ARTICLE · 1161197
AI著录,不只是自动填几个字段
一批活动照片进入档案系统后,最费时间的是什么?很多时候,并不是上传。而是上传之后,档案员还要一张张打开:这是谁?在哪里拍的?参加了什么活动?照片应该怎么命名?关键词填什么?如果是一段一两个小时的视频,工作量更大。要知道视频里谁讲了话、讲了什么、涉及哪些主题,往往还需要反复播放、人工记录。这也是声像档案管理长期存在的一个难题:文件已经数字化了,但文件里面的信息,还没有真正变成可以管理、可以检索、可以利用的档案数据。AI著录正在改变这一过程。
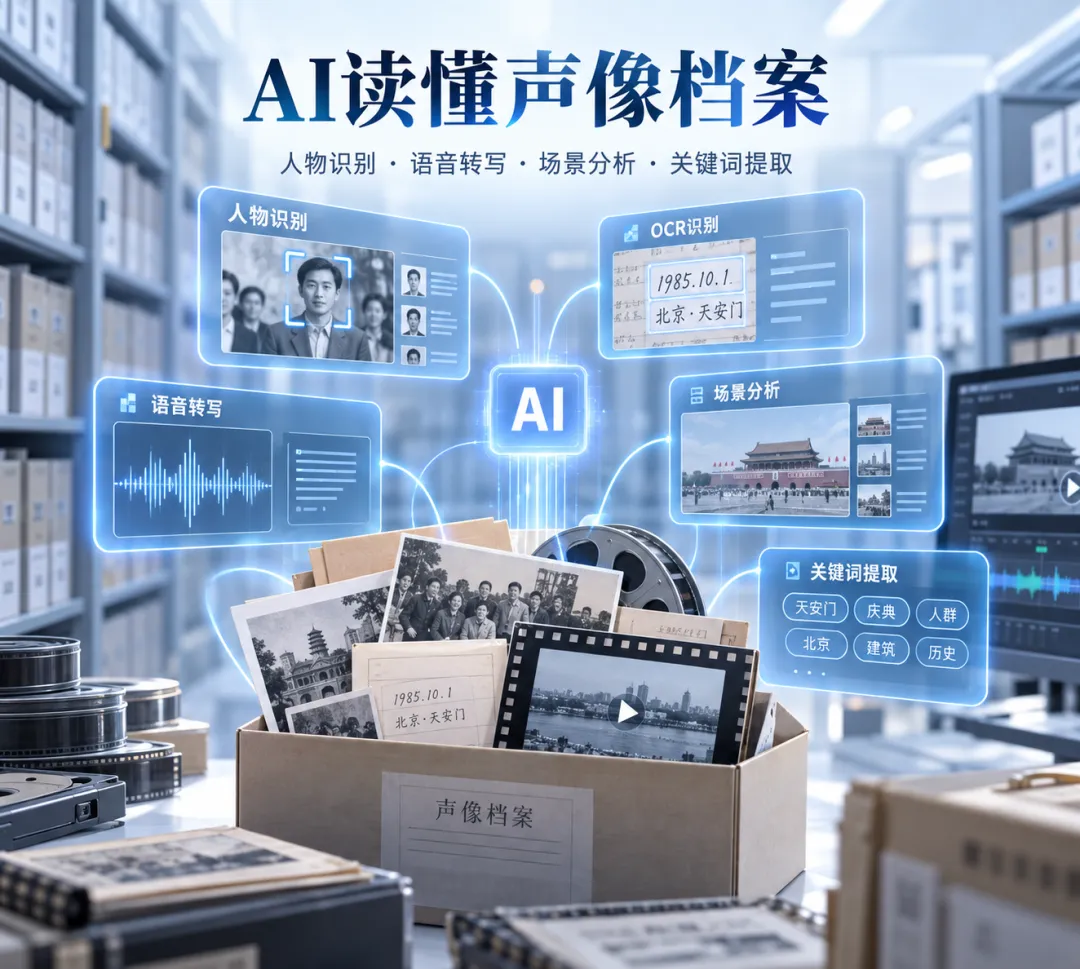
过去的声像档案著录,很大程度依赖人工“看”和“听”。照片靠人看。录音靠人听。视频既要看,又要听。而AI进入声像档案管理以后,首先改变的是机器处理这些资料的方式。它不再只把一张照片识别成一个JPG文件,也不只是知道这是一段MP4视频。而是开始进一步分析:画面里有什么人?出现了哪些文字?是什么场景?视频里说了什么?哪些人物、事件和关键词值得被记录?也就是说,过去藏在照片、音频和视频内部的信息,开始被机器“读”出来。这才是AI著录真正的起点。
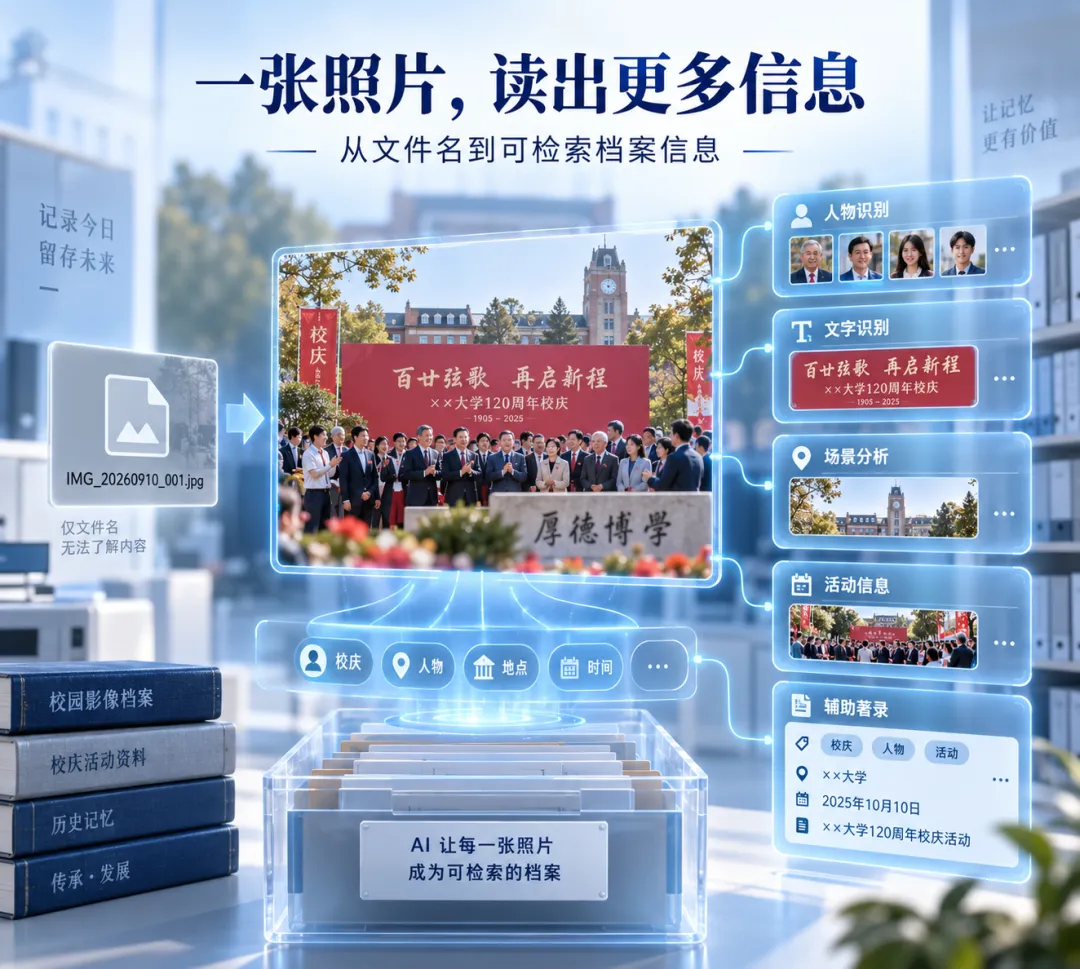
比如,一所高校上传了一批校庆活动照片。传统方式下,如果文件名只有:IMG_20260910_001.jpg,这个文件名本身几乎没有多少档案利用价值。档案人员可能还要根据照片内容,人工判断人物、活动、地点,再补充题名和其他著录信息。而进入AI声像档案管理系统以后,系统可以先对照片内容进行智能分析。识别照片中的人物;识别横幅、背景板等画面文字;分析照片中的场景和内容;结合已有资料形成相关内容描述;再辅助档案人员完成著录。如果系统中已经建立相关人物信息,还可以进一步把照片中的人物与已有资料形成关联。原本只有一个文件名的照片,就逐渐拥有了更多可以被检索的信息。从“这是一张照片”,变成“这张照片记录了谁、什么时间、什么活动”。这两个阶段,看起来只差几个字段,实际上决定了这张照片以后还能不能被快速找到。
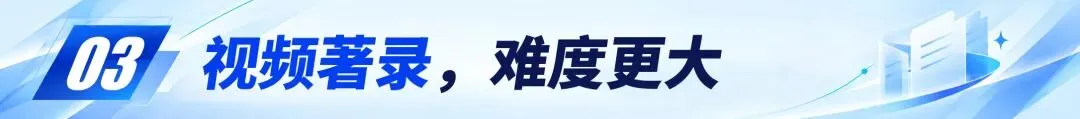
如果说照片著录解决的是“看见了什么”,那么视频还要解决另外一个问题:里面说了什么。一场两个小时的学术会议录像,可能包含多位专家发言、多个议题和大量专业内容。传统著录通常只能做到:“某某学术会议录像”。但这样的题名,对后期利用来说远远不够。几年之后,如果有人想找:“某位教授当年关于人工智能的一段发言”,仅靠文件名,很难快速定位。AI声像档案管理系统,可以通过语音识别将音视频中的语音内容转化为文字,并结合人物、关键词等信息进行辅助分析。于是,一段视频不再只是:“会议录像.mp4”。它开始拥有可以继续被检索、分析和利用的内容信息。更重要的是,文字与原始音视频可以建立对应关系。以后查到某段文字,不必重新从视频第一分钟开始播放,而可以进一步定位到相应内容。AI著录的意义,也从“帮档案员填目录”,延伸到了后续检索。
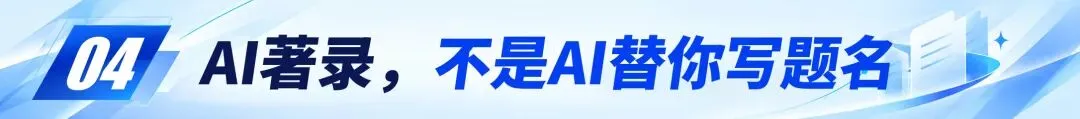
这是目前很容易被误解的一点。有人把AI著录理解成:上传一张照片,然后让大模型自动写一句描述。其实,对于档案管理来说,这远远不够。真正有价值的AI著录,需要解决三个层次的问题:第一层,是识别。看见人物、文字、画面,听懂语音。第二层,是理解。把分散在照片、声音、视频里的信息关联起来,判断其中可能涉及的人物、事件和内容。第三层,才是著录。把识别和分析结果转换成档案业务可以使用的信息,辅助档案人员形成更加完整的著录内容。所以,AI著录并不是简单的“AI写一句话”。而是在把过去隐藏在声像资料里的非结构化信息,逐步转变成可以被档案系统管理的数据。
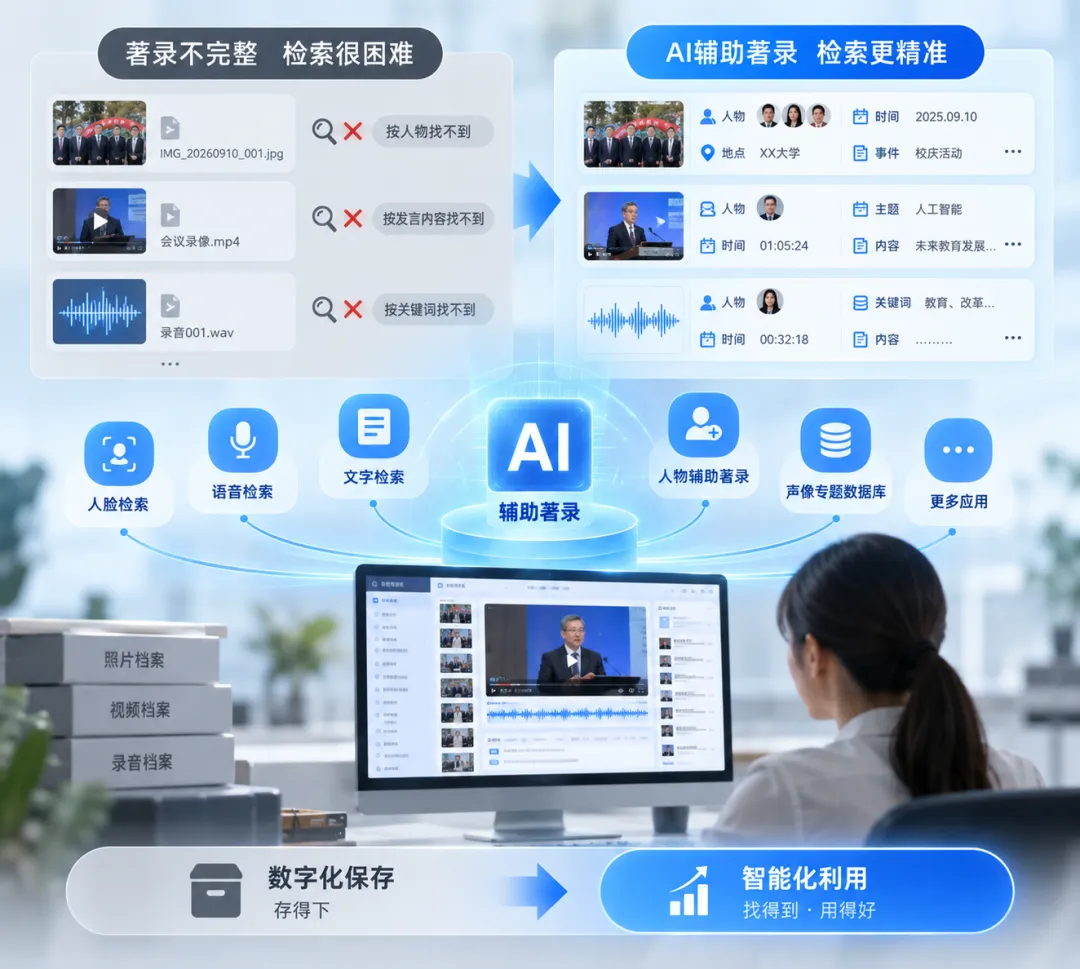
为什么现在越来越重视AI著录?因为声像档案管理中有一个很现实的问题:没有好的著录,就很难有好的检索。一张照片没有人物信息,后面就很难按人物查找。一段视频没有语音内容,后面就很难按发言内容检索。一批资料没有关键词和主题信息,专题数据库建设同样需要重新投入大量人工。因此,在AI声像档案管理系统中,AI辅助著录并不是一个独立存在的功能。它可以进一步与:人脸检索、语音检索、文字检索、人物辅助著录、声像专题数据库等功能形成关联。前面的著录越丰富,后面的检索和开发利用就越有基础。这也是声像档案从“数字化保存”走向“智能化利用”非常关键的一步。
但AI进入档案著录以后,还有一个问题不能忽略:机器识别出来的结果,能不能直接当作档案事实?答案显然不能这么简单。一个长相相似的人,可能被识别错误。一个专业术语,语音识别可能听错。一张年代久远的照片,仅凭画面信息,也未必能够准确判断事件背景。因此,AI著录真正合理的工作方式应该是:AI先识别 → AI辅助生成 → 人工审核 → 修改确认 → 正式入库。
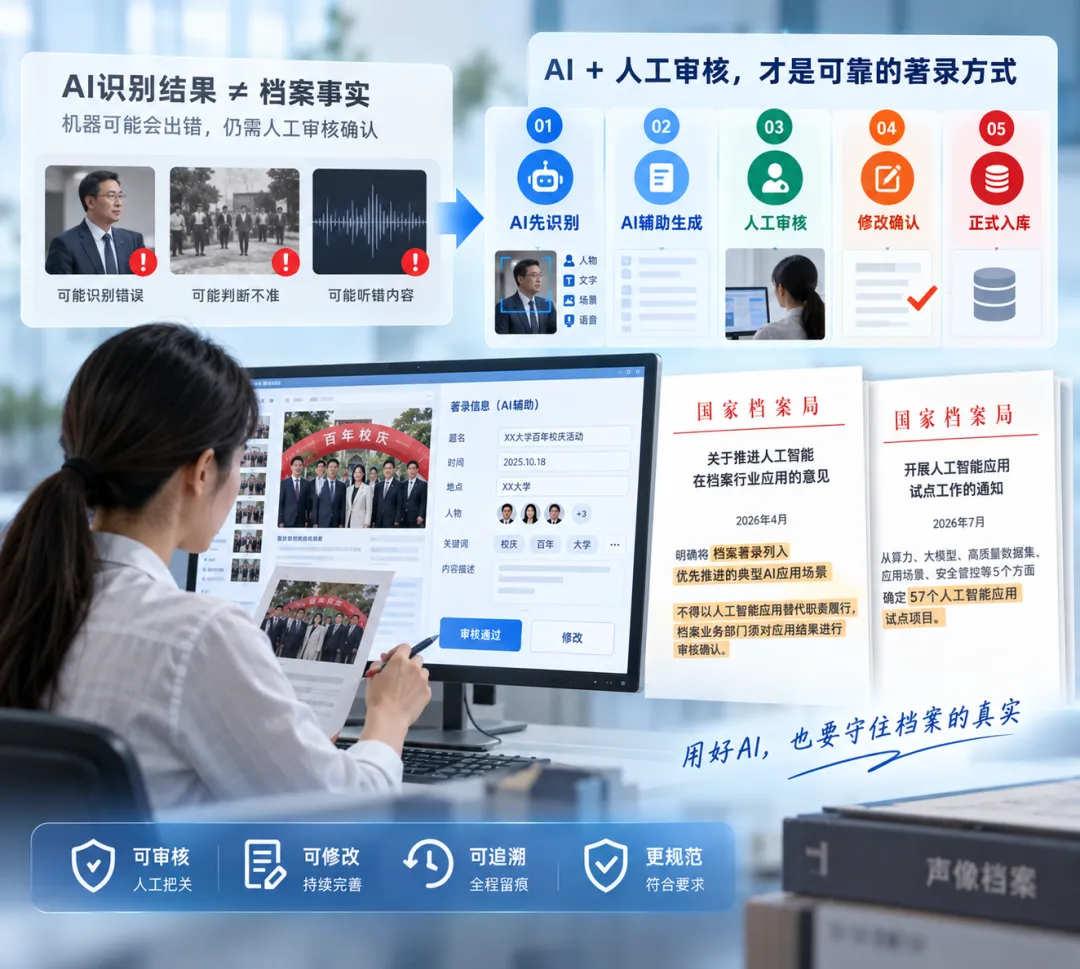
2026年4月,国家档案局印发《关于推进人工智能在档案行业应用的意见》,明确将档案著录列入优先推进的典型AI应用场景,同时提出,不得以人工智能应用替代职责履行,档案业务部门须对应用结果进行审核确认。到了2026年7月,国家档案局又从算力、大模型、高质量数据集、应用场景、安全管控等5个方面确定了57个人工智能应用试点项目。这释放出的信号已经非常清楚:档案行业需要AI,但需要的是可控、可审核、真正解决业务问题的AI。
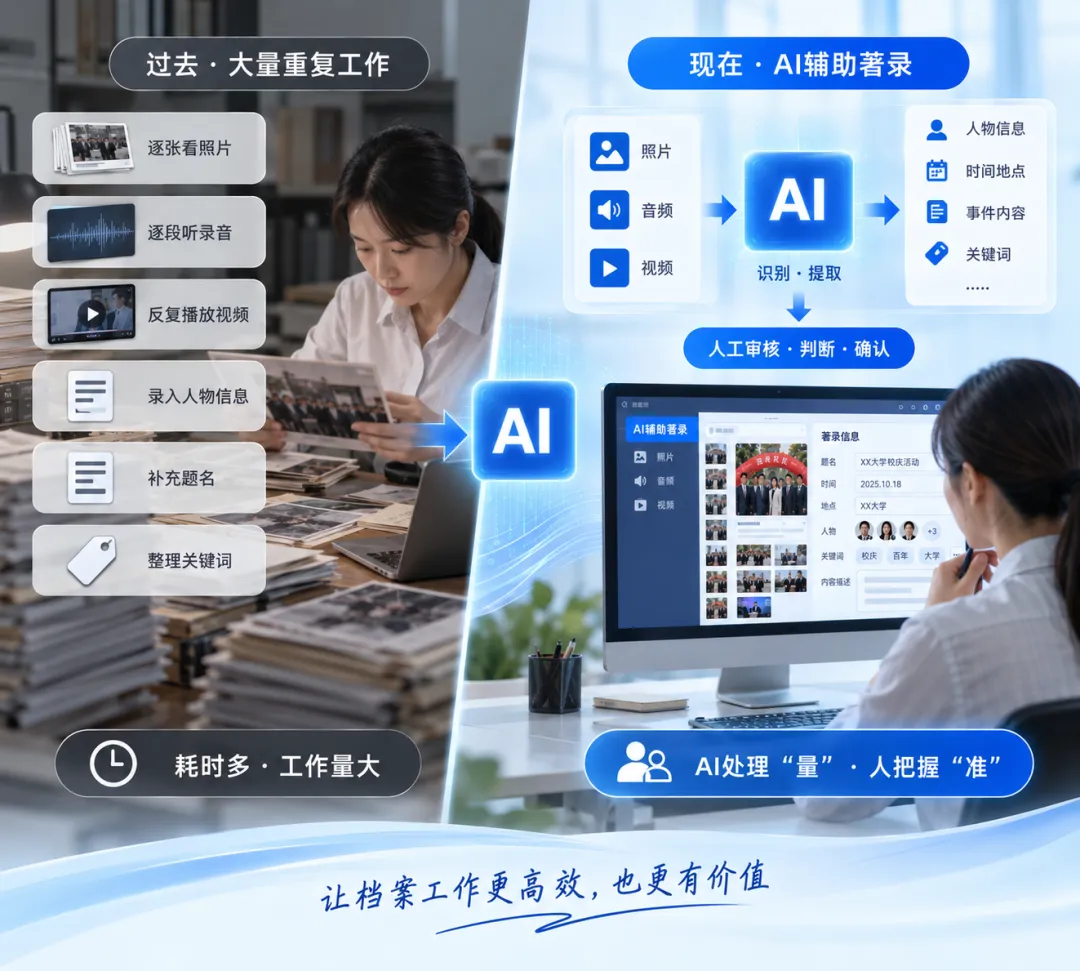
所以,AI著录真正要替代的,并不是档案员。而是大量机械、重复的工作。过去,档案员可能要把大量时间花在:逐张看照片、逐段听录音、反复播放视频、录入人物、补充题名、整理关键词。未来,机器可以先完成第一轮识别和信息提取。档案人员更多负责审核、判断、纠错和确认。AI负责处理“量”,人负责把握“准”。
目前,广州龙建达电子股份有限公司AI声像档案管理系统已在中山大学、北京师范大学珠海校区、南方科技大学、西安建筑科技大学、上海航天控制技术研究所等单位落地应用。从AI辅助著录,到人脸检索、语音识别,再到人物辅助著录和专题数据库,背后的逻辑其实是一致的:过去,我们解决的是——如何把声像档案保存下来。今天,更进一步的问题是——如何让机器读懂它,让档案员管好它,让使用者快速找到它。这或许才是AI进入声像档案管理真正有价值的地方。