ARTICLE · 1167951
Claude Code 学会逆向 App 了:一周 16 万 Star,连 Storyboard 都能还原
Windows 自带的计算器,你按 200 + 10%,屏幕上出来的是 220。
不是 200.1,也不是 210。为什么?
答案藏在计算器的 DLL 里。以前想知道,你得打开反汇编器,盯着 CMP EAX, 0x5c 这种指令一条条追。现在你对 Claude Code 说一句“用 REA 看看计算器,为啥 200+10% 是 220”,它自己翻进二进制,回来告诉你:按了加号之后,% 取的是第一个数的百分比,200 的 10% 是 20,200 + 20 = 220。顺手还附上了它看过的分支地址和反编译片段。
这个工具叫 REA,全称 Reverse Engineer Anything,逆向一切。
写 iOS 的朋友先别划走。REA 的前身是 Mac 上反汇编器 Hopper 的桥接工具,Apple 平台算它的老本行。它能解开 IPA 和 .app,列出 Objective-C 类和 Swift 协议,把编译后的 Storyboard 还原成控件、outlet 和 action,还能告诉你那句 Library not loaded: @rpath/... 到底卡在哪个文件上。第六节专门讲这部分。
最近一周它几乎刷屏了 GitHub Trending。我今天(10 月 13 日)用 GitHub API 查了一下 morluto/rea:162,120 个 Star,38,027 个 Fork。10 月 8 日的报道里它还只有 1.3 万 Star。Hacker News 上那条帖子拿了 784 分、330 条评论。
我把官网、README、官方博客、三个案例、HN 评论区和几篇中英文的源码分析都翻了一遍。翻完我觉得最值得看的,是它怎么逼 AI 不瞎编:每句结论都得附一张收据。这套做法,做任何领域的 Agent 工具都能抄。
一、它是怎么火起来的
很多报道写“REA 10 月 7 日发布”,这不准确。翻 CHANGELOG 和仓库历史,时间线是这样的:
rea-agents 上周下载 132,518 次 |
HN 评论区有人认出了作者 morluto,说他最早活跃在 RepoPrompt 社区。仓库的 MIT 协议、19 种语言的 README、一个专门的官网,都说明这不是一个随手丢出来的玩具。
二、逆向工程到底在干嘛
先把概念说清楚,后面才好理解 REA 的价值。
逆向工程,就是在没有源码的情况下,通过检查程序本身,搞清楚它是怎么工作的。 目的通常是三个:解释它、修改它,或者在自己的项目里重做一个。
还是拿计算器举例。官网把人工逆向的过程画得很清楚:
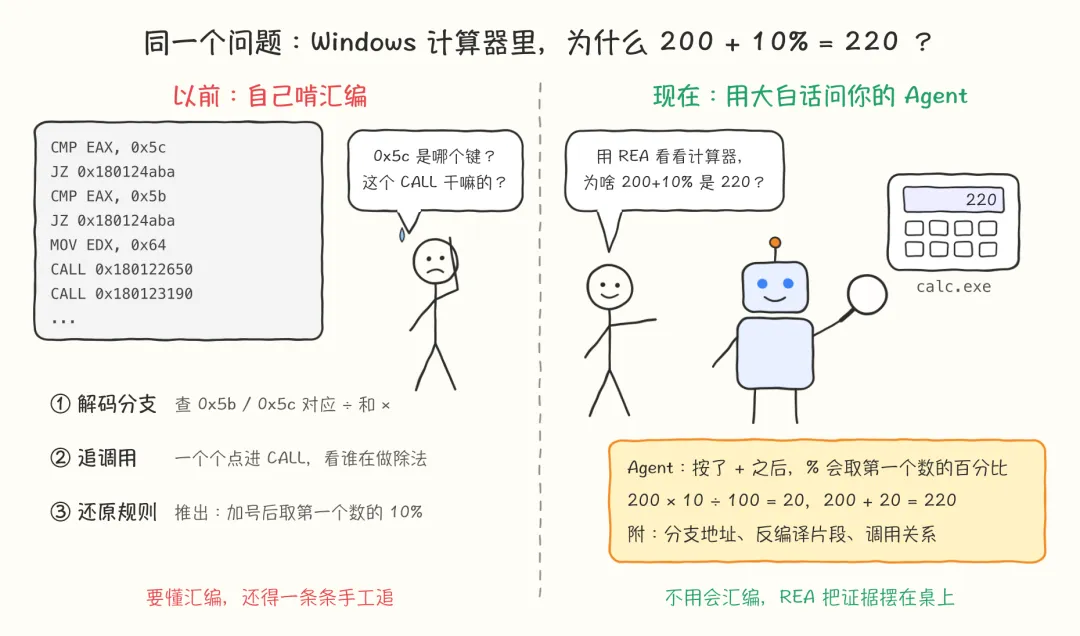
人工的做法分三步:
CMP EAX, 0x5c 和 CMP EAX, 0x5b,你得去查微软公开的源码才知道,0x5c 是乘号,0x5b 是除号。MOV EDX, 0x64 好懂,0x64 就是 100。可后面一串 CALL 0x180123190 只是地址,哪个在做除法、传进去的是哪个数,得一个个点进去看。整理成代码就是这几行:
if(operation == multiply || operation == divide){ percent = current /100;}else{ percent = current * previous /100;}这活儿不难,但要懂汇编,要有耐心,还要知道去哪查资料。REA 想做的,是把这三步交给 Agent,你只负责提问和判断。
三、REA 不反编译,它给 Agent 当翻译和记账员
很多人第一反应是:Claude 自己就能装 Ghidra,要 REA 干嘛?
先看它站在哪:
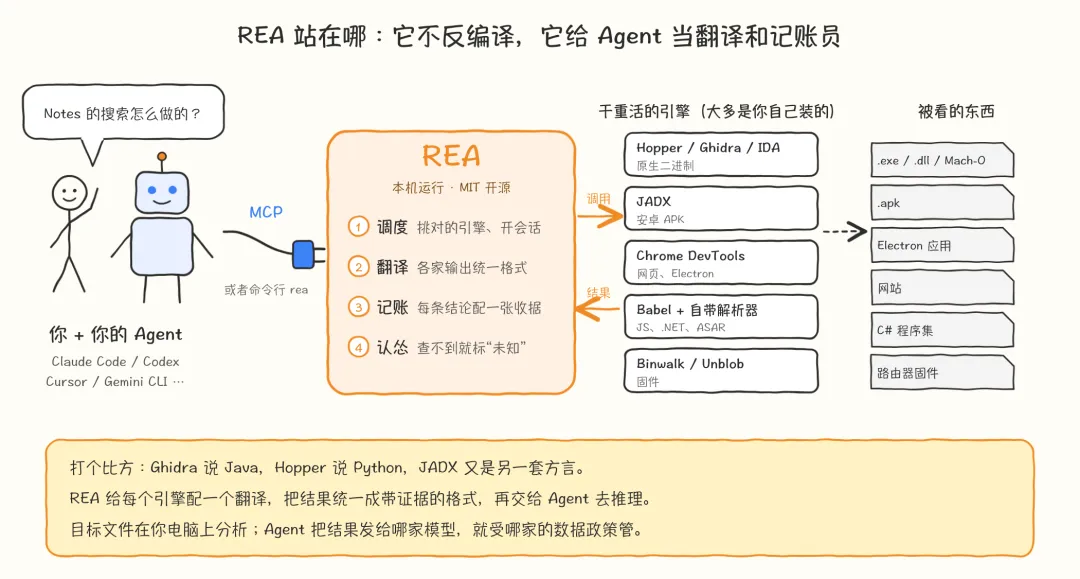
REA 自己一行反编译都不做。原生二进制交给 Hopper、Ghidra 或 IDA,安卓交给 JADX,固件交给 Binwalk,网页走 Chrome 的调试协议。JS 和 .NET 这些格式,它用自带的解析器读,不需要装重型工具。
它做的是中间那层:
有人数过,rea-agents 6.0.0 一共注册了 139 个 MCP 工具。其中 41 个是反汇编器的基础操作,比如列函数、读伪代码、查交叉引用;剩下的覆盖 APK、Electron、网页抓包、版本对比这些场景。
Hopper 的桥接写得挺讲究。Hopper 没有服务器模式,REA 就用启动参数让 Hopper 跑一个 Python 脚本,由这个脚本开一个只有当前用户能访问的 Unix socket,每个请求都要带一个随机令牌。脚本开头的注释记着一个踩出来的坑:所有 Hopper API 调用必须留在 Hopper 自己的 Python 线程上,挪到工作线程会死锁。
HN 上有人问:“直接给 Claude 一个 radare2 不就行?”安全圈的老兵 tptacek 的回答很实在:做逆向的人都有自己的一套脚本和流程,Ghidra 只是核心,你需要的不只是让 Claude 自由发挥,至少眼下是这样。
另一条评论更具体。有人用本地的小模型加 Ghidra 命令行去解一个程序,模型完全迷路;换上 REA 之后,同一个模型开始有进展了。工具设计得好,等于给能力一般的模型搭了脚手架。
四、核心原理:每个结论都要附一张收据
这一节是 REA 最值得学的部分。
让大模型做逆向,最怕的不是它不会调工具,是它会编。你问某个函数干了什么,它给你一段像模像样的伪代码,语气笃定。你拿去对汇编,发现关键分支是它想出来的。逆向里一个地址错了,后面的推理全部作废。
REA 的应对办法是在协议层面把规矩定死:
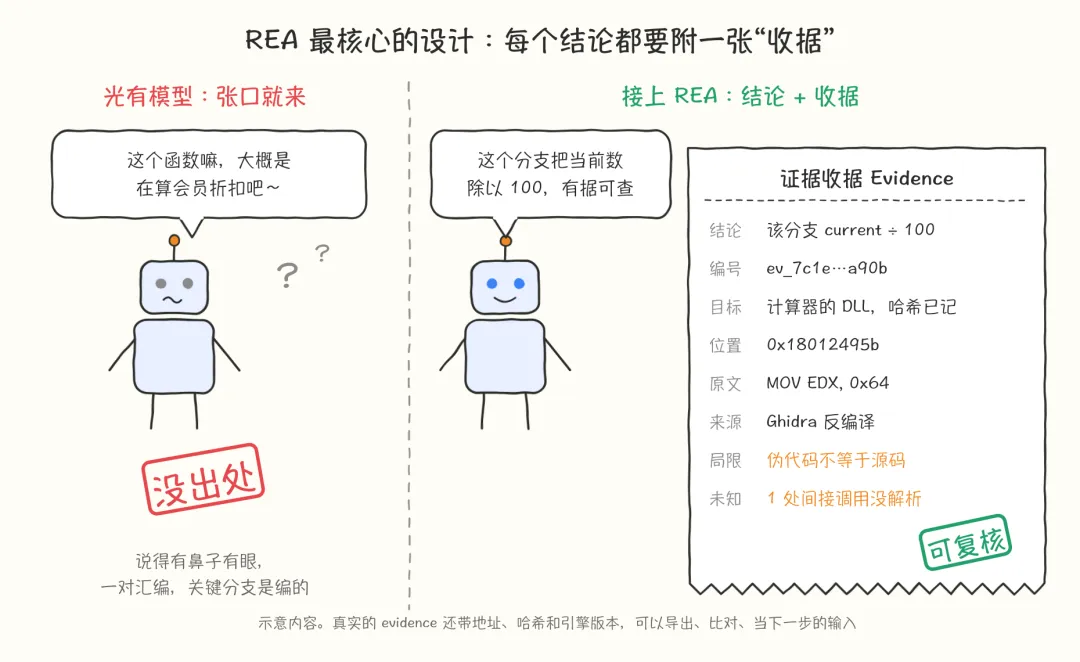
139 个工具里,126 个的返回值都是同一个结构:
{"result":"这次查询的结果","evidence_id":"ev_<64 位十六进制>","evidence":{"target":"被分析文件的哈希","addresses":["0x18012495b"],"provider":"ghidra","limitations":["伪代码是引擎的表示,不是原始源码"],"unknowns":["1 处间接调用没有解析"]}}上面是示意结构,真实字段以官方的 MCP 契约文档为准。逐段看:
analyze_function 的证据喂给 compare_functions 做两个版本的对比。工具的输出成了下一步的积木,可以一直往下接。record_unknown、list_unknowns、verify_unknown_resolution 工具。查不到就记下来,后面查到了再销账。还有几个细节,能看出作者被模型坑过多少次:
resource_constraint 错误,告诉你可以分页读,或者把完整证据导出成文件。模型的幻觉消不掉,但可以在每个可能胡编的出口,逼它交出出处。做其他领域的 Agent 工具,这个思路可以直接搬过去。
五、真实的玩法:从恐龙游戏到 30 年前的 DOS 游戏
官网放了几个案例,难度一个比一个高。
Chrome 断网小恐龙为什么越跑越快。 REA 通过浏览器调试连接,读出页面里真正在跑的 index.js,找到更新函数和三个参数:起始速度 6,每次无碰撞更新加 0.001,上限 13。官方还专门验算了:调用原版更新函数 4000 次,速度是 10.0;10000 次,到 13.0。Agent 基于这条规则重做了一个带速度滑块的小游戏。
Notion 复制时怎么保住块结构。 这是 Electron 应用的典型链路。REA 静态分析 Notion 的 preload 脚本,定位到页面能调用的 clipboard.write,它其实是 invokerInMain("notion:clipboard:write") 的包装。拿着这个通道名去主进程的代码里搜,找到了 ipcMain.handle 注册的处理函数:先检查发送方是不是 Notion 自己的页面,再调 Electron 的剪贴板 API。复制出去的 HTML 里还藏了一段 <!-- notionvc: ID --> 注释,粘贴时 Notion 用这个 ID 去本地找回完整的块数据。
DX-Ball 打砖块的声道计算。 这是原生二进制的案例,我做成了一个动图,你可以看 Agent 是怎么一轮轮追下去的:
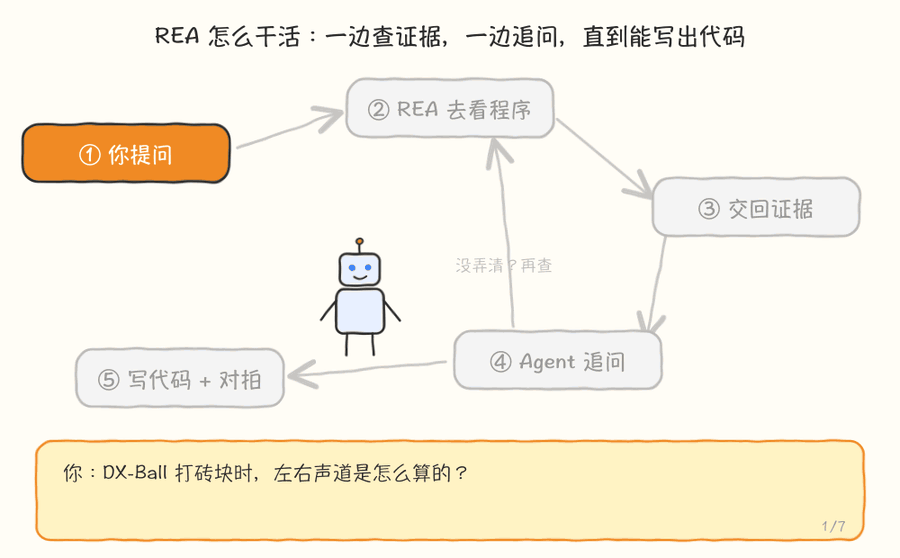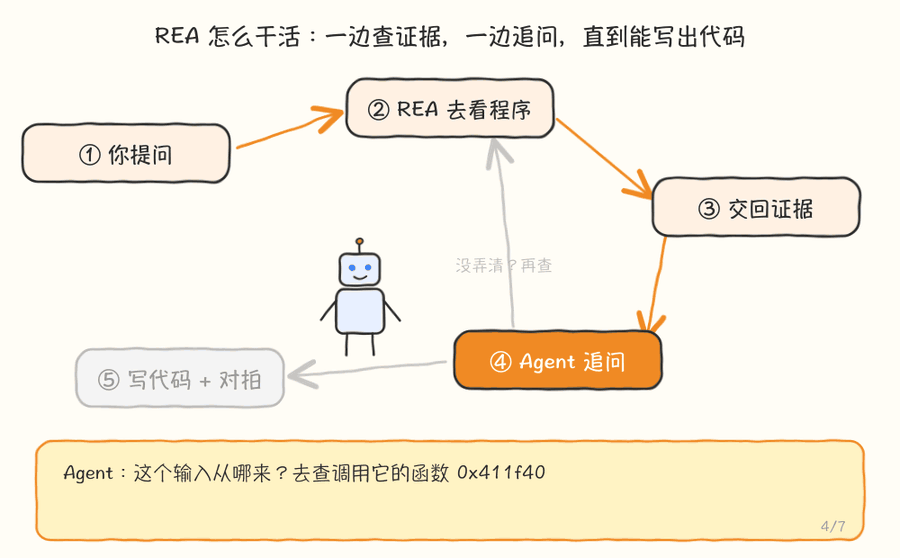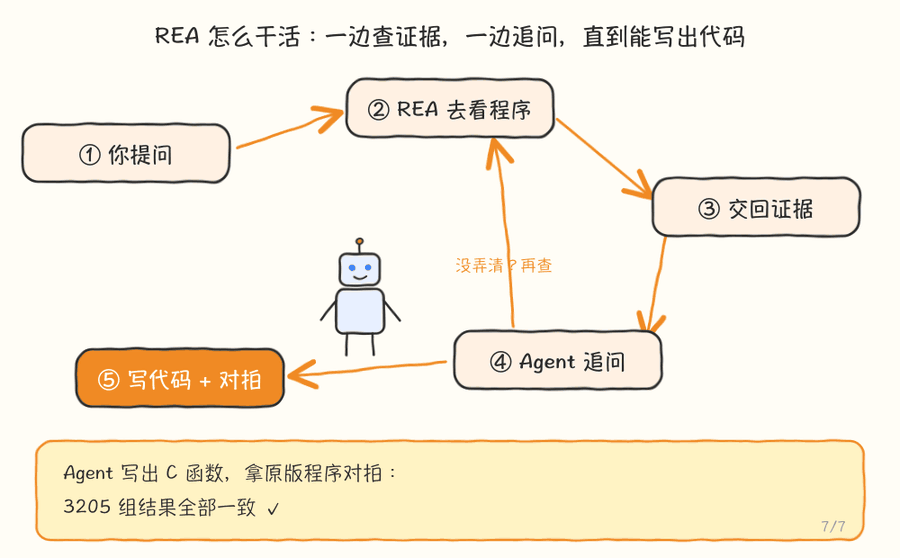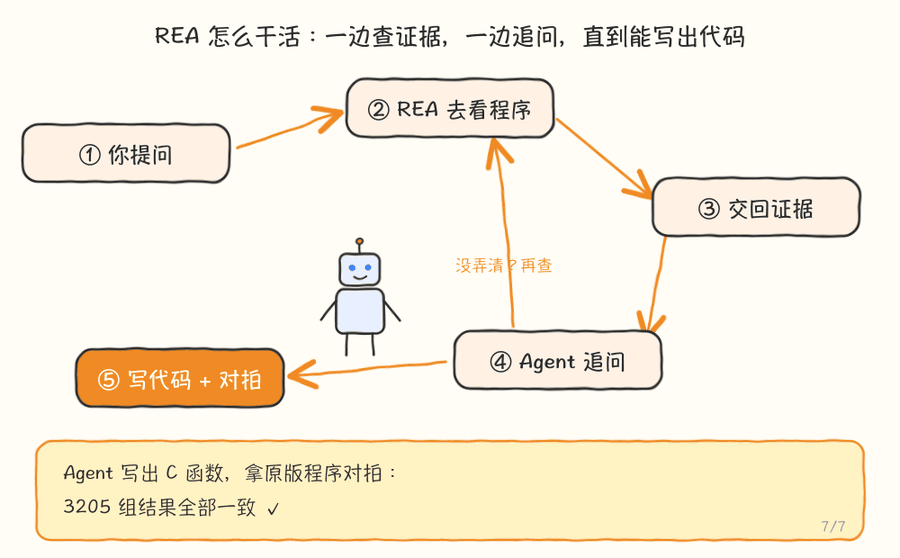
这里有个细节很能说明问题。反编译器给出的第一版伪代码,说这个函数没有参数。但 REA 同时返回了汇编,汇编里明明读了 [EBP+8]。伪代码和汇编对不上,这个矛盾本身就是证据,它给了 Agent 继续往下查的理由。于是 Agent 去查调用者,发现传进来的是砖块的屏幕坐标“20 + 30 × 列号”,再用 read_bytes 读出内存里的常量 1.5625 和 500.0,公式就完整了。
写出来的 C 函数对不对,靠的是对拍:
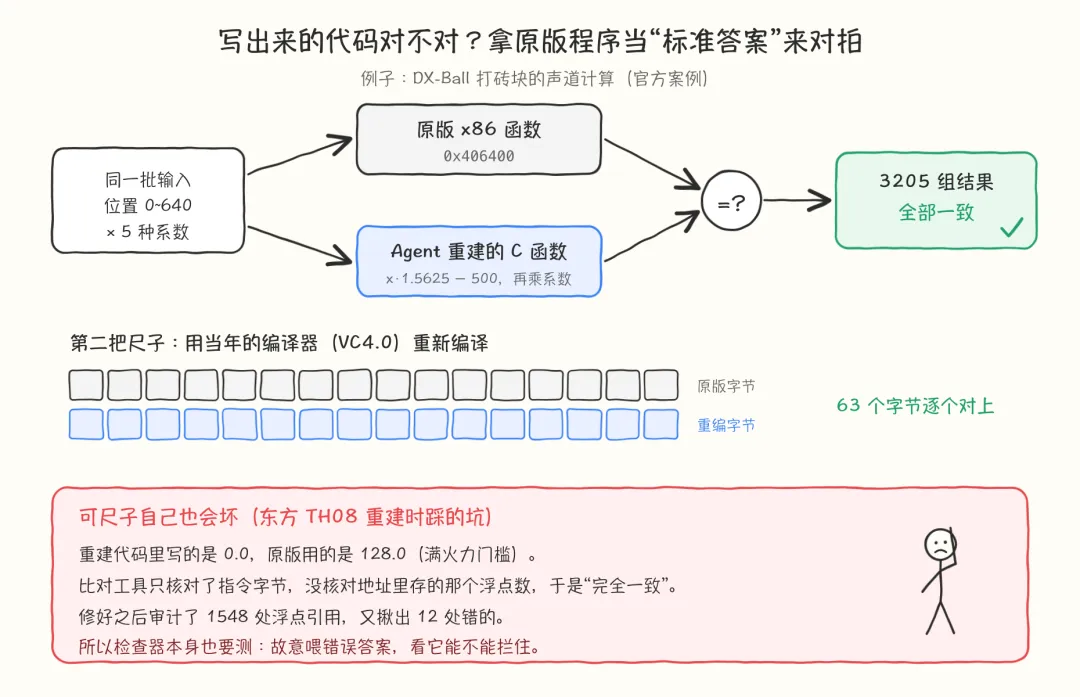
两把尺子:
截至 10 月 7 日,这个 DX-Ball 重建项目已经有 55 个维护中的 C 函数,跑了 45,380 次对比。
官方博客里更有料的一段
作者写了一篇《逆向工程的工业革命》,讲他用 Agent 重建东方 Project 系列游戏的经历。几个数字:
但我觉得博客里最值得读的是一个翻车故事。
TH08 的一个下游 Switch 移植版报了个 bug:没满火力也能自动吸道具。查下去发现,重建代码里判断火力的常量写成了 0.0,原版是 128.0。可这个函数早就通过了“完全一致”的字节比对。
原因是比对工具为了容忍常量地址变化,只核对了指令字节,没去核对那个地址里存的浮点数到底是多少。修好之后,作者审计了 1548 处浮点引用,又揪出 12 处错的。
作者的总结很清醒:一个人带着一群 Agent 干活,不可能亲自看每一行代码,心里有底,靠的主要是检查器。所以检查器本身也要测,要故意喂错误答案,看它拦不拦得住。
作者还写了一句:一条经验只存在我脑子里,只在我在场时有用;把它变成另一个会话能跑的检查,它就能一直帮下去。仓库成了项目的工作记忆。
六、写 iOS 的,能拿它干什么
开头说过,REA 是从 Hopper 的桥接工具长出来的,所以 Apple 平台这块的工具做得很细。我按 iOS 开发者常见的问题,把官方文档对了一遍:
inspect_artifactproject_apple_application_graph | ||
inspect_plistinspect_signature | ||
inspect_native_dispatch_metadata | ||
demangle_swift | ||
decode_interface_builder | ||
inspect_asset_catalog | ||
@rpath | trace_dylib_resolution | |
observe_native_calls |
文档里有两个能直接抄的命令:
# 查每个可执行文件的 dylib 加载路径,排查 @rpath 问题rea trace-dylib-resolution MyApp.app --json# 把编译后的 storyboard / nib 还原成对象和连线rea decode-interface-builder MyApp.app我觉得对 iOS 开发者最实用的是三类场景:
@rpath 加载失败,比如某个 Mac App 到底在什么时机发起了网络请求。有一条边界要说在前面。从 App Store 下载的 IPA,主程序是 FairPlay 加密的,REA 不负责解密,它的免责声明也明确不支持绕过这类保护措施。你能正常分析的是自己的构建产物、模拟器包、开源或授权给你的二进制,以及 Mac 上的 App。
这部分我目前只读了文档,还没在自己的项目上实际跑过。Swift 支持也有明确的边界:泛型、resilient、async 的表,文档标的是不支持或部分支持。
七、上手:一条命令装好,问对问题
装好 Node.js(22.19 以上),在终端跑:
npx rea-agents@latest setup它会扫出你机器上装了哪些 Agent,列出要改的配置,等你确认才动手,改之前会备份。支持 Claude Code、Codex、Cursor、Gemini CLI 等十几个客户端。装完重启 Agent。
然后直接提问就行。官方给的几个范例,翻成中文大概是这样:
用 REA 看看 Windows 计算器的 % 按钮,还原加号和乘号后面的两套规则,再写一个小计算器验证。搞清楚 Notes 应用的搜索是怎么实现的,给我看证据,然后在我的项目里做一个类似的功能。用 REA 检查这个恐龙小游戏,为什么会越跑越快?给出速度规则,再做一个能调速度的小版本。不想接 Agent,也可以单独用命令行分析一个 Electron 应用的目录或 ASAR 包:
npx -y rea-agents@latest analyze-javascript-application /绝对路径/到/应用 --json几个容易踩的点:
rea doctor。它会逐项检查引擎、环境变量和各个 Agent 的注册状态,告诉你缺什么。rea-agents,仓库是 morluto/rea,官网是 rea.tools。爆火之后 GitHub 上冒出一批同名仓库,有的描述写着“Download rea”,有的已经被删了。10 月 9 日官方还专门澄清,REA 没有发过任何加密货币。八、争议和边界
评论区吵得最凶的,是法律问题。
有个团队在做 Photoshop、Word 的开源复刻,他们在 HN 上明确说:团队禁止使用 Ghidra,不碰任何反编译,全部按“净室”流程来,因为做这么显眼的产品,用 REA 大概率招来官司。另一边,东方 TH08 的原社区重建项目已经转为私下开发,README 里直接把 AI 生成的反编译和移植称为“投机者”。REA 作者在博客里引用了这段话,表示尊重对方的付出,但选择公开继续、保留来源和署名。
REA 自己的免责声明列得很清楚,项目不支持、也不会帮忙的事包括:绕过 DRM、授权校验和反作弊,做游戏外挂,绕过你无权测试的系统的认证,复制专有软件的受保护代码和素材,以及绕过 AI 厂商的使用政策。相关请求在 issue 里会被直接关掉。
第二个争议在安全圈。有媒体把它和同期另一件事放在一起写:韩国多家银行被入侵,攻击者用的是一个开源的 AI 渗透测试工具。REA 本身不是攻击工具,但它把“读懂一个闭源程序”的门槛降到了“会提问”。以前靠“反编译太费劲”挡住的东西,现在要假设已经挡不住了。 对做闭源软件的团队来说,代码混淆、漏洞赏金范围这些决定,值得重新过一遍。
第三个是模型拒答。有人反馈 Claude Opus 5.5 偶尔会拒绝,有人说 Codex 更宽松,也有人反过来。比较一致的说法是:让模型追程序流程、重命名函数、回答“这段在干嘛”,基本正常;涉及 DRM 和授权校验,就容易被拦。
最后泼一盆冷水。16 万 Star 里有多少是看热闹的,不好说。真要上手原生二进制,Ghidra 的环境、Hopper 的授权、Agent 的 token 账单,都是实打实的成本。
我的判断
在我看来,REA 最值得拿走的是两条做法,139 个工具反倒是次要的。
第一条,把一个行业的职业规矩写进 schema。逆向圈几十年来的规矩是:结论要有出处,未知要承认,产物要能复核。这些原本靠人自觉,REA 把它们做成了 evidence_id、unknowns 和不许伪造的进度条。你在自己的领域做 Agent 工具,第一步可以先问:这个领域里,什么样的断言必须带出处?
第二条,花力气在检查器上。Agent 写得越快,检查器的漏洞扩散得越远。那个 0.0 和 128.0 的故事,比任何一个成功案例都更能说明这件事。
对普通开发者,它适合这些场景:搞懂自己每天用的 Electron 应用是怎么做某个功能的,给自家 IPA 做一次发版体检,接手一个源码丢了的老程序,打 CTF,或者让一款早就没人维护的老游戏在新系统上跑起来。拿它去照抄竞品,就别了。
你最想用 REA 看清哪个 App 的哪个功能?评论区说说,点赞多的我挑一个实际跑一遍,iOS 和 macOS 的优先。
参考链接