ARTICLE · 1173171
连 Linus 都用 AI 改内核了,为什么“读个文件”还这么难
连 Linus 都用 AI 改内核了,为什么“读个文件”还这么难AI 写个网页,你可能已经见怪不怪。 但如果用它的人是 Linux 创始人 Linus Torvalds,改的是操作系统内核呢? 10 月 12 日,Phoronix、It's FOSS 等媒体报道了 Linus 的一个实验分支:他在 Claude Code 的帮助下,尝试解决多线程读取文件时的性能瓶颈。 
据报道,Claude Code 在他的指导下参与了代码、测试程序、部分审查和提交说明初稿,性能测量由 Linus 在自己的机器上完成。 这仍是实验分支,不能理解成 AI 写出的补丁已经进入 Linux 正式版本。 但它值得拆开看看:为什么一个看起来简单的“读文件”,需要这么复杂的优化?AI 又能在其中帮到哪一步? 
01 / 只是读文件,为什么也会堵车 ◇ 先认识一个东西:页缓存。 Linux 处理普通文件读写时,通常会经过页缓存。你可以把它理解成内存里的一份文件数据,方便后续访问。 好比餐厅把常用食材放在操作台上,厨师不用每次都去仓库取。 现在,来了很多厨师,同时要拿同一份食材。 问题可能出在旁边那本登记簿:每个人拿之前登记一次,用完再登记一次。拿食材很快,更新同一本簿子却需要协调。 人多了,登记反而成了瓶颈。 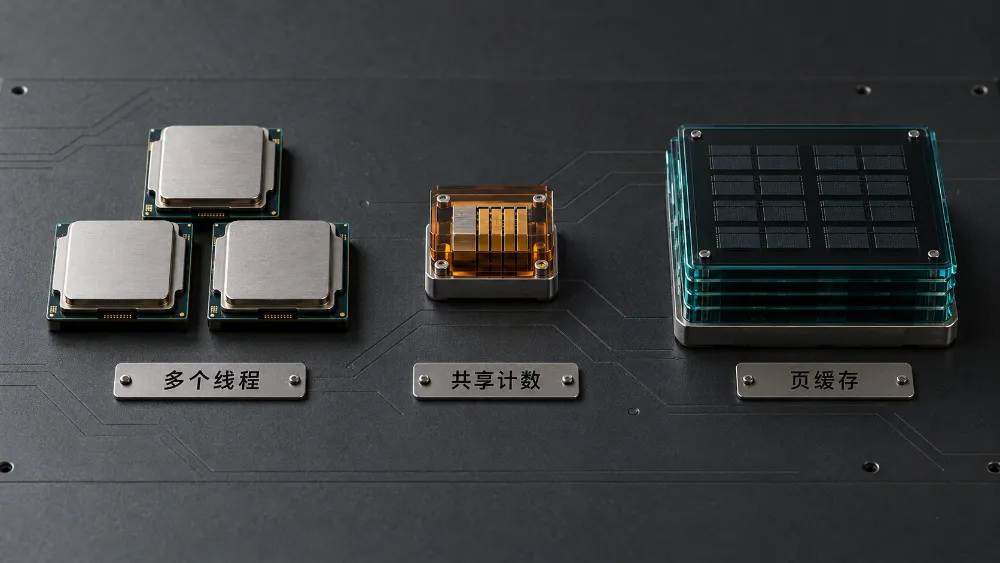
在计算机中,多个 CPU 核心频繁修改同一处共享状态,也可能付出可观的协调成本。 Linux 的 RCU 文档就解释了,减少读侧的原子操作和缓存通信,可以降低这类开销。 报道中,这次实验针对的就是多个线程对同一文件进行小块读取时,围绕页缓存内存块引用计数产生的竞争。 它也提醒我们:增加线程,并不保证程序按比例变快。 如果所有线程都要经过同一个拥挤的环节,再加人,也可能只是让队伍更长。 
02 / 拿走登记簿,能够改善吗 ◇ 登记不是白做的。 引用计数的一项用途,是帮助管理对象的生命周期:只要还有人需要它,就不能随便回收它。 🤔 想象一下:厨师还在切菜,操作台却已经被清空、挪给了另一道菜。省下登记时间,换来的可能是更严重的错误。 所以,减少读侧开销,必须配套回答另一个问题:怎样保证读取期间,数据仍然有效? 💡 Linux 中有一种重要的思路,叫 RCU。 它把“从数据结构中移除”和“回收内存”分成两步:先让后来的读者不再取得旧对象,再等待已经开始的读者完成,最后回收。 用餐厅的比喻说,就是先停止向新来的厨师提供旧操作台,等之前还在使用的人结束,再把它撤走。 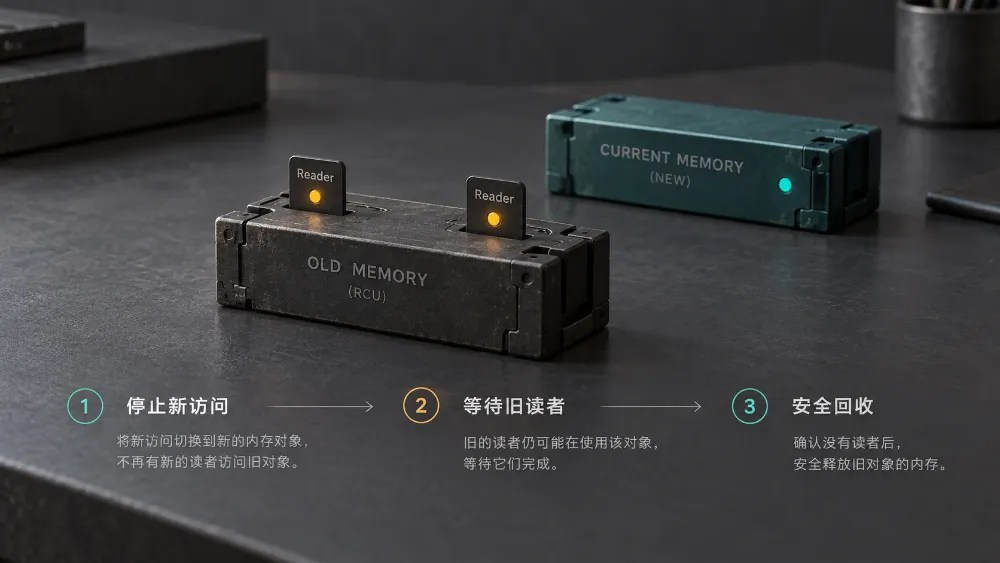
这里讲的是相关技术背景,并不是说所有引用计数都能直接用 RCU 替换。 👉 性能优化最难的地方,往往就是:少做了一步,还能不能保持原来的正确性。 尤其在内核里,读取、修改、回收可能同时发生。 单独看某一段代码没有问题,放进并发运行的系统里,就可能出现新的边界情况。 
03 / AI 能写补丁,谁来证明补丁成立 ◇ 这次事件里,值得注意的还有分工。 按照媒体对提交说明的转述,Claude Code 的参与范围包括代码和测试等工作,但方向由 Linus 指导,测量也由他亲自运行。 这让我们看到一个更具体的 AI 编程场景:开发者提出问题,借助 Agent 实现和检查,再根据运行结果继续判断。 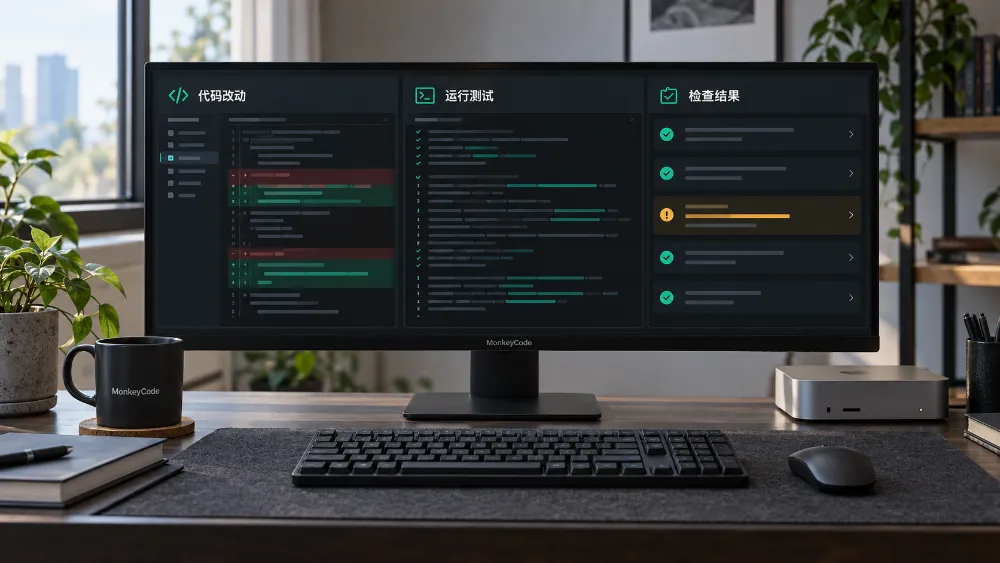
放到日常开发中,一次“性能优化”至少应该回答三件事: ⭐ 测了什么? 是某一种读文件场景,还是完整应用的响应速度? 只看到一张跑分图,很难回答这些问题。 因此,也不能把特定测试场景中的提升,直接写成“整个 Linux 快了几倍”。 对 AI 生成的优化,最有价值的交付应当包括:改动、复现方法、测试结果,以及尚未验证的部分。 “我改好了”之后,还应该接上“这是怎么验证的”。 
04 / 普通项目,也需要这一步 ◇ 我们大多数人不会每天修改内核,但会遇到类似的判断: 这些问题,需要回到项目里跑起来看。 使用 MonkeyCode 时,可以把验收要求一起写进任务: 先复现这个问题,再修改代码。修改后运行相关测试,说明如何验证;没有验证的部分,请明确列出来。 让 Agent 读项目、改代码、执行命令,再根据结果继续迭代。交到你手上的,才更容易是一份能检查的成果。 
05 / 写在最后 ◇ Linus 借助 AI 做内核实验,值得关注的是他让 AI 参与了哪些工作,又如何检查结果。 越重要的代码,越需要把测试和验证放进任务里。 你用 Agent 做过哪些真实项目?遇到过哪些“AI 说做好了,实际还差一步”的情况? 👉 立即体验 MonkeyCode: https://monkeycode-ai.com/ 👉 下载 MonkeyWork: https://monkeycode-ai.com/#desktop-client 🌟 欢迎加入 MonkeyCode 社群,分享你的使用经验,也和其他开发者一起交流任务怎么拆、结果怎么验,让 AI 更好地帮你把事情做完。 
🌙 怎么比较? 修改前后,硬件、输入、并发量和配置是否一致?
🌏 代价是什么? 更快的同时,是否增加内存占用,或影响其他路径?
AI 加了缓存,旧数据还能及时更新吗? AI 把串行任务改成并发,共享数据会不会被同时修改? AI 说接口更快了,测的是哪组请求?