ARTICLE · 1178352
AI工作流实操 别再堆Agent啦(多助手烧钱实测)
烧钱实测:团队模式,最高贵 5 倍,效果几乎没提升
Vals AI 在 10 月 9 号发了份实测,叫《Do Agent Teams Pay Off?》。他们拿 GPT-6 Sol 和 Claude Opus 5.5,做了 50 个完整 Web 应用,真刀真枪比了一回:单个 Agent 单干,对上 1 个 lead 带最多 5 个 subagent 的团队。
结果怎么样?
团队模式,贵 1.8 到 5.1 倍。4 组对比里,只有 1 组算是有统计学意义上的提升——GPT-6 Sol 在中等推理力度下,涨了 7.3 分,从 77.6% 到 84.9%。听着还行对吧?代价呢?每个应用 3.07 美元对 1.22 美元,2.5 倍的成本。
而且你把推理力度开到最大,两个模型的团队模式,全都没可测量的提升。多花的钱,基本打了水漂。
顺便提一句,每组配置只跑了一次,作者自己也说了这个局限,我也照实告诉你。
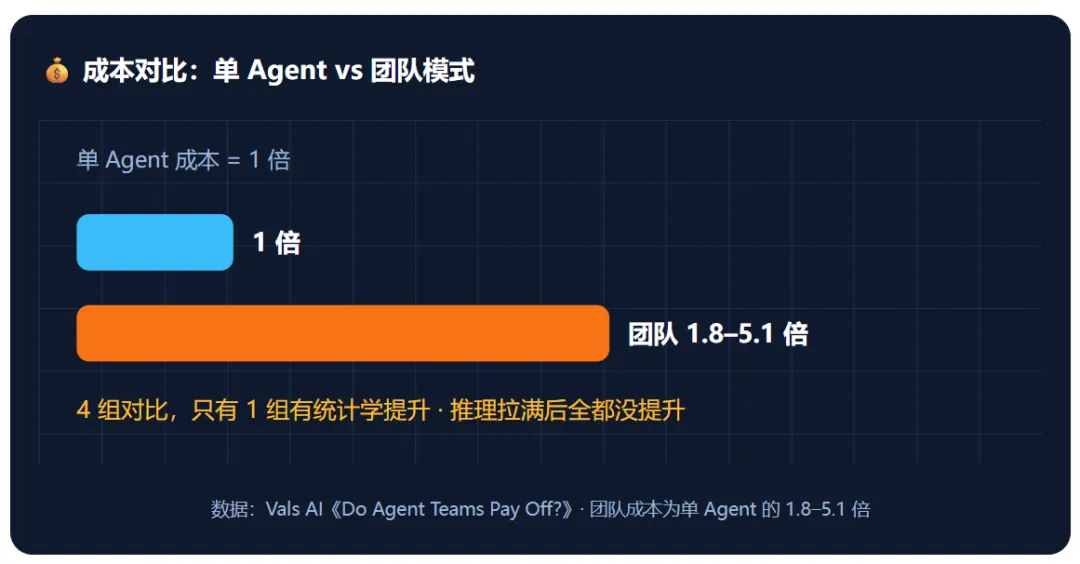
数据:Vals AI《Do Agent Teams Pay Off?》· 团队成本为单 Agent 的 1.8–5.1 倍
不只这一份数据。
Anthropic 自己内部也测过:Opus 5.5 做知识库任务,Agent 从 1 个加到 10 个、30 个、100 个,得分是 0.53、0.70、0.71、0.74。从 10 到 100,几乎原地踏步,明显见顶了。
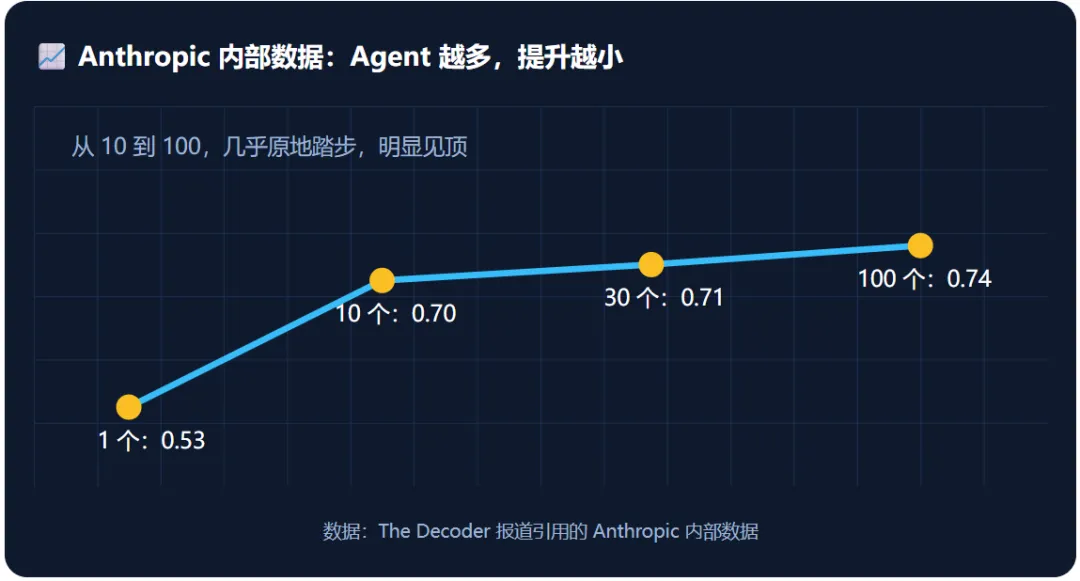
数据:The Decoder 报道引用的 Anthropic 内部数据
更扎心的还有 Fable 5.1:Agent 从 30 扩到 100,得分反而下降了。人越多越乱,Agent 也一样。
(来源:Vals AI 官方博客,作者 Katrina Drozdov,2026-10-09;Anthropic 内部数据为 The Decoder 报道引用,2026-10。)
人越多越乱,Agent 也一样。
原因:钱不是花在干活上,是花在协调上
这事我太熟了,跟工地上天天发生的一模一样。
就像包工头带施工队,最怕的就是人一多就乱。你派 10 个人去铺砖,看着挺壮观,结果呢?两个人等材料,三个人等图纸,一个人去问水电怎么走,最后真正铺砖的就那么几个。活儿没快多少,盒饭倒是多订了好几份。
Agent 团队,一模一样。带 10 个小工,不如带 2 个老师傅。人一多,真正干活的就那么几个,剩下的人在等、在问、在返工。你以为你在加人,其实你在加管理费。
那这钱到底花在哪了?
不是花在干活上,是花在协调上。Lead Agent 得拆任务、发指令、验收结果,subagent 之间还得对齐上下文。来回传话、等回复、返工——你烧掉的不是 token,是管理费。
OpenAI 的研究员 Noam Brown 有句话,我觉得说得特别到位:“把 10,000 个 Agent 扔给一部小说,就像把 10,000 个人扔给它一样没用。”
团队买的更多是速度,不是质量——按 Noam Brown 的说法是这样,但这也不是包票:Vals 实测里,Opus 团队反而更慢。这句话,你记住了,大多数坑就避开了。
解决方案:上团队之前,先跑两轮对比,再算一笔账
下回有人跟你说“上个多 Agent 团队吧”,你先别急着点头,先跑两轮对比,再算一笔账,答不上来就别上。
1 单个 Agent,推理力度拉满了吗?
实测里最有意思的一个发现:对 GPT-6 Sol 来说,把单个 Agent 的 reasoning effort 调高,比加一个团队更提分。先让老师傅使出全力,别急着招小工。你先把单个跑一遍,记个分,再把推理力度开到最大跑一遍,对比一下。要是已经够用了,停,就到这儿。
▼
2 任务能不能干净切分?
标准就一个:每个子任务,能不能独立验收?“同时抓 5 个网站的数据”,每个都是独立的,拆开没毛病。“写一个完整的应用”,前后耦合严重,拆开就是给自己找麻烦。你把任务拆成块,给每块写一句话验收标准。写不出来?那就说明拆不了,别硬拆。
▼
3 算账:你缺的是质量,还是时间?
缺质量,别加人,加人也提不了质量。缺时间,可以考虑加人,用成本换速度。但先算账:团队成本是单 Agent 的 1.8 到 5.1 倍。你问自己一句,“1.8 到 5.1 倍成本换来的速度,值吗?今晚必须交货,还是明天交也行?”只有今晚就要交货的时候,才值得花 2.5 倍的成本换速度。
▼
4 把 Lead Agent 的验收标准写清楚
每个 subagent 的输入、输出、验收标准是什么?Lead 怎么验收、怎么合并、怎么处理冲突?哪个环节失败了,整体怎么回退?没写验收标准,就等于小工瞎干,最后还得你自己返工。
▼
5 临走前的小条子:6 个都打勾,再上团队
单个 Agent 的推理力度开到最大了吗?任务能拆成可独立验收的块吗?验收标准写得出来吗?我是缺时间还是缺质量?算过账了吗,1.8 到 5.1 倍成本换速度,值吗?Lead 的验收标准写清楚了吗?6 个都打勾,再上团队。有一个打不上,就老老实实单 Agent 干。
最后说句大实话。中文AI圈现在流行“一个 Agent 不够就上十个”的叙事,各种 swarm、多 Agent 框架炒得火热。但实测数据摆在这儿:大多数场景,你不是缺 Agent,是缺一个把单个 Agent 用到极致的包工头——这是我的判断,不是实测数字。
模型越强,单个 Agent 越能干。与其堆数量,不如把一个用明白。
📦 方法已整理成Skill 首页回复03获取
AI包工头老麦,分享实操干货包你满意。
来源标注:- Vals AI《Do Agent Teams Pay Off?》(2026-10-09):https://www.vals.ai/blogs/multi-agent-vibe-code-bench- The Decoder 报道(含 Anthropic 内部数据):https://the-decoder.com/ai-agent-teams-waste-massive-tokens-for-barely-measurable-quality-gains-research-finds/- bigchange.ai 预算视角解读:https://bigchange.ai/blog/vals-ai-agent-team-coding-benchmark-cost-score- Noam Brown 引言来自播客评论,多家媒体引用- 注:Vals AI 每组配置仅运行一次,结论供参考;Anthropic 内部数据为媒体报道引用