ARTICLE · 1179140
毕业前最后买的一台电脑,192GB 显存,迷你主机TXA2-495
大四,计算机,最近天天跟大模型打交道。毕设选题跟本地部署沾边,跑实验得自己出机器。我那台 32GB 内存的笔记本,跑个 7B 都得靠量化,70B 想都别想。云 API 用着方便,账单也感人,一个月大几十块是常态,真要反复调 prompt、跑结构化输出,钱花得跟流水一样。租云卡?按小时计费,跑着跑着就想掐表。秋招也投了一圈,光靠嘴说会部署没用,手里得真有一台能当场跑模型的东西。
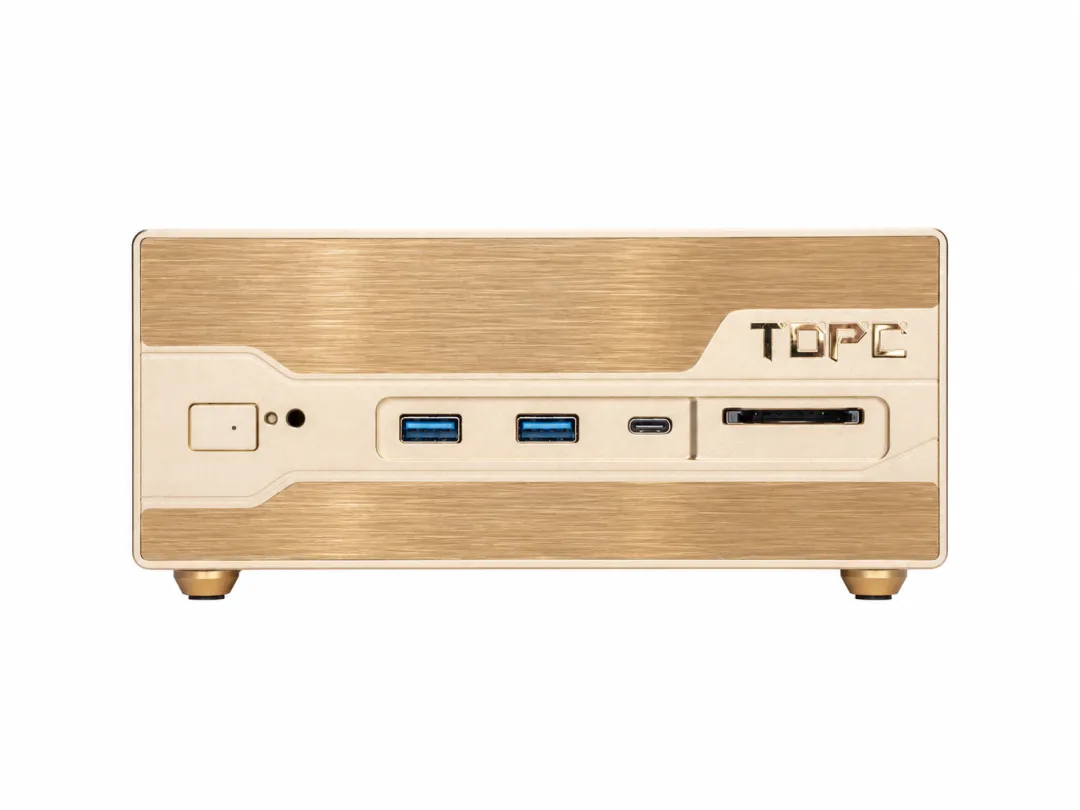
所以今年选生产力工具,我不看笔记本了,往台式机上想。可宿舍桌面就那么点地方,大机箱一摆,显示器都没处放。迷你主机就成了那个折中的答案,往桌面角落一塞,不占地方。
先说我为什么在意内存。跑本地模型,参数、上下文缓存、中间数据全压在内存里。显存不够,模型要么加载不进去,要么上下文被砍得没法看。他们公布的测试记录里,GPT-OSS 120B 跑起来专用显存占用 65GB,也就是说这种大家伙装得下,还留一大截余量给系统和其他任务;另一组 27B 的模型连续输出一万四千多 token,显存占用 37GB。这种装得下还带余量的感觉,用 32GB 笔记本的人很难体会。
性能上也不虚。Cinebench R23 多核 40743 分,Time Spy 图形分 12097。对我这种要编译、跑测试、偶尔渲染点东西的人来说,16 核 32 线程基本是毕业设计随便造的水准。图形部分是 Radeon 8065S,40 个计算单元,玩游戏不是它的主业,但集显能到这分数,日常带带 4K 屏、剪个视频都够用。更贴近开发场景的一条测试记录我也看了:Ubuntu 下用 35B 级别的 MoE 模型(Q8_0 量化)跑结构化输出,生成速度稳定在每秒 54 到 55 token,返回结果两次都过了 JSON 解析。对写代码的人来说,输出能被程序直接读取,比单纯聊天快那么一点更重要。可惜具体生成速度还是得看任务和模型,不能只看这一张表。
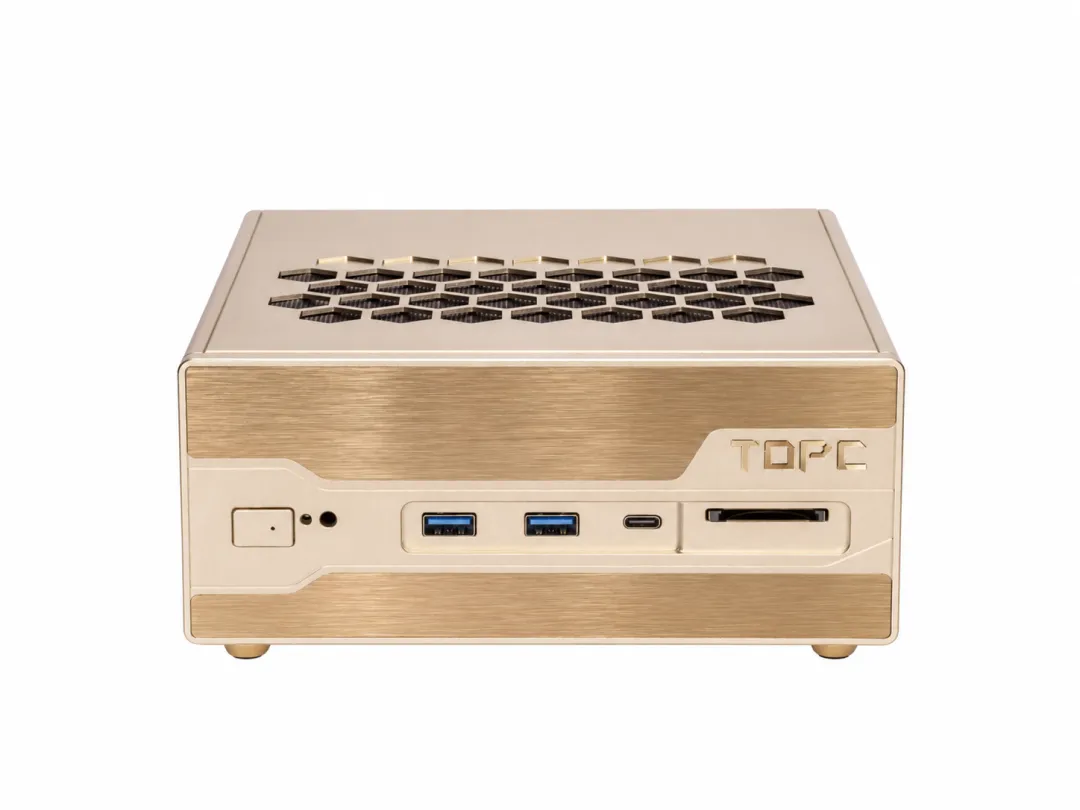
存储也是戳我的点。模型文件越攒越大,一个量化版就几十 GB,多个版本、数据集、实验记录,2TB 没几天就见底。TXA2-495 给四个 M.2 接口,系统盘、模型库、工作资料分开摆,后面不够再加,不用拆机换盘。这比只看出厂配多大硬盘实在,反正我是受够了天天腾硬盘空间的日子。
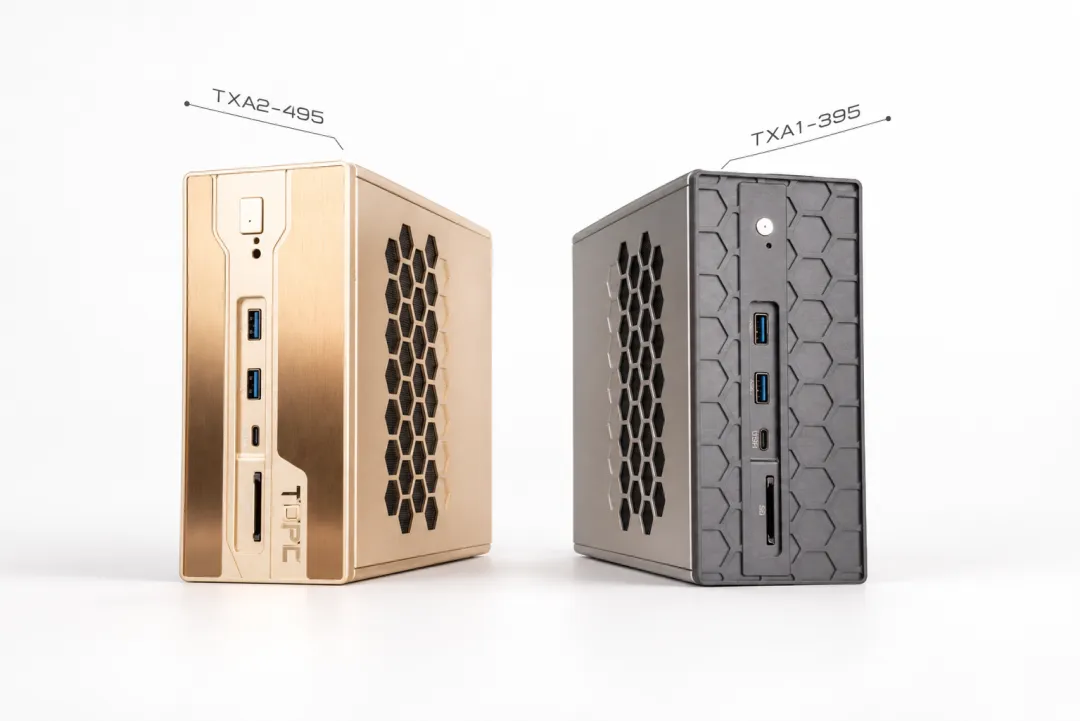
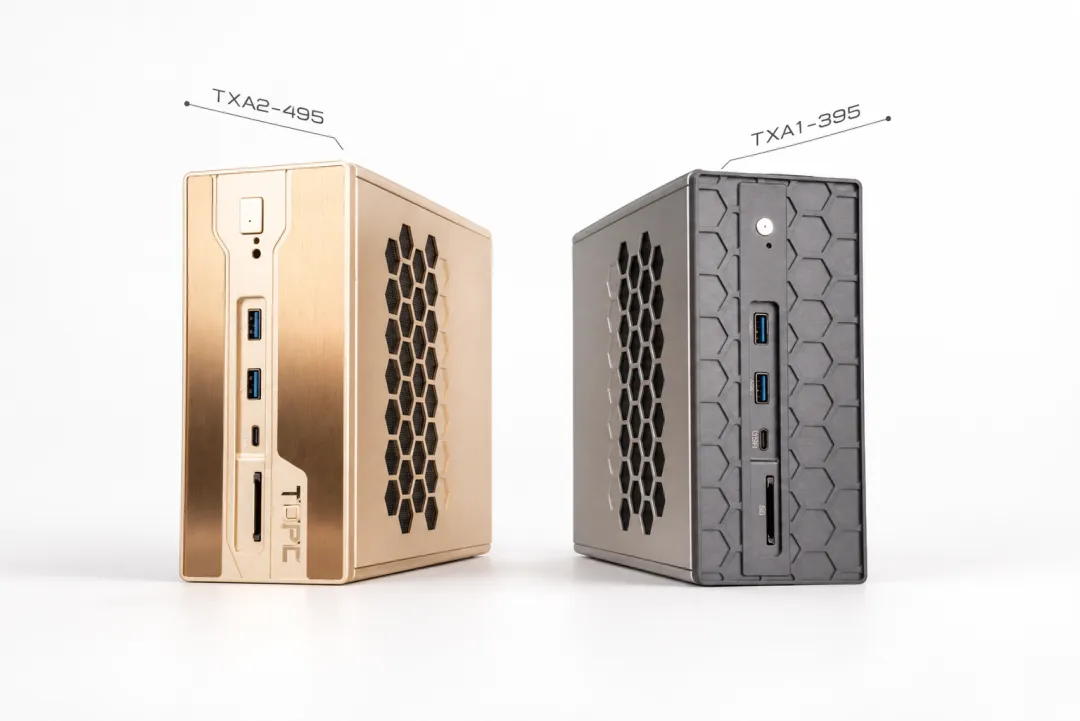
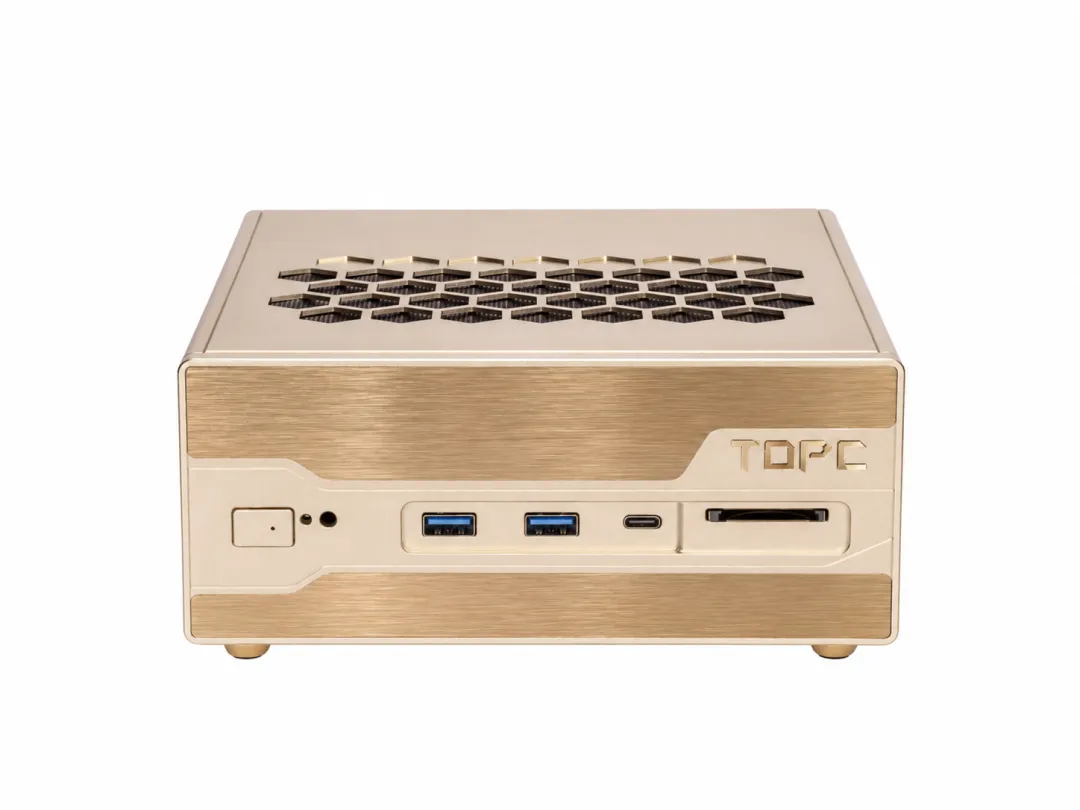
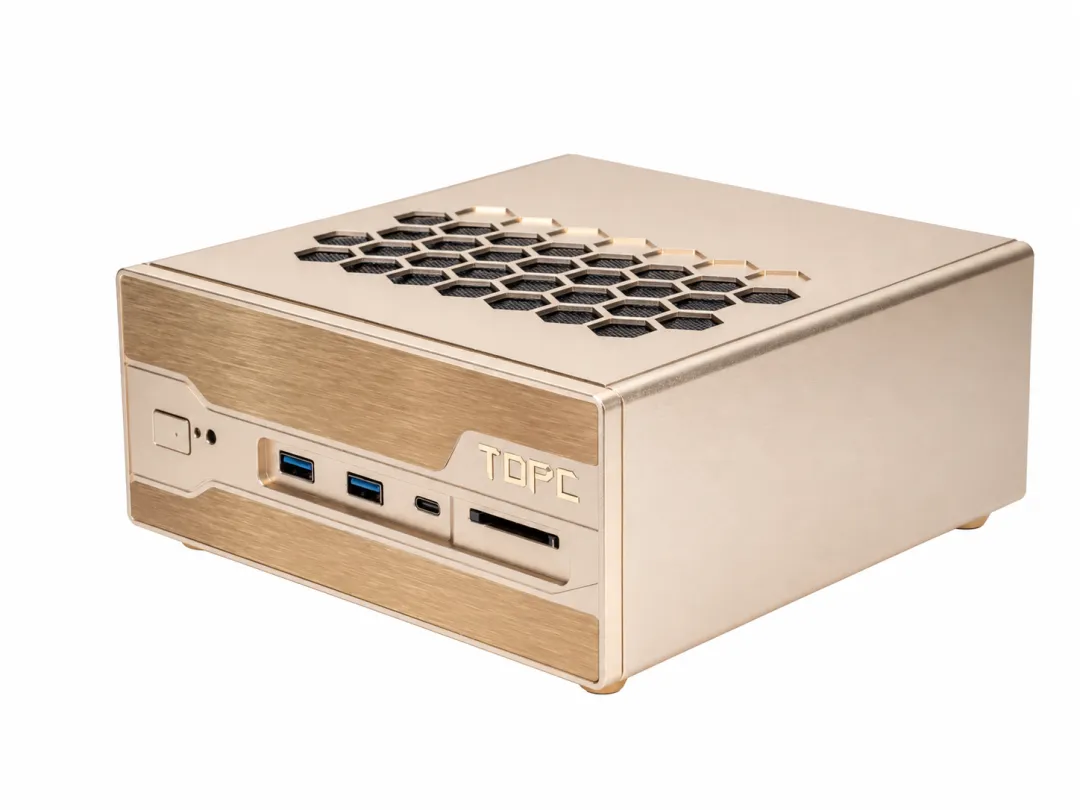
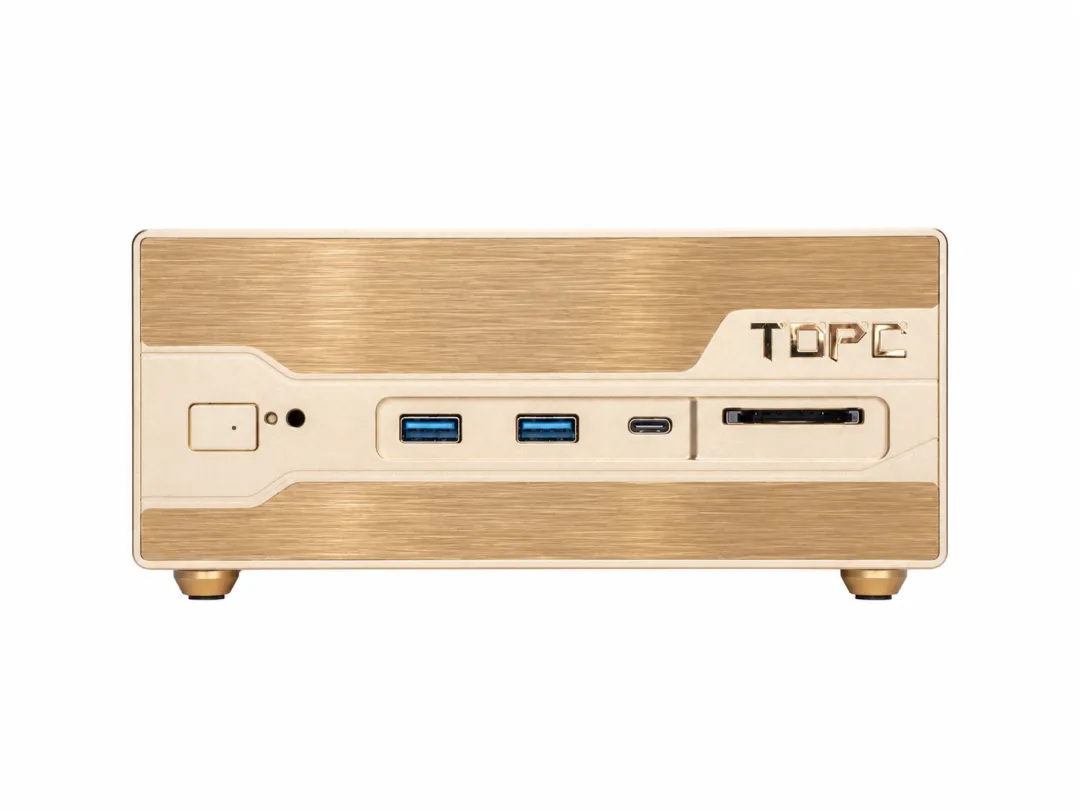
TOPC 是自研主板和迷你主机的厂子,之前 i9-13980HX 的 MODT 板子拿过 HWBOT R23 第一,调校上不算没底。这台机器淡金配色加拉丝前面板,方方正正,蜂窝开孔,摆在桌上挺有设备感。外形见仁见智,但至少不是实验室那种黑铁疙瘩,放宿舍里不算突兀。前置 USB 和读卡器在正面,拷数据集不用绕到机箱后面;背面给了万兆和 2.5G 两个网口,接 NAS、内网传文件都顺,还带 USB4。
价格嘛,45999 元起(2TB 版)。学生党看到这个数肯定得犹豫。但换个算法:云 API 月月烧、租卡按小时烧,还要忍受排队和传数据的折腾,长期用下来,这笔账未必省。而且这机器从内存到存储都给你留了余量,等毕业进了公司,接着当生产力主力也不至于很快过时。
明天发布,等实测数据出来我再细看。就目前放出来的这些配置,这应该是今年迷你主机里对本地 AI 最对症的一台。我的毕设机器,大概率就是它了。