ARTICLE · 1180116
零代码文档驱动大模型开发---AI办公助手系列-阶段小结
从第一篇 word 转 pdf到现在。这一路踩的坑五花八门,但反复在验证的,其实就那么几条沉淀。它们不是灵光一现,而是一次次碰壁之后,慢慢沉淀下来的底层逻辑。这一篇小结,把它们总结一遍。
沉淀一:坐标要唯一基准
这个坑,我踩了三次——第一篇做 word/pdf 互转,PDF 的坐标系上下是颠倒的;第二篇做 PDF 签字,坐标对不上;第九篇做 OCR,图片像素系和 PDF 点系又不一样。
三次踩下来,就一句话:只要有两个坐标系并存,就一定有换算;有换算,就一定有错位。唯一的解法,是定死一个基准,其它所有坐标都往它身上换算。别再问"用哪个系",先定"以谁为准"。
沉淀二:数据不出本机
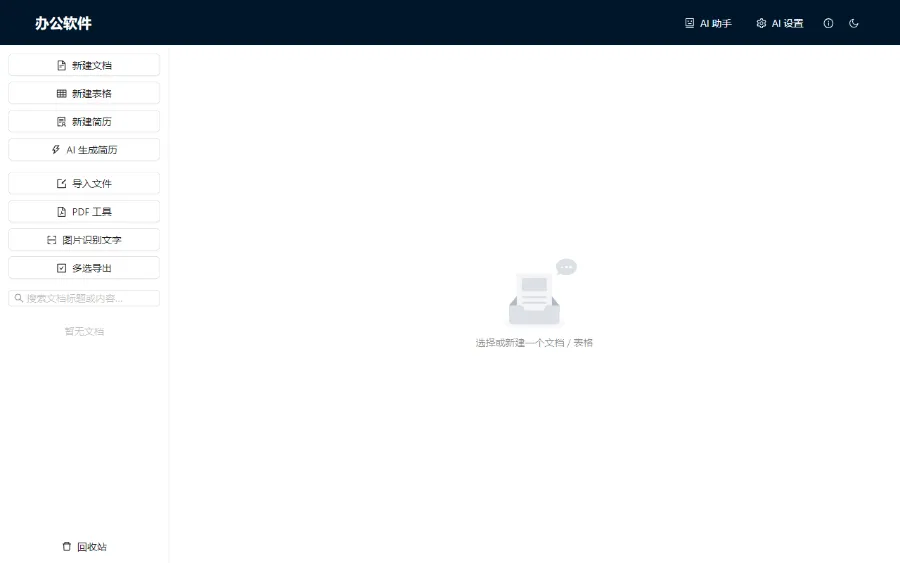
这是整个软件从一开始就立的 flag,贯穿了每一篇:文档存本地、OCR 在本地跑、embedding 用本地小模型、AI 问答走本地检索。
"本地"不只是隐私,更是三样东西——离线可用(不依赖云)、不交出去(数据自己掌控)、用户心里踏实。一个办公软件,最值钱的信任,就来自这句"你的东西,从没离开过你的电脑"。
沉淀三:能加就别改
第十篇做多知识库,最关键的决策是:不动老表,加两张关联表。因为动老结构,等于把已经算好的向量推倒重来;而"加"是增量的,老资产原封不动。
升级一个系统的正确姿势,是"在边上加一张表",不是"把现有的翻个底朝天"。能加、能小改,就绝不大改。
沉淀四:先验证,别迷信
第九篇选 OCR 引擎,一开始迷信"最出名的 tesseract",结果在自家环境里根本跑不起来,死磕半天白费。翻篇到 PP-OCRv4,先拿小样片实测——识别全对、速度够快,才放心往下做。
选型的第一标准,是"在你这里能不能实测通过",不是"别人都夸它"。名头再响,跑不起来就是零。
沉淀五:安全靠系统,不靠自觉
第八篇做数据安全,核心是"别把要命的保护,押在用户会记得上"——删除进回收站(可逆)、每 3 分钟自动快照、编辑防丢 flush,全是系统默认,不用用户操心。
可逆的操作,才配叫"安全";靠自觉的保险,等于没保险。凡是用户可能后悔的动作,系统都要替他留一道后路。
沉淀六:测试不能省
第十一、十二篇,闷头审查了五轮代码,修了 16 个 bug,结果真正会出事的那个时序 bug,五轮一个都没发现,真实点一遍才现形。
静态审查抓得住"逻辑上的错",抓不住"运行时的错"。看代码和用软件是两种感知方式,前者再仔细,也代替不了"像用户一样真实点一遍"。