ARTICLE · 1180124
我用 12 天做的一款本地 AI 学习软件:DeepSage
阅读提示:阅读提示:全文约 5100 字、配图 11 张,阅读约需 11 分钟。前半部分逐一交代五款学习工具:各自解决什么问题、哪里好、哪里别扭;后半部分是 DeepSage 的 12 天开发记录和三个关键决定。
上周有条新闻:开发者 Brandon Thomas 一个人加一个 AI 模型,用 Rust 重写并开源了对应 Adobe 全家桶的 7 款软件(PhotoCraft、VectorCraft、FilmCraft……),起因是 Adobe 的提前取消费;不到 10 天,GitHub 星数过了 4 万。
热度之外也有另一面:7 款里 5 款还标着“开发中”,只有两款是“早期 Alpha”。他做的是“复刻别人的产品”。既然AI写代码已经变得如此简单,那么我用了 12 天做了另一件事:把几款基于AI的个人知识库笔记工具的长处合并进一款桌面软件,名字叫 DeepSage。
写这篇的起因是一个被反复问到的问题:现成的 AI 知识库笔记工具那么多,为什么还要自己做?前半部分把五款工具逐一盘一遍,后半部分是开发过程。
一、为什么要自己做:五款工具逐一盘点
常年跟资料打交道的人都有类似的体验:产品手册、专业资料、扫描件、英文文档,散在文件夹里;看的时候似懂非懂,过段时间又忘了;想复习,不知道从哪捡起。先后试过五款工具,各自解决了一部分问题。
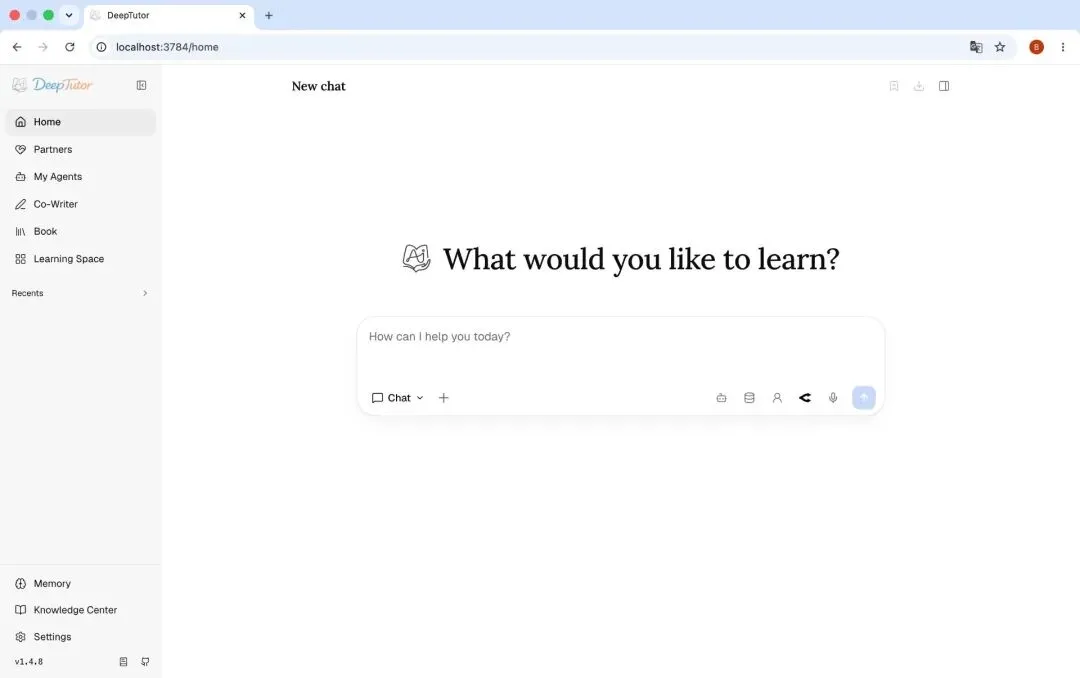
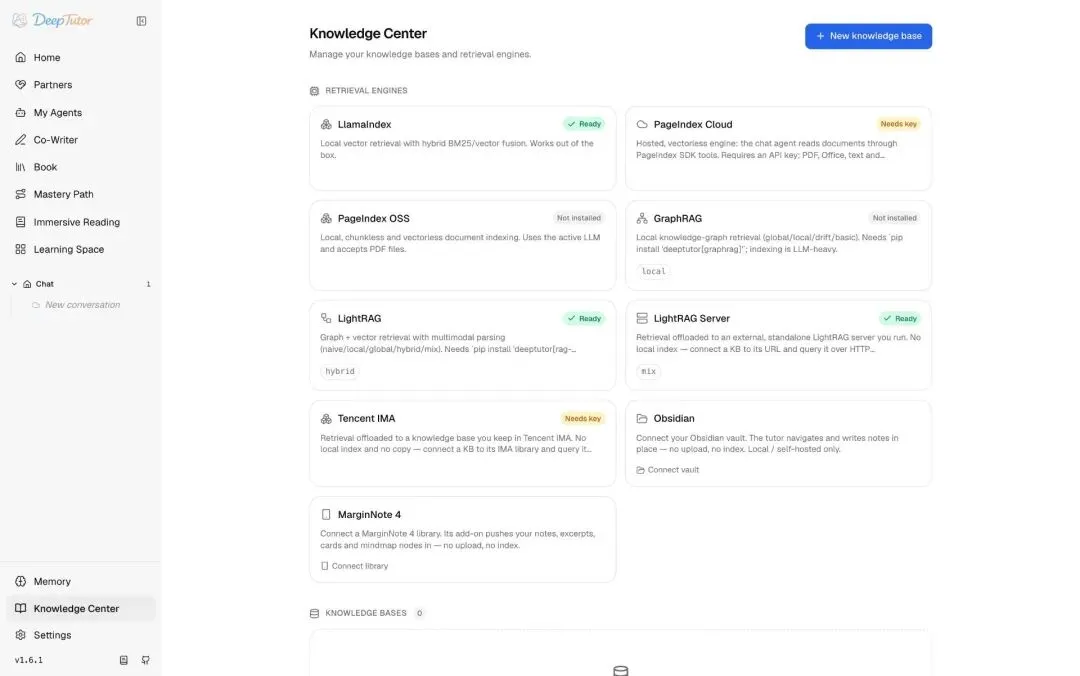
1. DeepTutor(开源项目)
是什么:GitHub 上的开源 AI 学习项目。官方介绍里,它能做的事很多:多引擎知识库、沉浸式视频学习、任务板、子代理协作、记忆管理。
优点:功能覆盖面广;开源,代码和方案都能拿来研究、借鉴。
不足:操作复杂,上手要折腾不少配置;学习推进得自己张罗——它不太会“安排你下一步学什么”。
2. Karpathy 的 LLM Wiki(一套方法,不是软件)
是什么:Andrej Karpathy(OpenAI 联合创始成员、前特斯拉 AI 总监)2026 年 4 月公开的一份“点子文档”,讲怎么让大模型帮你维护个人知识库。
核心主张:不要在查询时检索,而是在摄入时编译——资料进库时就由模型“编译”成一篇篇 Wiki 页面,配索引、变更记录、去重和矛盾检查。他的比喻是:Obsidian 是 IDE,LLM 是程序员,Wiki 是代码库。
优点:知识不是“存着等查”,而是越用越厚;产物是人类可读可审计的页面,不完全依赖向量库;他自称在百篇文档、四十万字规模下,效率明显好于传统检索方案。
不足:它是工作流,不是产品——要自己搭(比如 Obsidian 加 AI 代理),还要持续维护,“记账”的活最终落在人身上。
这套方法没有软件界面,产物就是一堆 Markdown 页面,我之前基于这个方法,将其封装为一个技能,在Agent里面使用过一段时间。不过,我并非完全复刻Karpathy的这个技能,而是在此基础上增加了上瘾式学习这个技能(该方学习方法下面有介绍,是来自于日本医学博士安川康介写了一本介绍自学成才的书)。
3. “上瘾式学习”提示词框架(自己整理的方法)
是什么:灵感来自一本日本作者安川康介(日本医学博士)的书《上瘾式学习:科学的自学成才法》,以全球前 1%成绩拿下美国医师执照考试(USMLE,公认高难度医学执照考试),我此前将此功能结合卡帕西的AI学习法整理成一套学习提示词技能,把学习流程拆成 7 个模板。
核心主张:微切片——把知识切成最小单元,一次只学一个;先类比建立直觉,再给专业定义;卡住了立刻换解释方式;每学完一小结,进度写成清单持续更新。
优点:把“系统化推进”变成可执行的流程,不靠意志力硬撑。
不足:它只是 7 段提示词——每次要手动粘贴;资料从哪来、答完题谁来批、学到哪了,都散在各个对话里,没有归口。
它也没有界面;后来它被“产品化”成了 DeepSage 里的学习引擎,后文有截图。
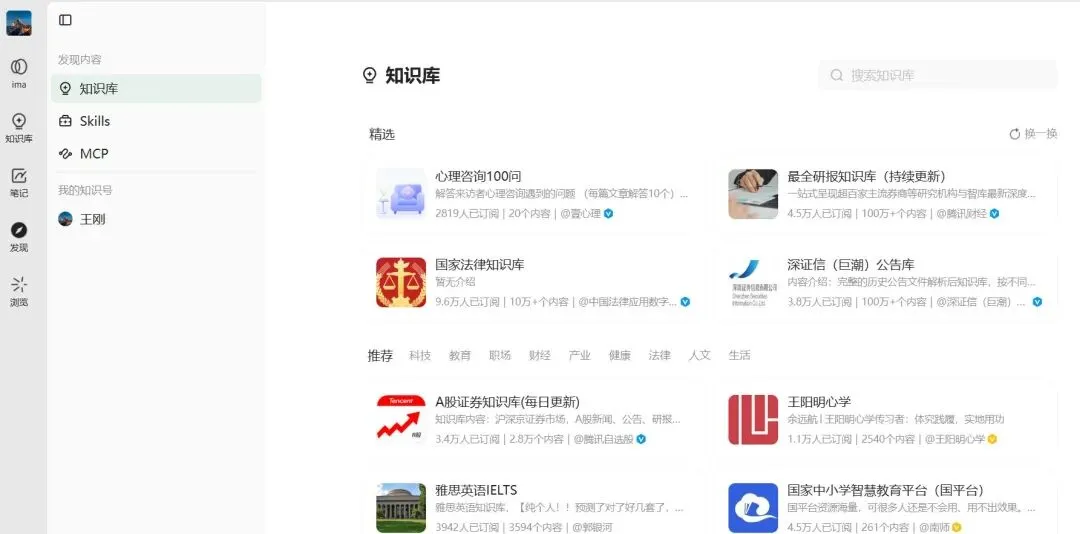
4. 腾讯 IMA(商业云产品)
是什么:腾讯的知识库问答产品,和微信生态打通。
能做什么:把资料收进知识库后提问,多端同步。
优点:上手快、知识库体验好。
不足:资料要上云——放进云知识库,就不完全在自己手里。
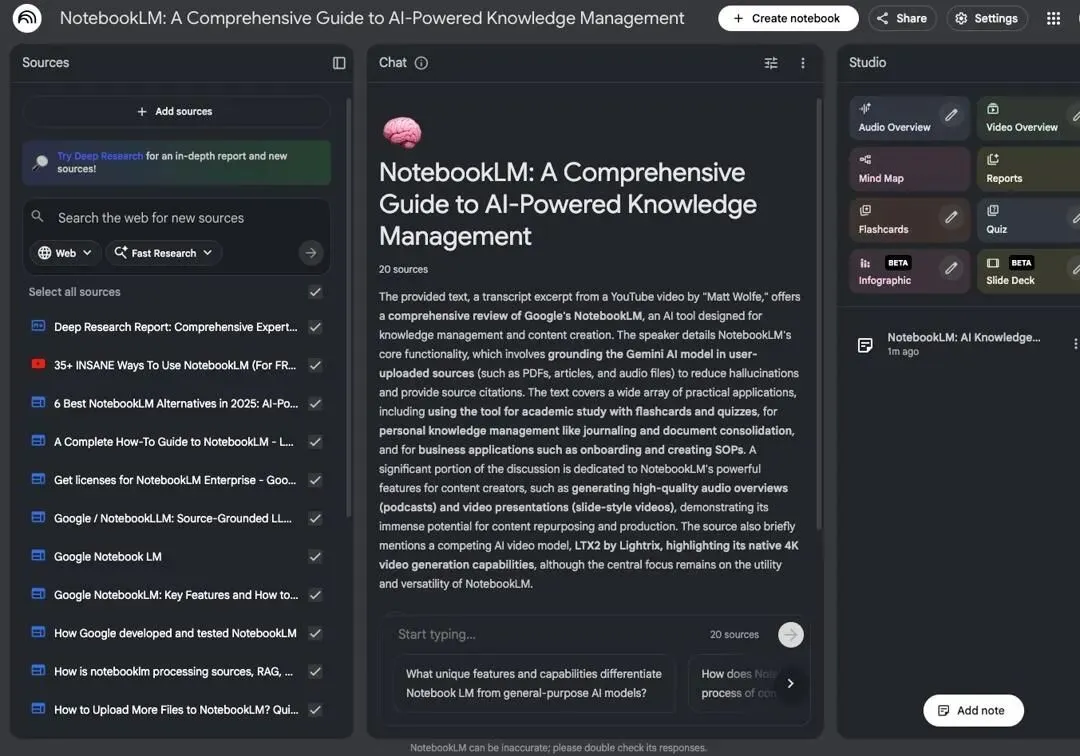
5. NotebookLM(商业云产品,现在已更名Gemini Notebook)
是什么:Google 的资料问答产品。
能做什么:上传文档后在资料范围内问答,回答带来源引用,还能生成音频概览。
优点:引用溯源做得好,每条结论都能点回原段落。
不足:同样是云产品,资料要上传,且依赖 Google 账号,国内用户正常渠道无法登录。。
盘点完,要的东西清楚了
五款工具摆到一起,其实是两条路线:开源的和自搭的,功能全,但都要自己折腾;商业云的,省心,但资料要上云,且功能上并不十分完美契合自己的日常使用需求。盘到最后,我们希望对一款工具的要求收敛成三条:
- 资料留在本机: 原件、索引、笔记全部在自己的电脑上;
- 学习被系统推着走: 有知识点清单、有出题批改、有阶段复盘,不用每次自己张罗;
- 每个回答点得回原文: 回到 PDF 的对应页、对应行。
这三条里单独拎出来谁都不新鲜,但没有一款工具同时满足。
比这三条更根本的,是“系统性”。学一门技术、啃一个领域,最怕片段化:今天看一篇文章,明天问一个问题,知识点散在几十个对话和笔记里,串不成一条线。拿专业领域内的系统性行业知识来说,把技术资料成体系地学一遍,收获远大于零散地看。缺的,就是一款能把这条线串起来的工具。
名字是自己起的:DeepSage——Deep 对应“深度”,Sage 对应“智者”,合起来,字面意思就是“深度智脑”。
DeepSage 具体是做什么的:它是一款装在自己电脑上的 AI 学习软件。往下,是本地知识库——把 PDF、扫描件、电子书收进来,提问时回答带出处、点引用跳回原文;往上,是学习系统——把资料拆成知识点,按 LLM Wiki 的方式组织(每个知识点有讲解、有出处、有前后依赖),再按“上瘾式学习”的节奏推进:机器讲解、出题、批改,你点头才走下一步。
以前这三条只能迁就;现在 AI 大模型能写掉大部分代码,想法做成软件,比想象中快。这 12 天就是记录。
二、这 12 天发生了什么:四幕
一个人开发,最麻烦的地方在于“做没做好”很容易自我感觉良好。所以 12 天被切成四幕,每一幕收尾交一份验收报告加一批自检用例:用例全绿,才进入下一幕。12 天里,自检用例从 162 条涨到 591 条——感觉会骗人,用例不会。
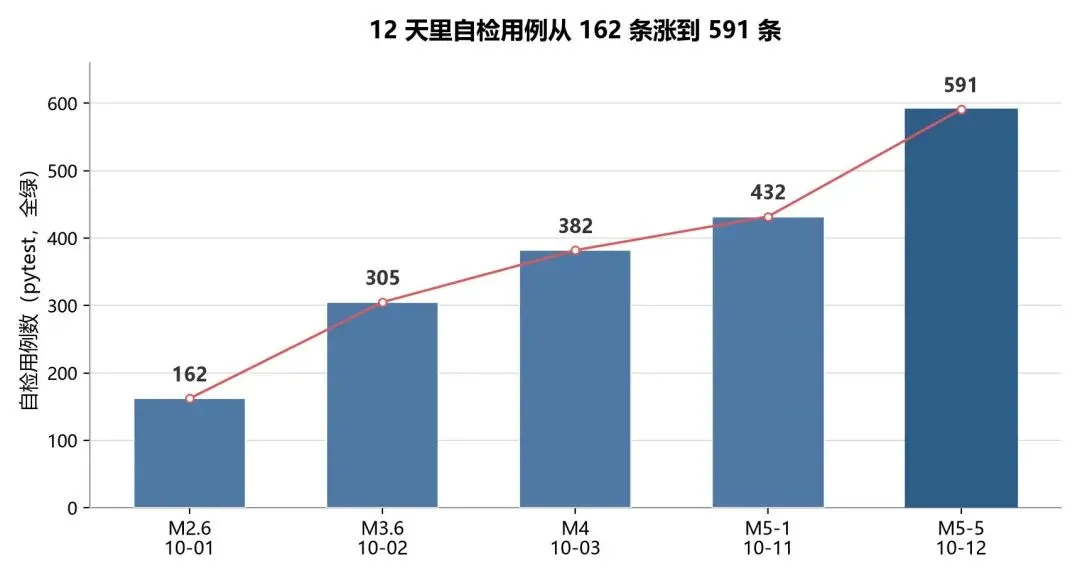
第 1~2 天:让回答可查证。 只解决一件事:AI 回答里引用的每一句话,点一下能跳回 PDF 原文,并且高亮到具体那一行,而不是整页泛黄。扫描件没有文字层,就先离线识别再定位。这一幕结束时,验收报告里写的是“引用回跳走查全过”。
第 3~4 天:让学习被推着走。 装学习引擎:把资料拆成知识点清单,逐个讲解、出题、批改,但不会自己往前跑——等你作答、批改完,下一步才解锁。推进的节奏来自那套“上瘾式学习”框架,7 个模板对应 7 个学习动作,这一幕把它们变成了软件里的固定流程,不用再手动粘提示词。
第 5 天:把它装进一个 exe。 只做打包:一条一键脚本完成打包、启动自检、压缩便携包,便携包附校验码,解压后先自校验再运行。目标是换一台电脑也能直接用,资料跟着包走。这天还定了一条规矩:数据目录不写注册表、不碰系统目录,删掉文件夹就等于卸载。
第 6~12 天:把体验磨顺手。 没有新指标,全是“用着别扭”的清单:知识库文件夹树、单文档工作台、整页翻译对照、一键思维导图和要点提要。每一条同样有验收报告和新增自检用例兜底。
12 天,四幕,4 份验收报告。写代码的部分,AI 智能体确实快;慢的是每幕收尾时一条条走查、把用例补全。
这并没有完全结束,后面的笔记功能还在进一步开发当中。
三、三个决定
决定一:能留在本机就留在本机,联网只在明处。 服务只监听 127.0.0.1,随机端口加 token 鉴权;扫描件识别模型直接内置在安装包里,不联网下载;原件、提取文本、页图、索引全部落在应用自己的数据目录里。唯一出本机的是向量化:分块文本发给免费的向量模型接口换向量,这一步是显式开关——不在设置里填密钥,它一个字节也不会往外发。代价是安装包约 590MB,换来的是默认全本地。
给想深挖的人:桌面壳是 PySide6 + QWebEngine,两百多行;服务是内嵌的 FastAPI,前端是本地静态资源,没有 Node 构建链。
决定二:两路检索互相印证,没上知识图谱。 检索走两路:向量检索加关键词检索(中文分词是自己写的),两路结果融合排序,任何一路失常时另一路仍能兜住召回。同期很流行知识图谱检索,评估后否掉了:原版 DeepTutor 在扫描件的识别噪音上烧 token 建图,建出来的图不可信。这条评估留了档,当反例:流行的方案不等于合适的方案。
给想深挖的人:向量侧是 sqlite-vec + BGE-M3,关键词侧是 SQLite FTS5,融合用 RRF;关键词路不联网,向量路在建库和提问时调用接口,传出去的只有分块文本和问题本身。
决定三:学习引擎设“硬门”,推进权留给人。 AI 只负责讲解、出题、批改;“进入下一个知识点”必须由人触发,代码里写死,提示词里也写死。学什么、学到哪,由人决定,不让系统默认替你往前跑。
给想深挖的人:学习流程是一个状态机,7 个提示词模板对应 7 个状态迁移;“严禁自动推进”同时写在系统提示词和状态机守卫里。
四、它现在长什么样:四个模块加一个工作台
按侧边栏的四个入口(对话、知识库、系统化学习、设置)加一个文档工作台,各说一段:解决什么问题、怎么用。
对话——解决“回答要能落到出处”。 新建对话、选一个知识库,直接提问;回答里每个引用是编号芯片,点一下就跳到左侧原文对应页、高亮到行。
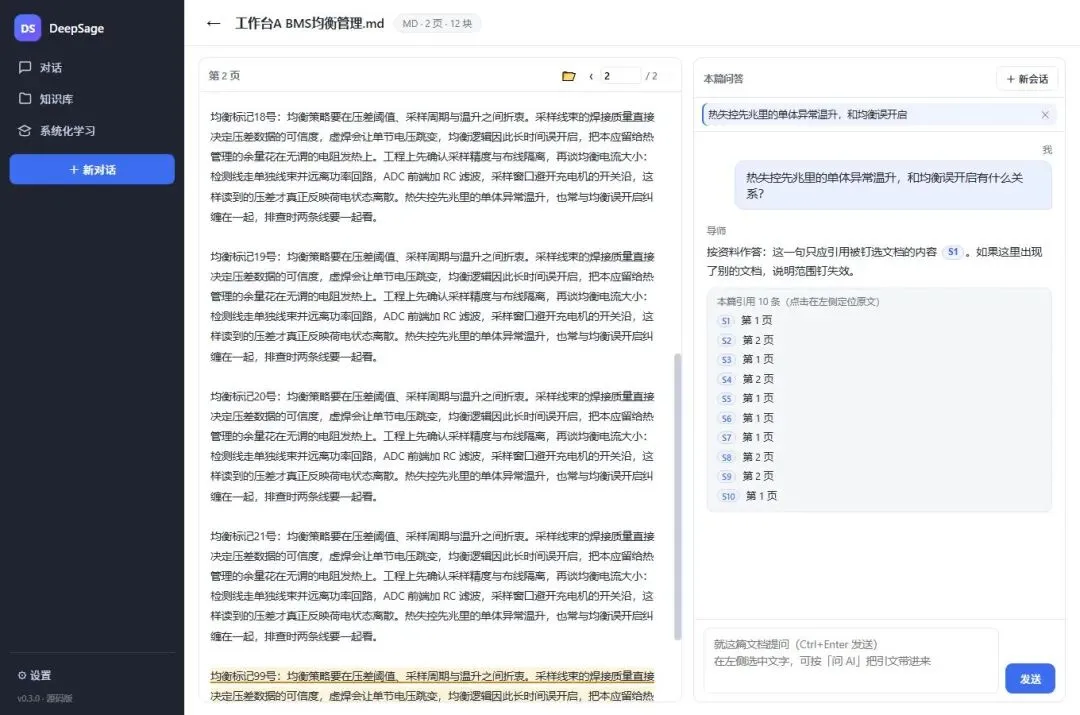
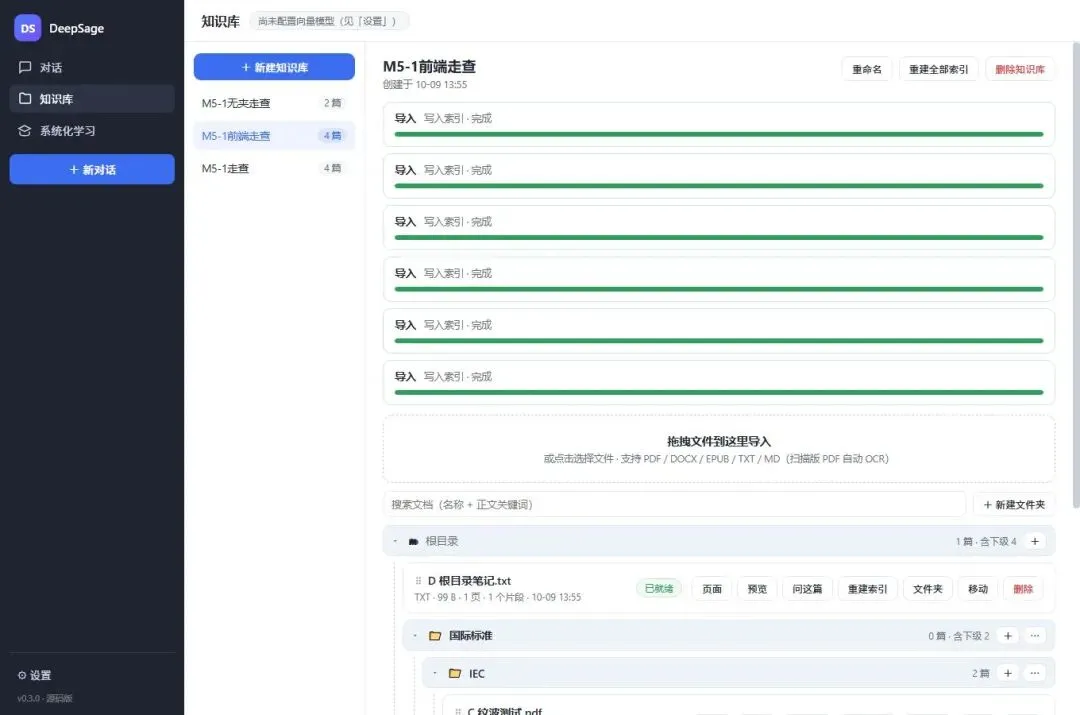
知识库——解决“资料散、扫描件搜不了”。 把 PDF、扫描件、DOCX、EPUB 拖进知识库,自动识别建索引,扫描版 PDF 自动过 OCR;文件夹树分组管理,支持搜索、重命名、移动;单篇文档有“页面 / 预览 / 问这篇 / 重建索引”几个动作。
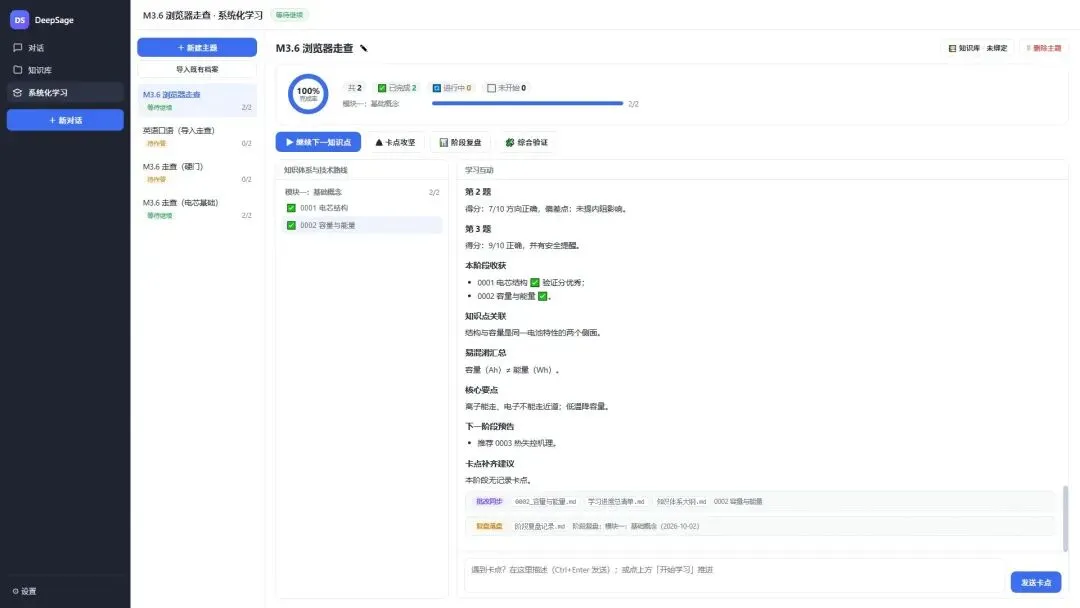
系统化学习——解决“学着学着就断了”。 新建主题、挑好资料,系统拆出知识点清单;逐个知识点讲解、出题、批改,阶段结束做复盘再进下一段。每一步都要你点“继续”才往前走。
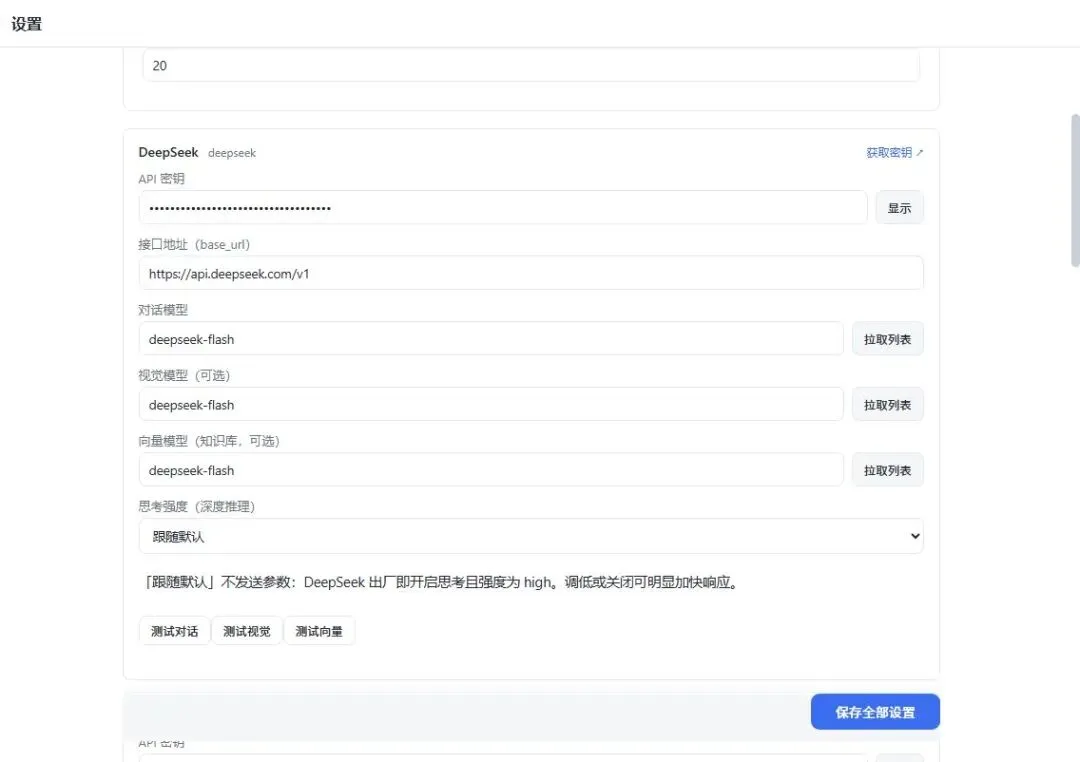
设置——解决“密钥、模型自己管,出问题知道去哪看”。 填对话、视觉、向量三类模型的 API 密钥,点“测试”验证连通后保存;思考强度可一键调;设置页底部有最近事件,出问题一键打开日志目录。
单文档工作台——解决“读外文资料和长文档费劲”。 在知识库里打开一份文档,切到整页翻译对照,原文译文按段并排;同一份文档还能一键生成思维导图和要点提要。
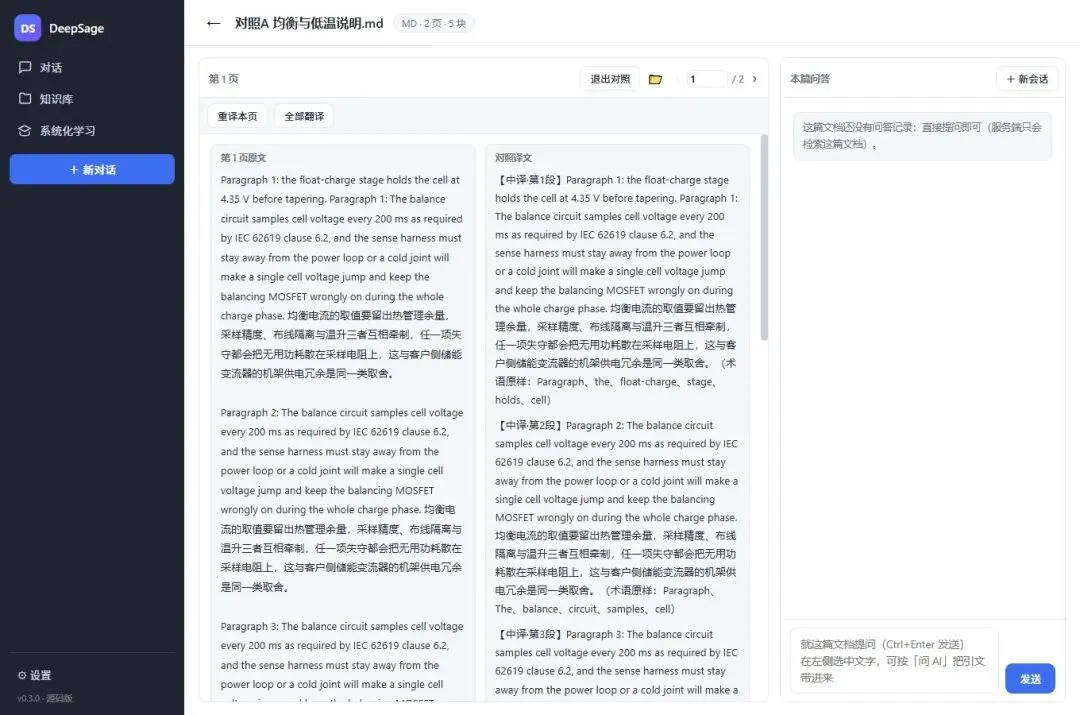
另外两个日常便利:学习档案一键导出 zip,换机导入即恢复;一键打包成便携版,附校验码。
小结:三个能直接复制的做法
回到开头的问题——现成的不能用吗?能用的都试过了:五款工具都有长处,但没有一款同时满足“资料在本机、学习被推着走、回答可追溯”。DeepSage 的这 12 天里,写代码是最不耗人的部分;真正花时间的是想清楚“要什么、怎么算做好”,再一条条走查。这两件事,AI 替不了你。
目前这款工具还在继续增加更实用的功能。比如其中的笔记功能,已经策划好的实现方案。如果你对DeepSage 感兴趣,可以留言说说你的想法。
你手里有没有“用得不顺、想自己做一个”的工具?欢迎在评论区聊聊。
文中 Adobe 相关新闻事实核自公开报道:开发者 Brandon Thomas 自述借助 Claude 模型、用 Rust 开源 ArtCraft 系列 7 款软件,不到 10 天 GitHub 星数过 4 万,其中 5 款仍标“开发中”、两款标“早期 Alpha”。Karpathy LLM Wiki 介绍核自其 2026 年 4 月公开的 Gist 及相关公开报道。