ARTICLE · 1190192
5 年前的机密文档被泄露:Anthropic 的所有胜利,早在 2021 年就写好了
5 年前的机密文档被泄露:Anthropic 的所有胜利,早在 2021 年就写好了
一张五年前的研发清单,兑现如今 AI 行业大半成果。 最近,一场版权官司意外曝光了 Anthropic 一份内部机密文件《Concise Research Roadmap》,这是 Anthropic 五年前的研究路线图。 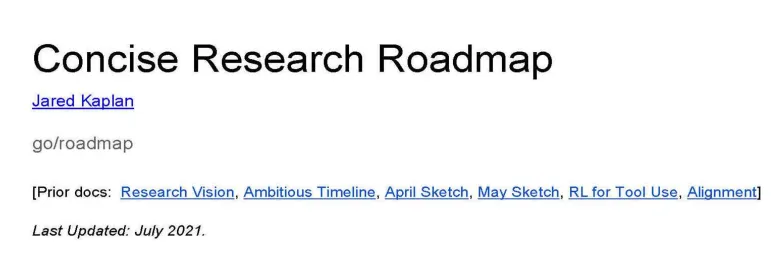
这个文档由 Anthropic 联创 Jared Kaplan 撰写,只有三四页,却出现了我们今天讨论的Coding Agent、Tool Use、长上下文、RL、自动化反馈,甚至Agent的安全问题...... 这份文档汇集了Anthropic “最强大脑”们密密麻麻的批注。比如,Anthropic 联合创始人Tom Brown 指出“仓库浏览是简单、高价值的切入点”,系统与可解释性研究科学家 Nelson Elhage 则预判“自动查找项目里的类型定义”会是极具用户价值的功能。 面对“最强编程助手”与“工具能力演示”的路线之争,CEO Dario 当场定调:“短期先演示工具使用,长期打造最强编程助手。” 对齐科学家 Amanda Askell 则提出了更深层的担忧:“如果只在自然语言领域做对齐,却在代码领域做能力研究,势必产生脱节。”她强调,安全与能力在任何阶段都必须紧密绑定。 要知道,那一年 Anthropic 刚成立半年,全部融资仅 1.24 亿美元。那时距离 ChatGPT 引爆全球还有 16 个月,距离 Claude 1 发布还有 20 个月。整个行业还在怀疑大模型是不是过渡产品。这群从 OpenAI 出走的人,已经一步步计划着"实现极高 GPU 利用率""研究长上下文""工具使用的强化学习""对社会影响的评估框架"...... 之后的五年,他们兑现了路线图上的每一个分支,更是交出了一份惊人的答卷。从Claude 1 到 Opus 5,从宪法 AI(Constitutional AI)到可解释性,再到近期的 Computer Use、MCP 协议、Claude Code、混合推理,都能在 2021 年那条路线图里找到锚点。 
2021年,ChatGPT 还未问世,整个行业都在摸索大模型落地方向。而 Anthropic 却在内部文档中明确写出 AGI 的核心路径,那就是做有长记忆能力的大型生成式模型,并通过结合自动化奖励与人类反馈的强化学习(RL)完成微调。所有的研究项目,都是以这个中心做的探索实验。 他们认为,检验这套路线的第一个载体,就是“对话式软件工程师助手”。它能通过对话完成软件的创建、编辑与讲解,能写函数、找 Bug、设计 API,还能讨论代码风格与工程最佳实践,最终达到一名软件工程师同事的水准。 这正是今天 Claude Code 的具体雏形。 Dario Amodei 为此定下两步走的落地节奏:短期优先完成能力验证,长期打磨深度生产力工具。团队从打印调试、代码仓库浏览这类轻量化工具能力切入,再逐步拓展到代码执行、自然语言文档编辑等更复杂的工具能力。 围绕这个目标,他们把 “规模化” 放在了所有研究方向的最首位,从一开始就为万亿参数规模做准备。 Jared Kaplan 是 Scaling Laws 理论的第一作者,他把这套认知从 OpenAI带到了 Anthropic,早早就在思考如何训练万亿(1T)乃至更大规模的模型。 除了超大参数模型本身,他们还讨论如何拉高 GPU 利用率,提前适配 TPU、Trainium 等下一代硬件;怎么把块稀疏注意力这类复杂工程封装起来,让非专业人员也能轻松配置超参数;怎么给大模型权重这类核心资产搭好安全防护体系。 Anthropic 还非常重视预训练与数据。 他们从一开始就打算训出行业性能最优的语言 + 代码双料基座模型,给后面所有的微调、功能探索、能力迭代当好底子。他们早早开始搭建全链路高质量数据集,不仅有自然语言和代码,还覆盖了 Diff(版本差异)、PR(拉取请求)、调试记录以及代码运行的评估结果,完整覆盖软件开发的全流程数据。 数据质量上他们也抠得极细,从数据过滤、迁移、微调到多样性优化,全套流程挨个打磨,这样打好数据底子,后面在更高级的强化学习环境里做对比实验、能力迭代,才不会走偏。 同时,他们提前攻坚支撑万亿参数甚至更大规模的机器学习底层技术,同步探索超长上下文能力,或是研究能封装海量记忆与经验的等效外挂方案。 能力与对齐同步推进,是 Anthropic 在文档中提出的另一大特色。 Amanda Askell 在文档评论中提前预判了代码能力与对齐研究脱节的风险,一方面代码能力持续增强,却缺少对应的对齐约束;另一方面对齐研究依赖的模型能力不足,也会限制测试的深度和成果的实用价值,长期下来,对齐研究就会变成与能力发展脱节的 “信息孤岛”。 因此,她要求各领域的能力研究与对齐研究应当按比例同步推进,安全不能等模型能力成熟后再补上。 围绕这条原则,Anthropic 规划了一套具体的研究方向。他们用人类反馈训练模型,不止让模型会答题,更要能主动提供帮助、根据反馈调整行为、在用户意图模糊时主动澄清问题。团队系统梳理对齐失效的场景,按难度分类归因,专门研究对齐效果随模型规模的变化规律。 连指导训练的奖励模型本身也被反复校验:在合规人类反馈数据、Stack Exchange 等静态数据集、GAN 对抗生成数据上交叉验证,确保奖励信号真正贴合人类意图,在不同数据源下都足够可靠。最终这些实验都会沉淀成通用方法论, 人类反馈怎么用效率最高、不同对齐目标需要多少数据与资源投入,全部量化落地。 这也是为什么 Claude 能率先打入金融、医疗、法律等高合规行业。 Anthropic 还在持续投入 “可解释性” 的长期探索。 Anthropic 想弄清楚模型内部究竟发生了什么,为此,可解释性领域的代表学者 Christopher Olah,专门拆解大模型的神经元、注意力头与内部功能回路。Olah 还提出,要把数据、工具方向的研究和可解释性工作结合在一起。 他们希望从底层机理搞清楚:算术推理、多轮对话、代码生成,究竟如何在神经网络内部实现。 他们把RL for Tool Use列成了一项重要研究方向。研究的核心是让大语言模型学会使用工具,理解环境和目标,并通过强化学习不断改进。 当时,他们已经把信息检索、打印调试(printf debugging)等任务列入研究计划。这些任务既有实际价值,也能用来检验:模型接入工具后,能否突破单纯生成文本的能力边界?相比监督学习,通过工具交互和强化学习来训练,能否获得更好的缩放效果和更高的算力效率? Dario Amodei 的视野并不局限于代码场景。他还提出,自然语言编辑器同样值得探索,比如让模型在类似 Google Docs 的环境里修改文档,既能产出高价值的安全研究成果,也具备广阔的应用场景,而支撑这两类编辑器的工具与底层基础设施,很多都是通用的。 他们真正想验证的是:模型能否从 “生成答案”,走向 “借助工具完成复杂任务”。如果这条路线成立,能力边界就能从软件开发延伸到更多知识工作场景。 而安全考量始终贯穿在所有研究方向里。 这群科学家从第一天起就带着一股极客的理想主义。Sam McCandlish 在当时就抛出了灵魂拷问:“怎么安全地部署非沙箱化工具?”Dario 更是预警:部署阶段可直接执行代码的工具风险极高。如今回看 Agent 赛道天天热议的沙箱隔离、权限拦截,全在他们当年的推演之中。 不仅如此,他们还想把公司打造成 AI 伦理研究的“山巅之城”,拉上学术界、政府一起做独立评测,用最高标准的安全框架为全行业树立规范。 最终这一切共同构成了 Anthropic 全栈闭环的研究版图:从底层算力工程(GPU/TPU 适配、训练效率)、模型基座(预训练、数据工程、长上下文)、核心能力(工具调用、代码生成),到安全体系(对齐、可解释性、权重安全),再到社会治理(第三方评估、行业生态),形成了一套完整且没有明显短板的 AGI 研发闭环。 
不少网友看完这些讨论,直接称神。“原来我们现在抢着做的Agent,是人家的代办清单。” 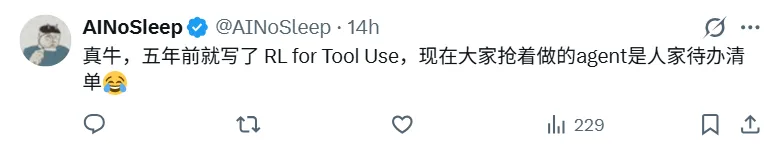
还有网友表示,对于前沿研究员来说,有这样的见识或许不算稀奇,不少已经成为共识。但真正能把这些研究路线做出来不跑偏,才是真的了不起。 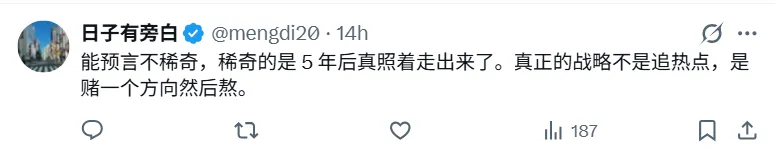
五年后的今天,Claude 已经能一次处理 1M token 的长文本,还进化出了专门适配工程场景的记忆优化方法,大模型已经迭代到了 Opus 5.5。在安全调校这条线上,也从最早靠人工标注反馈的训练方式,进化到 “AI 监督 AI” 的宪法式训练,再到如今的混合方案。 当年文档中的那些研究路线,变成了Anthropic每一个转折点的战略方向。 2022年,Anthropic 率先在最核心的 “对齐” 赛道,拿出了颠覆行业认知的方法论。 2022 年底,ChatGPT 凭借 RLHF(人类反馈强化学习)一夜爆火,把大模型带进了大众视野。但这套方法的痛点也很明显:要雇大量人做标注,成本高、难规模化,还容易把标注人的个人偏好带进去。 就在 ChatGPT 发布半个月后,Anthropic 发表论文提出 “宪法 AI” 思路:先给模型定一套行为原则,再让一个模型去评判、修改另一个模型的回答,反复迭代之后,模型就能做到既有用又不越界。 对内,它解决了安全调校跟不上模型能力增长的问题,刚好回应了团队早期 “能力和安全要同步推进” 的担忧;对外,它定义了 Claude 系列鲜明的产品特质,礼貌、克制、不主动越界,和同时代 GPT 模型形成了极强的辨识度。 搞定了训练方法,Anthropic 开始把模型做大、做长,2023 年在产品和算力两条线上同时破局。 这年 3 月,第一代 Claude 正式对外合作,主打长文本处理和安全属性,用过的人普遍觉得它比同期的 GPT-3.5 “礼貌得多”。这是 Anthropic 第一次拿出面向市场的实体产品。 5 月,Anthropic 把 Claude 的上下文窗口从 9K 一口气扩到 100K token,相当于 7.5 万英文单词;两个月后的 Claude 2 公测延续了这一能力。作为对比,当时主流的 GPT-4 仅能支持最高 32K(约 3 万多 Token)的上下文,而 Anthropic 自家的上一代模型更是只有不到 10K 的容量。这一跨越式的长文本能力,让一次性读懂整本书或整个代码库成为了现实。 安全体系也在同步落地。9 月,Anthropic 发布首版《负责任的缩放政策》(RSP),给模型的潜在风险划分等级,能力越高,安全管控就越严,这是行业里第一套成体系的动态安全机制。 到 2023 年 10 月,Google 领投的一轮让 Anthropic 估值站上 184 亿美元。全球大模型行业告别了早期的 “一超多强”,开始隐隐显现出两家顶尖独立实验室双雄并立的雏形。 这一年全球 AI 圈也风起云涌,GPT-4 发布树立新的能力标杆,OpenAI 成立专门团队押注长期安全,马斯克创办 xAI,谷歌整合 DeepMind 推出 Gemini。国内则开启 “百模大战”,百度、阿里等大厂的大模型集中亮相,智谱、月之暗面、深度求索等创业公司也开启密集融资。 2024 年是 Anthropic 的爆发年,在各个方向都拿出了代表作。 3 月,Claude 3 系列一次性推出三款产品,覆盖旗舰、均衡、轻量三大场景,并补齐了多模态能力。其中旗舰模型 Opus 默认支持 100K 的处理长度,在长文本评测中表现出极高的准确率,首次反超 GPT-4,将长上下文技术转化为扎实的产品竞争力。 随后在 6 月登场的 Claude 3.5 Sonnet 模型能力迎来大幅提升,在多项核心指标上追平 GPT-4o;到 10 月推出升级版时,该模型在代码评测集 SWE-bench Verified 上超过了当时所有闭源竞争对手,让 Anthropic 在软件工程与智能体开发市场中取得了明显的竞争优势。 真正让 Anthropic 拉开身位的,是 2024 年 5 月掀起的那场可解释性热潮。 2021年,“可解释性” 和 “工具使用强化学习” 还听起来都过于学院派,远不如堆参数、刷榜单来得实在。 2024 年 5 月,Anthropic 团队利用稀疏自编码器(SAE)成功对 Claude Sonnet 内部的数百万个特征进行了“内部扫描”,从模型里提取了3400万个特征,还定位到了 “金门大桥”“程序漏洞” 这些具体概念对应的内部回路。为了证明不是纸上谈兵,他们还做了个实验:手动激活 “金门大桥” 对应的特征,让模型不管回答什么问题都绕不开金门大桥。 这是人类第一次在商用级大模型上,做到对内部机制的精准解释和操控。这意味着 AI 安全研究从此不用再 “开盲盒”。而同期 OpenAI 也在做相关研究,却一直没公开具体进展;国内学术界有跟踪,但几乎没有产品级验证。这条赛道上,2024 年的 Anthropic 几乎一骑绝尘。 10 月,新版 Claude 上线 “电脑操作” 功能,模型能像人一样看屏幕、点鼠标、敲键盘,自主操作桌面软件。 才过一个月,Anthropic 又开源了 MCP 协议,把模型和各种工具、数据之间的连接方式统一了,相当于 AI 应用的 “通用接口”。 这掀起了 MCP 热潮,2025 年第一季度,OpenAI、谷歌先后宣布支持 MCP,国内阿里、腾讯、百度、支付宝也在四个月里密集上线相关服务。从各家自己做工具接口,到统一用 MCP,行业半年内就完成了站队。这是 Anthropic 第一次不是在模型能力上,而是在基础设施层上让对手跟进。 2025 年,Anthropic 把重心放到了智能体上,主战场选在了软件开发。 2 月 24 日,Claude 3.7 和 Claude Code 一起发布。前者能切换 “快答” 和 “深度思考” 两种模式的模型,用户可以自己控制思考程度;后者则是专门的编程助手,能自己翻遍整个代码库、查类型定义、调 bug、提交代码、跑测试。 这一刻,2021 年文档里的所有讨论都成了现实:从 “仓库浏览是个好切入点”,到 “先演示能力、再做生产力工具” 的节奏,全部分毫不差落地。大模型不再只是聊天工具,成了真能在电脑前干活的 “ AI 同事”。 5 月发布的 Claude 4 系列,又把长时间连续工作的能力提上新高度。旗舰版能连续几小时执行编程任务,在多项编程测试里都拿了第一。到 9 月的 4.5 版本,编程和智能体能力再上台阶,AI 能力达到初级工程师的水平。 同期,面向办公场景的产品也陆续推出,Anthropic 的生产力工具从程序员群体拓展到普通白领。到了 9 月,Anthropic 完成新一轮融资,估值冲到 1830 亿美元左右。 进入 2026 年,竞争到了更深的层面。 从 5 月到 10 月,Anthropic 密集更新 5.5 代全系列模型,从旗舰到轻量依次推出,多模态、深度思考、智能体三项能力同步成熟。产品不再追求单点能力爆发,而是转向 “产品级可用性” 的全面打磨 生态话语权也越来越重。MCP 已经成了全球 AI 工具的事实标准,从模型厂商到应用开发商都在接入,Anthropic 真正从 “做产品的” 变成了 “定规矩的”。而安全框架、第三方安全测试、行业前沿论坛这些持续推进的动作,也在一步步兑现当年 “打造机器学习山巅之城” 的愿景 如今全球 AI 行业,已经形成 OpenAI、谷歌、Anthropic 三家领跑的稳定格局。 五年间行业风口换了一轮又一轮,无数公司追着热点调转方向,而 Anthropic 始终沿着当年画下的线稳步推进。很多人说 Anthropic 是踩中了时代运气,但这份泄露的文档证明,他们如今的成果,本质上都是早有预谋的技术兑现。在行业摸黑赶路的时候,有人早已看清了地图,然后一步步走到了终点。 参考链接: https://i.smitop.com/concise-research-roadmap.pdf 
// 推荐阅读 
作者丨高允毅
编辑丨岑 峰
01
2021 年的 Anthropic,
究竟看清了什么?
02
这五年,Anthropic 都做了什么
2024 年,Anthropic 估值从年初的 184 亿涨到年底的约 410 亿。估值飞涨的背后,是产品开始真正跑通收入,当时 Claude 的年营收已经突破 10 亿美元。
上车,带你看遍全球 AI 顶会精华
可独家畅览:
专家演讲PPT
大会报告全文
热门论文解读
学术新星访谈
扫描上方二维码
或点击「阅读原文」关注专区。
未经「AI科技评论」授权,严禁以任何方式在网页、论坛、社区进行转载!
公众号转载请先在「AI科技评论」后台留言取得授权,转载时需标注来源并插入本公众号名片。
未经「AI科技评论」授权,严禁以任何方式在网页、论坛、社区进行转载!
公众号转载请先在「AI科技评论」后台留言取得授权,转载时需标注来源并插入本公众号名片。