ARTICLE · 1194195
Caveman:一个让 AI 编程助手少说废话、也少读垃圾的开源工具
今天给大家推荐的项目是 Caveman。它做的事情很直白:让 AI 编程助手话变少、读变少,代码该多精确还是多精确。它一边把回答压缩成短句,一边在本地架一个代理,把日志、JSON、CSV 这些"噪音"压扁再喂给模型。
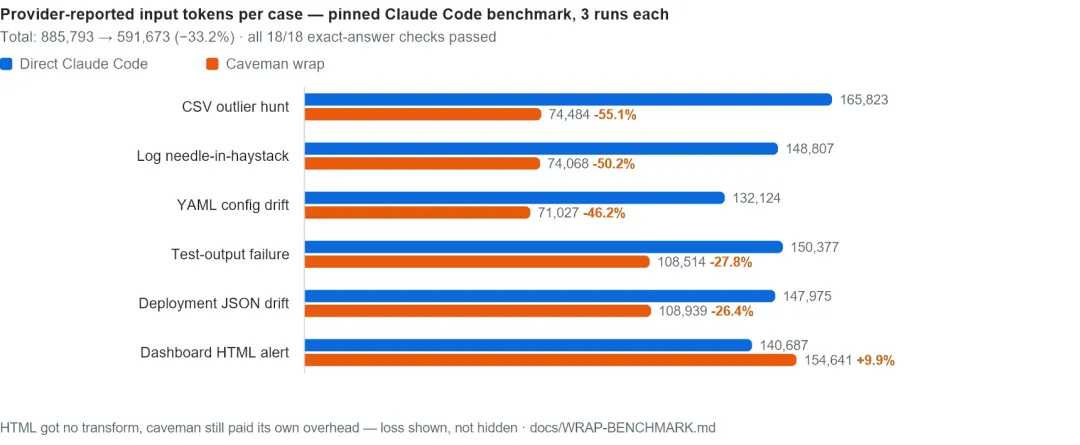
为什么值得关心?因为它省的是真金白银。按官方基准,整段会话的输入 token 少掉 33.2%,18 道题答案全部答对;另一项实验里,费用降到原来的不到一半。
❝项目名称: Caveman
主要语言: Go、JavaScript、TypeScript
Stars: 112.3k
Forks: 6.5k
项目链接: https://github.com/JuliusBrussee/caveman
你有没有算过,AI 助手到底"废话"掉了多少钱?
用 AI 写代码的人多半熟悉这个体验:你问一个小问题——为什么这个组件老是重新渲染——它先来一句"这是个很好的问题",再复述你的提问,展开三段背景,最后才给两行修改建议。真正有用的部分可能只占三分之一。
更贵的还在后边。为了排查一个报错,助手会把整份日志读进上下文,几十万 token 的"噪音"里只有一个关键字段。按 token 付费,你就得连噪音一起买单。
Caveman 的回应分两条线:管住嘴——用技能包改变助手说话的方式;管住眼睛——用本地代理压缩它读到的东西。
从"少说"到"少读":四个真正决定价值的能力
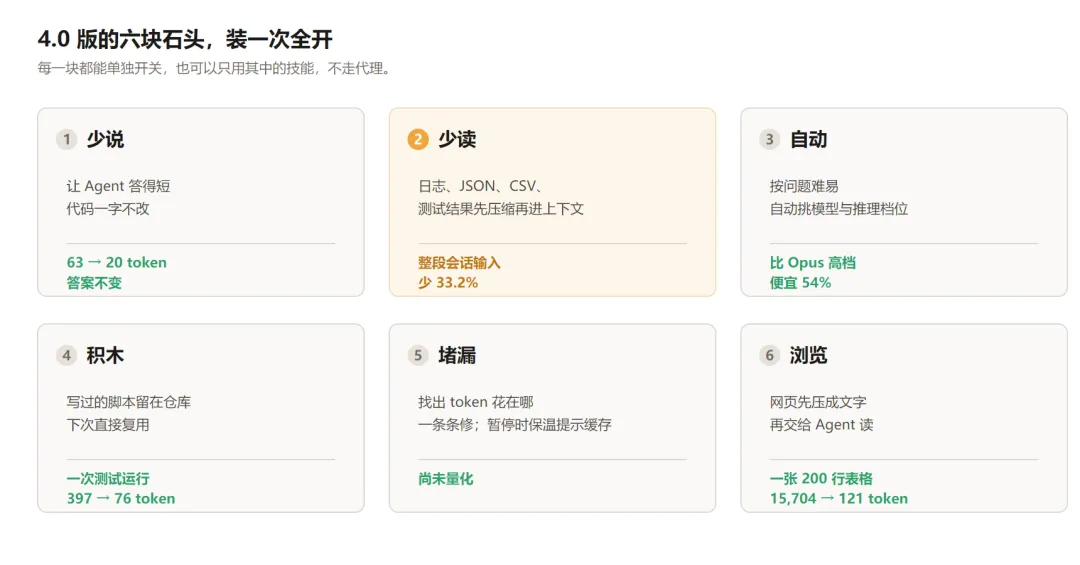
少说:短句,但意思一个不丢
它定义了一套回答规范:结论先行,一句一个意思,单句不超过 20 个词,参照的是 ASD-STE100——飞机维修手册用的受控英语标准,本就为"不能有歧义"而设计。
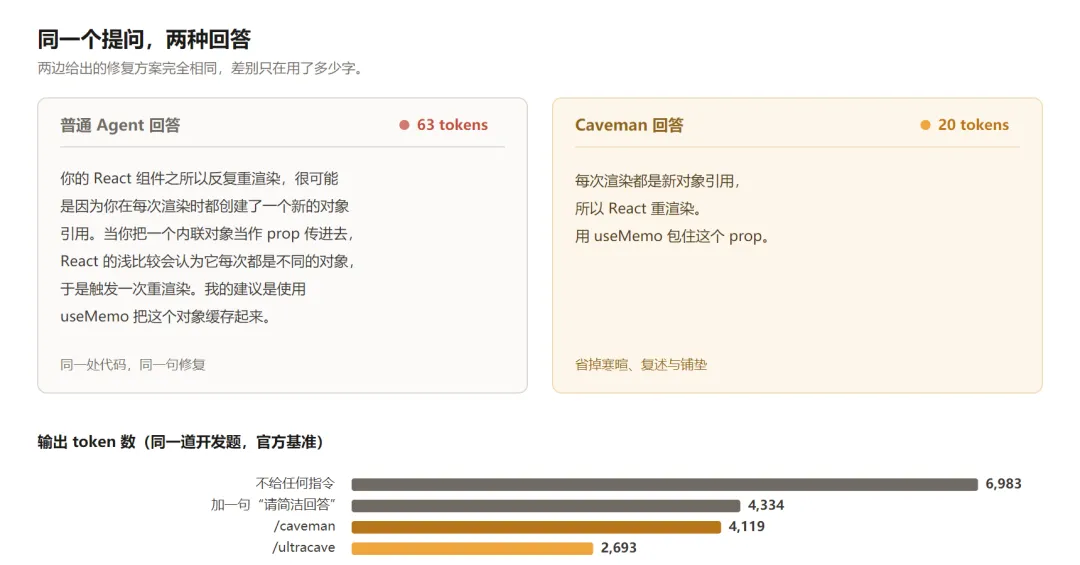
关键在于克制。代码、命令、路径、报错信息逐字符保留;not、never、no、only 这类否定词不许省略;数字和单位照抄。官方 README 的对照是:同一个 React 修复建议,普通回答 63 个 token,压完 20 个,方案完全一致。它还知道何时收手——安全警告、不可逆操作、你没看懂需要反问时,切回完整句子。
少读:把日志和表格先压扁
这是 4.0 版新增的代理能力。官方基准里,一份 28,041 token 的 CSV 压到 314 token,压缩率 98.9%;日志从 22,810 压到 348。放到整段会话尺度,输入 token 从 885,793 降到 591,673。原文不会丢——压缩前字节先完整存到本地,助手随时能取回。
按难度自动分配算力
同一个模型档位跑所有任务,是浪费的主要来源。Caveman 给模型选择器加了 Auto 选项,简单提问降档、困难提问升档。85 道真实编程题上,它解题率 43.7%、每次尝试 3.59 美元,全程高档位 Opus 5.5 则是 44.3%、7.83 美元——省掉 54%,耗时也少一半。
官方自己标了"诚实说明":这轮测试才做了一半,0.5 个百分点的差距在样本量下分辨不出优劣,且大部分节省来自对简单问题的降档。
把写过的脚本留下来
AI 助手习惯每次排查都现写脚本、跑完就扔。Caveman 的 Blocks 把它们沉淀进仓库,形成可复用的"积木"。一次 go test -v ./... 的结果,助手自己写管道读回来是 397 token,用现成积木只要 76。
技术实现:一个换掉 base URL 的本地代理
Caveman 主体用 Go 写成,另有 JavaScript、TypeScript 的 CLI 和插件,Apache-2.0 协议开源。架构是几个各守一段边界的小进程:
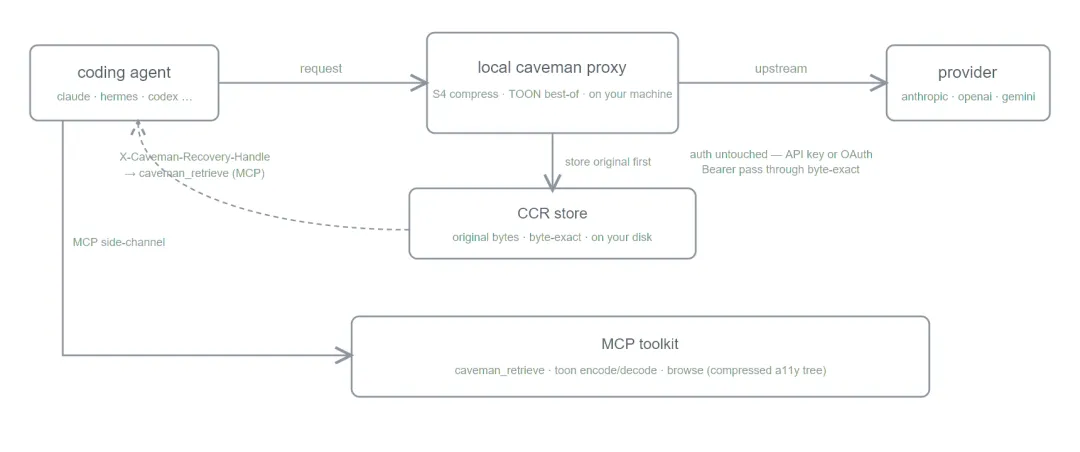
代理层( caveman-proxy)跑在127.0.0.1上,做法是把助手的 base URL 换掉,流量自然流经它。这是它"零代码改动"接进现有工具的原因——请求格式与认证方式保持原样,API 密钥逐字节透传。引擎层( caveman-engine)先识别内容类型再挑压缩器,内置 16 种,覆盖 JSON、日志、测试报告、diff、终端输出等。存储层(CCR)是本地 SQLite 库,保存压缩前的原始字节。默认上限 512 MiB,存满后新请求放行原始内容,已存的句柄不会被挤掉。 交互层有两条路:命令行 caveman用来安装和查看状态;caveman-mcp通过 MCP(模型上下文协议)在助手内部提供取回原文的工具。
最值得称道的是失败处理:任何一步出错都退回"原样转发",绝不编造结果。
上手指南与几个要留意的限制
安装只要一条命令,需要 Node.js 22.13 及以上:
运行 npx @caveman-ai/cli@latest,它会识别你装了哪些助手,展示将要改动的内容;确认后按回车,Claude Code、Codex、Gemini CLI、opencode 等 30 多个助手一并接上; 用 caveman status看当前开了哪几项,caveman off browse单独关掉某一项;只要"少说"、不要代理,换成 npx skills add JuliusBrussee/caveman -g。
限制也写在明处。命令行默认上报使用统计(命令、token 数、系统信息,不含提示词和代码),可用 caveman telemetry off 关掉;技能包本身不联网,但 Auto 需要登录并向官方云服务发送最近的提问。用 GitHub Copilot 按次计费的人,回答变短并不省钱;HTML 目前没有压缩器,那一项反而多花 9.9%。Blocks 仍是预发布状态,只有 Python 版本。
值不值得试?
Caveman 最值得关注的地方,不是"话少"这个玩笑式卖点,而是它把 token 优化拆成可独立开关的几块:管输出、管输入、管模型选择、管脚本复用。每一块都有对照数据支撑——Adobe Research 的论文测到成本降低 1.4 至 2.4 倍,JetBrains 对 86 道真实题做配对 A/B,结论是没有可测量的质量损失。
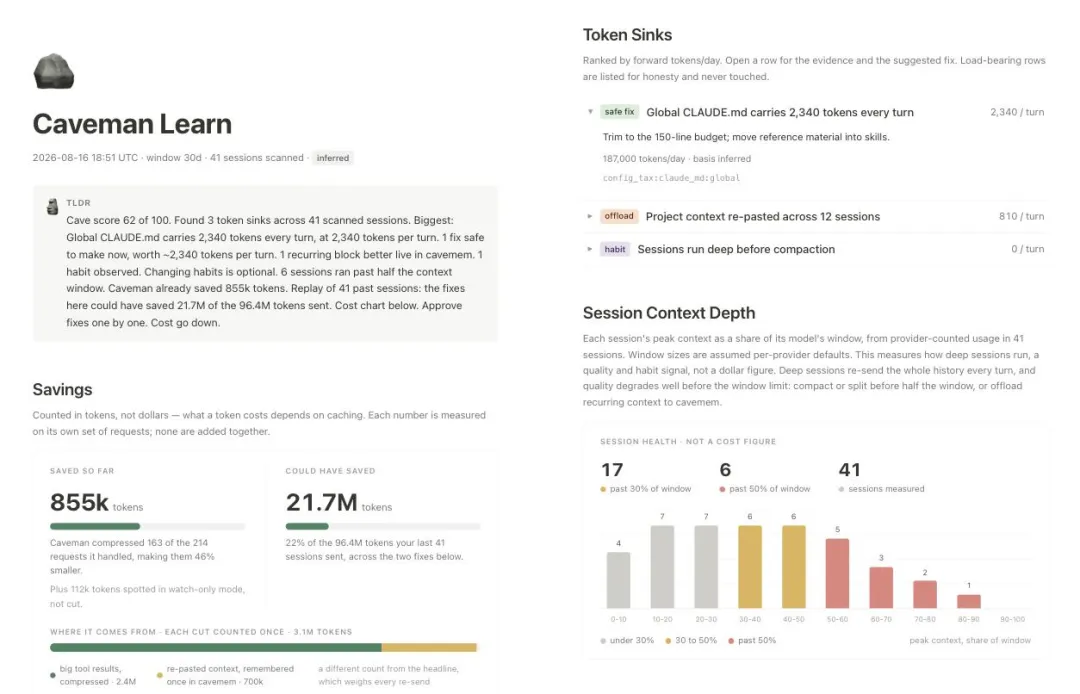
它适合两类人:每天用 AI 写代码、账单肉眼可见的开发者;以及想弄清"token 到底花在哪"的人——caveman learn 会把本地历史整理成账单,指出最大的几个漏斗。
项目 2026 年 4 月创建,仍在高频更新,最新版本 v4.0.1 发布于 2026 年 10 月 13 日。如果你的 AI 账单里也有一部分是"废话"和"噪音"贡献的,它值得跑一次试试。
项目主页:https://github.com/JuliusBrussee/caveman
资料来源
GitHub Trending 项目仓库与 README 官方文档 安装说明 INSTALL.md Releases 架构文档