ARTICLE · 1199059
新加坡试着让AI读懂诈骗对话:案件少了,单案损失为何反而更高?
新加坡试着让AI读懂诈骗对话:案件少了,单案损失为何反而更高?你收到一条“账户异常”的消息。对方先让你核对身份,再把你转到另一个聊天工具,接着用“涉案调查”“退款验证”或“保证金”催你操作。危险不一定藏在第一句话里,而可能藏在几轮解释、安抚和施压之后。 这正是新加坡最近公布的一项端侧反诈方案想补上的空白:不只判断号码、网址或单条短信,而是尝试理解一段对话如何把人推向转账。它值得关注,但还不是普通用户今天就能安装的防诈 App。 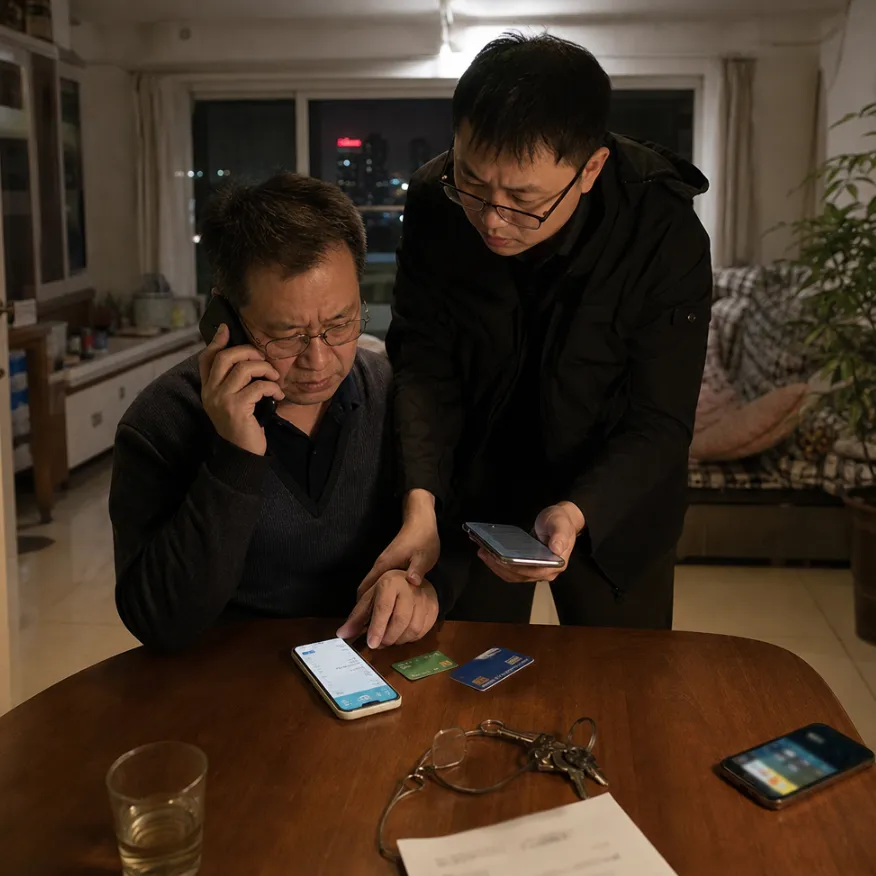
新加坡警察部队在《2025年诈骗与网络犯罪简报》中给出的数据,呈现出一个不能只看总量的反差:2025年诈骗案件数量同比下降27.6%,总损失也下降;但每宗诈骗的损失中位数从1,389新元上升到1,644新元,约增加18.4%。报告还显示,81.8%的诈骗案件涉及受害者自行转账。 这些数字不能证明“AI已经能解决诈骗”,也不能直接代表其他国家。但它们说明了一个现实:如果受害者是在连续沟通中被说服,单纯拦截一个号码、一个网址或一条短信,可能仍然来不及。 
传统防诈工具更擅长处理明确的风险信号:可疑来电、恶意网址、诈骗短信和用户主动举报。新方案试图观察的是另一层信息:对方是否不断改变说法、制造紧迫感、要求转移到私聊、索要验证码,或把“核实身份”一步步推成“先转一笔钱”。 这不是说过去的工具没有AI。新加坡现有的ScamShield已经用于核查可疑来电、网站和信息,也能过滤部分可疑短信、拦截诈骗来电和接收举报。新方案的变化,主要在于分析范围更长、提醒时机可能更靠近转账或交出验证码之前。 根据Google DeepMind与新加坡政府科技局的联合介绍,方案采用两阶段处理:先用较轻量的模型筛查可疑情境,再由基于Gemma的模型结合更长的对话片段分析风险。推理放在设备端,目标是减少把私人聊天内容发送到云端的需要。 但“端侧”不等于“已经保护了你的手机”。截至公告披露的信息,方案仍需要由应用或平台接入;没有公布普通用户可直接下载的应用和明确上线日期,也没有公开按语言、诈骗类型拆分的识别率、漏报率和误报率。官方提到模型经过合成对话和本地语料压力测试,但这不等于已经证明它能在真实聊天中稳定阻止损失。 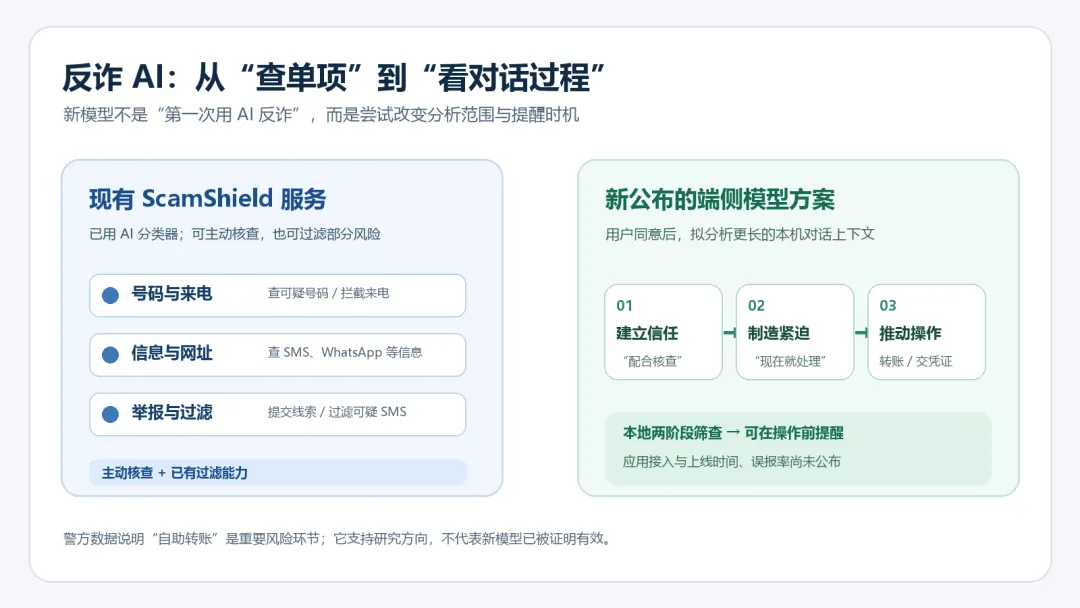
图:从单条信号识别到连续对话分析,端侧方案仍处于待接入、待验证阶段 训练阶段没有使用公民私人或可识别数据,不代表运行时完全不接触用户聊天。模型的用途,恰恰是读取用户授权范围内的对话。产品真正上线后,用户仍需要知道四件事:它读取哪些内容,是否完全在本机分析,是否会留下本地日志,以及误报后能否关闭、申诉和复核。 端侧解决的是“数据在哪里计算”,并不会自动回答“谁可以看、看多少、错了怎么办”。如果这些问题没有被产品说明和测试结果回答,隐私保护就还停留在宣传口号层面。 第一,不要把这项方案当成今天就能安装的AI防诈工具。新加坡用户可以使用当地现有的ScamShield;其他地区的用户,应通过本地银行、平台或政府机构的官方渠道核实,不要从陌生消息里的链接下载所谓“AI防诈工具”。 第二,遇到“账户异常、涉案调查、退款验证、保证金”等要求时,退出对话,不沿着对方提供的号码或链接继续核实。改用银行卡、平台或政府机构官网、官方App中的联系方式;只要对方要求转账、共享屏幕或提供验证码,就先暂停并找第二个人复核。 第三,如果未来聊天软件推出端侧反诈功能,开启前先看四项:读取范围、是否完全本地分析、是否有误报申诉和关闭选项、是否公开真实诈骗类型下的漏报率和误报率。只写“本地AI,保护隐私”还不够,用户需要看到效果和边界。 这次公布的价值,不是“AI已经能替你识破骗子”,而是反诈系统开始尝试识别号码和链接之外的东西:一个人如何在连续对话里被推着做决定。 但在平台真正接入、公开误报和漏报数据之前,它仍是一项待验证的方案,不是可以交托资金安全的保证。对普通用户来说,最可靠的防线仍然是主动退出、换官方渠道核实,并在涉及转账和验证码时增加第二个人复核。 如果一款聊天软件未来要在本机分析对话来反诈,你最希望它先公开什么:读取范围、误报率,还是出错后的处理方式?
真正需要识别的,可能不是一条可疑链接,而是一个人如何在连续对话里被推着做决定。
案件减少了,为什么单案损失还在上升?
反诈防线,正在从“认信号”走向“看过程”
新方案具体做了什么?