ARTICLE · 1204218
Python编程30:每天几十个 PDF 要合成一个?这份 Python 合并教程,能直接复制
工作中,你是不是经常遇到这种困扰,每次到月底、季末、年底报材料的时候。手头攒了二十多个 PDF——扫描件、盖章件、网页导出的文档—上级领导只给一句话:最后合成一个pdf文件。于是你各种网上、线下工具寻找一通,或者干脆打开第一个,复制、粘贴,翻到下一份……忙活一小时,页数对不上,顺序还乱了。
这不是你不会用电脑,而是你在用最笨的办法,做一件本可以几分钟可以完成的事。
01 为什么"合并 PDF"值得专门学一次
先别急着看脚步代码。先回答一个问题:这件事值得你花二十分钟学吗?
值得。因为它符合三个特征:高频、反复出现、纯重复劳动。材料报送、论文附录、合同归档、简历打包、课件整理——几乎每个行政办公场景都会遇到。这样的工作,写一次脚本就能永久复用,边际成本几乎为零。
相比之下,手工方式有三个隐藏成本:一是把文件传到在线工具,等于把可能涉密的资料交到第三方服务器;二是几十个文件来回复制,页序极易出错;三是每次都要重来一遍,永远攒不下经验。
02 先想清楚:合并 PDF 的本质不是简单"拼图",是"按顺序和业务逻辑接页"
很多人一听"合并"就想象成图片拼接,这是误解。
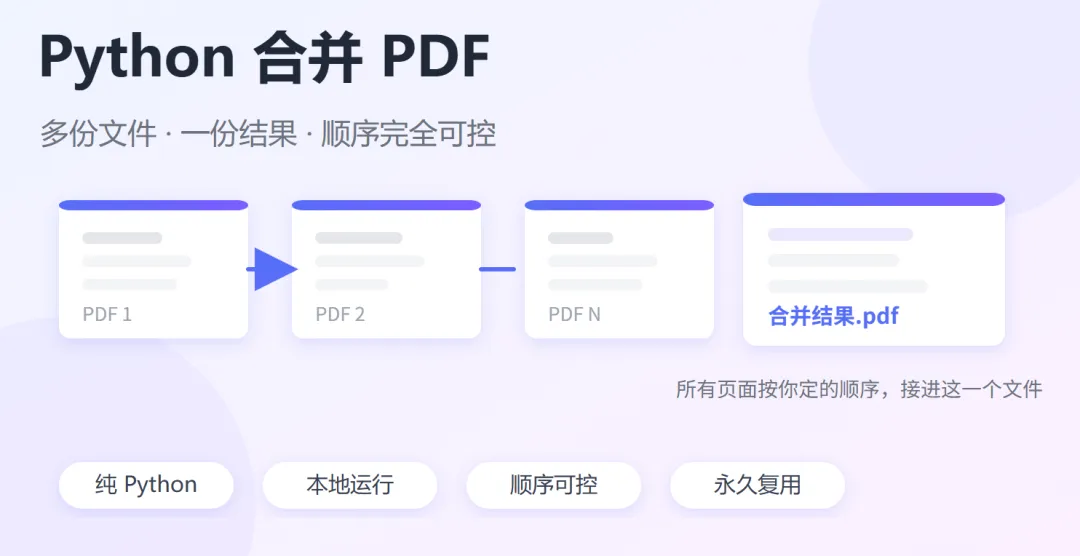
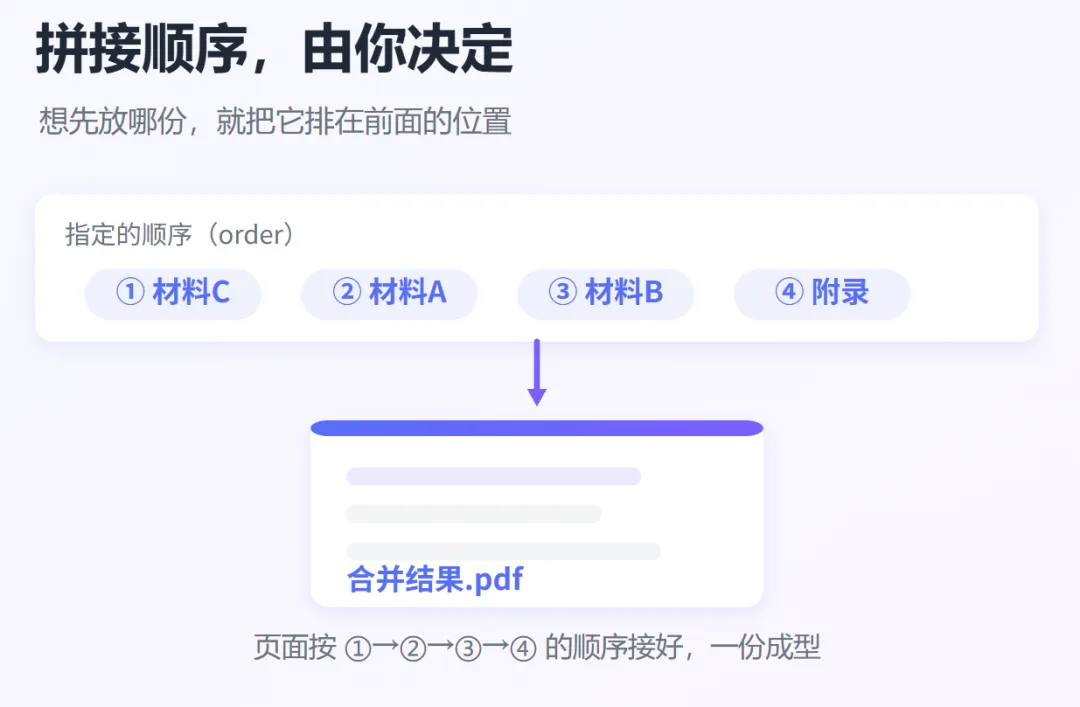
一句话说清:合并 PDF,是把 N 个文件的每一页,按你指定的业务逻辑先后顺序,依次接进一个新文件——像装订,每一页都还是独立的一页,只是被按顺序排进同一本里。
它不等于压缩,不等于把内容糊到一页,也不等于把多份资料变成一张图。它解决的是"多份文件→一份文件"的组织问题,而这件事的关键变量只有一个:逻辑顺序。
03 用什么工具?为什么选 pypdf
Python 合并 PDF 的主流选择,是一个叫 pypdf 的纯 Python 库。它免费、轻量、纯开源,由一个活跃社区长期维护,不依赖任何商业软件。
安装只有一行:
pip install pypdf装好后,合并的核心逻辑其实不到十行。文末直接给出复制的脚步代码成品。
04 三步写好一个可用的合并脚本
把这件事拆成三步,每一步都对应一个明确目的:
步骤一,收集文件:找到目录下所有要合并的 PDF;
步骤二,确定业务逻辑顺序:梳理清楚谁在前、谁在后,这是全文的"指挥棒";
步骤三,按逻辑顺序写入:用 PdfWriter 一页页接进新文件,最后落盘。
pypdf最小可运行脚步版本:
# merge.pyfrom pypdf import PdfWriter, PdfReaderwriter = PdfWriter()files = ["材料一.pdf", "材料二.pdf", "材料三.pdf"]for f in files:reader = PdfReader(f)for page in reader.pages:writer.add_page(page)writer.write("合并结果.pdf")
把这个文件存成 merge.py,在 PDF 所在目录运行 python merge.py,就能得到按列表顺序拼接好的"合并结果.pdf"。
05 最关键的需求:如何自由指定拼接顺序
合并 PDF 真正容易出错的地方,不是"会不会合并",而是"顺序能不能按我要的来"。你要的往往不是 ABC 顺序,而是"先放封面、中间按材料编号、最后放附录"这种业务顺序。
pypdf 的做法很直接:拼接顺序,就是你传入列表的顺序。想改顺序,就改列表,不用改逻辑:
from pypdf import PdfWriter, PdfReaderwriter = PdfWriter()order = ["封面.pdf", "正文.pdf", "附录.pdf"]for f in order:reader = PdfReader(f)for page in reader.pages:writer.add_page(page)writer.write("合并结果.pdf")
三个实用细节:
一是同一份文件可以拼多次,比如把"目录.pdf"放在开头又放在结尾,直接在列表里写两次即可;
二是想交互式选择顺序,可以运行时让用户输入编号,程序按编号重新排序,不用每次改代码;
三是大量文件时,可以先用 os.walk 递归扫描目录,再按"业务编号"而非文件名排序,避免数字文件名的字典序陷阱。
06 几个容易踩的坑
坑一|把"文件名排序"当成"业务顺序"。扫描出的文件默认按文件名排序,而文件名按字典序,1、10、2、3 会排成你意想不到的顺序。要么用自然排序,要么干脆手动指定顺序列表,别依赖文件名的巧合。
坑二|顺序写死在代码里,改一次就要动一次代码。把顺序抽成单独的列表,甚至放在一个 order.txt 里逐行维护,改顺序不动逻辑,才叫可复用。
坑三|加密 PDF 和只读扫描件。带密码的 PDF 要先解密才能合并;纯图片扫描件合并后仍是图片页,无法检索文字,这是源文件决定的,不是工具的错。
坑四|为了图省事用在线工具。把内部资料上传到第三方服务器,顺序和隐私安全都可能失控。本地脚本零上传,更稳妥。
07 一套能直接复用的判断框架
以后遇到类似需求,先别急着动手,用这个框架判断:
适合用脚本|高频反复出现、文件数量多、顺序有要求、要长期复用——写一次脚本,收益最大。
不太适合|一次性小文件、涉及极高密级的敏感材料、源文件本身格式混乱——用最小成本处理,或先做格式治理。
一句话总结:合并 PDF 不是技术难题,难点在于"顺序可控"和"隐私可控"。这两点,本地脚本都天然满足。
可以直接复制使用的代码脚本:
#!/usr/bin/env python3# -*- coding: utf-8 -*-"""@File: 30_merge_pdf.py@Python Version: 3.12.13@Platform: PyTorch 2.2.1 + cu121@Author: Wei Li (Ithaca)@Date: 2026-10-15@Contact: weili_yzzcq@163.com@Blog: https://2694048168.github.io/blog/#/@Version: V0.1@License: Apache License Version 2.0, January 2004Copyright 2026. All rights reserved.@Description:将一系列 PDF 文件拼接为单个 PDF,并可自由指定拼接顺序。功能特性:1. 自动扫描目录下(含子目录)的所有 .pdf 文件;2. 提供多种指定拼接顺序的方式:a. 交互式:运行时在终端按编号选择顺序;b. 命令行直接传文件(按传入顺序拼接);c. 通过顺序文件 / 拖入列表指定;3. 支持重复文件(同一文件可拼接多次);4. 输出单一合并后的 PDF 文件。依赖: pypdf安装: pip install pypdf用法示例:# 方式一:交互式选择顺序python3 merge_pdfs.py# 方式二:命令行按顺序传文件(顺序即拼接顺序)python3 merge_pdfs.py a.pdf b.pdf c.pdf# 方式三:指定输入目录 + 交互选择python3 merge_pdfs.py --dir ./pdfs --output merged.pdf# 方式四:从顺序文件读取(每行一个文件名)python3 merge_pdfs.py --order order.txt"""import osimport reimport sysimport argparsefrom pypdf import PdfWriter, PdfReaderdef natural_sort_key(name: str):"""自然排序:把文件名中的数字按数值大小排序,而不是按字典序。"""return [int(t) if t.isdigit() else t.lower() for t in re.split(r"(\d+)", name)]def discover_pdfs(directory: str) -> list:"""递归扫描目录,返回按自然顺序排序的 PDF 文件绝对路径列表。"""if not os.path.isdir(directory):sys.exit(f"目录不存在:{directory}")pdfs = []for root, _, files in os.walk(directory):for f in files:if f.lower().endswith(".pdf"):pdfs.append(os.path.join(root, f))return sorted(pdfs, key=lambda p: natural_sort_key(os.path.basename(p)))def read_order_file(order_file: str, pdf_dir: str = ".") -> list:"""从顺序文件读取拼接顺序:每行一个文件名或路径,空行与注释(#)忽略。"""if not os.path.isfile(order_file):sys.exit(f"顺序文件不存在:{order_file}")items = []with open(order_file, encoding="utf-8") as fh:for line in fh:line = line.strip()if not line or line.startswith("#"):continue# 去掉行内注释line = re.split(r"[#\t]", line)[0].strip()if not line:continuep = lineif not os.path.isabs(p):p = os.path.join(pdf_dir, p)items.append(p)return itemsdef pick_order_interactively(files: list) -> list:"""交互式:让用户在终端按编号选择拼接顺序。"""print("\n发现以下 PDF 文件(已按自然顺序编号):\n")for i, f in enumerate(files, 1):print(f" {i:>3}. {os.path.basename(f)}")print("\n请输入拼接顺序(用逗号或空格分隔编号,例如:3,1,2 表示先拼第3个、再拼第1个、再拼第2个)。")print("输入 q 退出,输入 a 则全部按当前编号顺序拼接。")while True:raw = input("顺序 > ").strip().lower()if raw in ("q", "quit", "exit"):sys.exit("已取消。")if raw in ("a", "all", ""):return files[:]tokens = re.split(r"[,\s,、;;]+", raw)indices = []ok = Truefor t in tokens:if not t:continuetry:n = int(t)except ValueError:print(f" 无效编号:{t!r}")ok = Falsebreakif not (1 <= n <= len(files)):print(f" 编号越界:{n}(应在 1~{len(files)} 之间)")ok = Falsebreakindices.append(n)if not ok or not indices:print(" 请重新输入。")continue# 允许重复编号,实现同一文件拼接多次return [files[n - 1] for n in indices]def merge_pdfs(paths: list, output: str) -> None:"""按 paths 顺序合并 PDF,输出到 output。"""if not paths:sys.exit("没有可合并的 PDF 文件。")writer = PdfWriter()total_pages = 0seen = set()dup_warned = Falsefor idx, p in enumerate(paths, 1):if not os.path.isfile(p):sys.exit(f"文件不存在:{p}")abs_p = os.path.abspath(p)if abs_p in seen and not dup_warned:print("提示:检测到同一文件被多次选中,将按选择拼接多次。")dup_warned = Trueseen.add(abs_p)try:reader = PdfReader(p)n = len(reader.pages)for page in reader.pages:writer.add_page(page)total_pages += nprint(f" [{idx}/{len(paths)}] 已加入:{os.path.basename(p)}({n} 页)")except Exception as e:print(f" 警告:无法读取 {p},已跳过({e})")if writer.get_num_pages() == 0:sys.exit("合并失败:没有任何页面被加入。")with open(output, "wb") as fh:writer.write(fh)print(f"\n合并完成!共 {len(paths)} 个文件、{total_pages} 页。")print(f"输出文件:{os.path.abspath(output)}")def main():parser = argparse.ArgumentParser(description="将一系列 PDF 文件拼接为一个 PDF,可指定拼接顺序。",formatter_class=argparse.RawDescriptionHelpFormatter,epilog=__doc__,)parser.add_argument("files",nargs="*",help="命令行直接传入的 PDF 文件,按传入顺序拼接。",)parser.add_argument("--dir",default=".",help="扫描目录(含子目录),默认当前目录。",)parser.add_argument("--output","-o",default="merged.pdf",help="输出文件名,默认 merged.pdf。",)parser.add_argument("--order",default=None,help="从指定顺序文件读取拼接顺序(每行一个文件名)。",)parser.add_argument("--no-interactive",action="store_true",help="不进入交互选择:命令行未传文件时,直接按自然顺序合并全部。",)args = parser.parse_args()# 确定要合并的文件列表(按优先级)if args.files:selected = [os.path.abspath(f) for f in args.files]print(f"使用命令行传入的 {len(selected)} 个文件(按传入顺序拼接)。")elif args.order:selected = read_order_file(args.order, args.dir)print(f"从顺序文件读取 {len(selected)} 个文件。")else:all_pdfs = discover_pdfs(args.dir)if not all_pdfs:sys.exit(f"在目录 {args.dir} 中未发现任何 PDF 文件。")if args.no_interactive or len(all_pdfs) == 1:selected = all_pdfsprint(f"按自然顺序合并 {len(all_pdfs)} 个文件。")else:selected = pick_order_interactively(all_pdfs)merge_pdfs(selected, args.output)# --------------------------if __name__ == "__main__":main()
写在最后
别指望一次就完美。更稳的做法是:先用两个小文件跑通顺序,确认输出页数对、顺序对,再放正式文件。原文件一定要留备份,输出文件名写清楚,比如"2026材料汇总_共58页.pdf"。
这份教程给你的是一个能复制的起点。真正的效率,是把"每次重来一遍"变成"写好一次,永久复用"。
如果这篇对你有帮助,点个「赞」和「在看」,也欢迎转发给正在受困于这种工作琐事的同事 👇
下一期,我们再见!