ARTICLE · 1205831
AI 写的代码更多了,软件却没更多
最近 Hacker News 上有一条 364 分的讨论,标题是《AI coding agents generate more code, but not more software》。
Hacker News 上有人把论文里的几个数摘了出来,很扎眼:基线每人每月 5017 行,AI 编码后多 1494 行,约 +30%;PR 从 5.34 个/月多 1.22 个;代码评审平均 7.03 天。
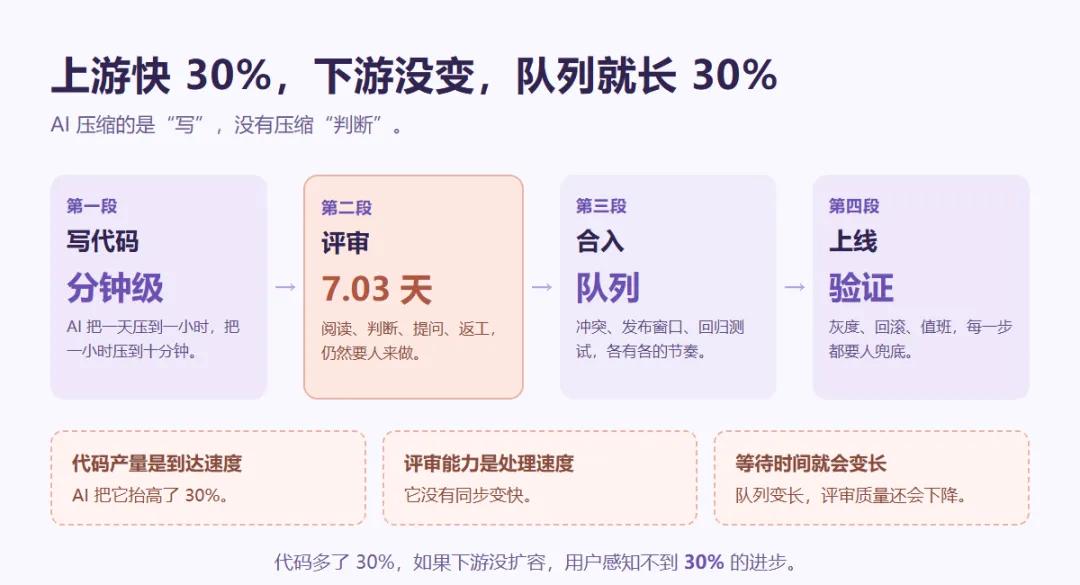
说得直白一点:AI 让代码产量涨了 30%,但评审要等 7 天,增量被队列吃掉了。
这条讨论有 313 条评论。有人说数据来自 2025 年,模型早变了;有人说评审文化本来就有问题。两边都有道理,但有一个事实没变:写代码变快了,评审没有。
先看清这三个数
报道来自 Ars Technica,2026 年 10 月。论文数据主要来自 2025 年及更早,样本是早期 agent 的使用情况。
7.03 天是平均值,平均值会掩盖长尾。真正拖住交付的,往往是少数几个躺了两三周的 PR;它们占着评审者的注意力,也让后面的 PR 排队。
7 天的平均等待也说明,评审队列本来就没有被当成交付系统的一部分。AI 只是把这个问题放大了。
如果评审时间不变,代码产量涨 30%,评审队列就会涨 30%。这是排队论,不是模型能力。
更麻烦的是,队列变长会反过来降低评审质量。评审者同时挂着十几个 PR,上下文频繁切换,最后只能看个大概。看得越粗,返工越多;返工越多,队列更长。
为什么 AI 的代码更难评审
AI 生成的代码看起来很合理。命名规范、注释齐全、结构完整,读起来不像胡写的。评审者很难从字面上判断“这段代码为什么要存在”“它有没有改变原来的行为”“它是不是在绕过某个边界”。
人工写的代码,评审者能顺着作者的思路问问题;AI 写的代码,作者自己也不一定记得当时的取舍。评审从“看懂一个人的思路”,变成“重新建立一套判断”。
更隐蔽的是,AI 会把“看起来对”当成目标。它能通过编译、跑通 happy path,甚至补出一套像模像样的测试;但边界条件、异常路径、权限判断,可能都被“合理”地省略了。
我的反面实验:把评审拿掉
有一批自动生成的 PR,一共 55 个,改了 493 个文件。
从创建到合并,中位数 3.1 分钟,最长 652 分钟。零评论,零人工评审。CI 两个任务,40 秒和 53 秒。
其中一个 PR 改了 6 个文件、加了 469 行,2 分 8 秒就合进去了。
单看这些数字,效率高得离谱。人工评审的时代,一个 469 行的 PR 不可能 2 分钟合入。
速度是真的。但“合入”只是状态,“功能可用”才是结果。零评审也不是免费的,它把评审成本从合并前挪到了合并后:出了问题再查,成本更高,影响面更大。
后来我给这条流程补了四道门。
需求核对:这个 PR 是否对应一个明确的需求,改动范围是否匹配。防止 AI 自己加戏。
diff 检查:有没有意外文件、生成文件、调试代码、密钥、无关格式化。AI 很容易顺手改一堆不该改的东西。
测试命令:不是只看 CI 绿,而是看它到底跑了哪些命令、覆盖了哪些路径。CI 绿可能是测试没跑到。
合并后 smoke:在真实环境里走一遍关键路径,确认功能真的能用。合入只是开始,不是结束。
这四道门听起来像流程,其实都是在补证据:需求对应关系、改动范围、测试覆盖、线上行为。没有证据,评审只能靠感觉。
四道门也不必一次上齐。先上 diff 检查和合并后 smoke,通常能拦住最贵的那几类问题。
评审要重做,不能直接删掉
我把变更分成三档。
低风险:配置、文案、依赖小版本、纯样式。自动门禁加抽查,不要求人工逐行读。
中风险:普通业务逻辑。一人评审,加测试和变更说明。
高风险:权限、支付、数据迁移、并发、外部接口。设计说明、两人评审、回滚方案、灰度发布,一个都不能少。
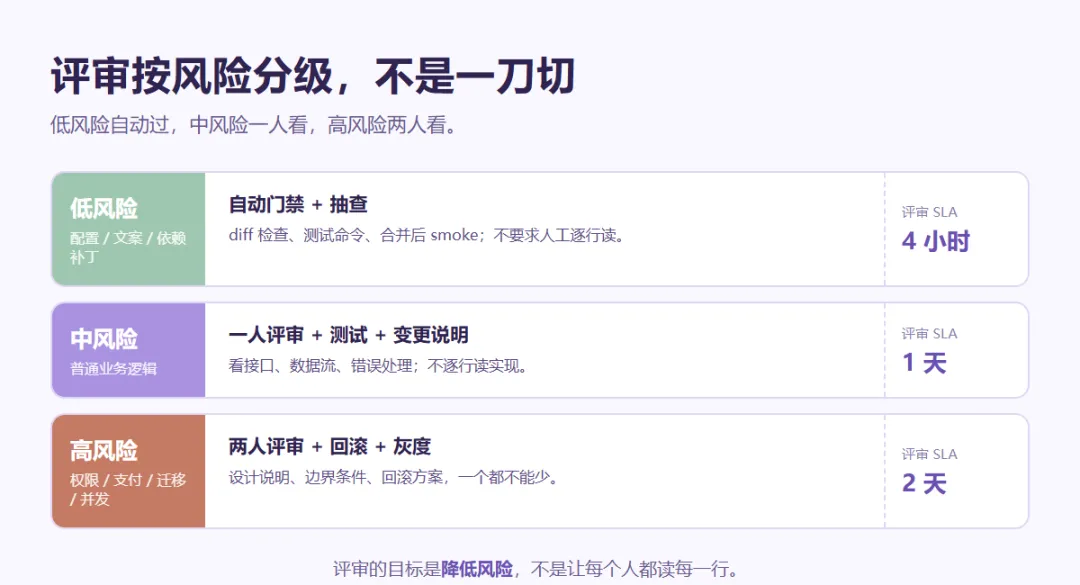
分级之后,评审等待时间会下降,因为大部分低风险变更不再排人工队列;高风险变更反而能得到更充分的注意力。
还可以给每档设一个评审 SLA。低风险 4 小时,中风险 1 个工作日,高风险 2 个工作日。超过 SLA 就升级,不要让 PR 在队列里躺 7 天。
PR 大小也要管。一个 PR 只做一件事,控制在几百行以内;超过就拆。AI 很擅长一次改很多文件,评审者最怕的也是一次改很多文件。
一个 469 行的 PR,拆成 5 个不到 100 行的 PR,评审者可以在半小时内看完一个,心理负担小很多。
度量也要换。不要只量 PR 数、代码行数;要量评审等待时间、返工率、逃逸缺陷、变更失败率。
评审等待时间衡量队列,返工率衡量一次做对率,逃逸缺陷衡量评审和测试有没有漏,变更失败率衡量整个交付链路。
评审质量也可以用抽样来量:每周抽 10 个已合入的 PR,回看有没有漏掉边界、权限、回滚点。不要等到线上出事才算账。
如果只能留一个指标,我会留“逃逸缺陷”。它最接近用户感知:评审和测试没拦住的问题,最后都会在这里出现。
评审的目标是降低风险,不是让每个人都读每一行。
评审时优先看接口、数据流、错误处理和回滚点,不必逐行读实现。AI 的实现细节可以在测试里验证。
举一反三
内容:AI 写稿快了,但事实核查、选题判断、发布验证没快。产量涨,垃圾也会涨;编辑的瓶颈从“写”变成“筛”和“核”。
数据:AI 写 SQL 快了,但口径确认、权限校验、结果验证没快。查询涨,错数也会涨;分析师的时间从“写 SQL”变成“对口径”。
客服:AI 回消息快了,但问题解决率、升级判断没快。回复涨,投诉也会涨;客服的瓶颈从“回”变成“判断该不该升级”。
共同点:AI 压缩的是生产,不压缩判断。判断层不扩容,产出就会堵在那里。
可以写成一个小公式:有效产出 = AI 产能 × 验证通过率。AI 把前一项抬高,后一项不变,有效产出不会等比例上涨。
最后
AI 让写代码变便宜,让判断变贵。
软件的价值落在被验证过的行为上,代码只是载体。代码多了 30%,如果评审、测试、上线没有同步扩容,用户感知不到 30% 的进步。
代码可以生成,软件要被运行、被维护、被信任。能编译、能通过测试,只是软件的起点;能扛住真实流量、能在出错时回滚、能让下一个人接手,才算软件。
未来团队的核心指标,可能从“交付了多少”变成“验证了多少、返工了多少、逃逸了多少”。
明天就能做的三件事:把最近 20 个 PR 按风险分档;给每档设一个评审 SLA;把“合入”改成“合入 + smoke 通过”才算完成。
如果这篇让你少一次“代码合了就算完成”,可以关注我。
这个号每周写两三篇真跑过、带数字、能照着复现的工程记录,主要聊 AI 落到真实系统里的做法和坑。
下一篇写:AI 生成 PR 的分级评审清单,低/中/高风险各查什么,直接照着用。