ARTICLE · 1208487
AI降本转向:token效率优先
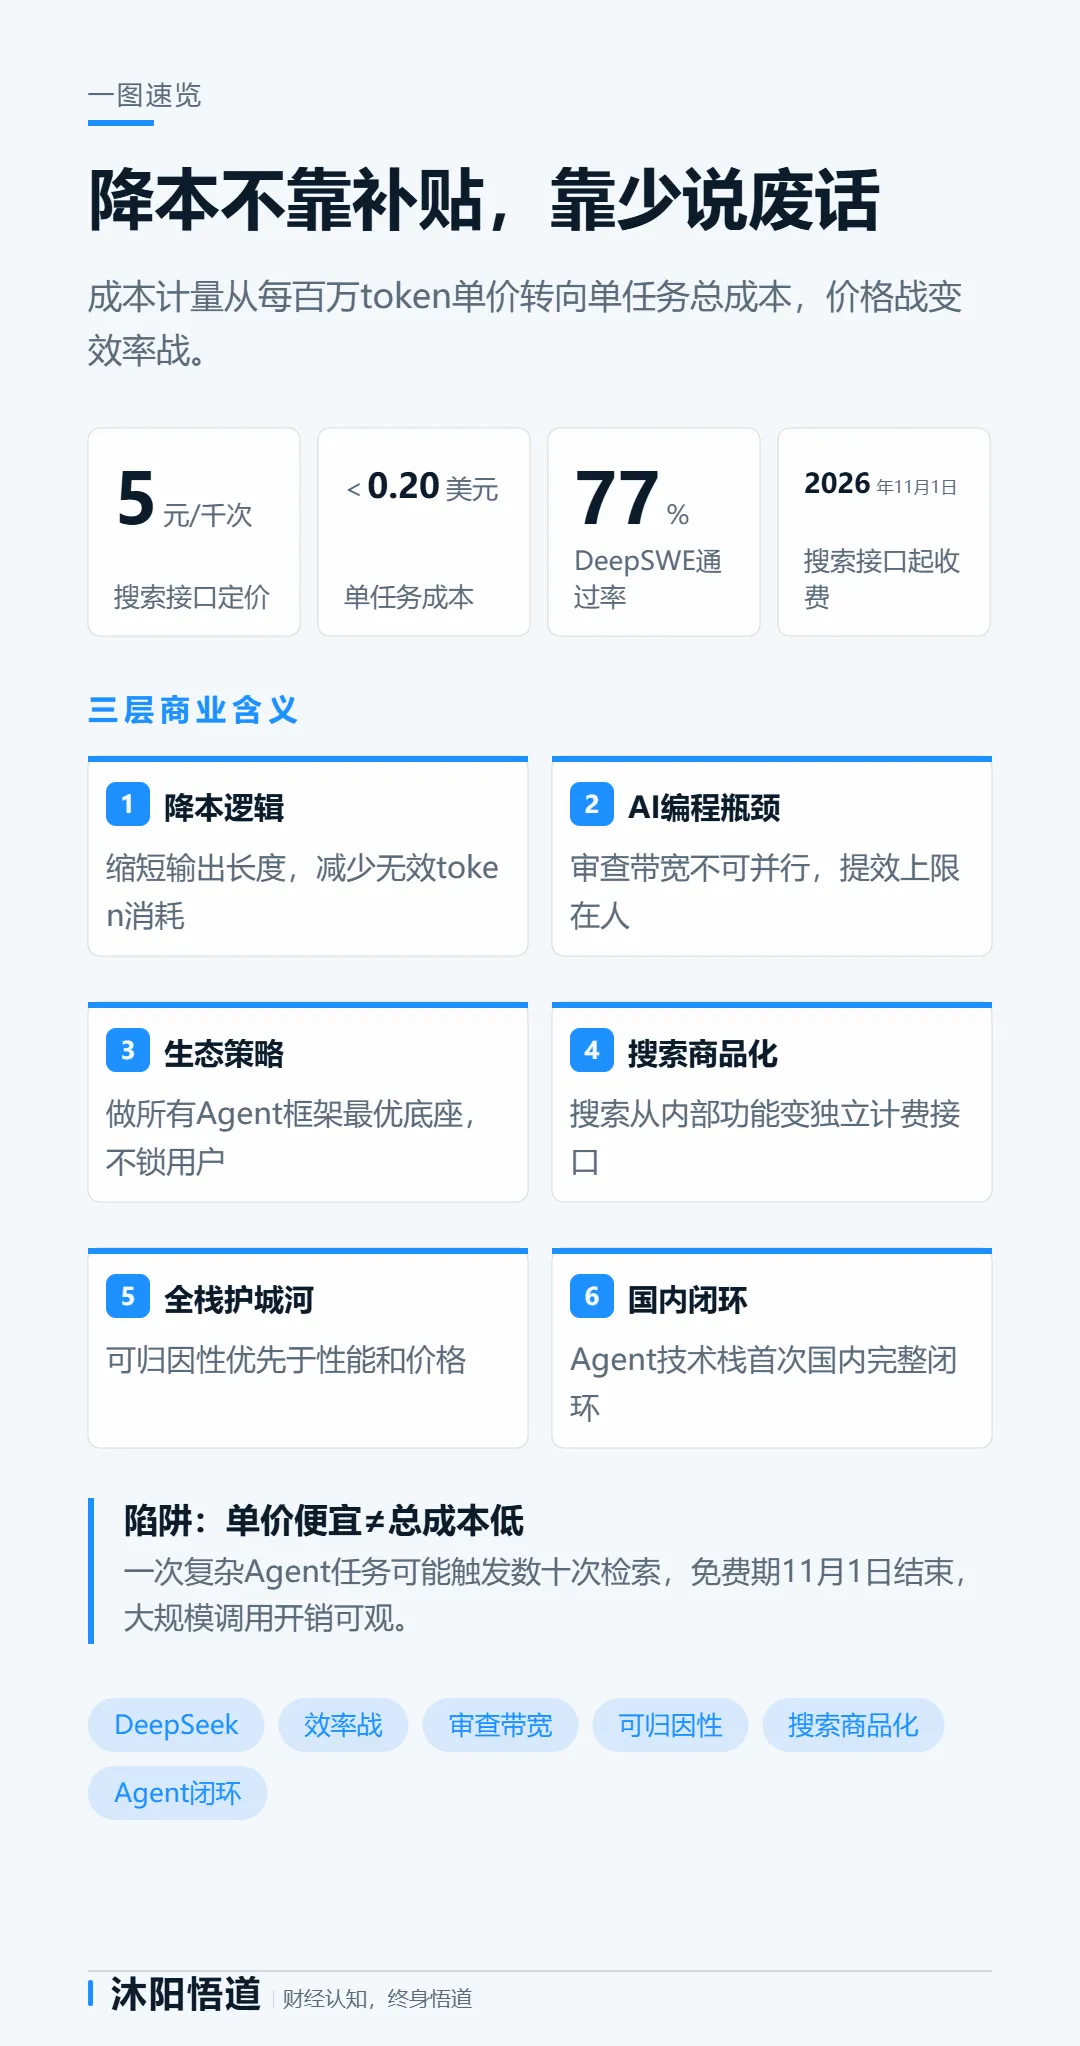
10月17日DeepSeek发布V4.1-Flash-1017,真正的变化不是跑分,而是降本逻辑从“降价”切换为“减少完成同一任务的token消耗”——计量单位一变,竞争规则就变。
10月17日,深度求索发布DeepSeek-V4.1-Flash-1017,网页端、APP与API同步切换,首次对外开放自研Search与Fetch接口,均定价5元/千次。主流解读是“跑分追上头部、AI写代码时代到来”,两句话都抓偏了。真正的信号藏在官方一句不起眼的表述里——“缩短了模型的任务运行时间与输出长度”。
先纠正一个误读:降本不是降价,是“少说废话”
很多人把“性能—费用帕累托最优”读成“性能涨了、价格没涨”。如果只是这样,那不过是一次常规商业让利,对手补贴就能跟。
关键在降本的来源变了:
能被补贴的东西,最终一定会被补贴掉;不能被补贴的,才是壁垒。“缩短输出长度”意味着模型在减少无效输出——少解释、少铺垫、少走弯路。这不是省钱,是变聪明的一种表现。
大模型的价格战,正在从“单价战”转向“效率战”。单价战打到同质化,效率战拼的是模型有多“克制”。克制很难被模仿。
AI编程的真实瓶颈:不是生成,是审查
官方演示很有冲击力:极少提示词、极短交互轮次,直接在框架内完成故宫3D建模、网页赛车游戏、Godot引擎《传送门2》复刻。从零到“能跑”,门槛确实被大幅拉低。
但“能跑”和“能用”之间隔着一堵墙,墙不在AI那边,在我们这边。
软件工程的复杂度是守恒的。它没有消失,只是从“设计期”转移到“审查期”:
读一万行别人写的代码,比写一万行自己想的代码更累。更关键的是:审查不可并行。写代码可以分模块分人,审查需要全局一致性理解,而“这个系统整体是否自洽”这个判断,切不成十份交给十个人。
一个团队用AI提效的上限,不由模型生成能力决定,而由这个团队的审查带宽决定。生成能力可以一夜提升十倍,审查带宽的提升以年为单位。
这解释了为什么同一个模型,在有成熟工程体系的团队里收益显著,在缺乏体系的团队里反而制造混乱:前者有带宽吸收产出,后者只会被自己无法理解的代码淹没。“许愿式编程”降低的是“从0到能跑”的门槛,没有降低“从能跑到能用”的门槛。
生态策略最聪明的一步:不做“自家框架专属”
官方文档里有个易被忽略的细节:
本次我们着重针对DeepSeek Harness、腾讯CodeBuddy、WorkBuddy等平台框架进行了优化。
三个里面两个是第三方框架。
它选了后者。Agent框架这一层胜负远未分出,做底座比做整车安全得多。隐性收益是:开发者不必为用好这个模型换掉现有技术栈,而迁移成本恰恰是开发者最抗拒的东西。
这与开源权重是同一逻辑的两面:开放API服务“要省事”的用户,开源权重服务“要可控”的用户(数据不出门、私有部署)。双轨并行,两类客户都留在生态里。
搜索API:真正的新增是“能力的商品化”
5元/千次的搜索接口,市场关注点几乎全在“便宜”。但官方文档里这句话揭示了真实性质:
当前用户在DeepSeek Harness / Claude Code / Codex中使用DeepSeek API时,已经会通过Server端工具调用访问到Search/Fetch接口,这部分调用目前未计费,并将在2026年11月1日00:00开始按次收取调用费用。
搜索能力早就存在,一直在被使用。真正的新增不是“搜索能力”,而是把搜索从产品内部功能,变成可单独计价、单独售卖的商品——典型的“能力商品化”。
5元/千次(每次半分钱)与其说是定价,不如说是基础设施补贴。目的不是靠搜索赚钱,而是让开发者把Agent的检索环节留在生态里——检索一旦外流,整套技术栈会跟着迁移。云计算时代上演过同一剧本:先补贴基础组件,再用技术栈粘性收租。
被忽略的细节:SEO作弊升级为GEO操纵
官方对搜索质量的描述里有个新词:
针对SEO作弊、GEO操纵和低质AIGC,我们通过严格的识别机制对其进行过滤。
GEO——生成式引擎优化。过去作弊是骗搜索引擎的排序算法,现在作弊是骗生成式模型的推理链。后者更危险:搜索引擎返回十条链接,人类能挑着看;AI搜索返回一段内容,模型会直接把它当事实来推理。
一条SEO垃圾网页,对人类是无效信息,对Agent是错误前提。由此可以预见:未来的搜索质量评价会从“相关性/召回率”转向“推理可用率”——返回内容中能直接支撑正确推理的比例。这个指标堆索引规模改善不了,只能靠过滤机制。
全栈的真正护城河:不是性能,是“可归因”
过去做Agent应用要拼装:A家模型+B家搜索+C家沙箱+自己写的胶水代码。这套组合有个隐性成本,平时看不出来,出事时立刻显现——找不到该负责的人。
模型说是搜索返回的内容有问题,搜索说是模型没理解,沙箱说是调用方式不对,胶水代码是你自己写的。团队陷入低效排查循环:换模型、换搜索、换沙箱逐个排除,最后发现是一个谁都不负责的边界问题。
全栈由一家提供的最大收益,恰恰不在性能,而是“出问题能找到人”。对企业采购而言,责任可追溯的权重往往高于单价便宜多少——一次生产事故的代价,远超一年接口费用。
对全栈厂商而言,真正的护城河排序是:可归因 > 稳定性 > 性能 > 价格。而市场讨论几乎全部集中在最后一项。
更深一层:Agent技术栈第一次可以在国内闭环
这一条与普通用户无关,但对企业级应用意义重大。
过去的现实是:模型可以是国产的,但搜索工具往往依赖海外服务。整条链路始终有一个“外来环节”,带来三重风险——成本(海外定价)、网络(跨境延迟与稳定性)、合规(数据出境)。
现在模型、框架、搜索、抓取都可以是国内接口。一个产业的自主可控,不是“每个环节都能自己做”,而是“关键环节之间的接口是自己的”。只要有任一环节依赖外部,整套技术栈的稳定性就受制于人。
对数据敏感行业(金融、医疗、政务),这是能否落地的分水岭——不是成本问题,是合规问题。
一个必须补上的反面:全栈不等于更优
主流叙事容易滑向“全栈一体当然比拼接好”,但这个判断需要条件。
全栈的代价是锁定,拼接的代价是集成成本。权衡取决于任务生命周期:原型期拼接更灵活,生产期全栈更稳定。很多团队的错误,是在原型期就上了全栈,或在生产期还在拼接。
四个需要校正的认知
一、许愿式编程不会大规模替代程序员。 它擅长快速产出可运行原型。架构设计、安全审核、长期可维护性、业务需求梳理仍高度依赖人。更准确的说法:减少原型试错时间,增加后期审查调试工作量——总工作量未必减少,工作性质从“实现”转向“判断”。
二、便宜不等于可以无限制大规模商用。 接口有速率与查询长度约束,一次复杂Agent任务可能触发数十次检索,5元/千次在大规模调用下依然是可观开销,且免费期2026年11月1日结束。“单价便宜”与“总成本低”是两件事。
三、单项基准高分不等于综合能力追平头部。 DeepSWE通过率77%(未经官方逐项确认)只是特定评测集上的表现。真实业务的复杂多变、超长上下文、多模态任务,与封闭测试集之间仍有差距。
四、Agent不是“模型强就够了”。 大量Agent失败不是推理不行,而是任务拆解、工具调用、外部信息获取、沙箱执行这些环节出问题。Agent是一套系统,模型只是其中一个模块。
六个可以跟踪的观察指标
真实生产环境的任务完成率结论:计量单位一变,竞争规则就变
这次发布表面是“模型升级+搜索开放”,实质有三层:技术上,通过减少任务时间与输出长度实现降本,把价格战变成效率战;生态上,做所有Agent框架的最优底座而非锁定自家框架;商业上,把搜索能力商品化为独立接口,完成Agent全栈闭环。
三层合起来指向同一个方向:大模型的商业模式,正在从“卖电”变成“卖电器”。卖电按度数计费,电是标准化的、可以混用;卖电器按功能计价,电器有生态、有锁定。“卖电器”的竞争,永远比“卖电”激烈。
顺着推下去,一个尚未被回答、但很快会成为核心的问题是:当厂商开始卖“完成的活”,“没完成的活”由谁承担?按结果计费听起来很美,但必然带来新的契约难题——失败的成本归谁。这会是Agent时代最重要的商业设计问题。
这次发布最值得肯定的不是跑分,而是它证明了降本可以不靠补贴而靠能力。在一个习惯用价格战争夺市场的行业里,这算难得的清醒——补贴能赢一时,效率才能赢一路。而更有价值的那个不起眼的副产品是:Agent的技术栈第一次可以在国内完整闭环。这件事不够性感,但它决定了多少企业敢真正把核心业务放上去。