ARTICLE · 1208493
影子端点专项扫描:AI "用进"安全的一次实践
影子端点专项扫描:AI "用进"安全的一次实践在SRC运营过程中,我们发现总有一些API相关的漏洞反复出现,常态化的互联网漏洞扫描也难以覆盖。针对这些漏洞进行分析复盘时,发现资产排查里一直有个盲区:框架自带、上线后忘了关的调试/监控/管理端点- - Druid监控台、Swagger文档页、Actuator、.git目录、中间件管理台。它们不在业务设计里,台账上也查不到,多数不需要认证,一旦暴露就能直接读配置、密钥以及进一步的渗透。 常规漏扫基本扫不到,原因大多在路径上:只打/admin这类标准路径;不认上下文前缀(应用挂在/portal下,真实路径是/portal/actuator/env);靠状态码判断(Java 应用对任意路径都可能返回200或统一错误页);需要登录态的端点,没带 cookie 时返回登录页,直接被判成"不存在"。 动手之前,我们试过从安全运营的角度治理:从访问日志做检测规则,只能覆盖有日志且被采集的系统,还是事后被动发现,收到告警后自动验证。但是效果还是比较有限,需要找更好的办法。 今年Q2在团队大力推AI应用,我想换个思路:不依赖日志和告警,AI 放在必要位置 - - 扫描期扩探 + 扫描后证据验证。工具是趁零散时间边做边测出来的- - 内网 34个域名做试点、再到全量域名资产,每跑一轮都暴露新问题,也就顺带改了几版。 我最初把AI当"报告润色器"用,很快发现没用 - - 模型看到的只是扫描器自己的结论。后来把它放进两个位置:扫描期的自适应扩探(AI提议、代码执行),扫描后的证据验证与研判(回抓真实响应、构建证据包再裁决,提高准确率)。 设计上守住四条:AI层不import扫描器,靠结构化数据传入,可独立单测;LLM失败或未配置时静默降级,扫描照跑不阻塞;每条判断记录模型、置信度和耗时;不外发明文凭据。 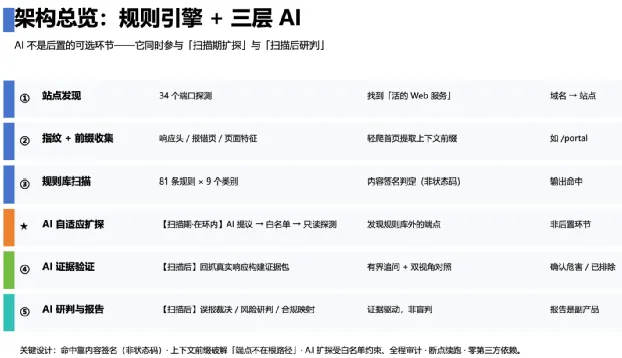
图1 核心链路:规则发现 + AI 研判 V1,只喂结论。 把命中记录(url、状态码、框架、描述)发给模型判真伪。跑 mock 靶标时效果很好,第一次跑真实数据就翻车了。 内网34条命中盲测,AI判了33真、1假。人工逐条抓真实响应复核,发现好几条其实是误报:某域名的/api/jsonws返回401认证失败,被判成真阳性、还列了高危;302 跳到Nextcloud登录页的Druid页面、308 跳端口的Harbor接口,也全被判成真阳性。问题不在模型的判断力,在喂进去的东西:它看到的是"扫描器说这是未授权",它从没见过那个401。扫描器判错了,它自然跟着错。 V2,喂证据。加了验证层:先回抓真实响应构建证据包(状态码、Content-Type、长度、正文片段、重定向链、认证失败特征、catch-all 比对、双视角对照等9项),再连同证据交给模型(其中"双视角对照"是为了识别"公网经 CDN 实际打不到"的端点)。同一批34条自动排除3条误报,与人工复核结论一致。 V3,约束型智能体。判得准了,但角色还是事后复核 - - 规则库没想到的端点谁来发现?于是给AI提议权,执行权留在代码里。同一批34条自动排除6条;它自己还提出要探Prometheus的/api/v1/status/tsdb、/api/v1/metadata,这些手工白名单里一个都没有。那次放行117条、拒绝11条。 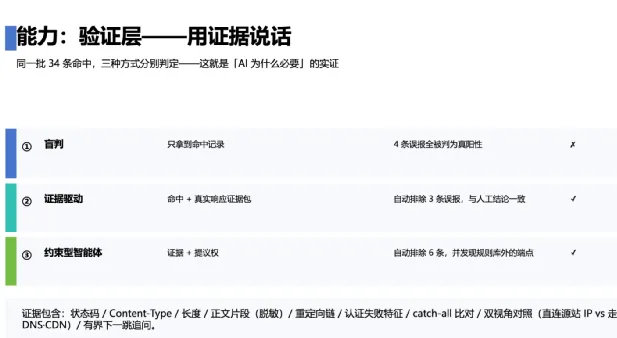
图2 同一批命中的三种判定方式 真正起作用的不是路径白名单,而是方法加副作用的约束:只允许 GET/HEAD,禁止 query参数,只取状态码和声明长度(不下载堆转储),不提交凭据,再加一份23个危险动词的黑名单。白名单按用途分两层 - - 发现阶段放得宽,定性阶段收得窄,每条提议都记"放行 / 拒绝 + 理由 + 结果"。 提示词里也写死了几条:不确定就输出uncertain,不得编造漏洞,判定理由必须引用证据里的具体字段。宁可让它说"不确定",也不让它编一个看起来合理的结论。 坑几乎都不在模型上。AI侧三个:推理模型"想太多",额度全吃在思考上、正文为空 - - max_tokens约束的其实是content和reasoning之和,给足之后再加一条"正文为空一律判失败";并发一高就被网关限流,后来把逐条研判和报告生成分给不同档位的模型,并发压到 3~4;审计字段还和实际调用不符(写pro、用flash),改成记录实际调用的模型。 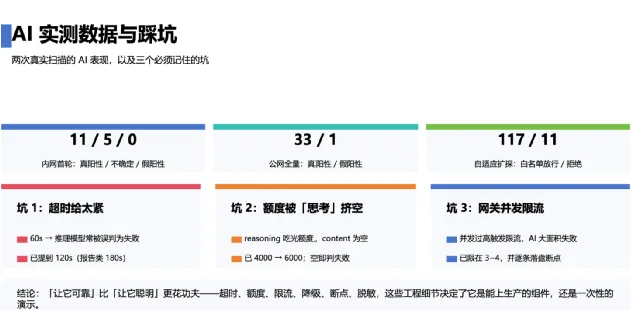
图3 AI 实测数据与三个坑 工程侧更多:重试语义不对导致请求翻倍,改成只在无响应时重试;catch-all站点对任意路径都返回首页,靠四层防护压住;认证失败页会把/jsonws回显进正文,于是加了认证失败特征判定;80端口301跳443导致同一发现报两次,做了跨协议去重。顺带一个优化:猜测的前缀先用3个探针判断是否存在,不存在就整组跳过,单站点探测数 372 → 96。 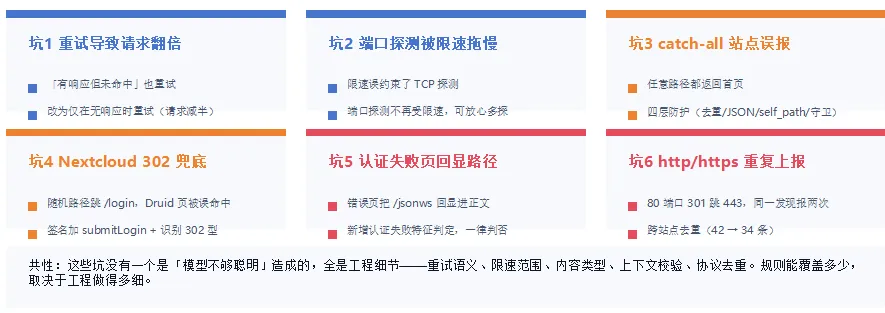
图4 工程化踩坑以及修法 内网第一轮34个域名,命中16条(去重后10个"站点 + 端点"),误报治理把 103条压到22、再到16,复核后未发现高危。 全网全量限速 10 req/s,29小时跑完,退出码0。收敛过程:42条原始命中 → 去重后34条 → AI过滤后33条 → 人工复核27条为真(另有4 条误报、1条重复、1条复核时已修复)。真正需要优先处置的只有1条:某客户 xxxx.com:18080 的 Druid /datasource.json 未授权返回数据库 URL 和 root 账号(68 个字段)。中危 5 条(Prometheus、Harbor、Nacos 元数据),低危 21 条(.DS_Store、Grafana health、Knife4j 文档页等)。 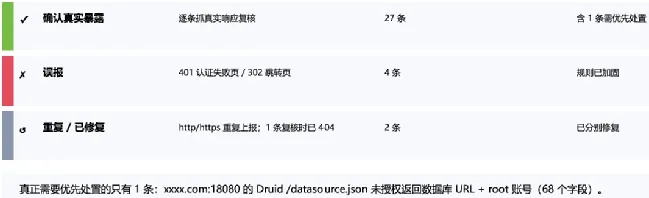
图5 公网全量的收敛过程 误报治理的工作量远超预期。四层防护、三处规则判定加固、跨协议去重,工程细节占了大半时间。 AI的效果取决于喂什么,不取决于模型多强。V1和V2是同一个模型,只把输入从"结论"换成"真实响应",误报排除就从0条变成3条。 给AI自由度的地方,得同时给它边界。发现规则库外的端点靠的是让AI提议;能上生产,靠的是白名单、只读约束和审计留痕。降级也不等于可选项 - - AI不可用时扫描照跑是工程容错,但降级结果只能算"候选集",不能当结论。 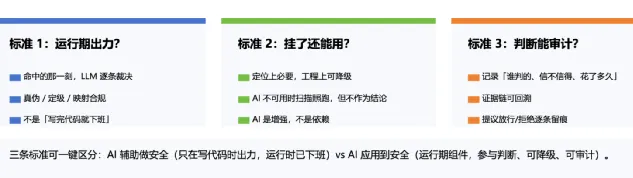
图6 AI 是否真正"用进"安全 把一次性的专项排查变成常态化能力:接入 CI/CD 门禁做上线前扫描,规则库导出为nuclei模板与主流体系互通,结论回写资产平台;再补IPv6、登录态探测和指纹驱动的减噪。影子端点这件事,找得到只是起点,判得准才是终点。
一、背景介绍
二、工具设计
三、AI 应用
四、踩过的坑
五、实测结果
六、几点体会