ARTICLE · 1210265
让助手查询 Excel 任务表
让助手查询 Excel 任务表
前面的任务助手从 CSV 读取任务,再从 JSON 查补充进展。这一篇把数据放进同一个 Excel 工作簿,让助手可以回答更具体的问题:
林舟有哪些进行中的任务?
截至 2026-10-14,林舟有哪些逾期未完成的任务?如果进展为空,再查补充记录。
模型把问题转换成查询条件,Python 打开已保存的工作簿,按条件筛选,再把记录和来源位置交回模型。 这一版用 openpyxl 读取 .xlsx 文件,不需要启动 Excel,也不控制 Excel 窗口。
示例文件在文末
一、先把工作簿整理成可以读取的结构
本例提供 任务清单.xlsx,包含“任务清单”和“补充记录”两张工作表。数据延续前面的案例,新增负责人;所有姓名和记录都是虚构的教学示例。
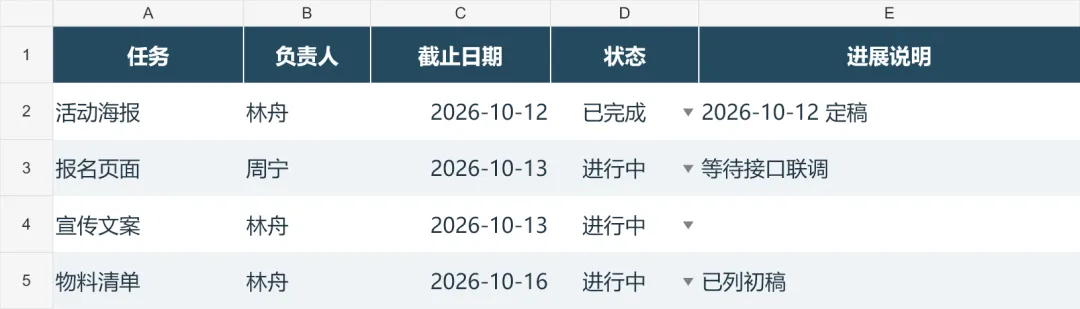
“任务清单”的前五列如下,第一行直接放表头:
四条任务中,活动海报、宣传文案和物料清单由林舟负责,报名页面由周宁负责。原来的截止日期、状态和进展不变。
“补充记录”的前两列是“任务”和“补充进展”。其中,宣传文案对应“初稿已完成,等待复核”。
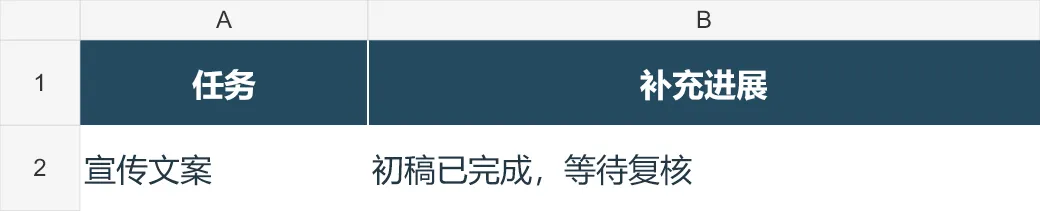
这里约定第一行是表头,数据区域不使用合并单元格。前五列或前两列的字段可以交换顺序,但必须齐全且不能重名。右侧的教学说明放在数据区之外,不参与查询。
任务名称暂时用来对应两张表,所以要求各表内名称唯一。如果同名任务很多,后续应增加任务编号,不能随意取第一条匹配记录。
二、从单元格读成一条条记录
这一版把 Excel 读取函数放在 excel_tools.py 中,模型调用循环仍放在 task_agent.py 中。主程序导入两个工具:
1
from excel_tools import query_tasks, get_progress工作簿路径在代码里确定:
1
WORKBOOK = Path(__file__).resolve().with_name("任务清单.xlsx")它指向 excel_tools.py 旁边的文件。模型只提供查询条件,不会凭一句自然语言要求自动搜索电脑上的其他工作簿。
先打开指定工作表
下面是负责读取工作表的完整函数。它同时用于任务清单和补充记录,expected_headers 分别传入五个或两个要求的字段名。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39
defread_records(sheet_name, expected_headers):"""只读指定工作表前 N 列;第一行是表头,右侧说明不参与查询。"""try:book = load_workbook(WORKBOOK, read_only=True, data_only=False, keep_links=False)except (InvalidFileException, BadZipFile) as exc:raise ValueError("无法读取工作簿,请确认文件是真正的 .xlsx") from exctry:if sheet_name notin book.sheetnames:raise ValueError(f"缺少工作表:{sheet_name}")sheet = book[sheet_name]if sheet.max_row isnotNoneand sheet.max_row > MAX_ROWS + 1:raise ValueError(f"本例最多读取 {MAX_ROWS} 条数据行,请检查有效数据范围")rows = sheet.iter_rows(max_col=len(expected_headers))first_row = next(rows, ())headers = [str(c.value).strip() if c.value isnotNoneelse""for c in first_row]iflen(headers) != len(set(headers)) orset(headers) != set(expected_headers):raise ValueError(f"{sheet_name}前{len(expected_headers)}列表头必须是:{'、'.join(expected_headers)},不能重名")result = []seen = set()for row_number, cells inenumerate(rows, start=2):if row_number > MAX_ROWS + 1:raise ValueError(f"本例最多读取 {MAX_ROWS} 条数据行")ifany(c.data_type == "f"for c in cells):raise ValueError(f"{sheet_name}第{row_number}行含公式;本例只读取固定值")values = [c.value.strip() ifisinstance(c.value, str) else c.value for c in cells]ifall(v isNoneor v == ""for v in values):continuerecord = dict(zip(headers, values))name = record["任务"]ifnotisinstance(name, str) ornot name:raise ValueError(f"{sheet_name}第{row_number}行缺少有效任务名称")if name in seen:raise ValueError(f"{sheet_name}任务名称重复:{name}")seen.add(name)record["来源行"] = row_numberresult.append(record)return resultfinally:book.close()
打开文件时,三个参数分别控制不同的事情:
read_only=True | |
data_only=False | |
keep_links=False |
book[sheet_name] 按名称选工作表。iter_rows(max_col=...) 限定读取前几列,返回的是一行行单元格对象。这里没有使用 values_only=True,因为除了值,还要检查单元格的 data_type。
finally 里的 book.close() 也很重要。正常返回、表头错误或中途报错,都应关闭已经打开的只读工作簿。
用表头与单元格值建立对应关系
第一次 next(rows, ()) 取出表头。后续每行执行:
1
record = dict(zip(headers, values))zip() 把同一位置的表头与值配对,dict() 将这些配对组成字典。按当前示例的列顺序,一行里的“宣传文案”对应“任务”,“林舟”对应“负责人”,“进行中”对应“状态”。
因此,程序后面可以使用 record["负责人"],而不是一直记着“负责人在第二列”。只要表头与该列数据一起移动,前五列内部调整顺序后仍能正确对应。
enumerate(rows, start=2) 从 Excel 第 2 行开始计数。完全空白的行会跳过,但行号不会重新编号。宣传文案目前在第 4 行,工具就记录 "来源行": 4。
这和返回列表中的第几项不同:宣传文案可能是筛选结果中的第一项,但它仍来自原表的第 4 行。
读不到,不能当成没有匹配项
代码会检查表头、任务名称、重复名称和公式单元格。字段不符合约定时返回明确错误,而不是继续给出一份看似正常的空清单。
本例只读取固定值。openpyxl 不负责计算 Excel 公式;即使使用 data_only=True,读取的也是文件中保存的公式缓存值,它可能缺失或没有更新。因此,这版工具检测到数据区公式会提示处理,不把缓存值自动当成新结果。
另一个细节是 sheet.max_row:有些导出文件没有可用的行数元数据,它可能是 None。所以代码既检查已知行数,也在实际迭代时检查上限。本例限制为表头下 5000 行,空白行也占工作表行号。
三、先把日期和空值处理清楚
从 Excel 读取截止日期,得到的未必是字符串。真正的 Excel 日期单元格,常被 openpyxl 转成 datetime 对象。
本例用一个函数统一处理:
1 2 3 4 5 6 7 8 9
defnormalize_date(value):"""Excel 日期常被读成 datetime;本例按天比较,不考虑时分秒。"""ifisinstance(value, datetime):return value.date()ifisinstance(value, date):return valueifisinstance(value, str):return parse_date(value.strip())raise ValueError("截止日期应为 Excel 日期或 YYYY-MM-DD 文本,不能是空值或普通数字")
这几个分支各有用途:
datetime同时包含日期和时间,.date()只取日期。本例按天判断逾期,忽略时分秒。如果已经是 date,直接使用。如果是文本,则按 YYYY-MM-DD格式检查并转换。空值或没有被识别成日期的普通数字,直接报错,不猜它代表哪个日期。
datetime 是 date 的子类,所以代码先判断 datetime,确保带时间的值先被处理。
读取任务清单时,read_tasks() 会检查负责人、状态和进展类型,并把日期转成统一文本,便于后面输出 JSON:
1
record["截止日期"] = normalize_date(record["截止日期"]).isoformat().isoformat() 得到的是 2026-10-13 这样的字符串。日期要用于比较时,再用 parse_date() 转回日期对象,避免混用 Excel 日期、文本和普通数字。
Excel 中空白的进展说明通常读成 None。本例将它转换为 "",方便后续判断是否需要补查;负责人和截止日期属于必填字段,不能同样当作普通空字符串继续查询。
处理后的宣传文案记录包含:
1 2 3 4 5 6 7 8 9
{"任务":"宣传文案","负责人":"林舟","截止日期":"2026-10-13","状态":"进行中","进展说明":"","来源行":4,"来源":"任务清单.xlsx / 任务清单!A4:E4"}
这里的来源位置对应本次读取时的文件和行号。排序、插入行以后,位置可能变化,它不是长期不变的任务编号。
四、把查询条件组合起来
原来的工具只查询逾期任务。这一版使用 query_tasks(),支持三个可选条件:
owner | |
status | |
overdue_as_of |
完整函数如下:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24
defquery_tasks(owner=None, status=None, overdue_as_of=None):"""可选条件按 AND 组合;不传条件就返回全部任务。"""for name, value in [("owner", owner), ("status", status), ("overdue_as_of", overdue_as_of)]:if value isnotNoneand (notisinstance(value, str) ornot value.strip()):raise ValueError(f"{name} 必须是非空字符串或省略")if owner isnotNone:owner = owner.strip()if status isnotNone:status = status.strip()if status notin STATES:raise ValueError("status 必须是已完成、进行中或待处理")cutoff = parse_date(overdue_as_of) if overdue_as_of isnotNoneelseNoneselected = []for task in read_tasks():if owner isnotNoneand task["负责人"] != owner:continueif status isnotNoneand task["状态"] != status:continueif cutoff isnotNone:if parse_date(task["截止日期"]) >= cutoff or task["状态"] == "已完成":continueselected.append(task)return {"筛选条件": {"负责人": owner, "状态": status, "逾期查询日期": overdue_as_of},"匹配数量": len(selected), "任务": selected}
参数默认值是 None,表示没有指定这个条件。没有指定负责人,不等于查询负责人为空的任务;没有指定逾期日期,也不会自动使用今天。
循环中的 continue 表示这条记录不满足条件,直接检查下一条。只有所有已指定的条件都通过,才执行 selected.append(task)。
因此,多条件的关系是 AND,也就是同时满足。
例如:
1
query_tasks(owner="林舟", status="进行中")这次应该返回宣传文案和物料清单。物料清单虽然还没到期,也会被选中,因为我们根本没有要求筛选逾期。
再换成:
1
query_tasks(owner="林舟", overdue_as_of="2026-10-14")这次只返回宣传文案。overdue_as_of 启用了“截止日期早于该日,且状态不是已完成”的规则。虽然没有额外指定 status,逾期规则本身仍然会排除已完成事项。
所有条件都省略时,query_tasks() 返回全部任务。若查询成功但没有匹配项,结果里会有 "匹配数量": 0 和空的任务列表。它与工具报错时的 error 字段含义不同。
五、让模型知道新工具怎样使用
数据读取方式改了,工具说明也要同步更新。模型需要知道参数是可选的、怎样组合,以及“逾期日期”有什么含义。
TOOLS 中与查询参数有关的部分如下,来自本篇完整代码:
1 2 3 4 5 6 7 8 9 10
{"type": "object","properties": {"owner": {"type": "string", "description": "可选,完整的负责人姓名,精确匹配"},"status": {"type": "string", "enum": ["已完成", "进行中", "待处理"]},"overdue_as_of": {"type": "string", "description": "可选,YYYY-MM-DD。只保留截止早于该日且未完成的任务。日期必须由用户提供。"}},"required": [],"additionalProperties": False}
required 为空列表,表示三个参数都可以省略。status 的 enum 声明允许的状态值,Python 侧仍会再次检查。对没有使用的条件,本例要求模型直接省略,不传空字符串或 null。工具返回值中出现的 null 则表示相应筛选条件未启用,这是结果说明,与请求参数的校验分开处理。
函数入口的参数检查也从原来的“必须恰好包含某个参数”,调整为检查已提供的参数是否属于允许集合:
1 2
ifnotset(args).issubset({"owner", "status", "overdue_as_of"}):raise ValueError("query_tasks 包含未定义的参数")
issubset() 在这里判断:模型给出的参数名是否都在这三个名称之中。若它额外提供 path 想指定其他文件,就会被拒绝。
工具名称到函数的映射相应更新为:
1
TOOL_FUNCTIONS = {"query_tasks": query_tasks, "get_progress": get_progress}补查进展时,get_progress() 使用同一个 read_records(),读取“补充记录”表的前两列。找到宣传文案后,它返回进展文字及 补充记录!A2:B2;没有对应记录时,返回 found=false。
系统提示词也同步写明:按负责人或状态查询时不需要日期;用户要求逾期但没给日期时先询问;进展为空再补查;补充记录不改变原任务状态。
主循环仍然接收模型的工具请求,调用 execute_tool(),再用同一个 tool_call_id 把实际结果交回模型。数据源换成 Excel,并不需要重写整套模型调用流程。
六、运行并核对真实结果
本篇代码目录包含完整程序、提示词、工作簿和运行说明。先在该目录打开 PowerShell,准备环境:
1 2 3
python -m venv .venv.\.venv\Scripts\python.exe -m pip install -r requirements.txt.\.venv\Scripts\python.exe task_agent.py --check-tools
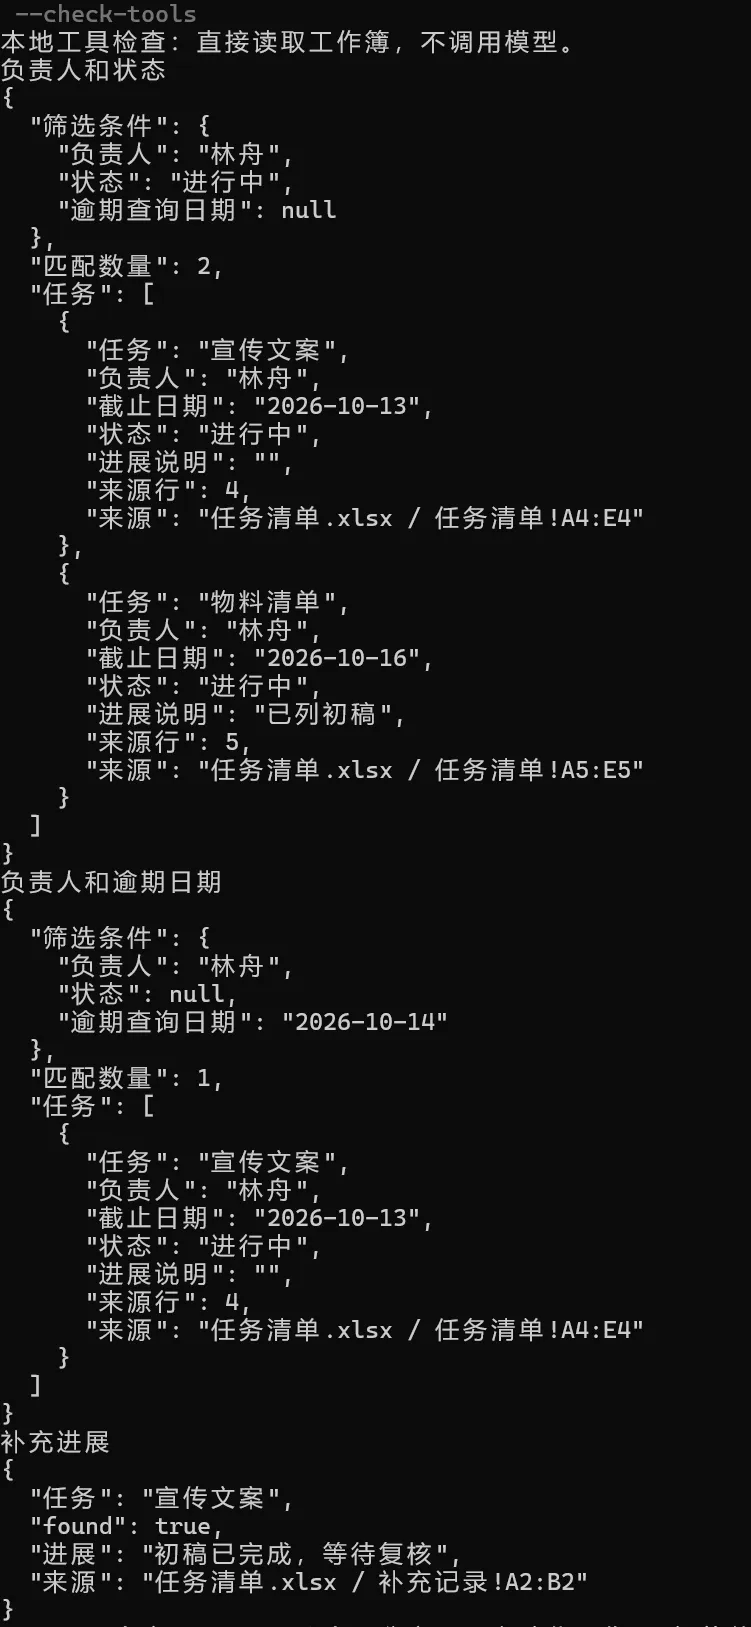
依赖中新增 openpyxl。工具检查不请求模型,会直接读取工作簿,核对“林舟的进行中任务”“林舟的逾期未完成任务”以及补充进展。
要调用模型,首次配置时复制 .env.example 为 .env,填写自己的 API Key。已有配置文件时直接编辑。
1 2 3
Copy-Item .env.example .envnotepad .env.\.venv\Scripts\python.exe task_agent.py
本次使用 DeepSeek deepseek-flash,已经实际运行默认问题。日志中的两次工具请求是:
1 2
模型请求:query_tasks({"owner": "林舟", "overdue_as_of": "2026-10-14"})模型请求:get_progress({"task_name": "宣传文案"})
第一轮查询只返回宣传文案;第二轮补查到了“初稿已完成,等待复核”;第三轮模型生成答复。返回的状态仍为“进行中”,任务记录与补充进展分别注明了来源位置。
另外两个问题也做了实际核对:
对应命令:
1 2
.\.venv\Scripts\python.exe task_agent.py --question"查询林舟所有进行中的任务,不按日期筛选。".\.venv\Scripts\python.exe task_agent.py --question"查询截至 2026-10-13 的逾期未完成任务。"
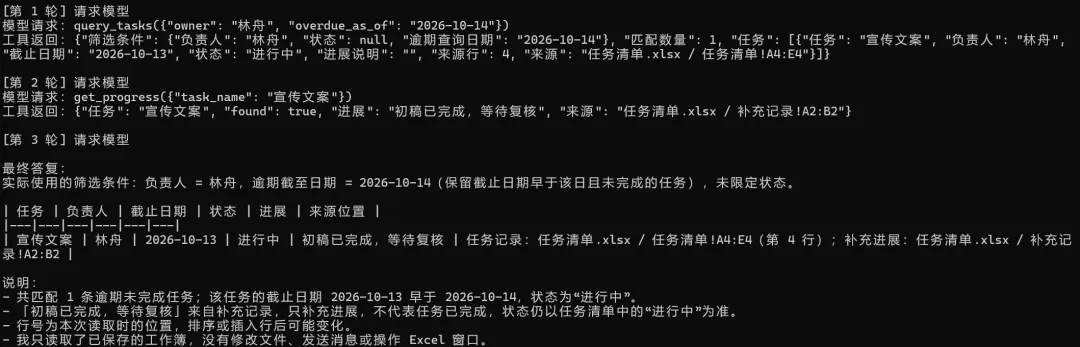
本次本地工具检查和 13 项离线测试通过;上述三个问题也完成了真实模型调用,查询前后工作簿的文件哈希一致。原始工具请求、返回值和模型答复保存在配套核对记录中。这些结果代表本次输入的表现,不能推成所有问题都一定会被正确理解。
文件查询与 Excel 窗口是两回事
这版工具每次调用都会重新打开已保存的文件。它不会读取 Excel 窗口里尚未保存的修改,也不继承你在界面中选中的区域或筛选结果。
修改任务后,先保存,再运行查询。一次任务中若既查清单又查补充记录,尽量不要在两次读取之间继续编辑保存,避免它们读到不同版本。
这里已经验证的是 .xlsx 文件读取和模型工具调用,没有进行 Office 主机自动化。无论助手在回复里怎样描述,代码中都没有写回工作簿的操作;如果以后要让它修改状态,需要另外设计写入工具和结果核对。
通过网盘分享的文件:让助手查询Excel任务表-代码.zip
链接: https://pan.baidu.com/s/1_lw6OW2fS_qlk6VVpwJQvQ?pwd=gr77 提取码: gr77