ARTICLE · 1215080
如何让AI读到志书?
当前,人工智能技术日趋成熟,正逐步应用于资料整理、辅助编纂等地方志业务。历代旧志、前两轮地方综合志书,是地方志的核心文献。若通用大模型能够直接读取线上公开志书,无疑将大幅提升地方志的利用效率。但在实际工作中,AI往往无法调取线上志书原文。如何实现AI对线上志书资源的有效读取,是方志数字化转型面临的现实课题。
一
志书卷帙浩繁,一部志书少则数卷,多则数十卷,各类史料分散于全书各个篇目。开展专题编纂、地情挖掘、资料整理等工作,传统方式只能依靠人工逐卷查阅检索,不仅耗时费力,效率低下,也容易遗漏散见于不同卷次、篇目的关键史料。
如果AI能够精准读取志书文本,便可承担大量基础性、重复性工作,按主题归集零散史料,梳理人物事件脉络,摘录整合文献素材,让从业者集中更多精力进行史实考订、史料辨析等核心工作。但目前AI在方志领域的应用,普遍面临“看得见、读不到、用不了”的现实困境。
二
本文所说“AI读到志书”,并非指模型训练阶段学习到的部分志书片段,而是指使用阶段实时调取志书内容,输出能够溯源核验的史料文本。不少从业者存在认识误区:既然在线上平台可以浏览志书,人工智能也应能直接读取调用志书内容。事实上,人工网页阅读与人工智能获取,是两套完全不同的运行逻辑。人工网页阅览是逐页浏览、按需摘抄;人工智能获取是依靠程序批量抓取、自动解析,二者的访问机制、数据获取方式完全不同。
目前,地方志机构数字化平台上线的历代旧志,大多为扫描图片,未经OCR(光学字符识别)处理,无可复制的电子文本,AI无法从纯图片中提取有效文字内容。
前两轮地方综合志书虽已形成电子文本,前端阅览页面不再采用扫描图片展示,部分平台后端依托完整电子文本搭建内部全文检索数据库,但仅限平台内部业务检索使用,没有对外开放批量获取、数据导出、模型调用接口。平台仅向普通用户开放网页查阅权限,限制机器批量读取与智能解析,AI依然无法调取志书资源。
三
要让AI读取、利用志书,一般需要先加工生成机器能够识别、调用的文本资源,大体可分为三种途径。
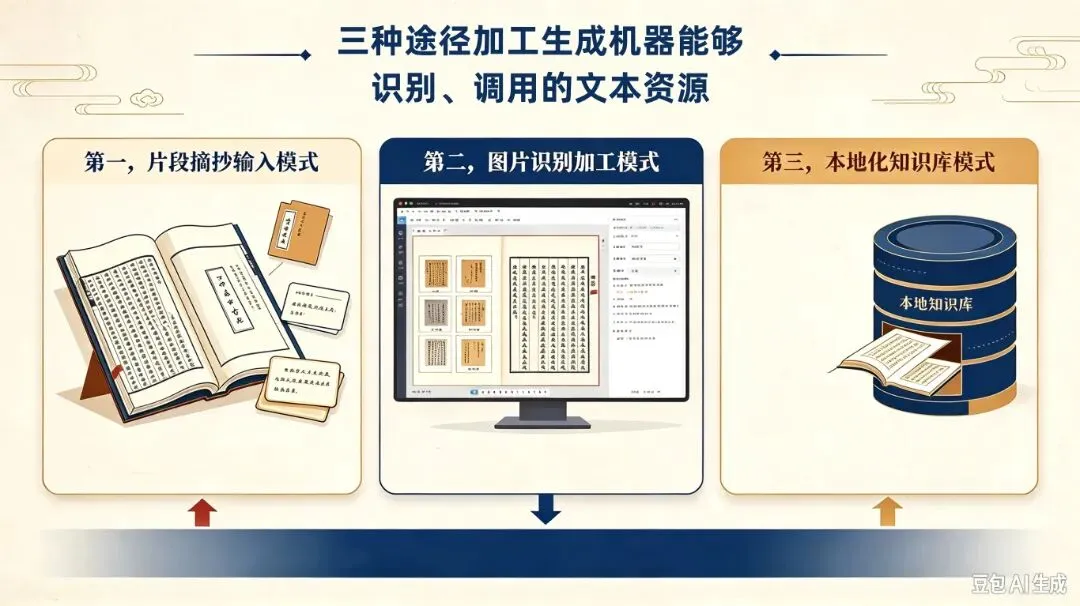
第一,片段摘抄输入模式。在地方志数字化平台,人工查阅志书,并完成检索、筛选、摘抄志书原文,输入大模型开展相关辅助工作。该模式技术门槛低、风险可控。短板在于无法实现全书智能检索,史料筛选、甄别归集仍高度依赖人工。
第二,图片识别加工模式。大量现存旧志仅有扫描图片,没有形成电子文本。需借助OCR技术将图片转化为可供机器识别、复制的文字。图片自动识别生成的文字容易存在错字、漏字等问题,不能直接使用,必须进行人工校核勘误,再交由大模型后续处理。该模式适合旧志活化利用的业务场景。识典古籍是此类模式的代表,由北京大学数字人文研究中心与字节跳动合作建设,已形成大批可供复制、检索的旧志文本资源。
第三,本地化知识库模式。有条件的地方志机构,可开展第三方合作,借助算力资源,将经过人工校勘整理的方志文献,建设本地化知识库,对接大模型,实现志书智能检索、辅助编纂等功能。杭州正在打造的“杭小志”数智编纂系统属于此类模式的代表。该模式是实现方志智能化的重要方向,但人力、经费投入较大,目前多数地方志机构尚不具备这一条件。
无论采取哪种模式,都必须恪守地方志“存真求实”的基本原则。AI仅能承担地方志业务的辅助工作,本身不具备辨别史料真伪、价值取舍等核心能力。凡是AI生成的文稿,均不能直接采信,必须人工逐条复核,坚决避免由于AI“幻觉”带来史实失真的风险。
国家“十五五”规划纲要明确提出“加强和改进地方志工作”。推动人工智能与地方志事业深度融合,正是落实这一要求的重要举措。实现人工智能对方志资源的有效读取、活化利用,是地方志数字化发展的必然趋势。方志工作者应当主动拥抱数字新技术,立足实际,积极探索,严守底线,规避风险,以人工智能技术赋能地方志事业高质量发展。
作者:王欣(成都市地方志工作办公室)
编辑:龙昱丹
审核:郫都区史志办