ARTICLE · 1223578
Mac本地运行AI工具,整理一份文件还有哪些环节要联网
2026年10月20日,提供AI搜索及Computer任务工具的公司Perplexity发布官方公告,其Computer任务工具开始支持在Mac上进行全本地运行。其中Computer是该公司开发的一款任务工具名称,并非某款新型硬件设备。
对于平时习惯在Mac电脑上处理文档的读者来说,大家普遍关心的是,如果在自己电脑上运行此类任务,整理存放在本地的会议记录和项目文件时,哪些步骤可以留在本机,哪些环节依然需要网络支持。
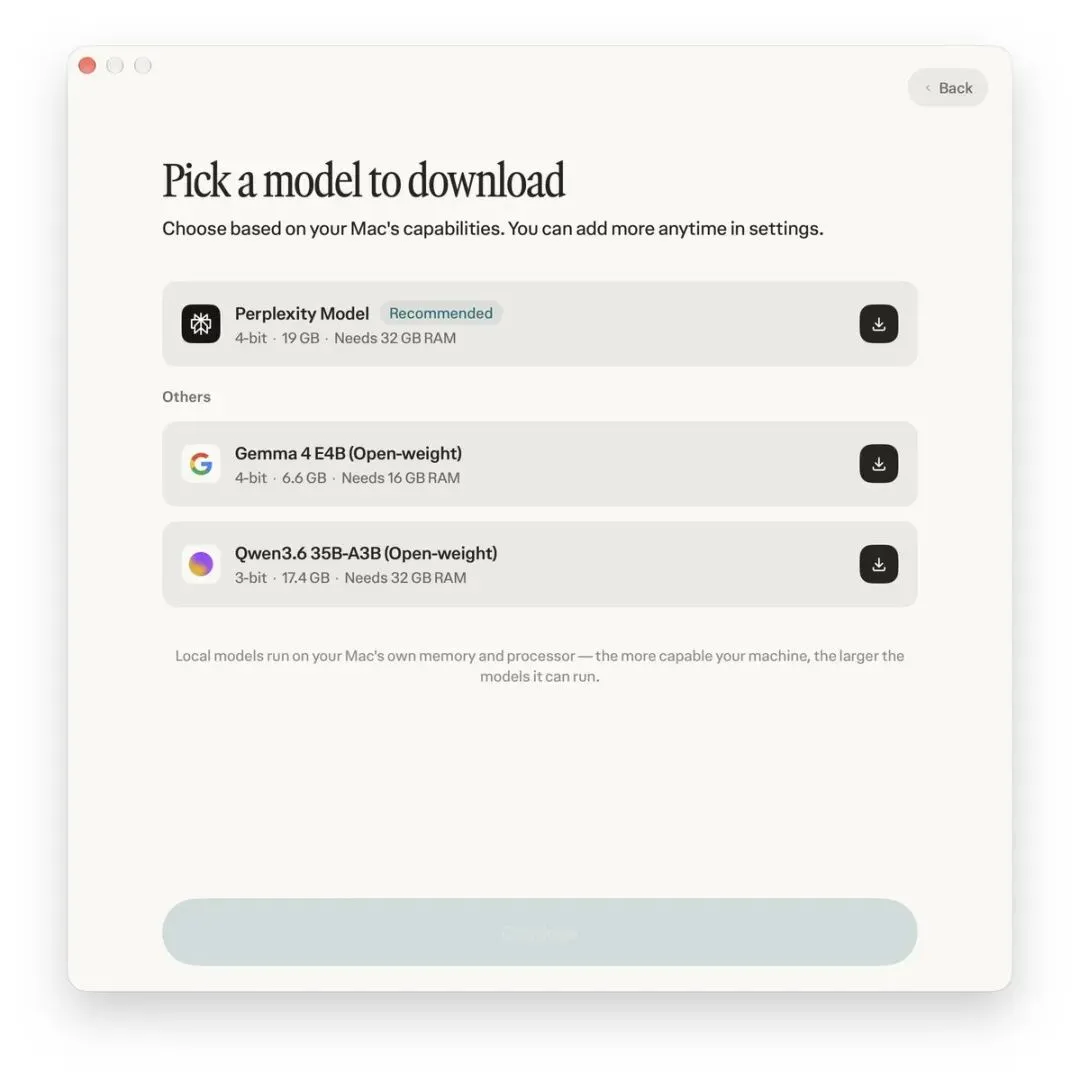
Mac应用的本地模型下载界面(9月公开截图,来源:@mweinbach,经Digg收录)。仅示意设置入口,图中型号与内存提示以当前应用为准。
01
一份周会摘要,哪些工作留在本机
在过去常见的使用场景中,很多桌面端工具本质上是将输入内容上传至远端服务器,由云端大模型完成计算后传回结果。这次更新的做法是把模型、运行框架和任务执行过程转移到用户的Mac本机。
只要设备硬件与操作系统符合相应要求,且已预先下载好所需模型,任务规划与文档处理便可在本地运行。这样在分析私有文档时,就不需要将这部分文本内容传往远端云端服务器。
为了直观说明这种运行模式在日常工作中的具体表现,我们可以设定一个常见的假设任务场景。假设你的Mac本地文件夹中保存着本周的多份会议原始记录、项目待办事项清单以及一份进度表。
现在的任务是将这些分散的文件整理成一份周会前一页摘要,标注出未确定事项,并输出到一个全新的本地草稿文件中。由于原始文件均存储在硬盘内部,目标也是新建本地文件,因此处理过程可以在本机完成。
在这个假设场景中,选择全本地模式后,模型对文档的读取、信息提炼和草稿整理都可以在Mac本机进行。处理这批本地文件的主体过程无需将文本发送到云端,减少了私有资料在网络传输中的暴露机会。
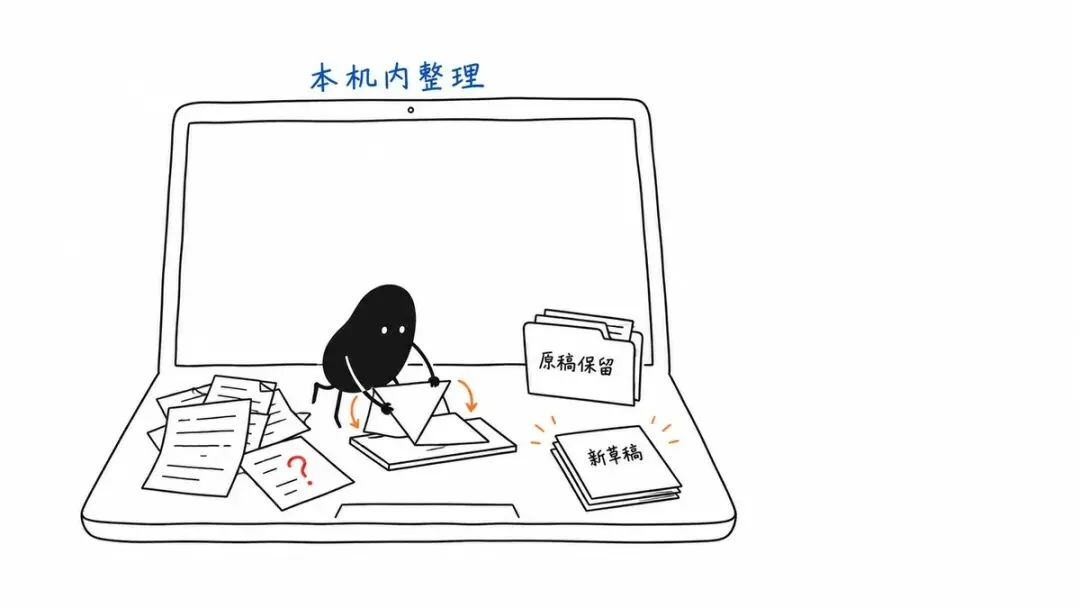
在授予相应权限后,该工具可以跨受支持的本地应用工作。我们可以让它读取备忘录里的随手记、信息中的临时沟通,以及表格软件里的进度项目,将这些零散资料汇总到一个草稿文档中。
在处理多份本地会议纪要时,可能会遇到同一事项的日期或版本冲突。合理的做法是让模型先在草稿中把矛盾点标出疑问,注明不同文件记载的具体差异,而不是让模型自行认定某一份就是最新版本。
同样,如果项目待办清单中缺少明确的负责人或交付日期,也应当明确标注为待确认事项,而不是让模型随意猜测补全。这能帮助我们在后续会议中有针对性地向相关人员核对。
当新的摘要草稿输出后,我们应当妥善保留原始文件。随后将草稿中的关键结论与待确认事项,逐一重新对回原本的会议记录和表格来源,确认模型在提取信息时没有产生理解偏差或遗漏。
需要说明的是,上述处理方式属于本文针对该假设场景的任务逻辑设计,并非官方固定提供的默认规则。如果只是对保存在硬盘里的文本进行提炼与重构,可以考虑使用本地模式,但具体效果仍需通过样本验证。
02
查新消息和发邮件,仍要接入网络
然而,模型在本地运行并不意味着整个任务的所有步骤都能自动切断网络。使用全本地模式本身就包含必要的联网前提。在首次开启和设置该功能时,必须先在连接网络的环境下完成应用更新与下载。
用户必须通过最新版Mac应用,按照提示下载并配置本地模型文件。这笔初始的数据下载与基础设置工作,是在本机运行任务前无法绕过的联网步骤,不能误以为安装后就能完全脱离网络进行设置。
其次,当整理摘要的任务需要引入外部最新信息时,联网步骤就会自然增加。例如在整理过程中,如果需要补上一段“今天刚发布的行业新闻”,或者核对某个网页上的最新动态,就必须接入网络。
由于存储在本机的模型无法凭空获取当日的实时资讯,任务此时就必须调用浏览器或网络接口发起检索。系统在这个节点会产生明确的网络请求,从而完成外部信息的获取与补充。
另一个新增联网环节体现在后续的交付过程。如果你在本地生成摘要草稿后,准备将其通过电子邮件发送给同事,或者直接在日历中发起会议邀请,这些动作同样需要网络支持。
虽然在本地撰写草稿属于本机处理,但无论是在线同步邮箱还是最终发送邮件,这些动作本质上都是网络传输。我们不能因为草稿由本地模型生成,就误以为发送过程也无需网络连接。
因此,拆解一个任务时,需要区分任务内容、模型运行地点以及资料的去向。本地处理仍需看具体权限、模式和资料去向,不能简单地将本地运行等同于全过程断网。
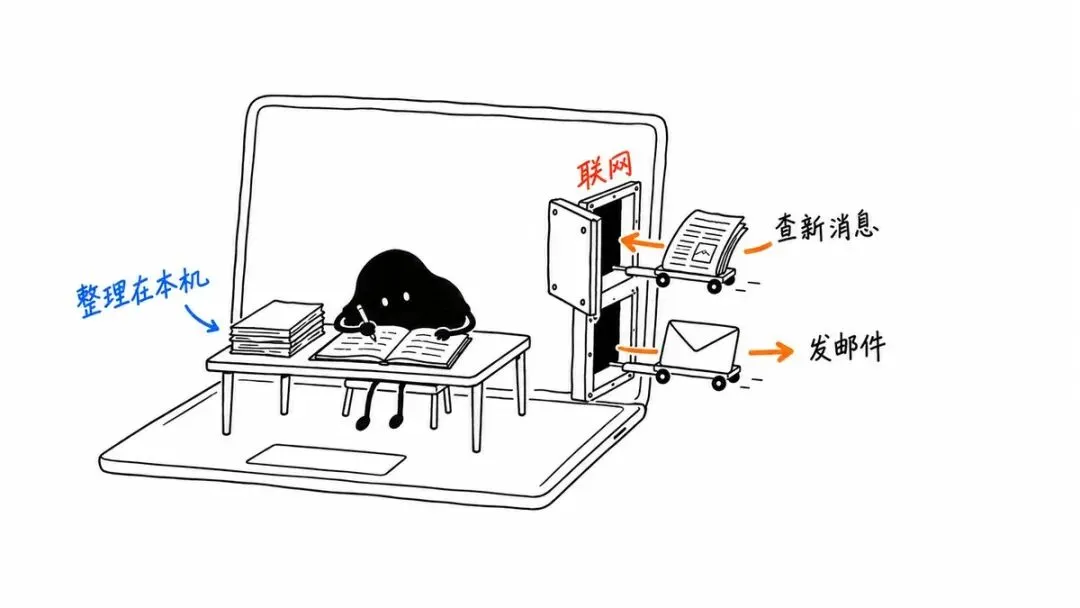
评估是否需要联网,关键在于了解核心资料是否仅保存在本机,以及是否需要远端实时信息或云端服务。弄清楚任务各个节点的请求路径,有助于我们在日常操作中更好地把握工作节奏。
03
全本地与混合,按自己的任务选择
在硬件与系统条件方面,官方信息显示该功能面向Perplexity Pro、Max及Enterprise订阅用户,且需要运行在受支持的Apple silicon芯片Mac设备上。不同配置的设备在实际运行速度上会有所差异。
在运行内存方面,官方给出了推荐36GB及以上统一内存的建议。这是基于良好体验的官方推荐配置,并不等同于一刀切的最低门槛,也不代表该配置能保证所有复杂任务都能高速完成。
除了全本地模式,此前已经存在的混合计算模式依然是可选方案。了解两者的区别有助于根据任务选择合适的模式。混合模式的任务起点在云端,由云端协调研究规划与推理逻辑,遇到本地私有文件时再调用本地模型处理。
相比之下,全本地模式则是完全从Mac本机启动,任务规划、推理与文件处理过程默认保存在本机。两种模式在任务的启动入口与算力分配上存在着明显的区别。
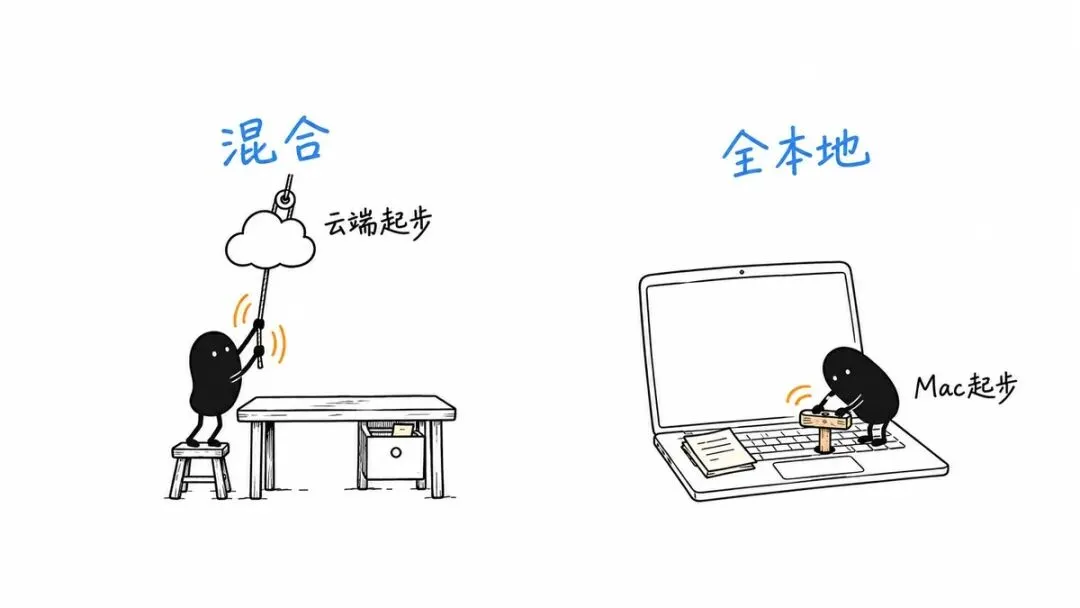
如果处理的本地文件敏感度较高,且任务本身不需要频繁获取网络信息,可以优先考虑全本地模式。若任务极其复杂,且需要结合大量网络搜索,混合模式或许是更切合实际的选择。
虽然官方指出了代码与工具运行在隔离的沙箱环境,但用户在授予文件和应用权限时仍需保持合理的谨慎。了解不同应用在系统中的权限范围,是使用各类桌面AI工具时的正常习惯。
对于想要尝试这一模式的用户,比较现实的方式是利用已有的Mac设备,先挑选一两份不敏感的样本文件进行测试。通过实际操作来观察应用能否顺利完成具体的文本提炼与格式整理。
理清全本地与混合模式各自的启动路径,看懂任务在什么时候会请求云端支持,就能在处理日常文件时更清楚数据的流动方向。结合自己的设备条件与具体的文档任务,选择适合自己的工作方式即可。