ARTICLE · 1227450
OCR 工程实践:文档曲面矫正——把图拉平,以及判断该不该拉
📌 系列第二篇。上一篇讲了模糊检测,解决的是"哪一部分不可信"。这一篇讲曲面矫正(Document Dewarping),解决的是另一个方向的问题:几何上就不对的图,怎么还原。文中所有结构、阈值、代码片段均来自真实项目代码实践。
一本书摊开放在桌上拍照,靠近装订线的那几行字是弯的。人眼读起来毫无障碍——我们知道那行字本来是直的,脑子自动把它捋平了。
文本行检测模型没有这个能力。它老老实实地沿着弯曲的字画了一个弯曲的框,识别引擎拿到一串被拉伸、被挤压的字形,输出一堆似是而非的符号。
问题不在识别,也不在检测。问题在于这张图在几何上就不是一张"平"的文档。
于是流水线上需要第二个前置模块:在检测和识别之前,先把这张弯曲的纸重新拍平。
这件事听起来简单,做起来有三个绕不过去的坎——而第三个,是绝大多数方案会忽略的。
一、为什么"拍平"比想象中难
最直觉的做法是找文档的四条边,算一个透视变换(homography),把四边形拉成矩形。它对"斜着拍了一张平纸"有效,但对曲面无效:
曲面不是单一 homography 能描述的。 书页的鼓包、试卷的卷边、纸张的自然下垂,形变是逐点变化的连续场。一个 3×3 的矩阵只能表达平面到平面的映射,表达不了"这张纸中间凸、四角塌"。 Ground truth 拿不到。 监督一个形变场,需要成对的"扭曲图 + 对应的平面图 + 逐像素映射关系"。真实拍摄永远拿不到第三项。这直接决定了这条路只能靠合成数据。 拉平之后应该多大? 这是个必须先回答、但经常被忽略的问题。A4 是 1:1.414,试卷可能是 1:1.3,一页教辅裁下来可能是任意比例。输出尺寸未知,意味着输出分辨率也未知——而分辨率直接决定后面的字还认不认得出来。
还有第四个坎,也是最容易被忽略的一个:
如果这张图本来就是平的,矫正就是纯粹的破坏。
任何矫正都要经过一次重采样。重采样必然损失清晰度。对一张平板扫描件做曲面矫正,收益是零,代价是实打实的分辨率损失和边缘锯齿。
所以一个能上生产线的曲面矫正模块,必须自带一个开关:这次我不动手。
二、系统整体技术架构
系统分三层:
处理链路:
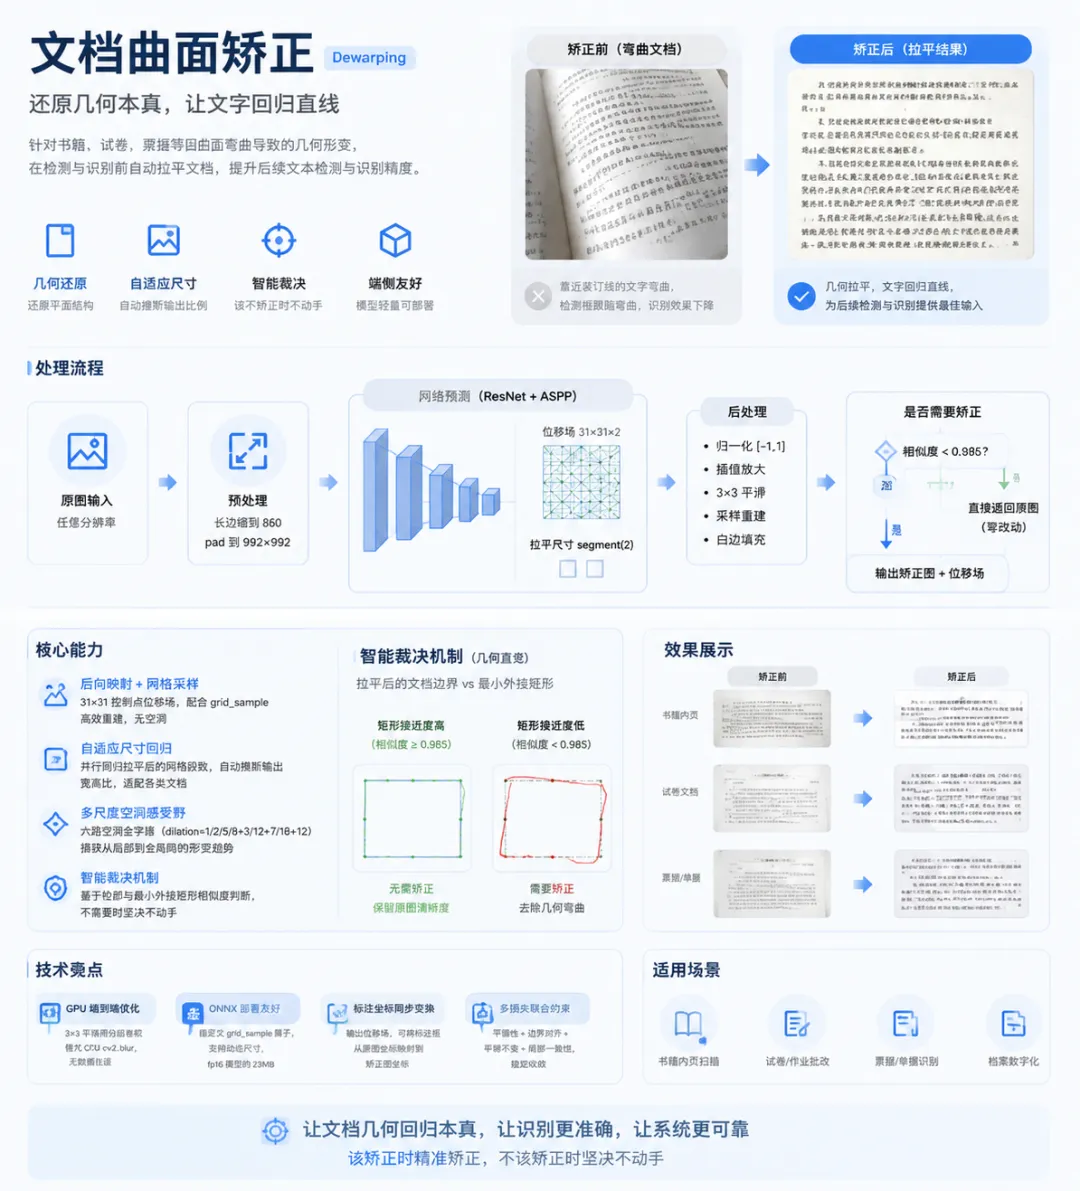
原图(任意分辨率)↓ 长边缩到 860,居中 pad 到 992×992骨干网络(resnet_head → resnet_down → 六路空洞 bridge)├─→ out_regress : [B, 2, 31, 31] 后向位移场(粗粒度)└─→ segment_regress: [B, 2] 拉平后的网格段数(隐含宽高比)↓归一化 (bm / 992 - 0.5) × 2 → [-1, 1]↓由 segment 推出 flat_h / flat_w,双线性插值放大到全尺寸↓3×3 均值模糊平滑位移场↓┌──────────────────────┐│ 是否需要矫正判定 │──→ 否 → 直接返回原图(零改动)└──────────────────────┘↓ 是F.grid_sample 重采样 + 白边填充↓输出:矫正图 + 位移场(.npy)↓xml_trans:标注框坐标随图变换
注意最后一层的分支。判定"不矫正"时返回的是原图本身,一个像素都不动。这个分支的存在,比矫正算法本身更能决定这个模块能不能上线。
三、核心技术一:为什么是后向映射
把扭曲图 D 拉平成平面图 F,有两种描述方式:
前向映射(forward map):对 D 的每个像素,算出它应该去 F 的哪个位置。问题是 F 上会留下大量空洞——多个源像素可能挤到一处,另有一些位置无人认领,需要额外的孔洞填充。 后向映射(backward map):对 F 的每个像素,算出它应该从 D 的哪个位置取值。目标图每个位置都有明确的来源,一次双线性采样直接出图,没有空洞。
项目选的是后向映射,网络输出 2 通道的位移场:
out_regress = self.out_regress(bridge)# [B, 2, 31, 31]
后处理时把绝对坐标归一化到 [-1, 1],直接喂给 F.grid_sample:
bm = output.permute(0, 1, 3, 2)# [B,2,H,W] -> [B,2,W,H]bm = (bm / self.target_size - 0.5) * 2
注意:permute(0, 1, 3, 2) 这一步极易漏。位移场的两个通道是 (x, y),而 PyTorch 的张量维度是 (H, W)。漏掉这个转置,位移场会沿主对角线翻转——矫正结果看起来"有点像但又完全不对",是非常难排查的一类 bug。
3.1 为什么位移场只有 31×31
骨干最后一层特征图的空间尺寸恰好是 31×31(992 ÷ 32 = 31),网络直接在这个分辨率上回归位移。换句话说,网络只预测 31×31 = 961 个控制点的位移,剩下的靠双线性插值放大。
这个设计是刻意的,也是这套方案能在端侧跑起来的关键:
961 个控制点足够描述一页纸的整体弯曲趋势(人眼看一页纸的形变,用的信息量比这还少); 输出头极小, out_regress只有两层 3×3 卷积;插值放大的代价是块状 artifacts,这正好由下一节的 3×3 平滑来兜。
项目里还预留了一个 UltraFastTPSTransformer(31×31 网格的薄板样条求解器)实现,思路是用 TPS 做更平滑的插值。但它最终没有接入主线:
self.transformer = UltraFastTPSTransformer(grid_size=31, device='cpu')# 实际上没有用到
原因很现实:TPS 需要在推理时对一个 (31×31+3) 阶矩阵求逆,端侧 runtime 上代价高、算子支持差,而双线性插值 + 3×3 平滑的效果已经够用。工程选择常常不是在好和更好之间选,而是在够用和可部署之间选。
四、核心技术二:把"拉平后多大"也交给网络
这是方案里第二个不那么直觉的设计。
网络除了位移场,还并行回归两个数:
self.segment_regress = nn.Linear(self.num_filter * map_num[2] * 31 * 31, 2) 这两个数是拉平后文档在横竖两个方向上的"网格段数",它们的比值就是拉平文档的宽高比。推理时保持原图长边不变,按这个比值推出短边:
ratio_res = segment[0][0] / segment[0][1]flat_h, flat_w = (h, int(h / ratio_res)) if h >= w else (int(ratio_res * w), w)bm = F.interpolate(bm, size=(flat_h, flat_w), mode=”bilinear”, align_corners=True)
为什么不直接回归 flat_h 和 flat_w 两个像素值?因为像素值是高方差、无约束的连续量;而"网格段数"是一个被量化到 32 的倍数上的离散量(992 = 31 × 32),网络的回归目标更平滑、更容易收敛,也更不容易输出荒谬的尺寸。
导出 ONNX 时这一步还做了取整:
segment = segment.round().int()flat_shap = segment[0] * 32 * ratio.round()
注意:把连续量离散化后再回归,是一个通用的工程技巧。它的本质是用先验约束缩小解空间——不要指望网络从零学出"A4 纸的比例大概是多少",而是让它在一个已经正确的量纲里微调。
五、核心技术三:六路空洞卷积金字塔
backbone是一个做了两处改造的 ResNet:
self.resnet_head = nn.Sequential(nn.Conv2d(3, 32, kernel_size=3, stride=2, padding=1),nn.BatchNorm2d(32), nn.ReLU(inplace=True),nn.Conv2d(32, 32, kernel_size=3, stride=2, padding=1),nn.BatchNorm2d(32), nn.ReLU(inplace=True),)self.resnet_down = ResNetV2StraightV2(num_filter=32,map_num=[1,2,4,8,16],BatchNorm=BatchNorm,block_nums=[3,4,6,3],stride=[1,2,2,2])
主干内部大量使用 dilation=3 的空洞卷积(ResidualBlockWithDilatedV1),而不是标准 3×3。原因是:判断某一个位置的位移量,需要看到整页的弯曲趋势,局部纹理几乎没有信息量。
最值得说的是六路 bridge,它的 dilation 配置是精心排布的:
六路并行后 concat,再用 1×1 卷积压回 128 通道:
bridge_concate = torch.cat([bridge_1, bridge_2, bridge_3,bridge_4, bridge_5, bridge_6], dim=1)bridge = self.bridge_concate(bridge_concate)# 1536 → 128
注意 bridge_4/5/6 是两级级联而非单级:18 → 12 的级联比单级 18 更容易训练,也更接近"先大范围定位、再细化"的直觉。这是 ASPP 结构在回归任务上的一个实用变体。
整个模型 num_filter=32,参数量控制在 4500 万量级以内(含全连接的 segment_regress),导出 fp16 后模型文件约 23 MB。
六、核心技术四:后处理的三个动作
6.1 3×3 均值模糊:为什么必须平滑位移场
网络输出的 31×31 位移场经过插值放大后,会带有明显的块状阶梯。直接拿去采样,文字边缘会出现锯齿甚至撕裂。
所以位移场在采样前要平滑:
bm[:, :1] = self.blur(bm[:, :1])bm[:, 1:] = self.blur(bm[:, 1:])
3×3 是个折中:核太小压不住阶梯,核太大会把真实的强形变(比如书页装订线附近)一起抹平,导致矫正不足。
值得一提的是这部分代码实现的演进:
v1 版本用 cv2.blur,意味着位移场要从 GPU 搬到 CPU、转成 numpy、算完再搬回去;v2 版本改成用 F.conv2d的分组卷积在 GPU 上完成,全程无数据往返。
class Blur(nn.Module):def __init__(self, ksize):kernel = torch.ones((1, 1, *ksize)) / (ksize[0] * ksize[1])self.register_buffer('kernel', kernel)def forward(self, x):return F.conv2d(x, self.kernel, stride=1, padding=self.padding, groups=x.shape[1])
这是一个典型的"算子改写"优化:算法没变,只是把实现搬到了数据所在的地方。在推理链路里,数据搬运的代价经常超过计算本身的代价。
6.2 采样与白边填充
mask = (bm.abs() <= 1).all(dim=-1).unsqueeze(1)# (1, 1, H, W)out_img[~mask.expand_as(out_img)] = 1# 填充白色
位移场超出 [-1, 1] 的位置,说明目标像素在原图里找不到对应内容——这些是矫正后多出来的空白区域。填白色而不是黑色,因为文档的背景色就是白的。这个细节错了,输出图上会出现刺眼的黑角。
6.3 尺度换算:从 992 回到原图
前处理时把图 pad 到了 992×992,后处理的 padding 必须换算回原图尺度:
pad_left = round(pad_left * w / new_w)pad_top = round(pad_top * h / new_h)out_img = F.pad(input, pad=(pad_left, pad_left, pad_top, pad_top),mode='constant', value=1)
注意:换算用 round 而不是 int。int 是截断,会在上下、左右产生不对称的偏移,累积成一个像素级的整体错位。矫正任务对错位的敏感度远高于分类任务——差一个像素,文字边缘就已经糊了。
七、核心技术五:该不该矫正——一个被低估的问题
这是本方案里我认为最值得讲的部分。
7.1 为什么必须判断
前文说过,矫正的代价是分辨率损失,收益是几何归位。当收益为零(图本来就是平的)时,执行矫正就是净损失。
更麻烦的是:模型是用"曲面文档"训出来的,它对任何输入都会输出一个非零位移场。它不会主动告诉你"这张图不需要我"。
判定逻辑必须自己加。
7.2 第一版:三个指标(0827)
第一版算了三个量,任一超阈值就矫正:
ratio_diff = abs(pred_ratio - orig_ratio) / orig_ratio# 宽高比差异disp_mag = bm.pow(2).mean().sqrt() / ((h**2 + w**2) ** 0.5)# 位移场强度curvature_score = dy.std() / orig_ratio# 曲率need = (ratio_diff > 0.1 or disp_mag > 0.02 or curvature_score > 0.01)
思路是对的——从"宽高比、位移强度、弯曲程度"三个角度分别设卡。但工程上有两个问题:
三个阈值要分别调,且三者的量纲、分布完全不同,调参时互相牵制; curvature的实际计算是 bm[:, :-1, 1:, :] - bm[:, :-1, :-1, :],只在水平方向做了差分,却把它命名为"曲率"。变量名叫dy,实际求的是 x 方向梯度。这种命名与实现不符的地方,是后续维护时最容易埋雷的地方。
7.3 第二版:一个几何直觉(0829)
第二版换了个思路,只用一个量:
如果拉平之后的文档边界本身就是矩形,那它本来就是平的。
# 取位移场的四条边,拼成轮廓top = [(xs[0, j], ys[0, j]) for j in range(W)]bottom = [(xs[H-1, j], ys[H-1, j]) for j in range(W)]left = [(xs[i, 0], ys[i, 0]) for i in range(H)]right = [(xs[i, W-1], ys[i, W-1]) for i in range(H)]contour = np.array(top + right[::-1] + bottom[::-1] + left, dtype=np.float32)# 轮廓 vs 它的最小外接矩形rect = cv2.minAreaRect(contour)box = cv2.boxPoints(rect)intersection = np.logical_and(mask_contour, mask_box).sum()union = np.logical_or(mask_contour, mask_box).sum()similarity = intersection / (union + 1e-6)need = similarity < 0.985
三个阈值换成一个阈值,而且这个阈值有明确的几何含义:矫正后的文档轮廓与它自己的最小外接矩形有多接近。一张真正弯曲的纸,拉平之后边界不可能是规整矩形——因为纸的物理边界在三维空间里是弯的,投影回二维必然带弧度。
阈值取 0.985,非常严。这是刻意的方向性选择:
注意:宁可不矫,不可过度矫。漏矫的代价是"这张图的文字还是弯的",下游照常工作,只是效果打折;过度矫的代价是"把一张清晰的图搞糊了",下游直接崩。两类错误的代价完全不对称——这一点和上一篇模糊检测里"在入口处宽容、在裁决处严格"是同一个取向。
从三指标到单指标的演进,真正的收获不是省了两个阈值,而是找到了一个有物理意义的可观测量。指标越接近问题的本质,阈值就越容易定,也越容易向别人解释。
之所以这么实现,是因为业务使用的时候对于扭曲不严重的图片倾向于原图输入到后续流程,故此进行当前实现。具体是否需要参考,取决于业务流程。
八、数据:合成数据是这套方案的地基
真实世界的成对数据(扭曲图 + 平面图 + 逐像素映射)拿不到,所以训练数据只能是合成的。项目里用了三条路:
doc3d_root_path | ||
uv_root_path | ||
gen_root_path | ||
generate_document_3.py |
最后一项是这套方案能学会"该不该矫正"的关键。
8.1 负样本必须专门造
如果训练集里全是曲面文档,模型从来没见过"平"的样本,它对任何输入都会输出一个非零位移场——"不需要矫正"这个类别在数据里根本不存在,网络自然学不出来。
自建负样本的做法很朴素(generate_document_3.py):
reduce_value = np.random.choice([0, 4, 8, 16, 24, 32])# 四周随机留边...bg_img = cv2.resize(bg_img, (bg_w, bg_h))# 随机真实背景bg_img[reduce_value:reduce_value+new_h,reduce_value:reduce_value+new_w] = image# 把平整文档贴上去
要点有三:
用真实拍摄的背景图而不是纯色,让模型见过桌面、纹理、光影; 文档四周随机留边,避免模型把"文档占满画面"当成"需要矫正"的伪特征; 因为文档是平的,31×31 的控制点就是规则网格,标注零成本。
8.2 损失函数:四条约束各管一段
loss_fn_dewarp | 0.8 × smooth_l1 + 0.2 × mse | |
loss_local | ||
loss_edge2 | ||
DocunetLoss_v2 | |d|.mean() − 0.1 × |d.mean()| |
loss_edge2 的方向权重是个细节:
weights_top = torch.where(diff_top < 0, alpha, beta)# alpha=0.8, beta=1.0
上边界往内收(diff < 0)权重 0.8,往外扩权重 1.0。因为两个方向的错误代价不同:往内收会切掉文档内容,往外扩只是多留一点白边。把这种不对称直接写进损失函数,比事后靠阈值补救有效得多。
loss_local 的 17×17 十字核也值得一提:它算的是"某点的位移与它周围 17 个点的位移均值之差",本质是位移场的平滑性正则,但只约束十字方向而非全窗口,是为了保留纸张在横竖两个方向上的独立弯曲能力。
九、工程部署
9.1 前处理:长边 860 + pad 到 992
new_h = (new_h // 2) * 2new_w = (new_w // 2) * 2
两处细节:
偶数化:骨干里有多次 stride=2 下采样,奇数尺寸会造成 off-by-one 的累积误差; 992 = 31 × 32:与 31×31 的控制点网格严格对齐。这不是巧合,是先定了控制点数(31)再反推出输入尺寸。
9.2 ONNX 导出:grid_sample 是个坎
标准 ONNX 算子集没有 grid_sample,需要用 torch.autograd.Function 挂一个自定义算子:
class _OnnxInferGridSample(torch.autograd.Function):@staticmethoddef symbolic(g, input, grid):return g.op(”onnxinfer::grid_sample”, *[input, grid], **{})
导出配置:
torch.onnx.export(model, image, output_file,input_names=['input'],output_names=['out_img', 'out_map'],opset_version=11,dynamic_axes=dynamic_axes,operator_export_type=torch.onnx.OperatorExportTypes.ONNX_ATEN_FALLBACK)
三个要点:
双输出:除了矫正图 out_img,还输出位移场out_map。这一点后面会用到;动态轴:H/W 必须动态,因为输出尺寸由 segment决定,编译期未知;fp32 / fp16 双版本:模型文件从 46.7 MB 降到 23.8 MB,正好减半。
注意:fp16 版本的 grid_sample 用了 padding_mode='border',而 PyTorch 版本用的是 'zeros'。两种 padding 在边界处的采样行为不同,会产出不同的边缘像素。跨版本对齐结果时,这是第一个要查的地方。
9.3 为什么要把位移场输出来
导出 out_map 看起来是多此一举——下游要的是图,不是位移场。
但位移场是这套方案的通用中间产物。有了它,任何与原图坐标绑定的信息都能跟着变换到矫正图上——最典型的就是标注框。这是下一节的内容。
十、标注坐标随图变换:别让标注白标了
图矫正完了,标注怎么办?
如果标注还留在原图坐标系里,那么矫正后的图和标注就对不上了——整批数据报废。必须让标注跟着图一起变换。
做法是把位移场展开成一张查找表:
def remap(map, shape=(0, 0)):w, h = shapemap_x = ((map[:, :, :, 0] / 2) + 0.5) * w# 反归一化回像素坐标map_y = ((map[:, :, :, 1] / 2) + 0.5) * h...return ori_map_cord, map_cord
ori_map_cord 是原图(含 padding)坐标,map_cord 是矫正图坐标,两者一一对应。对每个标注点,先补上 padding 偏移,再在 ori_map_cord 里找最近邻:
x = int(float(point[0])) + round(left)y = int(float(point[1])) + round(top)length = np.sqrt(np.power(x - ori_map_cord[:, 0], 2) +np.power(y - ori_map_cord[:, 1], 2))map_index = np.argmin(length)result = map_cord[map_index]
三个必须注意的地方:
padding 换算必须与推理端完全一致。推理端用 round,这里也必须round;推理端 pad 到 992,这里也必须按 992 算。差一点点就是整页标注的系统性偏移。rect和 area两种标注结构要统一。XML 里既有四点area也有x/y/w/h的rect,代码先把rect转成area再统一处理,避免两套映射逻辑产生分歧。最近邻查找是 O(N) 暴力搜索。N 是矫正图的像素数,一张 2000×1500 的图就是 300 万次距离计算 × 每个标注点。当前实现靠 30 进程 multiprocessing硬扛:
img_files_list = split_list(image_filenames, n=30)pool = multiprocessing.Pool(processes=30)
更好的做法是直接对位移场做双线性索引,或者建一棵 KDTree 把查询降到 O(log N)。这类"用多进程掩盖算法复杂度"的方案,能跑但跑不久——数据量翻一倍时,进程数没法跟着翻倍。
十一、复盘:五个真实存在过的坑
1.segment的顺序在不同批次里不一致。
(x, y) 和 (y, x) 两种约定混在同一份训练集里,靠一行翻转来兜。这类"数据约定不统一"的问题,表现出来的是模型收敛慢、精度上不去,但代码不报错、日志不异常,是最难定位的一类问题。
2.curvature名不副实。
前文提过,0827 版本里名为 dy/curvature 的量,实际只在水平方向做了差分。它能用,但名字误导了后续所有人。
3. 定义了但没用的模块。
self.transformer = UltraFastTPSTransformer(grid_size=31, device='cpu')# 实际上没有用到
TPS 变换器被实例化、挂在模型上,因此会进入state_dict、会被保存、会被加载,但从不在 forward 里被调用。它白白占用了权重文件体积和加载时间。死代码挂在模型成员上,比躺在文件里的死代码危害大得多。
4. 位移场在 CPU / GPU 之间来回搬。
0529 版本用 cv2.blur 平滑位移场,意味着 GPU → numpy → CPU → 计算 → GPU 的完整往返,每个样本两次。0829 版本改成 GPU 上的分组卷积后消除。
5. 导出版本里白边填充被注释掉了。
# mask = (bm.abs() <= 1).all(dim=-1)# out_img[~mask.expand_as(out_img)] = 1
这几行是注释状态。也就是说PyTorch 推理版本和 ONNX 导出版本在边界处理上行为不一致——本地看着没问题,上线后边缘出现黑边。这类"两个版本各自演化"的问题,靠 code review 很难发现,只能靠同一批样本的逐像素对比来兜。
结语
上一篇模糊检测的结论是:让系统知道自己的哪一部分不可信。
这一篇曲面矫正的结论,几乎是它的镜像:让系统知道自己在什么时候不该动手。
把一张弯曲的纸拉平,技术含量在位移场、在空洞卷积、在损失函数。但让这个模块真正能进生产线的,是那个 similarity < 0.985 的判断——是它让模块具备了"拒绝执行"的能力。
这背后是一条更普遍的原则:任何有副作用的处理,都必须自带一个"这次不动手"的开关。
曲面矫正是这样,去水印是这样,超分是这样,去摩尔纹也是这样。这些模块的共同点是:它们都在改写像素,而改写像素必然有代价。一个只会"执行"而不会"拒绝"的模块,在流水线上是危险的——它会在不需要它的时候,安静地制造损失。
还有一点值得带走:判断"该不该做"的指标,要尽量贴近问题的物理本质。从三个经验阈值(宽高比、位移强度、曲率)到一个几何可观测量(轮廓与最小外接矩形的重合度),减少的不是一个数字,而是调参时的盲目性和解释时的含糊。当你很难向别人解释一个阈值为什么是 0.02 而不是 0.03 时,通常说明这个指标选错了。