ARTICLE · 1230690
WorkBuddy系列:扫描版PDF转Excel
发布时间:2026-10-22 21:06:14 最近访问:2026-10-22 22:58:14
WorkBuddy系列:扫描版PDF转Excel
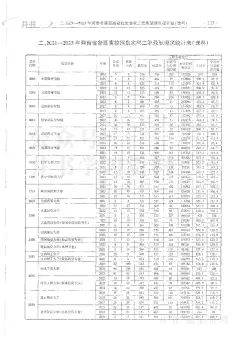
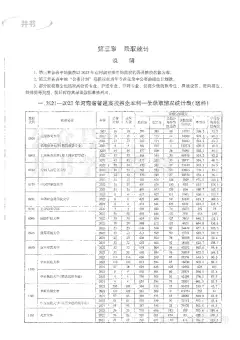
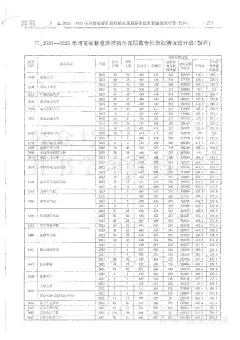
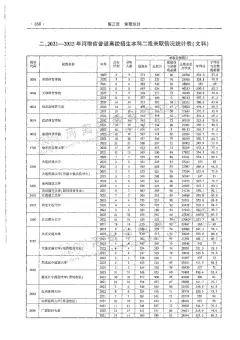
你大概也遇到过:收到一沓扫描版PDF,要把里面的表格变成Excel,结果丢进工具,出来要么是一片空白,要么行列全乱。WorkBuddy确实能把扫描PDF转成xlsx,但这里先泼盆冷水——它不是「丢进去就完美」的一键魔法。扫描件的核心在两步:OCR质量+表格结构还原,任何一步翻车,出来的表都得返工。用鼠标在PDF里划一下文字:
· 能选中 → 文字层PDF,直接抽表格,基本不掉链子;
· 选不中、是一片图片 → 扫描版/图片型PDF,必须先走OCR,否则WorkBuddy抽出来是空的;
· 前几页电子版、后几页扫描件 → 混合型,极易漏页,必须明确告诉它「从第X页开始是扫描件」。
⚠️ 加密/禁止复制的PDF WorkBuddy读不了,得先用PDFtk或ILovePDF解锁。1. 准备工作区
· 把要处理的PDF放到同一个本地文件夹;
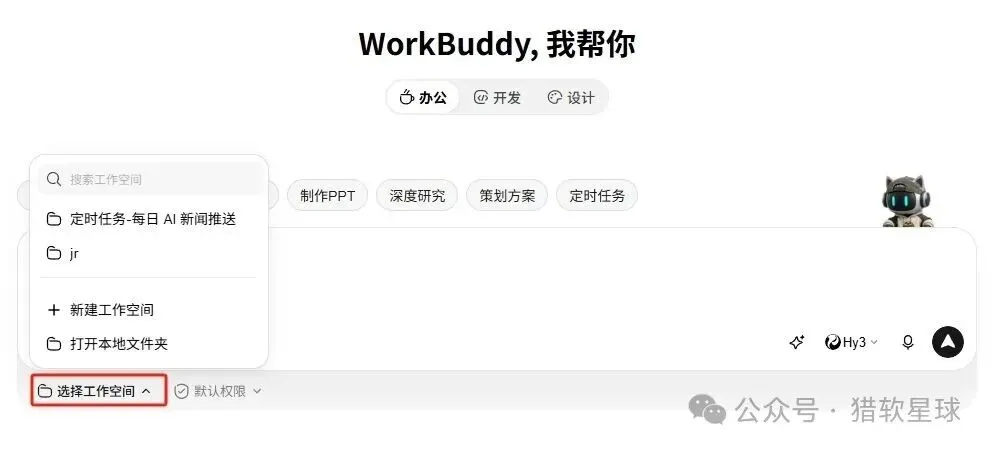
· 打开WorkBuddy → 新建任务 → 把这个文件夹设为工作目录(或直接把文件拖进对话框、@引用)。
2. 发这条指令(单文件版,可直接复制)
对这份扫描版PDF开启OCR,识别其中所有表格, 保留行列结构和合并单元格逻辑,输出为.xlsx文件。 要求: - 跨页表格自动合并为一张表,表头只保留第一行,删掉重复表头 - 金额、日期、数量各自分列,日期统一 YYYY-MM-DD - 识别置信度低或歪斜的单元格,在旁边标"需复核" - 另开一个sheet列"存疑项":页码+字段+原因 - 输出文件保存到当前工作目录3. 批量版(一文件夹多份)
读取本文件夹下所有PDF,逐份做OCR并提取表格, 每份PDF的数据放一个sheet(用文件名命名), 再汇总成一张"总表"sheet。 金额类字段必须给出原文上下文原句,方便复核。 先拿前3份跑通再全量跑。💡 「先跑3-5份」这句不是废话——批量任务第一个坑,就是中途漏算后半截。4. 等它跑完,去Artifacts面板拿xlsx
生成后别直接发出去,至少抽查:金额求和、日期格式、合并单元格有没有挂错行。
| | |
|---|
| | |
| | 先用pdf24或PDFCandy做「增强扫描」(纠偏+提对比度),实测准确率能从62%拉到94% |
| | |
| | 换腾讯云表格识别V3技能,或TextIn xParse连接器 |
| | 让它在备注列同时记「原印刷内容+手写内容+冲突点」 |
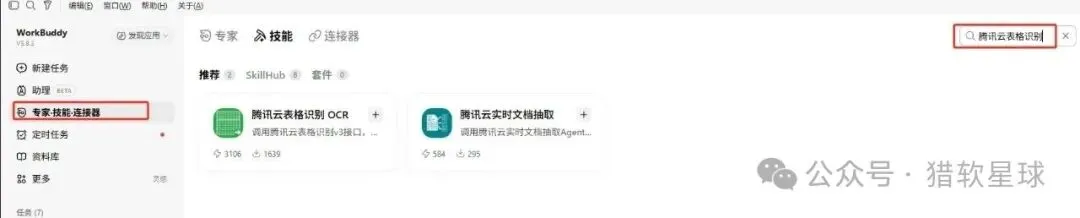
· 腾讯云表格识别V3(SkillHub里装):专门做表格OCR,对无线表格、旋转表格、嵌套表格比通用OCR强很多,直接支持导出Excel;
· TextIn xParse连接器:适合财报、标书这种多层表头+跨页续表,能保留表头层级和阅读顺序,目前对新用户有免费额度。
接法很简单:在「专家·技能·连接器」里搜名字 → 安装 → 指令前加一句「用xxx解析这份文件」。
用OCR识别这份扫描版 PDF 的全部表格,转成Excel。 1. 先纠偏、去噪,再识别;水印压在表格线上的话保留原图、只在识别时忽略水印 2. 每个单元格文字原样落格,不要自行"补全"或"推测" 3. 跨页表格合并为逻辑一张表,重复表头只留首个 4. 金额列保留原始数字,另外加一列"是否含币种/单位符号" 5. 日期统一 YYYY-MM-DD,原文没有写"未注明" 6. 置信度<80% 的单元格标黄 + 列入"存疑"sheet 7. 输出xlsx到当前目录,文件名带日期1. 金额、日期、账号必须人工抽核5%-10%——OCR对「0/O」「1/l」、小数点、千分位符最容易看错;
2. 大文件(100页以上)别一股脑丢进去,先想清楚要哪几页,或分块读,不然容易超时/OOM;
3. 敏感文件(合同/发票/身份证)优先用本地WorkBuddy桌面端,别走网页版上传,授权范围先看清。
OCR质量与表格结构还原,是扫描PDF转Excel的两道关——任何一道失守,出来的xlsx都只是「半成品」。你手头那些堆了半年没动的扫描报表,是真没法自动化,还是只是没给工具说清「从第几页开始是扫描件」?
适用工具:WorkBuddy(推荐本地桌面端处理敏感文件)
提效外挂:腾讯云表格识别V3、TextIn xParse连接器
先点个收藏,下次再遇到扫描件表格要手工抄,把上面的提示词模板直接丢给WorkBuddy试一份——先跑3份,跑通再全量。
关注我们,持续挖掘好用的效率工具
每周分享AI与效率工具实测,不恰烂钱,只讲真话。