ARTICLE · 1234279
Kafka 源码入门:从 Producer 发送到 Broker 存储关键路径
文档告诉你 Kafka 怎么配,源码告诉你它为什么只能这么配。很多面试和排障的"玄学问题"——消息到底什么时候才算发成功、页缓存什么时候真的落盘、消费位点存在哪——答案不在调参文章里,而在一条调用链上。这篇不带你逐行抠源码,只画一张地图:从 producer.send 到消息落盘,关键类和关键岔路分别在哪。
开场:读源码最怕"从第一行开始"
直接打开 kafka 源码仓库,几千个类、Scala 和 Java 混排,多数人三天就放弃。正确姿势是自顶向下带着问题追一条链路。
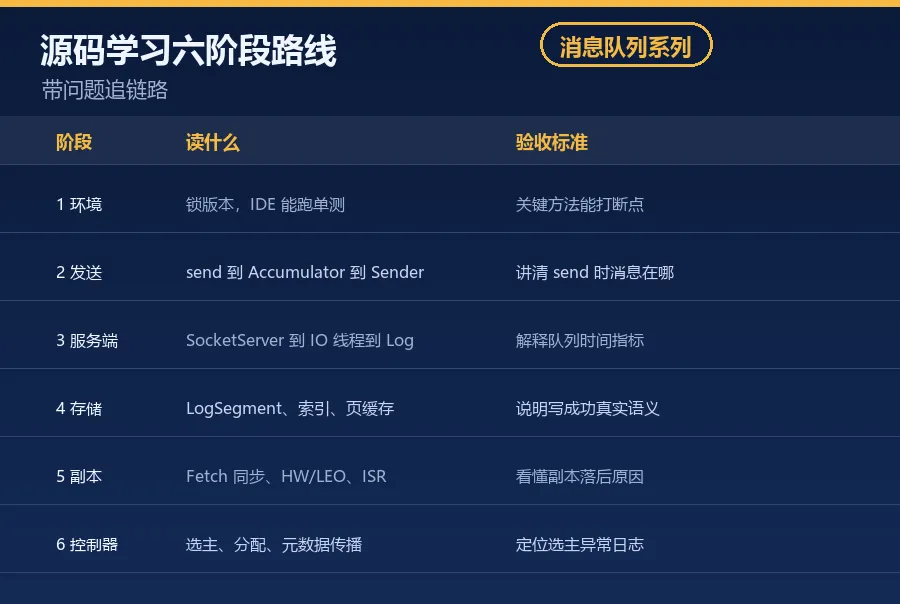
先定版本:锁定一个你正在用的大版本,不同版本包结构差异不小; 先分模块:clients、core(Broker)、存储、网络各管一段; 先追链路:跟着一条消息从发送到落盘走一遍,比通读一百个类有效; 再回头补:走完链路,再补协议、副本、控制器这些支线。
读源码的产出不是"记住所有类名",而是把文档里抽象的机制对应到具体代码位置——出问题时知道去哪打断点。
一、Producer 发送:send 不是立刻发
producer.send() 返回的是一个 Future,但这个调用本身几乎不碰网络。
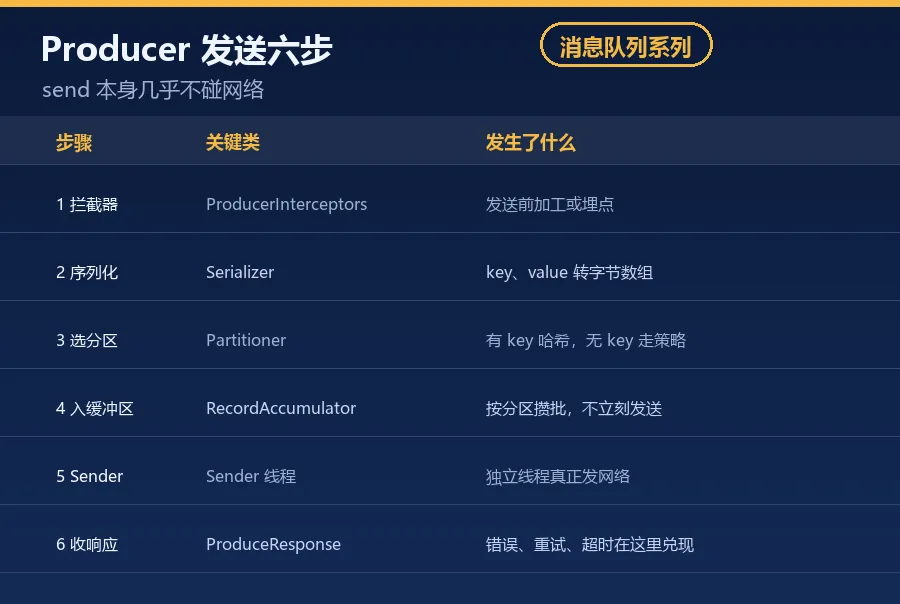
理解这张表,就解开了新手最大的困惑:为什么 send 成功了消息还可能丢? 因为 send 只是把消息放进了客户端的缓冲区(第 4 步)。真正的网络发送在另一个 Sender 线程里,要等它收到 Broker 响应并回调,才算走完"发送确认"。
二、批次缓冲区:RecordAccumulator 的设计
第 4 步的缓冲区是 Producer 性能设计的核心。
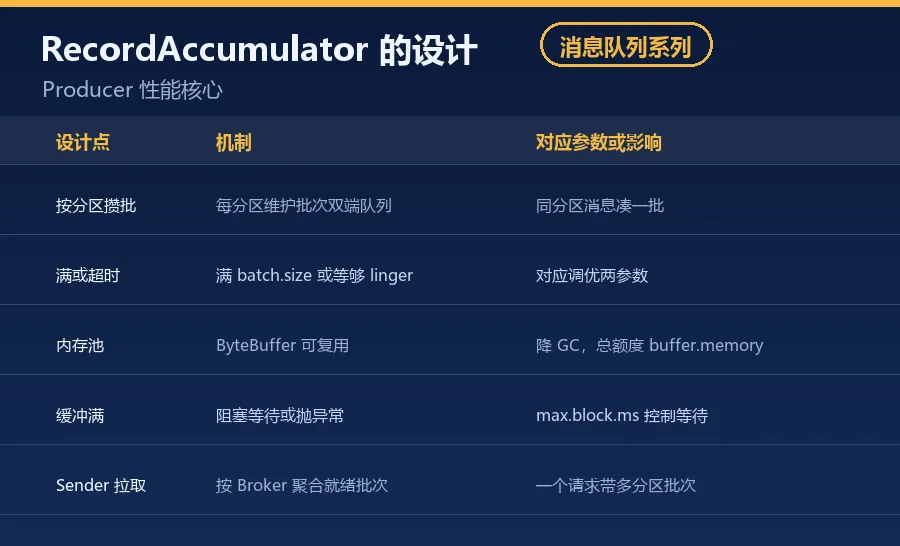
第五行是很精巧的设计:攒批是按分区的,但发送是按 Broker 聚合的——同一个 Broker 上多个分区的就绪批次会被组装进同一个请求,这正是 Kafka 能用很少的请求数扛高吞吐的微观原因。
三、Broker 接收:请求在服务端的三级队列
消息到达 Broker 后,要经过一条明确的线程流水线。
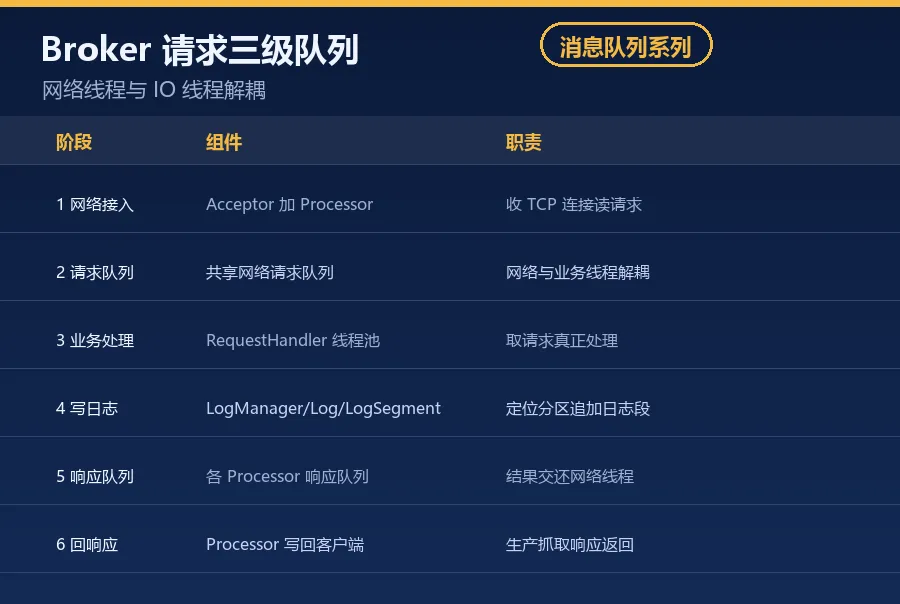
第二、三阶段的分离解释了一个监控指标:第 30 篇说的"请求队列时间"就是请求卡在第 2 步等待 IO 线程的时间——num.io.threads 不够时,请求堆在这个队列里,队列时间升高,但 CPU 可能还没打满。
四、落盘:追加写与页缓存
写日志这一步,是 Kafka 存储性能的根。
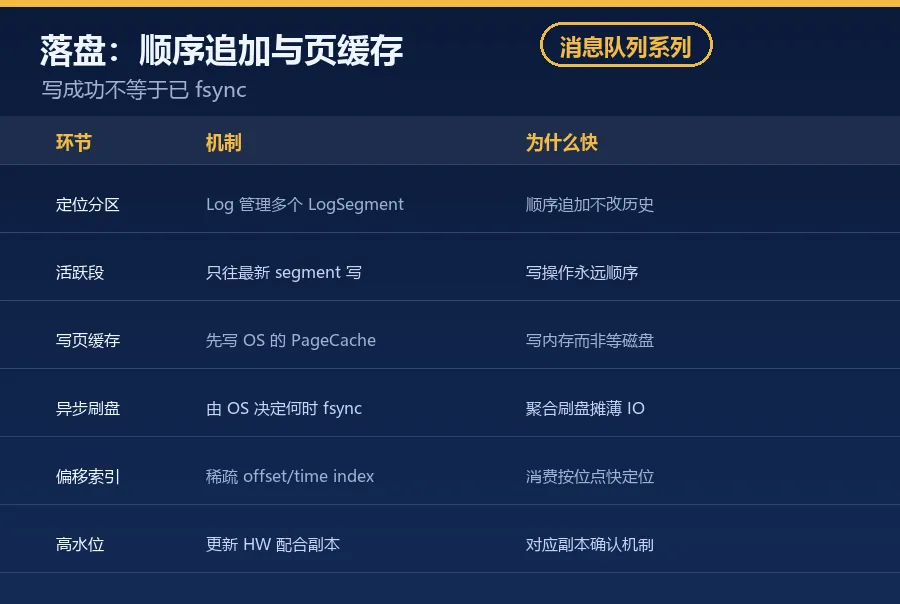
第三、四行再次强调了第 19、20 篇的结论:Broker 写成功的语义是"写进了页缓存",不是"已经物理落盘"。 Kafka 把持久性交给多副本,而不是让单条消息同步刷盘——读源码能看到写入路径上 fsync 并不是每条消息都触发。
五、消费读路径:零拷贝发生的位置
消费侧的链路比生产短,关键优化在数据怎么从文件到网卡。
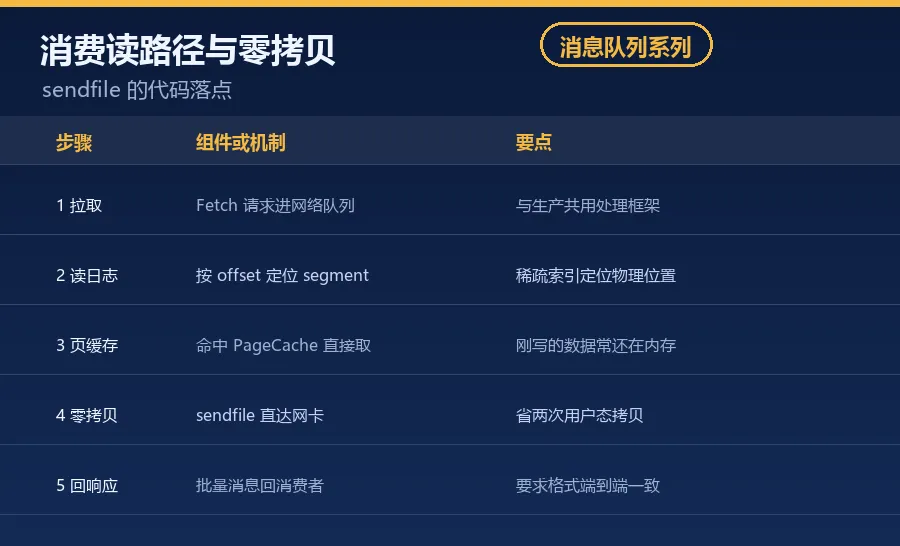
第 4 步就是第 20 篇零拷贝的代码落点:只有消息格式不需要 Broker 转换、数据直接从文件通道发送时,sendfile 路径才成立。 一旦要在 Broker 做解压重组或格式转换,就必须把字节读进 JVM,零拷贝立即失效。
六、源码学习路线清单
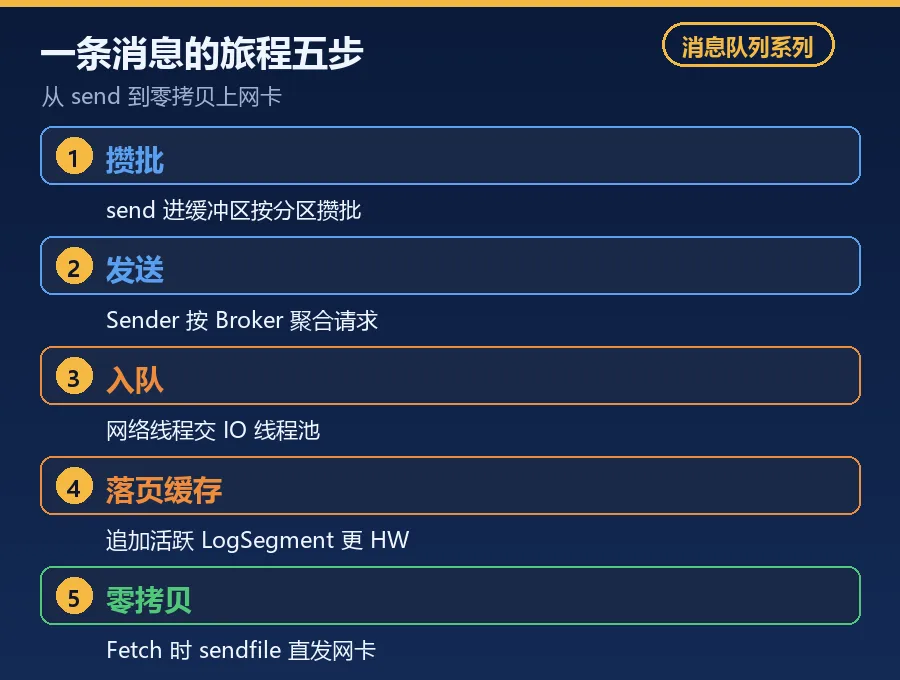
一条消息从生产到可被消费的完整旅程是五步:send 进 RecordAccumulator 按分区攒批,Sender 线程按 Broker 聚合成请求发出,Broker 网络线程把请求交给 IO 线程池,IO 线程追加写入活跃 LogSegment 的页缓存并更新副本高水位,消费者 Fetch 时按偏移索引定位,命中页缓存的消息经零拷贝直接发往网卡。
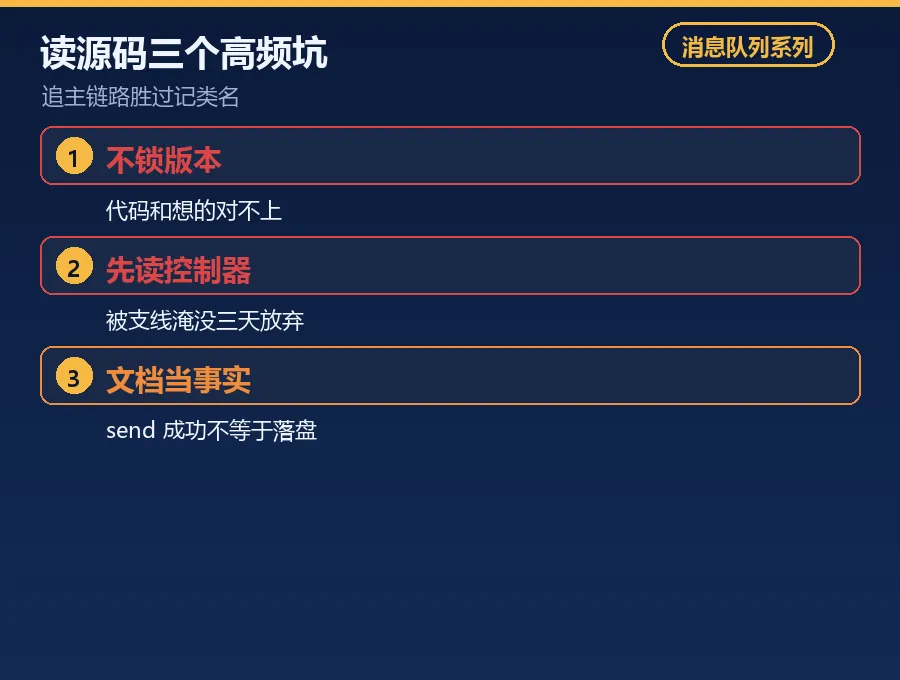
读 Kafka 源码有三个高频坑:不锁版本看到处是"代码和我想的不一样"、一上来通读控制器和副本协议被支线淹没、把文档语义当成代码事实(send 成功不等于落盘、写成功不等于刷盘)——追一条主链路比记住一百个类更有用。
争议话题
「应用开发有没有必要读到 Broker 源码这个深度?」
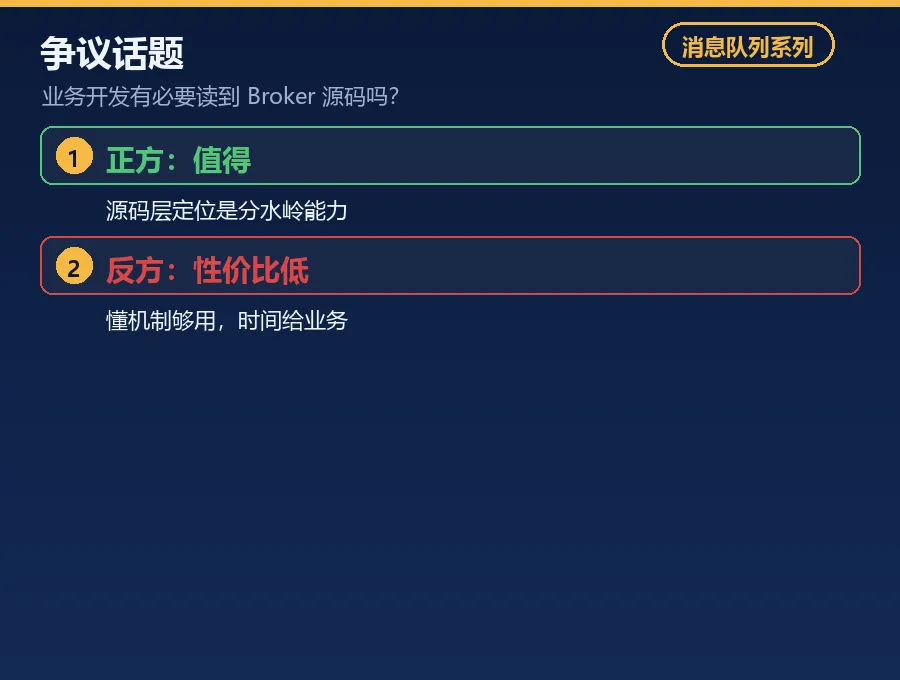
正方(值得读): 中间件出问题时,能在源码层定位的人和只会看监控的人差距巨大;理解写入和副本路径后,可靠性参数不再是背诵项,而是推导项,这是高级工程师的分水岭。
反方(性价比低): 业务开发时间有限,理解机制和关键路径足够支撑选型排障,逐行啃 Broker Scala 源码投入巨大,真正用到的频次很低,不如把精力放在业务架构上。
你读源码时哪一段最让你"原来如此"?是 RecordAccumulator 还是零拷贝?评论区聊聊。
注:Kafka 源码包结构与类名随版本演进,本文基于典型版本的关键路径描述,具体代码请对照你所用的版本。