ARTICLE · 1235333
AI 突然可以"许愿" 了,但我劝你先别急着夸
一、那天晚上,我愣了半天
我有个习惯,晚上收工前刷一遍各家 AI 的更新,像睡前刷朋友圈。
10 月 17 号那天,我在 DeepSeek 官网页面愣了半天。
上个月,这家公司的 V4.1-Flash 还被开发者骂 "像被降智了一样"—— 那是 V2EX 上一个开发者的原话,我写稿时还引用过,语气里的无奈我记得很清楚。
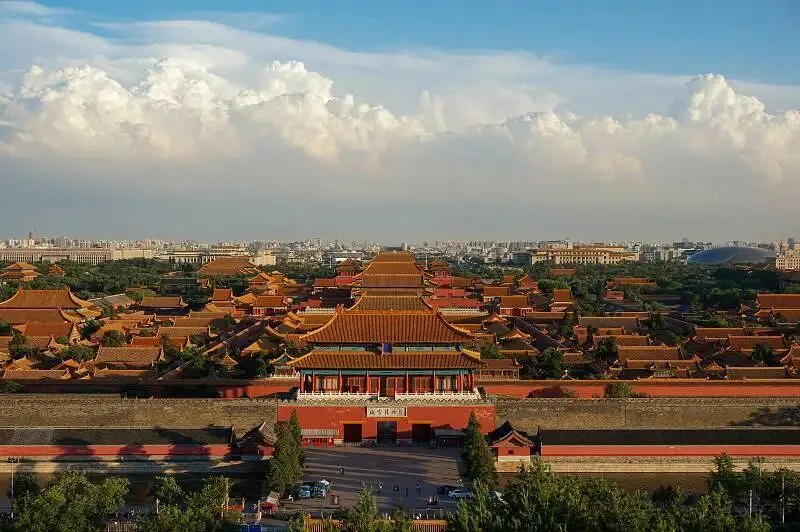
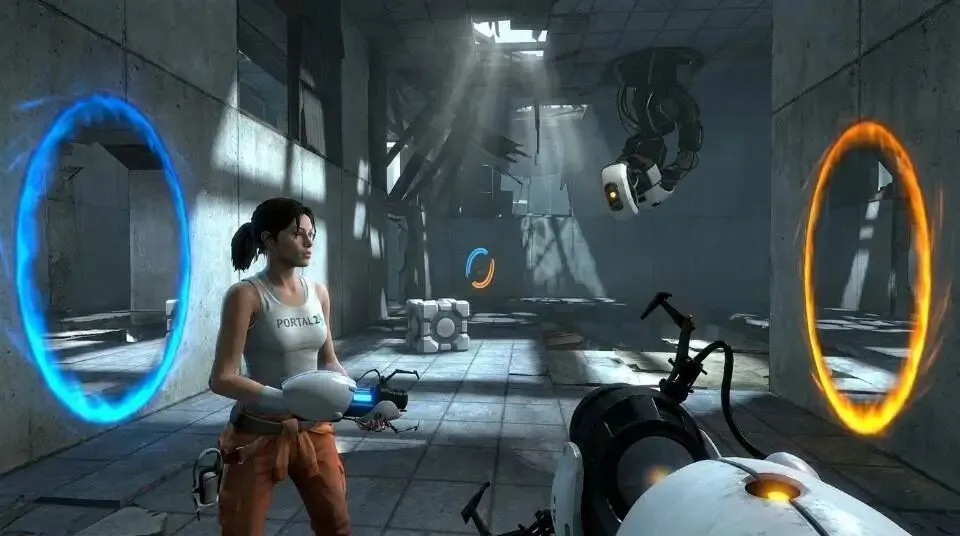
结果就隔了一个月,同一个模型,换了个后缀叫 1017,官网放出一段演示:你打一句话,它给你建一座能转着看的 3D 故宫,红墙黄瓦都在;你说要个赛车游戏,它当场给你做出来;它甚至把《传送门 2》这个游戏重新做了一遍。
一个后缀版本,架构一点没动。
我当时心里就一句话:这不合理。
二、一个数把我拦住了
干这行久了,我有个职业病:看到厂商的新消息,先默认是刷分。大模型圈子里,厂商自己测自己,想好看点太容易了。
官方给的答案也玄乎,叫 "自反馈强化学习"。翻译成人话:它写完代码,自己跑一遍,跑出毛病自己改,改完再跑,全程没人盯着。像你请了个特别自觉的厨子,菜出锅自己先尝一口,咸了,自己加勺水。
听着挺好,对吧?但这句话是厂商自己说的。
我打开官方那张基准表,想看看它拿什么证明自己。终端操作这项,31.2 涨到 42.3;写程序这项,20.3 涨到 29.1;修代码这项,74.2 涨到 77.0。
全是厂商自己报的数。
看到这,我差点关页面。
有一个数把我拦住了。不是分数,是钱。同一个评测任务,上一版平均花 3 块 3,这一版花 1 块 3,降了六成。
为什么?它把话写短了。大模型按字数收钱,废话少了,账自然小。
能力往上走,价钱往下掉。
你什么时候见过又强又便宜的东西?反正我干了十年,见得不多。
三、又强又便宜,真的有这种好事?
我转头去翻第三方实测。36 氪的编辑真去试了:拿一张剪纸的照片,跟 AI 说 "把它变成海边小镇"。结果它真做出来一个能滚动的 3D 网页,纸的厚度、折痕、投影,一样不少。拖时间滑块,天空、海面、窗户的灯,跟着一起变。
我盯着动图看了好几遍。
V2EX 上有人说得更直白:旧版 "像被降智了一样",换到 1017"恢复正常了",40 分钟让它把一套手机 UI 移植完了。还有个开发者说,以前跟它说话是鸡同鸭讲,现在 "有种自己智商都提高了的错觉"。
到这一步,我基本信了,这版确实不一样。
网上传得最响的说法是 "便宜了 35 倍",听着比谁都香。我顺藤摸瓜去查,最早是个产品经理发的一条推,两小时内的快速测试,没有基准说明。这种证据我见多了,热闹归热闹,不能当数。
可后来,我找到了他完整的测试,叫 Bug Hunt Bench。105 个隐藏 bug,塞在两个真实的生产代码库里,一个近 3 万行,一个 6 万行。测试时彻底断网,连代码的修改记录都清空了 —— 模型没法从历史里偷看答案。最后独立评审拿保密答案盲打分,账单全部公开。
1017 在这个测试里修掉 42.7 个 bug,花了 1.84 美元。
Anthropic 的旗舰 Claude Opus 5.5,修掉 41.7 个,花了 58.53 美元。
一个只多修一个 bug,一个贵了 30 多倍。
看到这组数,我把 "刷分" 两个字从脑子里删了。
四、封神和翻车,可能都是真的
但冷静的那一棒,紧接着就来了。
匈牙利一个独立测试,让 1017 整理产品资料,结果能直接发布的比例只有 21.4%,上一版是 41.1%。它变快了,也更会编了 —— 每次跑,大约 95 条说法找不到出处,上一版是 30 条。
国内程序员那边也有反馈:它 "更聪明但更难驾驭",重构代码的时候,它嫌代码啰嗦,自己把功能组件删了,删之前没问任何人。
那一刻我意识到,我差点又被带跑。
这能力是真的,但它分场景:让它搭房子、做游戏,它行;让它对着资料说实话,它反而退步了。
五、真正变的是什么
把这些摆在一起,我才想明白这次真正变的是什么。
能力确实涨了,涨得还不少。但 "涨多少",得看你拿哪把尺子量。
以前考的是笔试,看你会不会答题;现在考的是干活,看你能不能把项目交付。而且活能不能干成,一半看模型,一半看套在外面的框架 —— 你可以把模型想成发动机,框架就是底盘和变速箱,光有发动机,变速箱不匹配,车也跑不快。
10 月有篇论文,跑了 6200 多条任务轨迹,结论就一句话:同一个模型,换个框架,排名都能反转。
网上为什么吵成一团?说封神的和说翻车的都对,因为他们测的根本不是同一个组合。
官方演示的故宫、传送门 2,是挑出来的样品;真实项目要跟它来回对话几百轮 ——671 轮、804 轮那种 —— 跑着跑着,它可能就自作主张了。
所以 "许愿式编程" 这五个字,一半是真的,一半得打折。
真的一半:门槛确实降了,你说清楚,它就能做出能跑的东西。
打折的一半:这能力挑场景,也挑人 —— 许愿的人得说清自己要什么,还得看得懂交回来的东西。这两件事,模型替不了你。
说到功劳,网上好多人把它记到梁文锋头上,"技术执念,必然优秀" 嘛。我一开始也这么想。
查完资料,我改主意了。V4 的技术报告,270 个人署名,梁文锋在名单里;中国企业家那篇报道写得很直白,他已经建成了 "不依赖单一个人的工程化体系"。
上一版被骂降智的,也是这家公司。
哪有什么必然优秀。产品好坏是多变量的事,训练数据、训练思路、评测口径,哪个环节都可能翻车。这家团队真正值钱的地方,不是 "必然优秀",是不刷榜、死磕效率 —— 这次,他们赌对了 "后训练"(模型练完基本功,再针对干活加练一轮)和成本这两张牌。
六、说回你,先问三件事
说回你。下次再看到哪个 AI 说 "我能做项目",别问它跑分多高,问三件事:
分数谁测的,厂商还是第三方?
涨的是会答题,还是真能交付?
便宜的时候,错了谁来兜底?
这三问,能帮你躲掉大半营销话术。
防归防,试也得敢试。门槛是真降了,试错成本也低。
手头要真有个 "想做个东西但不会编程" 的念头 —— 一个记账的小工具,一张给爸妈的电子相册 —— 现在可以开口了。
AI 的辅助能力,今天又多了一个新权重:以前它帮你查资料、写文案、剪视频,现在它还能把你脑子里的想法,变成屏幕上能跑的东西。你说不明白的,它会追着问你。
对普通人来说,这是我这两年见过最实在的一次进步。
别怕试,试的时候,留个心眼就行。
你上一次被哪个 "AI 神迹" 带跑过?评论区聊聊,我保证不笑你。