ARTICLE · 1238260
DeepEP 源码级拆解,一次讲透
DeepEP 源码级拆解,一次讲透
一条 MoE 的 all-to-all,被 DeepSeek 单独造了个通信库 —— DeepEP。
最近把它的 CUDA kernel、handle 机制、以及 Megatron / SGLang / vLLM 的接入层
一起读了一遍,整理成 18 张图,从「为什么难」到「能抄什么」,一次讲完 👇
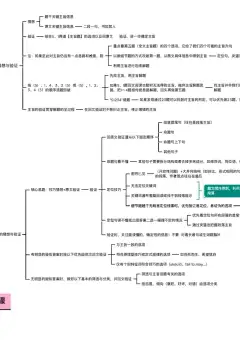
① 它到底解决什么
· 流量被放大 top-k 倍:256 选 8,每条都单发 = hidden×8,按目标机器去重能砍掉一大块
· 机内 NVLink 和机间 RDMA 差一个数量级,必须两条腿同时跑
· decode 每卡每步只有几十~几百 token,一次往返延迟直接吃进 TPOT
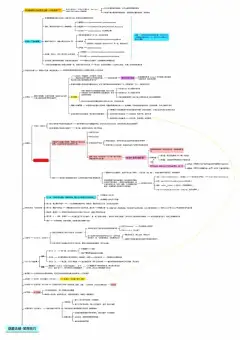
② 四个反直觉的点
· 它不是 all-to-all 的封装,而是把 permute 和通信融进一个 kernel
· 通信分两段:先交换「谁给谁发多少」,再并行搬数据
· 反向不需要新算子:dispatch 的反向就是 combine
· kernel 是 JIT 按参数现编的,batch/容量一变就重编译(性能坑的根源)
③ 训练侧和推理侧不是一回事
· Megatron:六步链路 + 4 个 backend,top-k 概率必须是 fp32
· SGLang:prefill 走 normal、decode 走低延迟,dispatch 拆成 a/b 两段做重叠
· vLLM:三个 backend(HT / LL / v2),HT 和 CUDA graph 天生不合
④ 三条可以直接抄走的经验
· 容量向上取 2 的幂,避免每步重编译把 GPU 饿死
· decode 用 no-sync + psum 判界,别等 CPU
· 空 batch 也要走一次通信,否则对端永远等不到计数
还有个最容易踩的坑:v2.5 把 ElasticBuffer 改名成 EPBuffer,
框架里那些 `from deep_ep import ElasticBuffer` 的路径会直接 ImportError。