ARTICLE · 1238401
我开源了复刻流程,说说逆向软件没人讲的事
10 月中旬,GitHub 上有个开源项目火了,火得有点不讲道理。
它叫 REA,全称 Reverse Engineer Anything,直译过来就是“逆向一切”。10 月 6 日,它的星标还不到 1 万;9 天后突破 25 万;到 10 月 17 日,超过 29 万。科技博主 Matthew Berman 转发相关内容,留下一句话:Software is done——软件完了。
评论区比博主还热闹。有人拿 REA 配上 Claude Code,只看二进制、不看源码,28 分钟复刻出一个 GNOME 计算器;有人嫌一款语音输入工具越来越贵,让 AI 把它逆向了,全程只对 AI 说了两句话,25 分钟;还有中学信息处的老师,每年几次考试都要手动调动几十个铃声、考完再改回来,索性逆向了一套铃声系统的 Web Socket 接口,自己写了个控制面板——输入考试日期、区域和科目,对应区域自动静音。
我盯着这些战绩看了一晚上,心情有点复杂。因为就在这几天,我刚把滴答清单 8.2.40 完整逆向了一遍,又在本地重建了一版,翻车三次,次次和数据丢失有关。
所以这篇不想聊逆向有多爽。想聊的是爆火背后没什么人讲的那件事:复刻。
对于我们搞产品开发的人来说,拆成熟产品不是偷懒,是基本功。
基于一个成熟产品,先理解它有什么功能、这些功能是怎么实现的。站在巨人的肩膀上,我们的产品可以更完善;甚至可以直接在成熟产品上做功能的迭代和优化,把一些功能拼接、组合,长出新的东西。
举个我自己的例子。保险代理人一天要用的东西有多少?
过去这些靠 IT 人员一个个做,做出来也是四座孤岛。换个思路:先把这些流程在一个成熟软件里拆透,看它怎么管任务、怎么管提醒、怎么管数据;然后把它们合到一个工具上,再借 AI 的能力做两件事。客户面谈完了,面谈情况自动撰写成纪要;AI 分析客户的时间、销售拜访和面谈记录,给出本周的活动量管理建议,提一些销售建议和改进的方向。
这样一来,等于有了一个时刻懂我们的私人教练,帮我们总结、帮我们反思,随时随地陪在身边。很大程度上,省掉了手工去统计和汇总的那个过程——而统计和汇总,过去往往是一个团队最耗时、最容易出错的环节。
REA 这类工具真正改变的,是读懂的成本。拆开看,它就是一个 MCP 服务器加一个命令行工具,作者是开发者 morluto,主要用 TypeScript 写,MIT 许可。它把 Ghidra、IDA、Hopper 这些老牌逆向工具接到 Claude Code 这样的 AI 智能体上,过去工程师最痛的一步——读得懂反编译结果——AI 替你干了。
但注意,我说的是“读懂”的成本。
后者没什么人讲的部分,才是我这次翻车换来的。
读懂和复刻,是两回事。
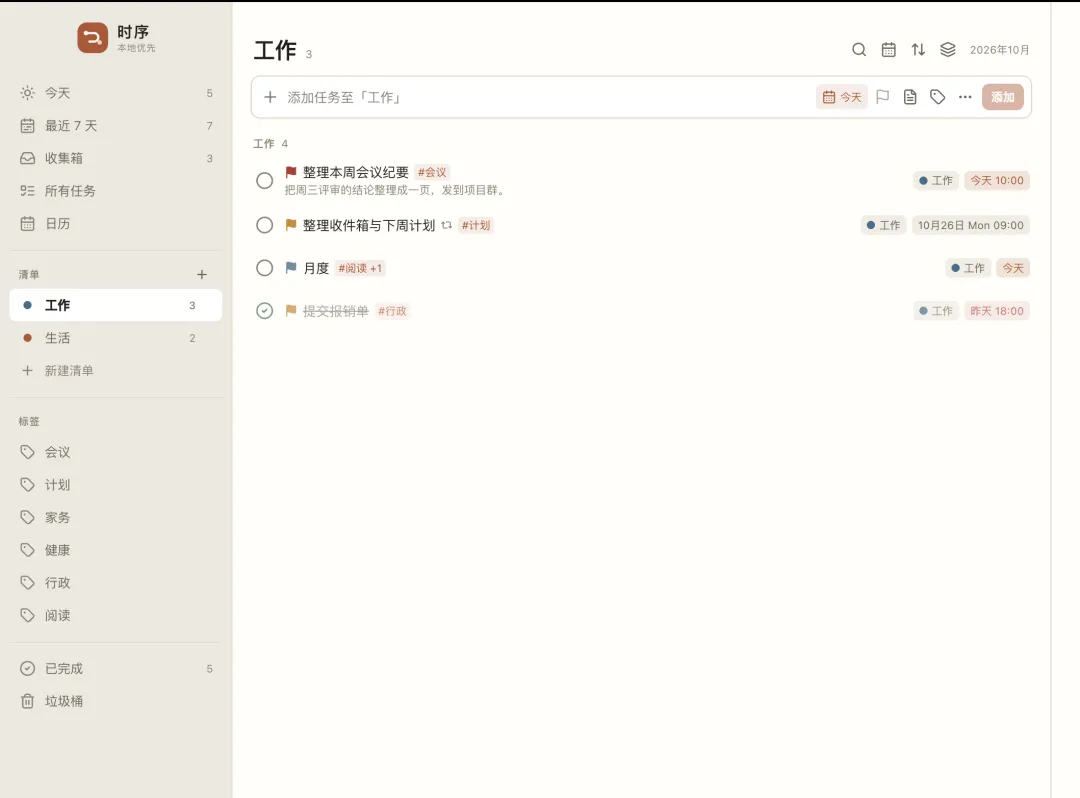
复刻出来的「时序」:清单、标签、日期收进同一个工具
真正做开发的小伙伴就应该清楚:不让 AI 真实地去开发一个软件,你永远不知道坑在哪。我这次全程 AI 参与,问题一个都没少——丢包、功能设计不全、内部逻辑矛盾、数据丢失、前端后端对不上、内部无法联动。
最疼的三个,全部和数据丢失有关。
这三个事故真正值钱的一课,不是它们怎么修的,是它们怎么骗过我们的:事故一和事故二的早期测试,全都是绿的。因为测试里写的是“等一会儿再断言”——等上一小会儿,看起来数据存上了。恰恰是这一小会儿的等待,把竞态伪装成了通过。
测试全绿,用户一用就丢数据。这不是笑话,这是我的真实经历。
还有一类坑,安静得可怕。
691,158 行
反编译还原的 C#
68 张
具名数据表 · 814 个字段
638 个
界面
逐段读下去,我发现 1,163 个方法是空壳,占 1.9%。它们能编译、能跑、不报错,行为静默地错。把还原代码直接当产品代码用,等于给自己埋了上千颗哑弹。
至于“页面做出来 ≠ 功能做出来”,举个小例子。在滴答清单里完成一个任务,不是打个钩就完了:主列表那一行要移进“已完成”分组;侧栏“今天”的角标要重算;侧栏“已完成”加一;日历里这一条变灰;搜索结果要标注它已完成;还有第六条最容易被忘——取消这条任务的待触发提醒。漏了第六条会怎样?用户被一个已完成任务的提醒吵醒,而你的功能“看起来”完全正常。
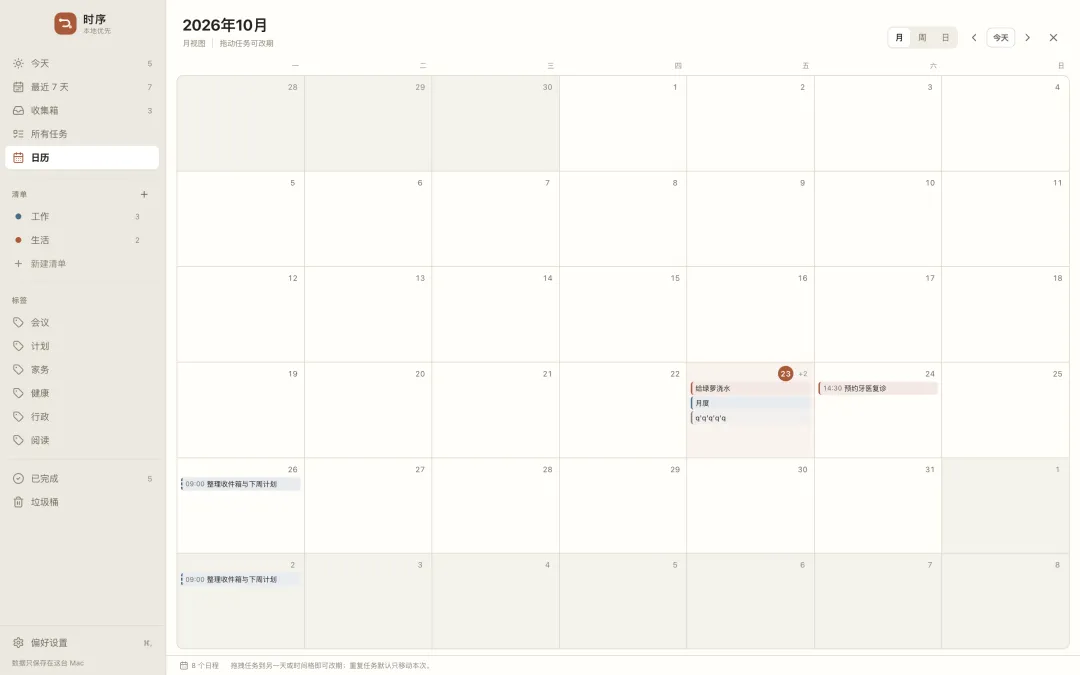
复刻版的日历视图:任务落在日期上,六个面要同时刷新
这六个面——主列表、侧栏角标、详情面板、日历视图、搜索结果、提醒调度——就是复刻里最没人讲、又最要命的东西:联动。
在成熟产品上反思、拆解,需要方法和技巧。我把自己这一路的翻车捋了一遍,也找到了网络上的成熟方法论——GitHub 上的 replica-skill(github.com/Jakeschincariol/replica-skill),MIT 许可,十一个 Claude 技能,从 recon(取证)一路管到品牌和部署,讲的正是“复刻任何应用”这件事。我把它当底座,按自己的实战加了门禁、角色和红线,整理成一套体系开源出来(github.com/EvolutionWayen/replica-Wayen):12 个阶段、12 道门、20 条红线、20 条失效模式,配可执行的门禁脚本和两百多项自测。所有规则都从实战里长出来,没有一条是设想。
细节不透,不进开发。
刚开始就要做细节级的拆解,而不是粗略地把功能罗列一遍。什么叫细节级?功能的状态、数据的联动、输入和点击的条件、点击完之后系统的反应——这些都要讲清楚。举三个产物。
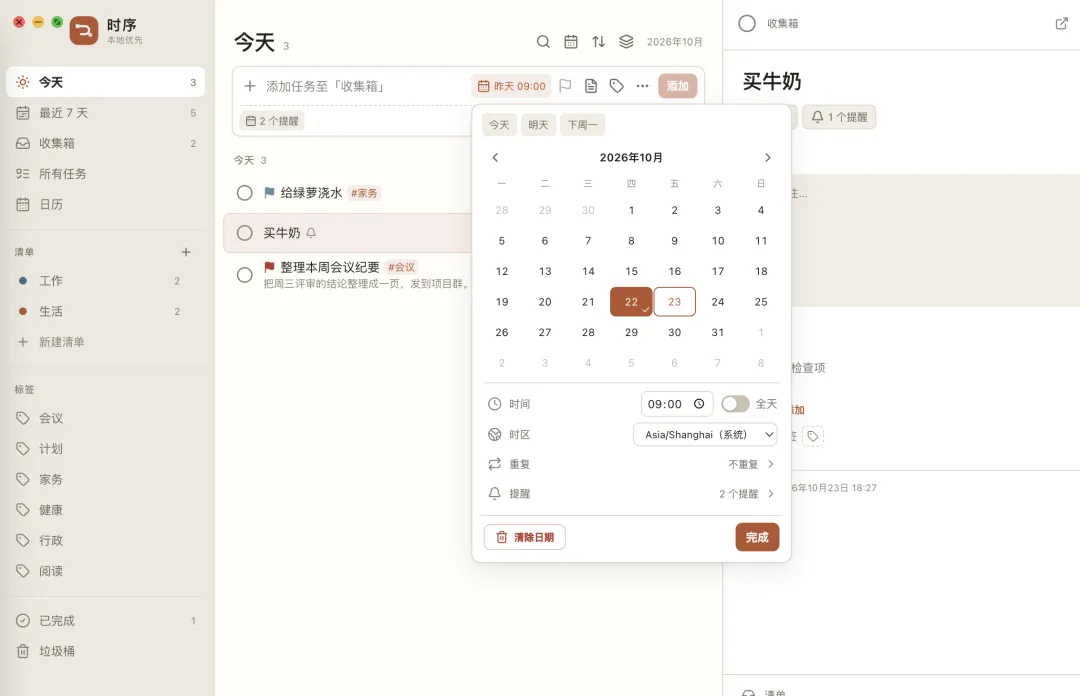
一个日期选择器就有多少状态:时间、时区、重复、提醒,这就是细节级
这三个产物粗看都是文档工作,但它们是唯一能让 AI 批量开发不跑偏的东西。AI 举证,你拍板——AI 负责拆透、给证据、暴露未知、提方案;你负责校正行为理解和体验取舍。未确认的蓝图,不得批量开发;确认之后冻结,改要先算影响面。
这条铁律是被打出来的。我最初让 AI 照着反编译结果直接写实现,1,163 个空壳方法就是这么静默溜进设计的。后来立了规矩:反编译还原的代码只当规格书读,不编入产品;数据表结构可以照搬语义,代码必须自己重写。
整个流程十二个阶段,一句话版本:
S0 立项:为谁解决什么,不做清单至少五条;S1 取证:把目标拆成地图;S2 行为蓝图:每个功能一份契约,最耗时也最值钱;S3 审查冻结:你逐条确认,哈希冻结,之后才允许写代码;S4 架构;S5 设计系统;S6 逐屏重建;S7 后端,真文件持久化;S8 测试;S9 一致性评分,功能分加界面分,实算不手填;S10 痛点:原版被骂最多的点,就是你的卖点;S11 发布。
其中 S2、S3、S6、S7 不能跳、不能压缩。
注意事项三条。第一,门禁有四态:通过、不通过、阻塞、不适用。阻塞是环境问题,不是通过;不适用必须带理由。不许假绿。第二,角色分开:产品官、总控、蓝图工、重建工、验证官,谁都不能既当运动员又当裁判;AI 说“完成了”不算汇报,带路径、带命令、带数字的才算。第三,测试全量连跑至少三遍才可信——单次绿不可信,这是我们用三次丢数据换来的。
CAUTION · 合规边界
基于商业和知识产权的考虑,我们做的是复现功能,不是复制资产:复现这个功能,而且让功能之间去联动起来,并且真实有效——这是我们首先要达成的目的。反编译还原的代码只当规格书读;数据库默认操作副本;这套体系默认只做本地自用和个人研究;哪天真要对外卖,再走商业分支:商标域名核查、视觉文案命名全面切割、素材来源台账,一个都跑不掉。
网址附上:https://github.com/EvolutionWayen/replica-Wayen.git
REA 把“读懂一个软件”变得便宜,这是好事,“软件已死”倒不至于——至少复刻的难度一点没降。
它从来不是技术问题,是纪律问题。
也别想着完美复刻。诚实的交付是范围加分数:做到了什么程度,还差在哪,白纸黑字算出来。
如果你手上也有一个“给我重做一遍”的软件,打开 github.com/EvolutionWayen/replica-Wayen,从 stages 里的 S1 取证开始,先拆出它的功能清单。这一步不用写一行代码,但足够你知道,复刻和逆向之间隔着多远。
我是智能进化Wayen。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发,我们下篇见。