ARTICLE · 1239340
AI 用 CAD 的瓶颈,不在生成
这两周,不少人在转 HuggingFace 上一个叫 cad-1000-hours 的数据集:509 个任务、1000 多小时、207 GB,全是真人在 Windows 上操作 CAD 软件的录屏。
很多讨论都集中在一个问题上:有了这批数据,能不能训练出更会操作 CAD 的 AI?
我把 509 个任务的元数据逐个拆了一遍,也翻了任务说明、验收条款和部分交付文件。看完之后,我更关心的反而是另一个问题:假设 AI 已经能画出一张图,我们怎么知道它真的画对了?又怎么让这张图进入企业原来的工作流程?
这两个问题,可能比继续提高生成能力更接近产品落地。
一、先定义什么叫“画对了”
这份数据集中,有两个数字值得产品经理多看一眼。
509 个任务,验收条款平均每题 7.2 条,中位数是 8 条。也就是说,每个任务通常不只是要求画出一个结果,还附带一组需要逐项检查的要求。
例如,某个任务会规定不同房间的具体尺寸。图纸看起来像那么回事,并不代表尺寸就正确;尺寸正确,也不意味着标注、图层和交付文件都符合要求。
我继续往下看,发现另一个细节:509 个任务中,有 309 个带有结构化的 dimensions 字段,共包含 2,675 条尺寸记录。这 309 个任务全部属于 AutoCAD,占全部 312 个 AutoCAD 任务的大多数。其他软件对应的任务,没有这个结构化字段。
这个发现让我意识到,评价 AI 画图的难点,可能不只在于模型能不能生成几何图形,还在于我们有没有把“正确”拆成机器可以检查的条件。
对工程设计来说,一张图纸的验收标准可能包括几何尺寸、构件位置、标注内容、图层归属、文件格式,以及是否满足项目既有的制图规范。不同要求的检查方式也不一样:有些可以通过程序直接核对,有些需要结合视觉判断,还有些必须由专业人员确认。
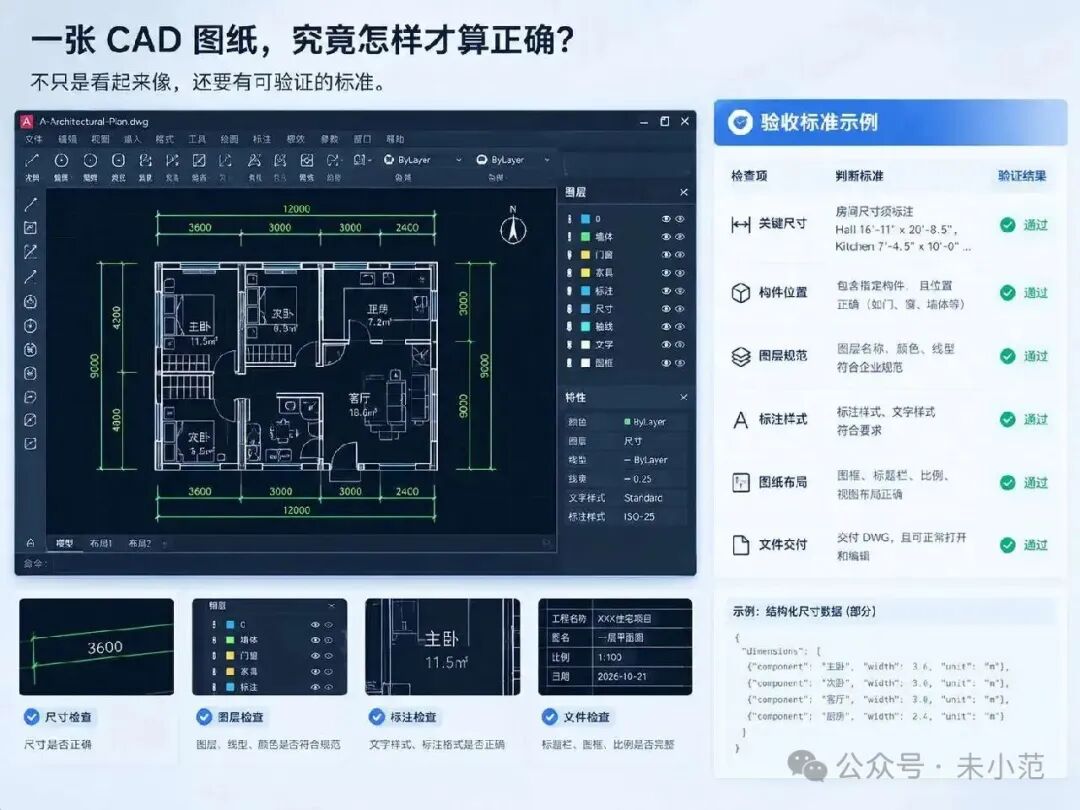
这里要注意,数据里存在结构化尺寸,并不意味着所有 CAD 任务都已经可以自动判分。但它至少提供了一个值得继续验证的方向:把原本依赖工程师经验的验收要求,逐步拆成可以执行的检查项。
我的判断是,AI+CAD 要进入工程交付,必须先回答“什么叫完成”,再讨论“怎样生成得更快”。
否则,模型生成得越快,人工检查和返工的压力也可能越大。
二、比最终结果更值得研究的,是任务怎么完成
这份数据集总计约 1018 小时。单看录屏,确实很容易把它理解成一批用于训练电脑操作智能体的视频素材。
但我觉得,更有研究价值的是视频之外的东西。
每个任务除了录屏,还有逐帧交互事件、任务过程的文字描述,以及部分任务附带的命令日志和可执行脚本。抽样查看的 narration.json 中,文字标注会记录某个时间段执行了什么操作、目的是什么、使用哪个软件,平均每段约 12 秒。
这相当于从不同角度记录了同一件事:人做了什么操作,当时想完成什么,以及最终交付了什么。
更有意思的是 output_files/ 目录。
我在其中统计到 141 个带命令日志的任务,还有 21 个带可执行脚本的任务。其中 20 个是 Siemens NX 的 journal 文件,另一个是 CATIA 脚本。
抽查的一份 NX journal 有 5,764 行,包含 697 处建模调用。从建立基准面、绘制草图,到拉伸、开孔、倒角,都能在脚本中找到对应步骤。
录屏可以让我们观察人的鼠标和键盘操作,命令日志与脚本则进一步揭示了软件内部执行任务的方式。它们不能直接代表所有人的最佳操作路径,却能给智能体研究提供另一种材料:除了模仿人怎么操作,还可以研究任务如何分解、哪些步骤能够重复执行,以及结果怎样验证。
这也是我看技术仓库时比较在意的一点:数据能不能帮助我们理解任务的完整过程,而不只是让模型看过更多例子?
对于产品经理来说,这个区别很实际。用户提出需求、系统理解任务、调用工具执行、检查结果、处理异常,最后交付文件,这是一个完整的产品过程。只研究其中的生成环节,很容易忽略真正影响用户体验的其他部分。
三、工程企业需要的,可能不是一张从零生成的新图
看完数据,我开始思考一个更偏产品的问题:如果现在要做 AI+CAD,应该从哪个环节切入?
从技术方向看,至少可以分成三类。
第一类是从自然语言直接生成几何模型或图纸。 它的想象空间很大,但如果要用于工程交付,还要解决尺寸准确性、结构可编辑性、制图规范和验收等问题。
第二类是让 AI 像人一样操作 CAD 软件,通过鼠标、键盘和命令完成任务。 这条路与现有软件的交互方式更接近,但操作过程中的定位、状态识别和异常恢复都需要处理。
第三类是把模型的理解能力与软件命令、脚本或 API 结合起来:模型负责理解需求、拆解任务和选择操作,确定性的工具负责执行,系统再通过规则检查或视觉判断验证结果。
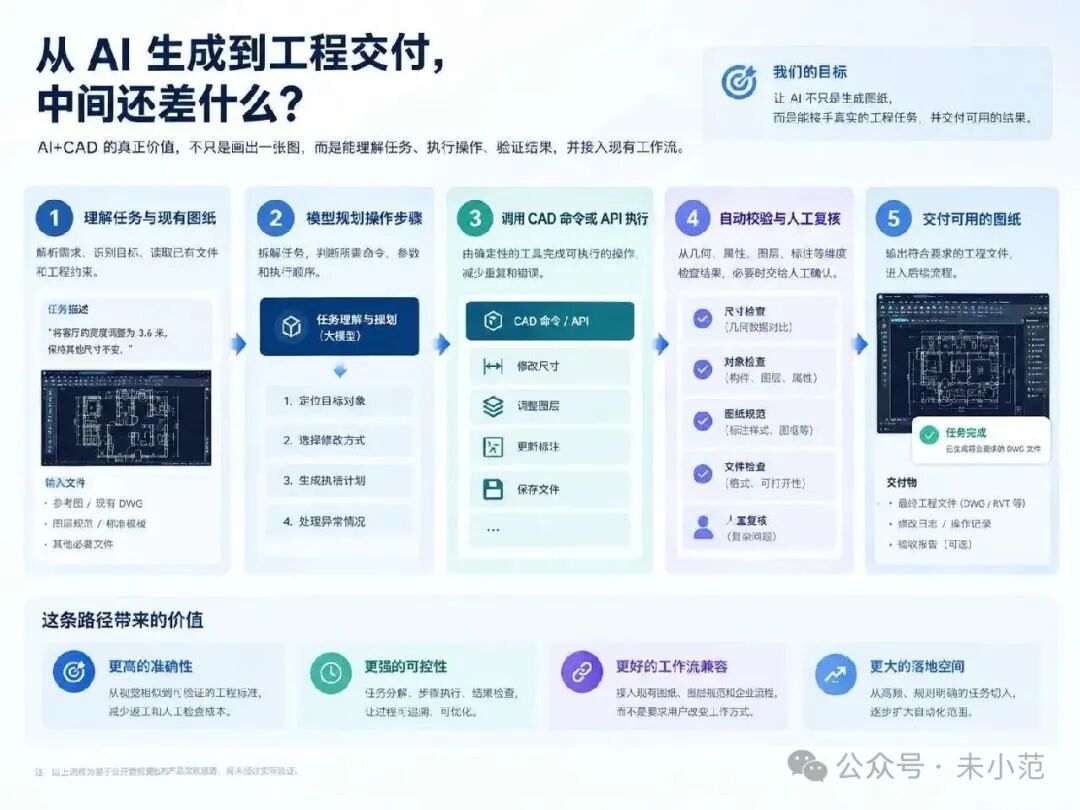
第三类是我更想优先验证的方向。 不过,这只是基于现有材料形成的产品假设,还不能据此断言哪条路线一定最先成功。
原因在于工程企业的实际工作方式。
一张图纸往往已经存在于某个项目里,带着既有图层、字体、图框、标题栏、标注规则和历史修改记录。用户真正需要的,可能是把一处尺寸改对、批量调整一组构件、补全标注,或者根据已有图纸完成下一步工作。
如果 AI 重新生成一张外观相似的图,用户还得把它放回原来的文件体系,核对差异,处理图层和标注,再走校审流程。生成结果看起来不错,不等于它减少了工作量。
这份数据也提供了一个值得关注的背景:按任务时长统计,AutoCAD 约占整个数据集的 66.3%;按任务数量统计,509 个任务中有 312 个来自 AutoCAD。
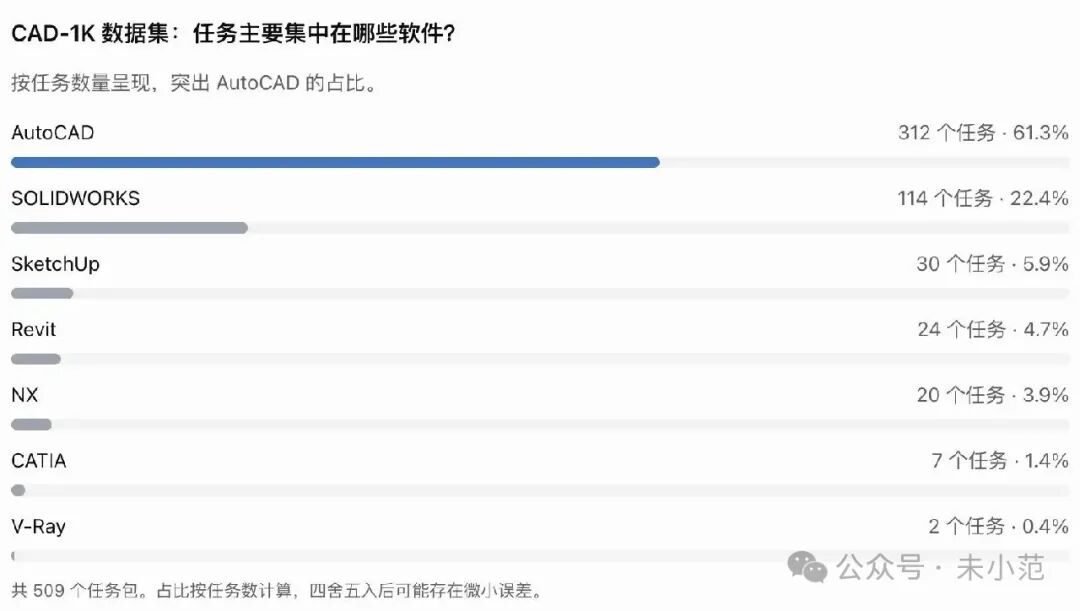
当然,这只能说明这份数据集的构成,不能直接证明中国工程企业的需求分布。但对产品设计有一个启发:当用户已经在某款软件里积累了大量图纸、模板和工作习惯时,AI 产品需要认真考虑如何接入这些存量资产。
一条产品判断:与其只追求“让 AI 画出一张新图”,不如优先验证“让 AI 接手一张已有的图,完成一个明确、可检查的修改任务”。
后者的任务边界更清楚,也更容易设计验收条件。它未必更容易实现,但至少可以通过具体场景验证:有没有减少操作步骤,是否保留原有文件结构,修改结果能否通过检查,人工复核时间有没有下降。
这些指标比一段流畅的演示视频更接近产品价值。
四、产品落地不能只靠模型“看起来会了”
如果把上面的判断再往前推一步,我会倾向于先做一个边界明确的任务,而不是一开始就追求全自动设计。
例如,在已有平面图中修改一个房间的宽度。
系统先识别目标对象和相关约束,再通过 CAD 命令或 API 执行修改,随后检查尺寸是否达到目标、相邻构件有没有受到意外影响,最后把需要人工确认的部分交给设计人员。
这条流程里,模型负责理解和决策,软件工具负责执行,验证机制负责判断结果是否符合要求。三者各自承担不同职责。
当然,这种混合架构也需要验证。命令或 API 并不天然可靠,模型也可能识别错对象,规则检查更不可能覆盖所有设计要求。实际产品需要比较不同方案的准确率、稳定性、开发成本和维护成本,再决定哪些环节适合自动化。
我认为产品经理在这里的作用,是把一个看起来很大的技术问题拆成可验证的小问题:先选择高频、规则相对明确、失败后容易发现的任务,再通过真实用户和真实图纸测试它是否值得做。
这也是我研究这份数据集时最大的收获。它让我开始从“模型能不能画出来”转向“任务能不能被定义、执行、验证和交付”。
五、还有两个边界,不能忽略
先说评测。
这 509 个任务的参考答案和验收信息已经公开,因此更适合用于开发过程中的测试和回归,不能直接把它当成独立盲测集,再用结果证明模型具备了普遍能力。
同一团队另有一个 AutoCAD Bench 评测项目,使用单独的 50 个任务,并结合确定性检查与视觉判分。研究时需要区分公开任务数据和独立评测,不能把两者混为一谈。
再说授权。
我查看的 cad-1000-hours 仓库没有明确的 License 声明。即使同一团队的其他数据集使用了 CC-BY-4.0,也不能据此推断这份数据具有相同授权。用于商业产品或对外发布之前,应先向发布方确认使用权限。
对产品经理而言,技术上能下载、能训练、能跑通,只是开始。数据能否合法使用、效果能否独立验证、结果能否进入真实工作流,同样决定了一个方案能走多远。
最后,说说我的判断
这次拆解让我更明确了三件事。
第一,评价 AI+CAD,不能只看生成结果像不像,还要定义清楚什么叫完成,并把能自动检查的条件尽量落下来。
第二,研究智能体不能只看最终文件。任务理解、操作过程、异常处理和结果验证,都可能影响它能不能稳定工作。
第三,对于工程企业,值得优先验证的产品机会,可能在于接手已有图纸、完成明确任务,并把可编辑、可检查的结果交还给用户。
我还不能仅凭一个数据集就断言哪条技术路线会胜出,但至少知道下一步应该验证什么:选一个真实、高频的 CAD 修改任务,比较模型直接生成、GUI 操作和命令/API 混合方案,再看准确性、返工成本和人工复核时间。
这比单纯追问“模型还能不能画得更好”更接近产品经理应该解决的问题。
如果你也在研究 AI+CAD,你目前卡在生成、操作、验收,还是接入现有工作流?欢迎在评论区聊聊你的实际情况。
如果觉得这篇文章有启发,欢迎点个在看,也转给正在做工程数字化或 AI 应用的朋友。
想继续交流工程行业的 AI 实践,可以添加微信 ffkkqdd 进入读者群;这次整理的任务索引与相关资料,也会放在知识星球「AI 工程实践局」。