ARTICLE · 1239800
英伟达抛出 14 天算力方案,国产 AI 杀出一条新赛道
英伟达抛出 14 天算力方案,国产 AI 杀出一条新赛道
最近一连串产业新闻放在一起对照,一条全新的赛道轮廓正在浮现。 10 月 21 日英伟达在 GTC 柏林发布 DSX POD 模块化 AI 工厂方案,整套算力集群、供电、高速网络、液冷系统提前在工厂完成集成封装,以集装箱形态交付。只要场地水电网络等基础条件就绪,原本长达 6 个月的现场部署周期,最快压缩至 14 天投产。 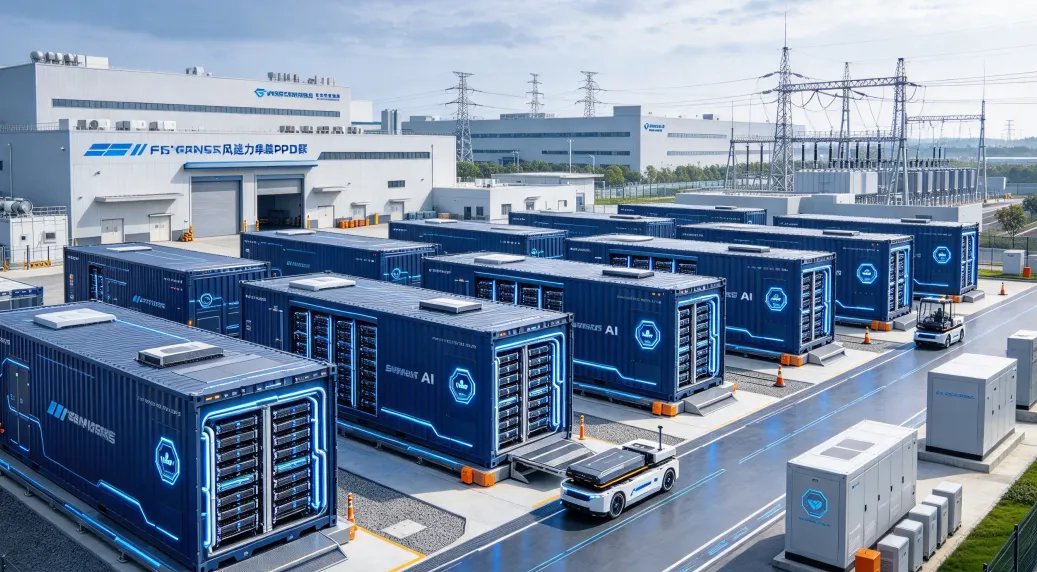
依靠 GPU 与 CUDA 生态,英伟达已经拿下全球算力市场的主导地位。而这一次,它的野心早已不止芯片售卖,而是把竞争力向上延伸,覆盖整套算力系统交付、集群落地全流程。 几乎同一时间,国内产业链同步传出密集进展:中兴推出新一代模块化智算基础设施,华为发布 3D 数据中心架构,国产 1024 卡液冷超节点顺利点亮;三星、SK 海力士同步推进国内 NAND 闪存工厂技术升级。 这些看似独立的消息,共同指向一个核心变化:AI 竞争,不再只是比拼谁拥有性能更强、数量更多的芯片。下一阶段的决胜点,是谁能够把算力更快、更稳定、更低成本转化为真实生产力。 当产业重心转向算力交付效率,中国长期沉淀的制造、通信、电力、工程建设能力,迎来全新的释放窗口。 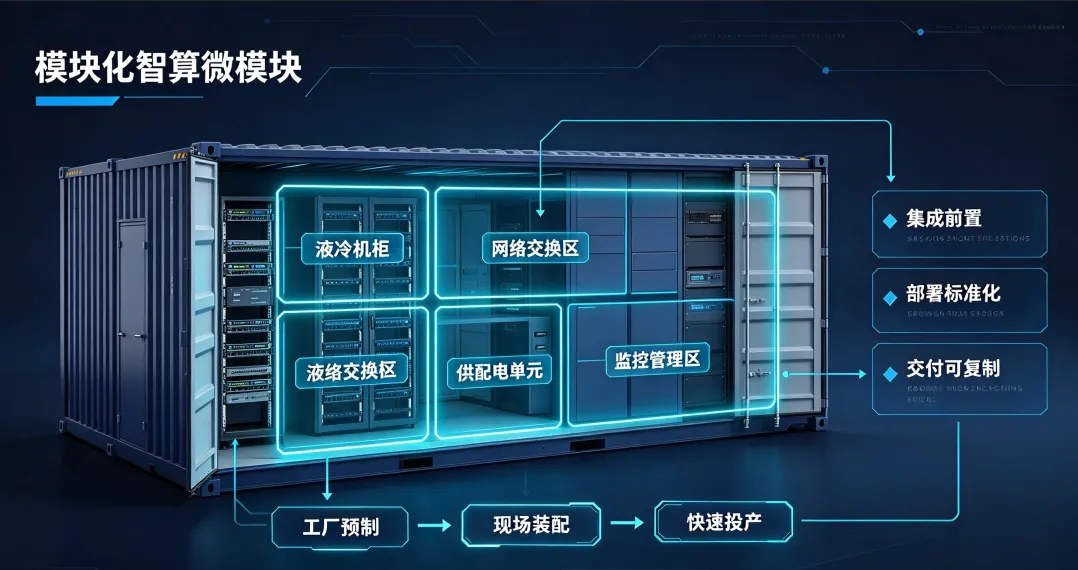
过去很长一段时间,行业衡量 AI 实力最简单的标尺,就是 GPU 数量。谁家采购的卡更多、集群规模更大,就代表投入力度更强。 但很多人忽略一个关键事实:买到 GPU,不等于算力立刻可用。 一座 AI 数据中心从硬件到货到正式投产,中间有大量复杂工程环节。高密度服务器需要稳定供电,液冷系统承接巨大热负荷,高速网络完成跨设备互联,整套集群还要经过多轮调试、压力测试、故障验证。任意一环拖慢进度,价值不菲的算力硬件只能闲置,持续产生巨额沉没成本。 DSX POD,就是英伟达给出的解法。把大量原本需要在机房现场完成的集成调试工作前置到工厂,设备出厂前完成联调与验证,运抵现场后仅需对接基础配套,大幅降低现场施工的不确定性。 当然,模块化数据中心并非英伟达首创。DSX POD 现阶段是围绕 Vera Rubin 计算平台打造的参考架构,合作厂商预计 2027 年初启动规模化供货。14 天投产,建立在外部基建全部就绪的前提之上,不等于从零新建数据中心只需要两周。 但这些细节,并不掩盖这次发布的产业信号。 在此之前,英伟达的护城河是 GPU 硬件和 CUDA 软件生态,客户拿到芯片之后,系统集成、集群搭建、运维落地都需要自行解决。现在英伟达主动向前延伸链条,目标是缩短硬件到货到算力可用的间隔。 背后商业逻辑十分清晰:AI 工厂投资体量巨大,算力集群闲置一天,就是潜在收益的流失。随着单座算力基建投入持续走高,部署效率、运行能效、全周期成本,权重正在快速抬升。 英伟达不再仅仅满足于卖出更强的芯片,它开始关心这些芯片什么时候真正跑起来。 这一点,远比 14 天这个抓人眼球的宣传数字,更值得产业深度研究。 顺着这条产业脉络不难发现:当 AI 基建走向模块化、标准化、快速交付,过去热度远不如芯片的制造工程能力,正在成为新的护城河。 就在英伟达发布 DSX POD 前一日,中兴通讯推出 ZXEDC M8000 智算微模块方案,将液冷机柜、网络、供配电、监控一体化集成,专门面向高密度 AI 算力场景。 这类产品很难像新款 GPU 一样引爆舆论,但直击行业最痛的落地难题。传统模式下,机柜、电源、散热、网络分头采购、分头施工、多方对接调试。模块化方案把绝大多数集成工作前置工厂,智算中心建设,从定制化现场工程,转向标准化产品交付。 更关键的是,这套方案早已走出发布会,落地真实商业项目。中兴官方披露,2025 年拿下国内头部互联网企业长三角算力中心 666 套 IT 模块订单,其中 345 套 M8000 IT POD 已经完成交付,从下单到设备抵达现场,周期约一个月。 这里需要厘清边界:一个月是设备交货周期,不等于整体投产周期,不能直接和英伟达 14 天的现场部署指标对标。 
但这个案例足以证明,模块化智算方案在国内已经跑通商业化交付。产业竞争的本质,从来不是谁的概念讲得更漂亮,而是能不能把复杂的算力系统,做成稳定、可复制、可大规模交付的标准化产品。 华为在 9 月发布的 3D 数据中心架构,则走出另一条差异化路线。通过供冷、IT 设备、供电备电立体分层布局,适配超高密度算力,依托工厂预制、现场装配的思路,持续提升建设效率。 中兴、华为、英伟达三者的技术路线、适用场景各不相同,不存在简单的孰优孰劣。但它们都在回答同一个时代命题:算力芯片密度越来越高、造价越来越昂贵,如何高效搭建、稳定运行大型算力底座? 这里正在发生一场认知转向。 过往讨论国产 AI,舆论焦点永远集中在大模型榜单、单卡芯片跑分。但当 AI 进入规模化商用阶段,供电、散热、高速互联、工程交付、运维保障的长期价值,正在被行业重新评估。 而这些赛道,恰好是中国制造业长期积累的优势领域。 我们拥有完整的通信设备产业、成熟的供配电与液冷产业链、海量数据中心建设运维经验。当算力基建从定制工程转向标准化产品,这些分散能力,就有机会重新组合,形成独有的差异化竞争力。 这不代表国产方案已经全面领先海外巨头,但至少说明:英伟达掀起的这一轮产业变革,不只是放大它自身的优势,也给国内厂商开辟了全新的竞争空间。 10 月 15 日,首套 1024 卡昇腾 Atlas 950 SuperPoD 液冷超节点顺利点亮,同步适配阶跃星辰 Step 5 Preview 模型;沐曦、壁仞、摩尔线程等国产算力平台,也官宣同步支持该模型。 很多报道的重心放在 “1024 卡” 这个规模数字上。但这件事真正的看点,不在于集群规模,而是国产算力正在攻克一个硬核难题:如何让大量芯片不只是物理堆叠在一起,而是实现高效协同计算。 
大模型训练,尤其是 MoE 架构,对芯片间互联带宽、延迟有着极高要求。就算堆再多 NPU,如果互联效率不足,大量算力会卡在数据等待传输上,理论性能根本无法释放。 昇腾超节点依托自研高速互联架构,把上千张 NPU 整合为一个紧密协同的计算系统,同时搭配液冷与系统级设计,解决高密度部署带来的散热难题。 英伟达做模块化集群,主攻部署效率;国产超节点,主攻大规模芯片协同计算效率。二者处在算力产业链的不同环节,互为补充。 当然,硬件点亮不等于经过长期业务稳定验证。超节点的实际吞吐能力、稳定性、综合使用成本,还需要大量真实业务负载持续检验。 但行业风向的变化已经肉眼可见:讨论国产算力的标尺正在升级。大家不再只盯着单卡跑分,高速互联、内存体系、液冷方案、调度软件,被打包纳入整套系统评估。 多家国产算力平台同步适配新模型,同样是关键信号。硬件性能再强,如果模型适配滞后,生态终究是空中楼阁。模型和硬件之间快速打通适配链路,是国产算力生态补齐短板的必经之路。 把几件事串联起来:超节点主攻计算协同效率,模块化 POD 主攻建设交付效率,模型适配打通上层应用。它们暂时还没有形成一套完全成熟、统一的终局方案,却共同搭建起国产算力底座的一块块拼图。 中国 AI 真正值得期待的,未必只有下一颗性能追平海外的芯片。更值得期待的,是这些分散能力能不能打通、串联,形成闭环。 同期还有一条容易被算力热点掩盖的新闻:路透社报道,三星、SK 海力士正在推进国内 NAND 闪存工厂技术升级。三星西安工厂升级更高层数 NAND 工艺,SK 海力士大连工厂同步迭代产线。两家企业确认升级计划,同时明确,本次升级不是扩建产能、新建厂房。 在先进半导体设备管制的大背景下,这件事格外值得玩味。相关升级依旧受出口许可约束,不能简单解读为无限制技术下放。 比起纠结外资企业的布局动机,更本质的问题是:成熟半导体工厂的核心价值到底是什么? 一座存储工厂、晶圆厂,价值从来不止设备和厂房。背后沉淀的工艺 know-how、熟练工程师团队、生产管控体系、上下游供应链协同能力,是重金也很难短期复制的资产。 对于三星、SK 海力士而言,国内产线是全球制造版图里稳定的一环,持续迭代产线竞争力,是企业正常经营选择。与此同时,本土存储产业也在稳步成长。Omdia 数据显示,2026 年第二季度,长江存储在国内 NAND 市场份额达到 38.5%。 我们不必简单把这件事定义成外资与本土厂商的对抗博弈。当下国内存储产业格局,是海外大厂成熟产线持续迭代,本土厂商持续突破创新,二者共存发展。 NAND 闪存不是训练大模型必备的 HBM,却是 AI 数据中心 SSD 存储的根基。算力集群持续扩容,计算之外的存储、网络、基础设施,同样需要同步升级。 它和 DSX POD 没有直接配套关系,但给我们一个重要提醒:算力硬件可以快速迭代,托举整个产业的工业制造体系,需要数十年持续积累。这种体系能力,本身就是核心竞争力。 对于中国而言,这可能是比单纯讨论某一项技术领先或落后,更值得长期关注的产业价值。 很长一段时间,讨论国产 AI,大家第一反应就是:国产芯片什么时候追上英伟达? 这个问题当然重要。先进制程、芯片架构、软件生态上的差距客观存在,不会因为制造业基础自动抹平。核心芯片自主突破,依旧是绕不开的长期主线。 看完近期一系列产业动态,一个新的思路慢慢清晰:AI 下半场的竞争,赛道已经变宽了。 当全球 AI 比拼的重心,从 “谁卡更多” 转向 “谁能更快把算力变成稳定生产力”,中国手里的牌就不止芯片一张。 这场持久战,需要芯片、模型,同样需要供应链组织能力、大规模工程落地能力、软硬件适配能力、长期稳定运维能力。而这些领域,国内已经积累了大量实战经验。 
当然,潜力不等于胜势。分散的各项能力,能不能整合为一套可靠、低成本、可规模化复制的完整方案,还需要大量项目持续验证。 英伟达这次的新动作,拓宽了全球 AI 产业的竞争边界。国内算力基建、超节点、存储产业链的接连突破也在证明:中国 AI 的发展路径,未必只能复刻海外巨头走过的老路。 芯片和模型依然是主战场。但长远来看,谁能把前沿技术落地为好用、可控、成本可控的算力底座,才是决定未来格局的关键。
一、英伟达为什么开始操心数据中心怎么建了?
二、中国企业的机会,恰恰藏在这些不起眼的环节里
三、1024 卡超节点,真正值得关注的不是 1024 这个数字
四、三星和海力士的中国工厂,提醒我们别忽略制造体系
五、下一阶段,中国有机会用自己的方式参与竞争