ARTICLE · 1245235
索尼AI狂飙150万条假说!湿实验证实两大未知衰老机制,看穿人类漏掉的基因密码
作者知遥
编辑知遥
生物医学界有一座永远搬不完的愚公之山。
每年,全球新增的生物医学论文超过100万篇。哪怕一个顶尖科学家不吃不喝,一辈子也读不完自己细分领域的文献。人类的大脑带宽,早已在信息洪流前彻底过载。
但如果把这几百万篇论文,喂给一台能够感知时间流逝的机器呢?
近日,索尼AI(Sony AI)的一项最新研究在海外科技圈引发震动。索尼AI科学发现团队联合冲绳科学技术大学院大学(OIST)、系统生物学研究所等24位学者,抛出了一篇长达66页的重磅论文,正式公开了名为 Hakken(取自日语“发现”)的知识预测系统。
当研究人员把Hakken的准星对准“人类衰老遗传学”时,这台机器一口气吐出了 1543297条 高置信度的全新科学假说。
这还没完,他们没有停留在电脑屏幕上。研究团队挑出假说送进真实的生物湿实验室(Wet-lab)进行细胞级实测,竟然当场证实了两条此前人类文献从未记载过的基因相互作用!
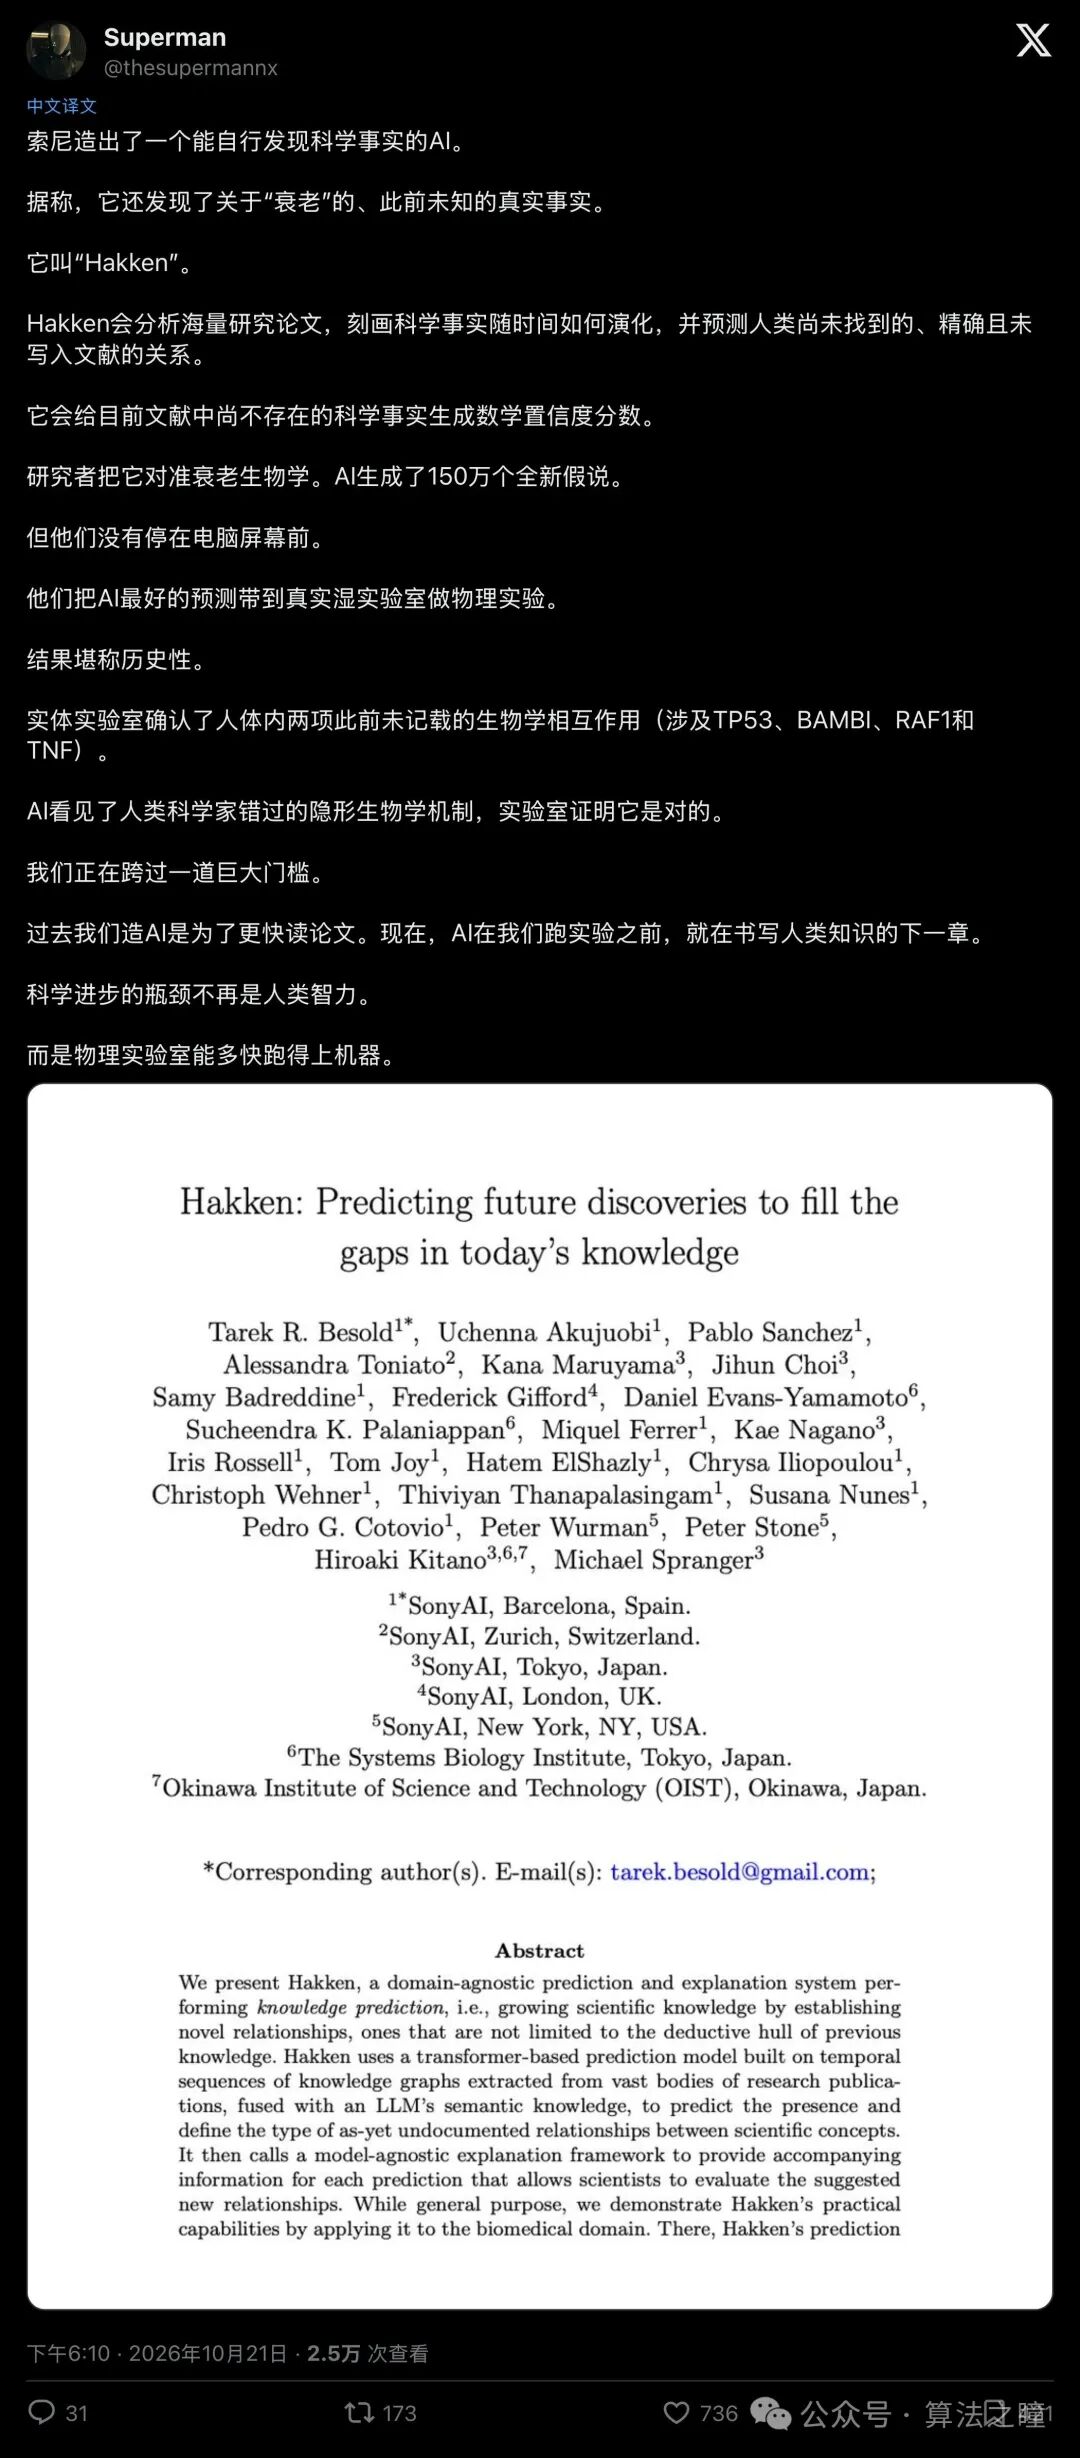
▲ 社交平台上引发热议的英文长帖,惊呼“科学进步的瓶颈已从人类智力转向实验室吞吐速度”
有人高呼“AI正在替人类书写下一章科学史”,也有人冷笑“这不过是用150万次盲猜撞大运”,甚至有网友毒舌吐槽:“照这么算,我也能把家里的烤面包机列为论文共同作者。”
剥开社交网络的喧嚣与口号,这台只用了约16张H100显卡、挂载着70亿参数小模型的系统,究竟是怎么在浩如烟海的故纸堆里,揪出人类科学家漏掉的基因暗线的?
我们需要像拆解一台精密钟表一样,拆开Hakken的四个核心机制。
01拆解一:湿实验室里的“基因盲盒”,到底拆出了什么?
在看懂机器怎么算之前,先看它算出了什么。
要把这次湿实验的结果听明白,不需要生物学博士学位,只需要认识四个在人体细胞里赫赫有名的“角色”:
- TP53
:著名的“基因组守护者”,人体的抗癌总司令。一旦DNA受损,它就负责叫停细胞分裂甚至启动细胞自杀,绝大多数人类癌症都伴随着它的突变。 - BAMBI
:细胞表面的一种“伪装受体”。它像一块刹车片,专门负向调节TGF-β信号通路,而这条通路在人体里是个双面派,有时抑癌,有时又会促成器官纤维化或癌细胞转移。 - RAF1
:细胞增殖与存活通道上的核心开关,也是靶向抗癌药长期紧盯的猎物。 - TNF
:肿瘤坏死因子,人体免疫与炎症反应拉响的“核心警报器”。
过去几十年,关于这四个基因的论文汗牛充栋。但从未有人把TP53和BAMBI、或者RAF1和TNF以特定调控关系直接画上等号。
Hakken在扫描了截至2020年的历史文献演进轨迹后,给出了高分预测。经过算法过滤与人类生物学家按“新颖性、机制合理性与可实验性”精挑细选,三条候选假说被送往独立的外部合同研究组织(CRO)进行真刀真枪的细胞实验:
- 第一盲盒(置信度0.85):TP53会影响BAMBI的表达。
实验室诱导P53蛋白上升后,BAMBI的表达量随之持续飙升,且两者的峰值时间严丝合缝。验证成功! - 第二盲盒(置信度0.83):RAF1会降低TNF的表达。
实验室用抑制剂把RAF1按住后,细胞内的TNF信使RNA水平立刻一致升高。换言之,平时正是RAF1在死死压住炎症警报。验证成功! - 第三盲盒(置信度0.84):SOAT1会影响STAT3的转录活性。
在肝癌细胞系中进行刺激测试后,目标蛋白毫无波澜。验证失败。
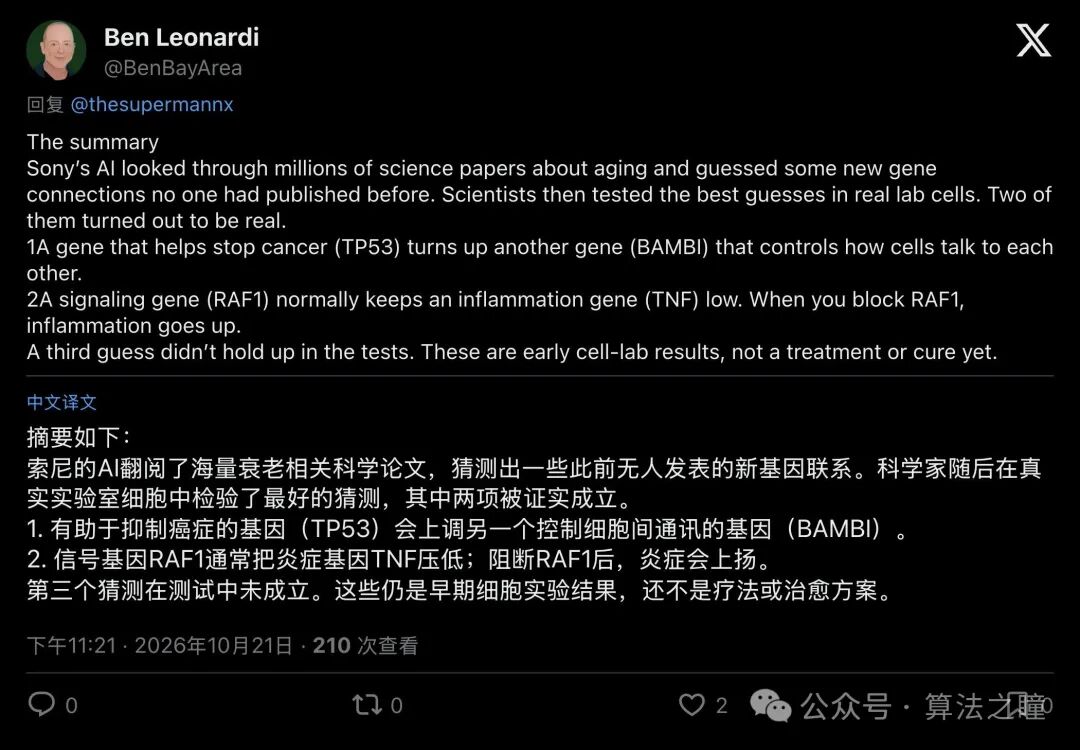
▲ 网友Ben Leonardi整理的通俗版实验结论,特别提醒“这只是早期细胞实验,还不是灵丹妙药”
注意一个极具洞察力的细节:得分0.85和0.83的成了,夹在中间得0.84分的反而败了。
这恰恰戳破了外行对AI算命式的迷信。面对评论区“150万次猜中2次算什么本事”的质疑,必须看清科学研究真实的漏斗结构:150万条假说是机器在庞大基因组合空间里筛出的及格线;随后经过机制过滤与人类专家的主观挑选,仅有3条进入烧钱的湿实验。
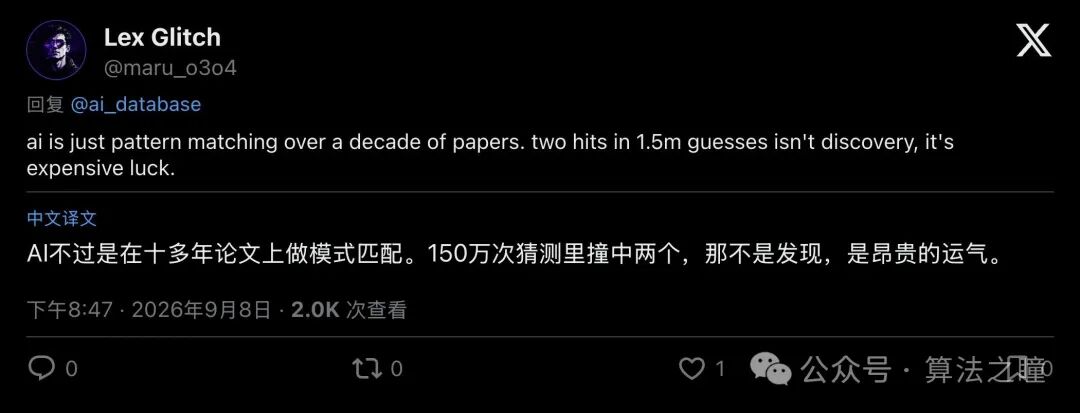
▲ 英文评论区的冷水:质疑在十年论文上做模式匹配、从150万次猜测中撞中两个只是“昂贵的运气”
你既不能吹嘘“AI整体命中率高达66.7%”,也不能贬低它是“瞎猫碰上死耗子”。因为没有这台机器在底层把暗线捞出来,人类专家连把这三组基因送进实验室做测试的念头都不会产生。
02拆解二:从“算菜谱”到“算基因”,给知识图谱装上时间机器
为什么偏偏是索尼AI做出了这套系统?
翻开技术族谱会发现一个极有趣的冷知识:Hakken的核心预测引擎叫 THiGERLLM,而它的前身 THiGER(发表于2024年),最早干的活儿之一竟然是预测食材与风味化学分子的配对!
当年,索尼AI的工程师们研究的是如何从已知的美食搭配图谱里,推算出哪两种从未搭在一起过的食材能撞出奇妙火花。但当他们试图把这套纯图神经网络(GNN)搬到跨度几十年、包含23种细粒度有向关系(如“增加”“减少”“结合”“共表达”)的生物医学文献图谱时,纯图模型撞上了三堵叹息之墙:
第一,看不懂论文里的弦外之音纯拓扑连线分不清两个基因之间复杂的实验条件与多标签修饰关系。第二,冷启动死局刚被人类发现的新基因或长尾罕见基因,在图谱里根本没几条连线,图神经网络一算就瞎。第三,把“未知”当成“错误”
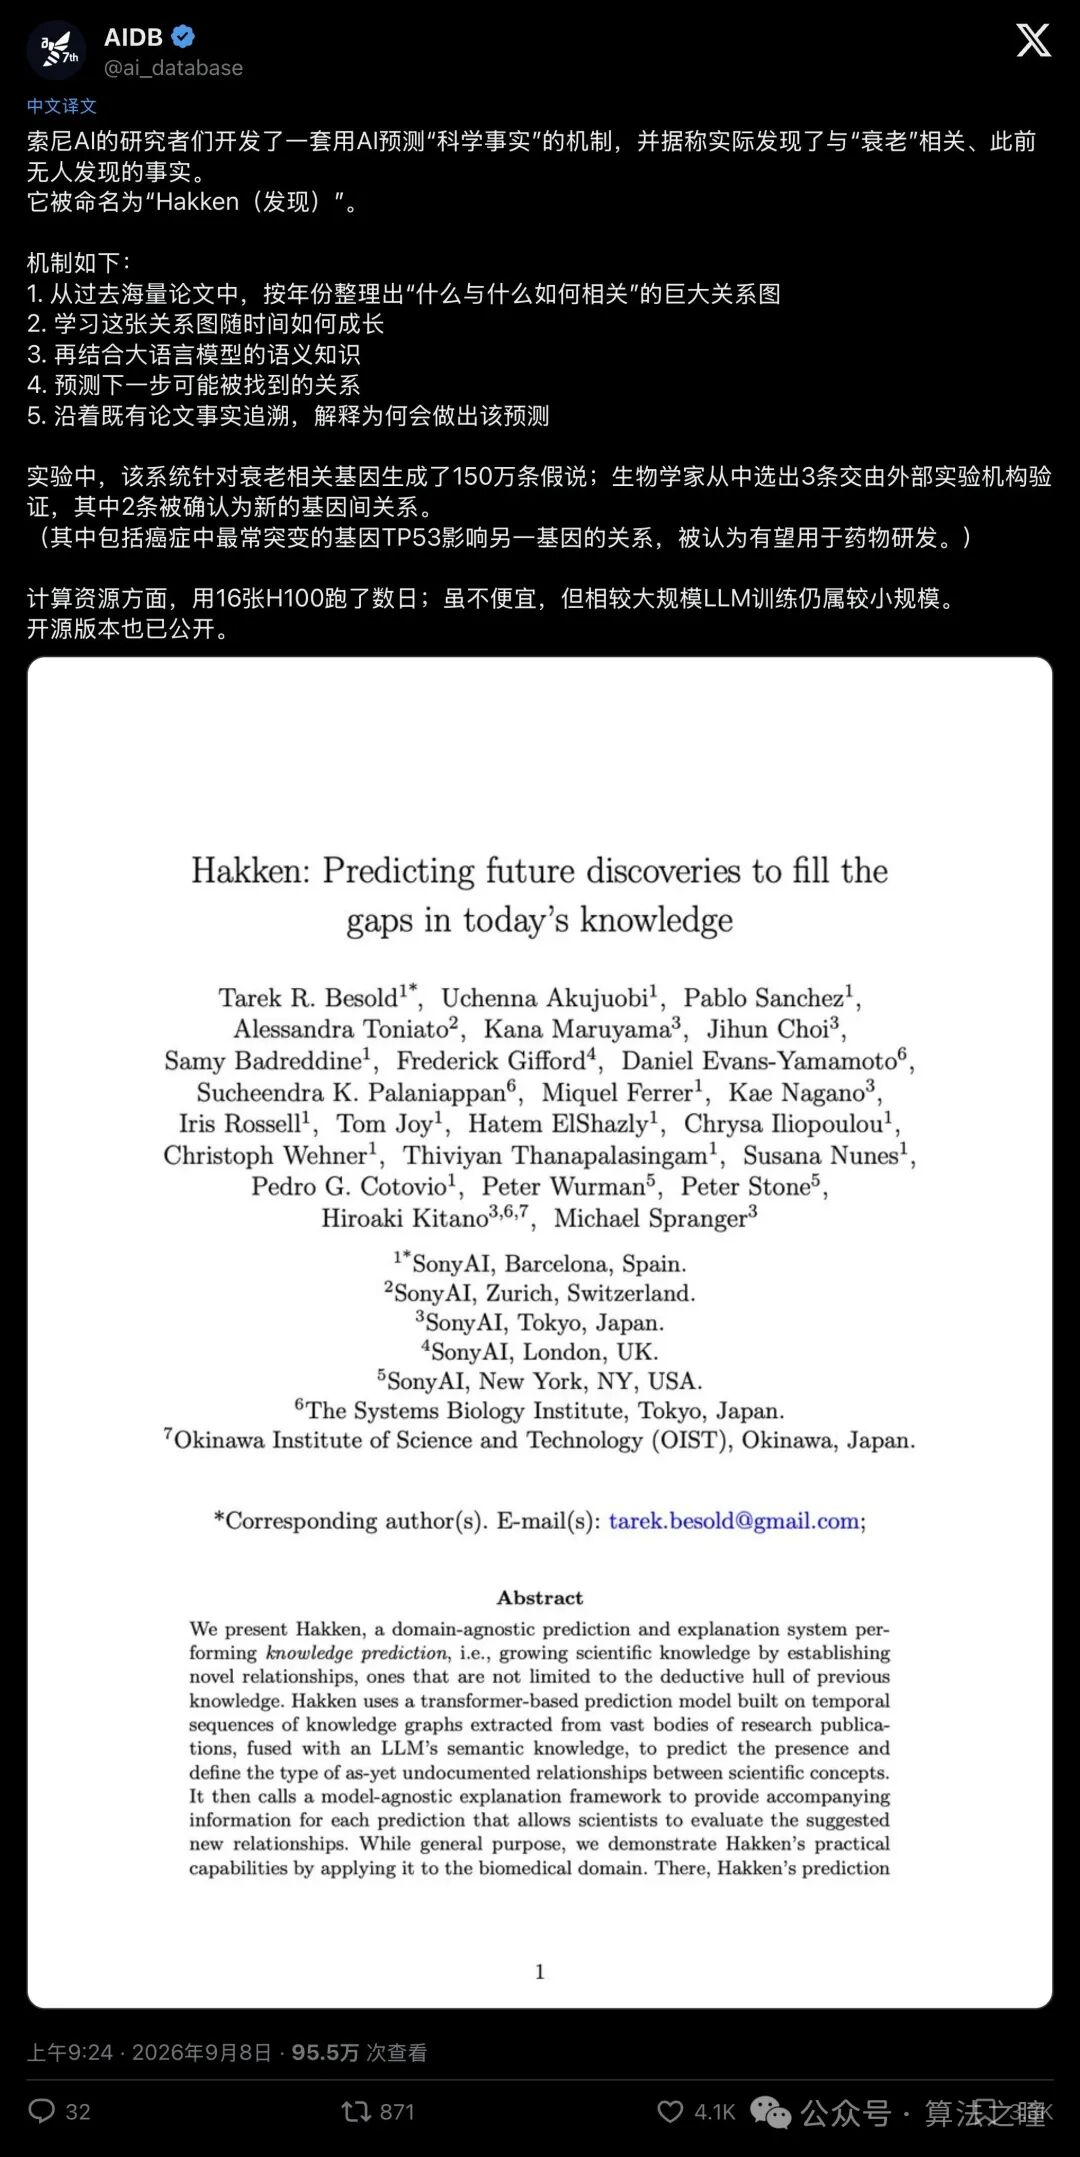
▲ 日语科普账号AIDB拆解Hakken的五步工作流:按年份建图、学习演化、融合LLM、预测新连接并生成解释
为了砸穿这三堵墙,升级版的 THiGERLLM 先在图编码分支里使出了三招绝活:
第一招,给孤儿节点发“家谱身份证”(RDF2vec本体初始化)。模型不靠随机数字给基因编号,而是先把每个基因、疾病、化合物锚定在标准的生物医学本体树(如基因本体GO、疾病库MeSH)上,用随机游走算出初始向量。哪怕某个冷门基因在历史论文里从没和别人同框过,模型一看它的“家谱出身”,也能立刻明白它的生化底色。
第二招,把历史切成胶片(GraphSAGE快照聚合)。系统把几十年的医学文献按年度或双年度切成一张张静态图快照,用GraphSAGE提取每个时期节点的局部邻域特征。
第三招,跨时空“情侣专座”掩码(Pairmate-Only Attention Mask)。当模型把几十年的快照串起来送进时序Transformer时,专门设计了一套只看配对伴侣的注意力掩码。在同一个时间截面里,源基因  的目光被严格锁定在目标基因
 身上,彻底屏蔽批次里其他无关基因的噪音干扰;而在时间轴上,它又能顺着因果链条,看清这对基因在过去三十年里是如何一步步在各自圈子里积累证据、缓慢靠近的。
03拆解三:严禁“偷看答案”的盲测,与 <htg> 软前缀脑机接口
有了时间演化图谱还不够,还得让机器读懂论文原句。
为此,团队请出了70亿参数的开源模型 Mistral-7B-Instruct-v0.3,并将其参数死死冻结(Frozen),作为语义推理主干。
这里藏着整个系统最精妙、也最严苛的防作弊设计,非共现文献采样(Non-Co-occurring Sentence Sampling)。
想想看,如果你把同时写着“基因A”和“基因B”的论文句子喂给大模型,大模型根本不用动脑子,直接做个阅读理解就能把关系抄出来。为了逼出真正的“预测能力”,研究团队立下铁规:
- 严格时间截断
:只准抽取训练截止年份(如2020年)之前的历史文献。 - 严禁同框
:每次推理时,只准抽最多 20条只提基因A、绝不提基因B 的句子,外加最多 20条只提基因B、绝不提基因A 的句子!
这就像把两个素未谋面的嫌疑人的独立档案袋拍在侦探桌上,档案里绝没有两人见面的记录,却要求侦探推断他们未来会不会联手犯案。
没有共现句子,冻结参数的Mistral-7B怎么破案?答案是给它装上一套“脑机接口”,<htg> 软前缀注入机制:
- 全局图标记替换(
<htg>Splice):在喂给大模型的文本提示词模板里,预留了一个特殊的 <htg>占位符。图神经网络算出来的“全局时序配对向量”,经过一层轻量级MLP投影后,像芯片插槽一样直接替换掉<htg>的词向量。 - 时序快照软前缀与门控

:那几十个年份的历史快照向量,被拼成一串“软前缀”塞在所有文字的最前面,并配上一个可学习的门控标量  ,让大模型在读独立句子时,能随时调取这两个基因在过去几十年里的拓扑距离演变。
不仅要算得准,还得说得清Hakken配套了名为 PHELInE 的解释框架。它不需要撬开预测模型的黑箱参数,就能在知识图谱上自动搜出连接两个基因的 2到4跳文献路径,告诉人类科学家:“我之所以猜A能影响B,是因为历史文献证明A控制C,C调节D,而D恰好作用于B。”
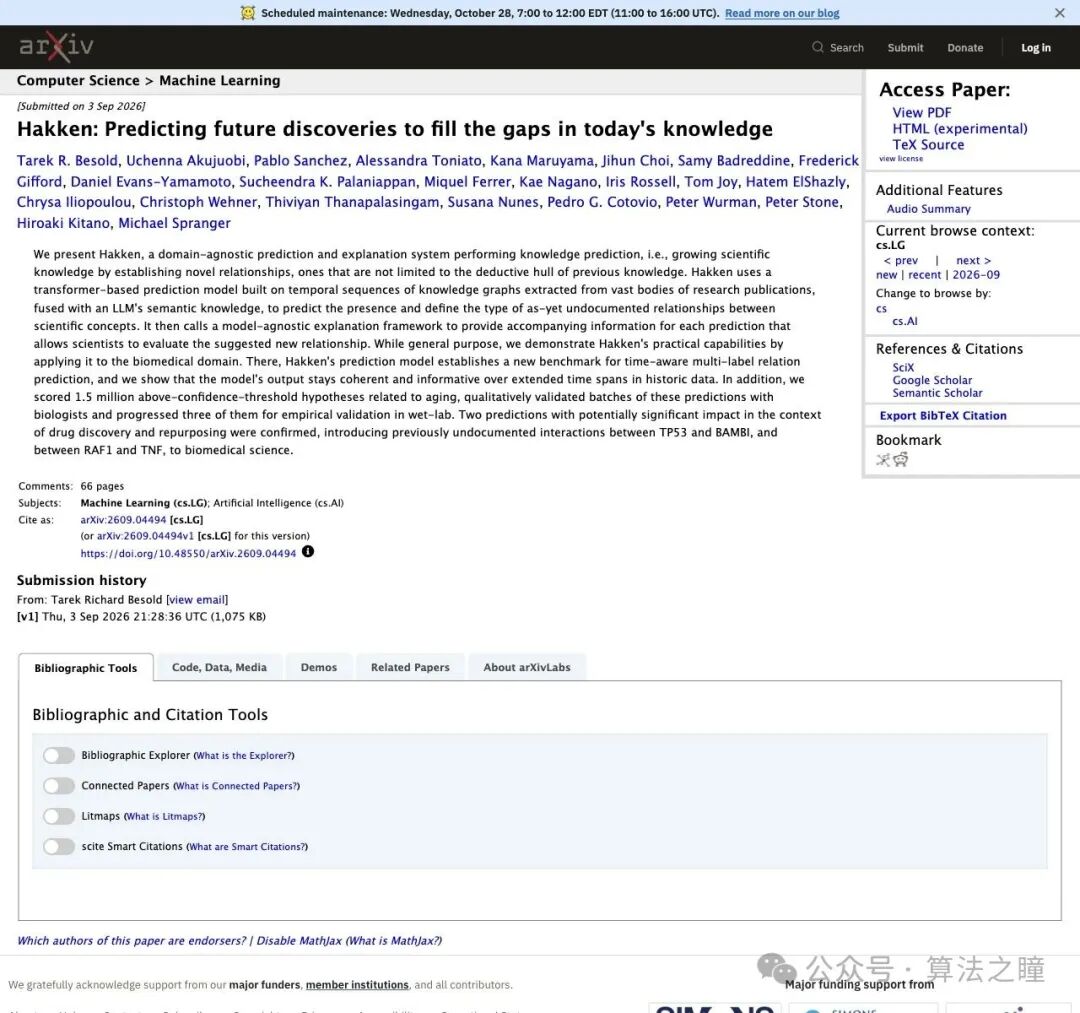
▲ arXiv预印本(2609.04494)首页,24位作者联手打通了“时序图预测+文献路径解释+湿实验验证”闭环
正是这些清晰的多跳文献证据链,给了人类生物学家掏出经费、把假说送进实验室的底气。
04拆解四:不把“人类还没发现”当成错,损失函数里的科学哲学
如果说架构设计展现的是工程巧思,那么Hakken在损失函数上的改进,则直指AI科学发现(AI for Science)最深刻的哲学悖论。
在传统的机器学习里,非黑即白:训练数据里有连线的就是正样本(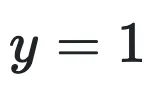 ),没连线的统统当成负样本(
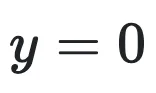 )。如果模型敢把一个
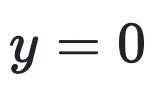 的样本预测出高概率,损失函数就会狠狠惩罚它。
但在科学探索中,“人类文献里还没写”,等于“生物学上不存在”吗?
当然不等于!那些 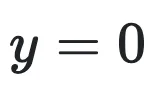 的空白地带里,恰恰埋藏着人类尚未发现的科学新大陆(即正样本与未标记样本混杂的 PU Learning 困境)。如果用传统损失函数去训,模型越老实,就越不敢预测未知的科学发现;再加上23种生物关系里,热门关系有几百万条,冷门生化反应只有寥寥几十条,稀有类别的梯度瞬间就会被淹没。
为了解开这个死结,索尼AI团队专门推导出了 PU-safe动态加权平衡Focal Loss(DWF)。它的四板斧刀刀见血:
- 给未知留活路(PU-safe软目标退火)
:随着训练深入,如果模型对某个未标记样本( 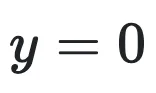 )依然极其顽强地给出高置信度,系统不会一棍子把它打死清零,而是通过动态混合系数生成平滑的“软目标”,主动释放惩罚压力,容许模型坚持它所看到的未来。
- 动态聚焦难啃的骨头
:摒弃固定常数,根据预测值与软目标的实时差距动态调整聚焦指数,把算力火力集中到边界模糊的困难样本上。 - 有效质量批次归一化
:按每个批次内的“有效调制质量”与全局类别逆频率做归一化,让只有几十条样本的冷门生化关系,也能在反向传播时拿到和百万级热门关系平起平坐的梯度步长。 - 拒绝做骑墙派(伯努利方差正则项)
:强行惩罚那些集中在0.5附近的模棱两可预测,逼模型给出干脆利落的判断,最后再用Platt Scaling与保序回归做混合校准。
这套机制的效果立竿见影:在以2020年为界的时间切分盲测中,THiGERLLM拿下了 51.16% 的Macro F1分数,在稀疏长尾关系上的召回率实现了大幅跃升。作者甚至坦言,由于许多真实存在的生物学关系至今还没被人类实验做出来,这个精度指标其实只是系统的“保底下界”。
05尾声:当机器开始批量生产“待验证的未来”
目前,索尼已将平台骨架以 HakkenOSS 之名开源在GitHub上。
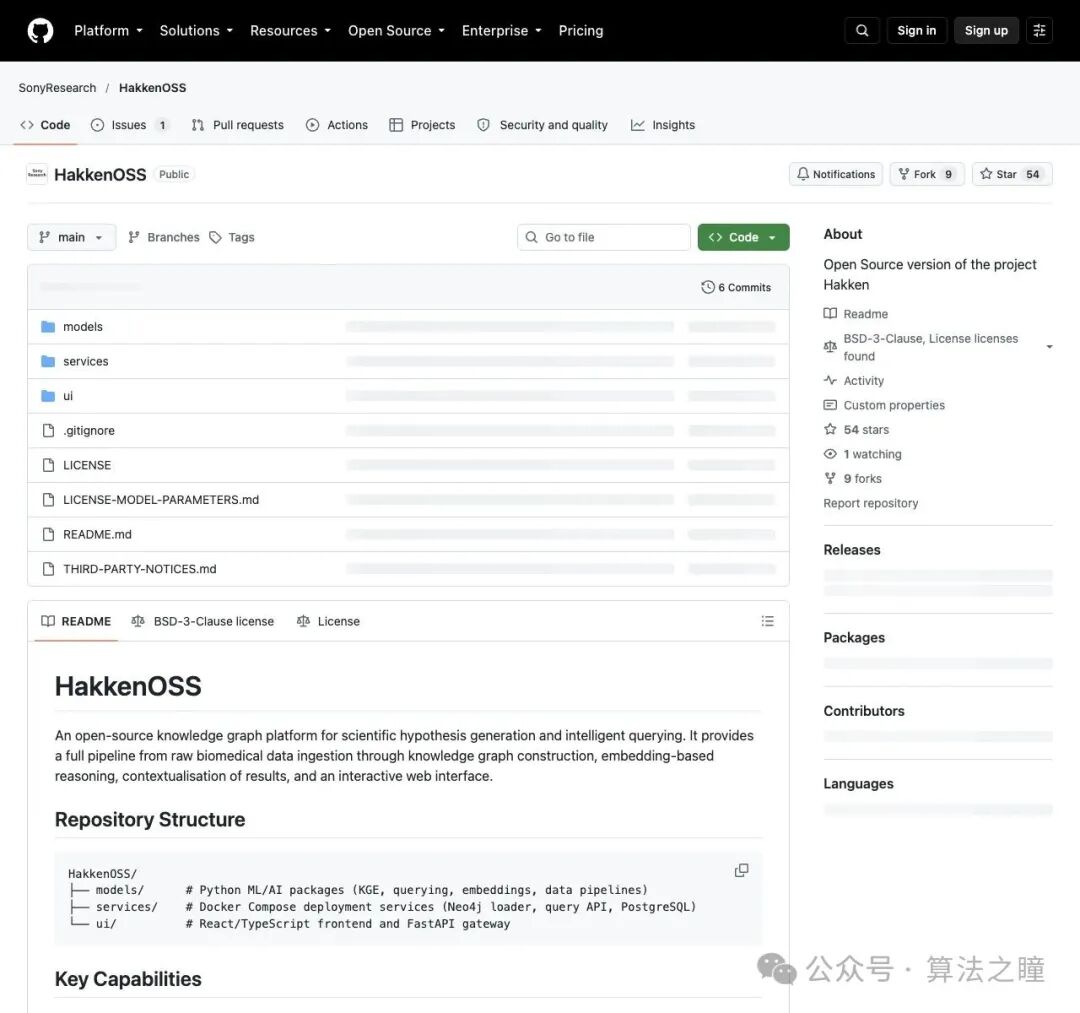
▲ 索尼开源的HakkenOSS代码仓库,涵盖了从数据摄入、图构建到假说生成的完整流水线
但我们也必须保持清醒开源代码骨架,不等于一键复现全部神迹,论文底层的完整数据拼图不仅包含PMC开放获取文献、MEDLINE摘要,还融合了昂贵的商业授权学术数据库;对外演示的图形界面版本也受限于数据许可而仅基于PubTator3训练。更何况,从细胞系里的基因表达变化,到真正做成抗衰老或治癌的药物,中间还隔着动物实验与漫长的临床试验深渊。
然而,Hakken撕开的这道口子依然让人心头一震、又热血沸腾。
过去,我们造AI,是为了帮科学家更快地检索过去;现在,通过把时序知识图谱装进大语言模型的脑回路,AI开始批量计算人类知识的“演化惯性”,在几百万篇无人能通读的论文夹缝里,精准指认那些本该存在、却被人类视野盲区漏掉的隐形齿轮。
正如网友Hello Chicken在评论区留下的那句感叹:“未来最棘手的课题在于,如何训练人类去接住AI喷涌而出的高压水枪。”
当一台机器几天之内就能甩出150万条有理有据的科学假说时,限制人类揭开生命奥秘的终极瓶颈,已经从大脑的想象力,转向了现实世界里的移液枪、培养皿和实验室,到底转得有多快了。