ARTICLE · 1247050
同一块晶体,15 个软件、40 种方法:答案差多少?
同一块晶体,15 个软件、40 种方法:答案差多少?
60 多位作者联手的一次“统考”,以及它给出的几条实用结论
导读
2016 年 3 月,《科学》(Science)刊登了一篇不太像论文的论文:它没有提出新方法,没有合成新材料,也没有预测任何新物质,只是把 71 种元素的晶体交给 15 个电子结构软件、40 种方法各算一遍,问了一个最朴素的问题——大家算的到底是不是同一个东西?为了回答它,60 多位作者联手。答案比想象中好,也比想象中更值得警惕:现代方法之间的一致性已经达到了高精度实验的量级;而真正拉开差距的,往往不是“你用了哪个软件”,而是“你下载了哪一版的赝势文件”。本文把这份成绩单拆开,讲清三件事:那个用来打分的 Δ 值是什么、哪些选择真正影响结果、以及为什么“算得一致”并不等于“算得对”。
关键词:可复现性;赝势;平面波;Δ 值;SSSP;DFT 验证
1. 一个很少被认真问的问题
几乎每个做第一性原理计算的人都遇到过这样的场面:组会上,你和隔壁工位的同学对同一个体系报了不同的晶格常数,差得不多——0.02 Å,也许 0.05 Å。导师看了一眼,说了句“大概是 k 点或者截断能不一样吧”,话题就过去了。
这句“大概”,掩盖了一个相当要紧的假设:我们默认计算结果只由物理决定,而不由实现方式决定。同一套密度泛函理论,用 VASP 算和用 Quantum ESPRESSO 算,用这套赝势和用那套赝势,应该给出同一个数。这个假设如果站不住,那“文献里说这个材料的带隙是 1.2 eV”这句话的可信度就要重新评估——因为你并不知道那个 1.2 eV 里,有多少是物理,有多少是某个 2003 年的赝势文件。
这个假设过去只是被零散地检验过:不同课题组各比各的,体系与口径都不统一,没有人把整个社区的代码和赝势摆到同一张桌子上。原因很实际:全世界没有一个人同时精通这十几个软件;而这类“不比谁更聪明、只比大家一不一样”的工作,既不算新物理,也很难拿到经费,做出来还未必有人引用。真正推动它的,是比利时根特大学的一个课题组——他们想做一件更朴素的事:给 DFT 立一把可以互相校准的尺子。
最终把东西摆上这张桌子的,是 60 多位作者[1],以及 15 个主流固体电子结构代码:既有全电子的 WIEN2k[2]、FLEUR、exciting、FHI-aims、ELK、RSPt、FPLO,也有以平面波或实空间网格为主的 ABINIT、CASTEP、Quantum ESPRESSO[3]、VASP[4]、GPAW,还有用局域原子基组的 SIESTA、CP2K 等。每个代码再配上几套自己惯用的势或基组,总数凑成 40 种方法。它们各自算同一批题,然后互相对答案。
2. 怎么给 DFT 打分:Δ 值的构造
统一考试的题目是这样的:71 种元素的晶体,全部用 PBE 泛函[5],各自算出一条状态方程,也就是能量随体积变化的曲线 E(V)。
为什么不比总能量?因为总能量的绝对值本身就没有可比性。赝势把核心电子挖掉之后,参考态被重新定义过,不同赝势给出的总能量可以相差几十电子伏特,这个差值没有任何物理意义。真正携带信息的是曲线的形状——平衡体积在哪里、曲率多大、也就是晶格常数和体模量。所以比较必须落在 E(V) 上,而不能落在 E 上。
在这条思路上,他们把两套计算结果之间的差异压缩成一个数,记作 Δ:先把两条 E(V) 曲线的能量零点各自平移到自己的最低点,抹掉那几十电子伏特的绝对偏移;再以两者平衡体积的平均值为中心,取上下各 6% 的窗口(即 0.94 V0 到 1.06 V0),把曲线之差的平方在这个体积区间上积分、除以区间宽度 0.12 V0、开方,单位是 meV/atom。用大白话说:它衡量的是两条状态方程曲线在“物理上有意义的那一小段”里,平均偏离了多少(图 1)。
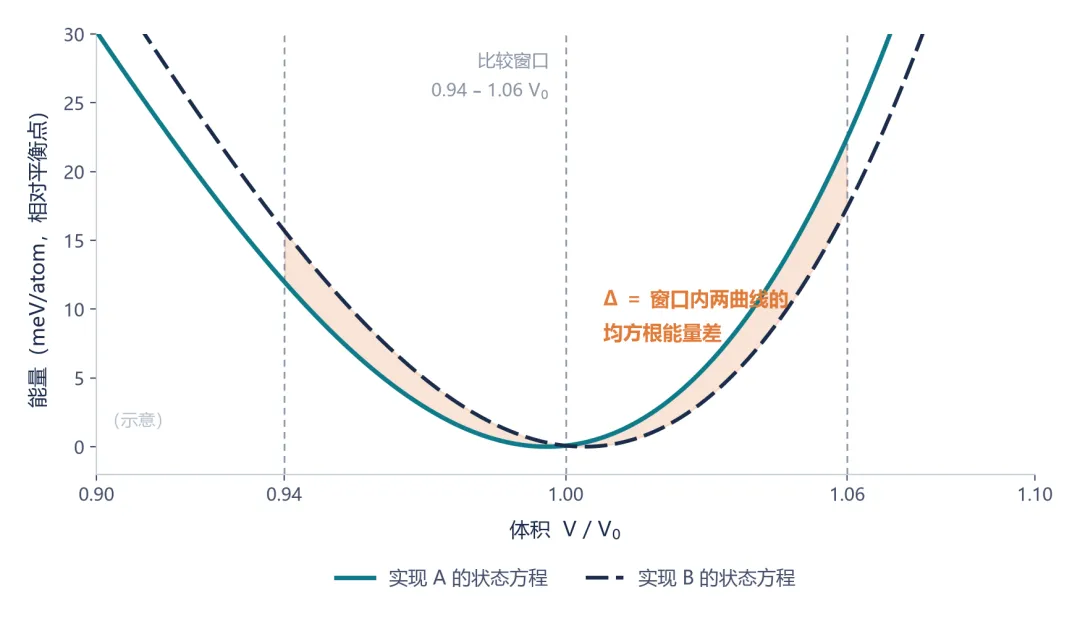
图 1 Δ 值的几何含义(示意):两套实现给出形状略有差异的状态方程,在 0.94 V0–1.06 V0 窗口内取差的均方根,即得 Δ。两条曲线的极小点(各自的平衡体积)略有差别,窗口即以两者的平均值为中心。窗口只覆盖平衡点附近,正是晶格常数、体模量这些量真正被读取的区间
这个定义有两个讲究。第一,它把“绝对能量的零点”彻底消掉了,只留下形状,所以 PAW、超软赝势、模守恒赝势、全电子方法可以放在同一张表里比较。第二,窗口限制在平衡点附近,是因为晶格常数、体模量这些量本来就是从曲线的极小点附近读出来的;远离平衡点的大幅压缩或拉伸不是基态方法的主场,把它们算进去只会稀释信号。
值得注意的是,这套评分方案并非凭空而来:最早是这批人里的几位为“如何估计固体 DFT 预测误差”搭起来的框架[6],随后被 Jollet–Torrent–Holzwarth 的 71 元素 PAW 数据表直接用作质量判据[7],再后来又被 SSSP 赝势库用作筛选标准。一个指标能被从元素基准一路用到赝势筛选的三批工作反复采用,本身说明它抓住了真问题。
3. 成绩单:1 meV/atom 是什么概念
先说好消息。当代主流的实现与赝势库,Δ 值普遍落在 1 meV/atom 附近,表现最好的能压到 0.3 meV/atom 左右。这个数字小到什么程度?作者给了一个很有说服力的参照系:把两组独立的高精度高压数据(Holzapfel 等人的一组,与 Kittel、Knittle 汇编的另一组,都是 Cu、Ag、Au 的高压状态方程)也折算成 Δ,是 1.0 meV/atom;而这三件材料的全电子计算之间,平均只有 0.8 meV/atom。换句话说,今天不同代码之间的一致性,已经略微超过了实验与实验之间的一致性。
最能说明问题的是硅。晶格常数是硅最经典、被算过最多次的可观测量之一。论文给出的对照是:早期 PBE 文献里,硅的晶格常数曾经散开 0.05 Å;而 2016 年这批代码的最新版本之间,只差 0.01 Å。按硅的晶格常数 5.43 Å 折算,前者约 0.9%,后者约 0.2%——相差五倍(图 2)。
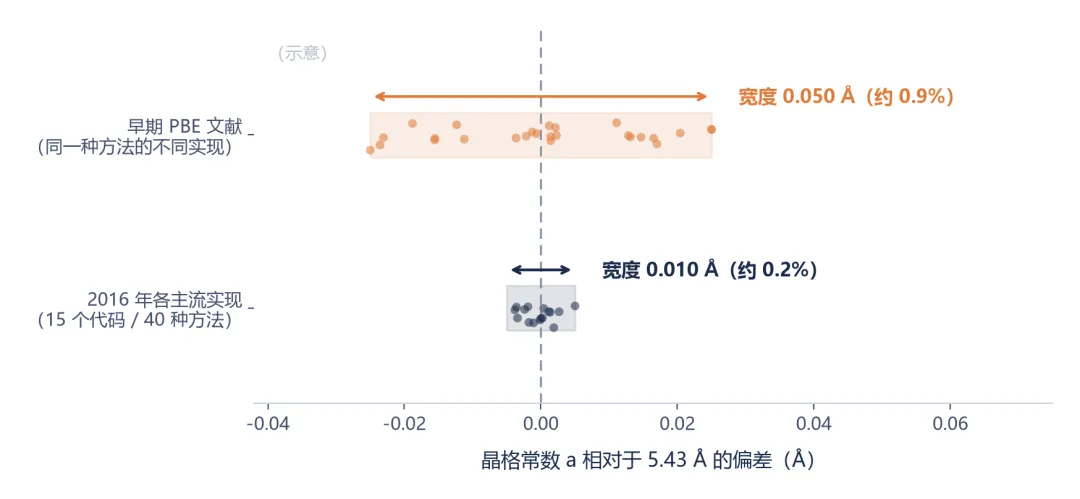
图 2 硅晶格常数在不同时期的离散程度(示意):横轴为相对于 5.43 Å 的偏差。历史上 PBE 文献的分布宽度约 0.05 Å,2016 年各主流实现之间的差异收敛到约 0.01 Å
这件事的意义值得强调一下。计算材料学长期被批评的一点是“算出来的东西没法验证”——实验可以重复,计算似乎只能相信。这篇论文提供了一个反向的答案:计算不但可以验证,而且可以自我校准。因为一旦有了 Δ 这把尺子,任何新写的代码、新生成的赝势、新的基组,都可以拿去和这套公开数据库比一遍,立刻知道自己处在什么水平。这在方法论上,比任何一个具体的材料预测都更值钱。
4. 真正拉低分数的,是“上一代赝势”
好成绩不是平均分布的。同一张表上,有一批结果明显偏离:Troullier–Martins 那批 FHI98pp/ABINIT 模守恒势、Dacapo 与 CASTEP 里的 Vanderbilt 型超软势,Δ 值显著高于当代水平。
但作者没有停在“上一代就是不行”这一句上,他们做了一个更精细的拆分——把“代码实现”和“赝势选择”这两个变量分开:让两套不同的代码使用同一套赝势文件,看它们能一致到什么程度(图 3)。
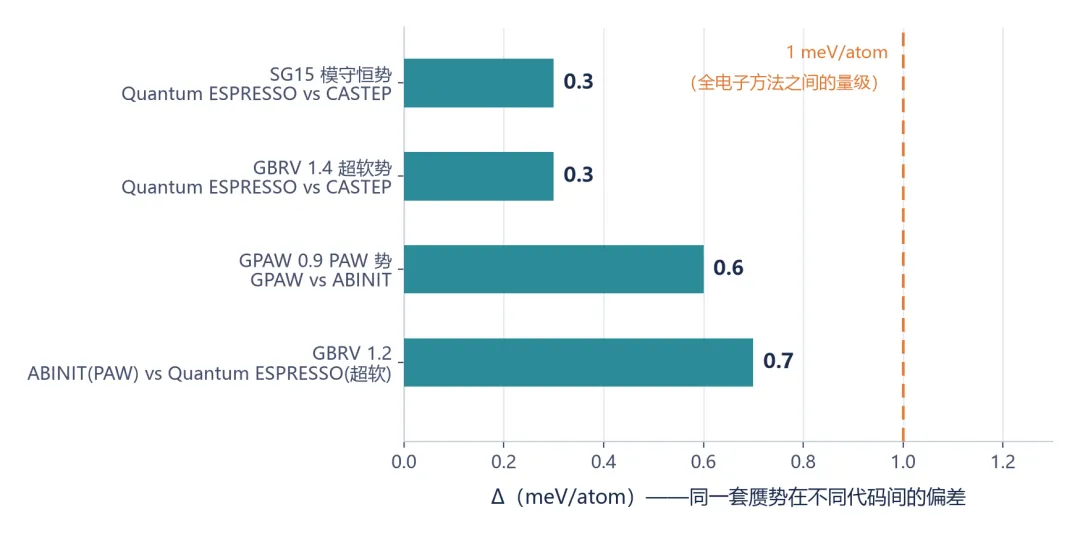
图 3 同一套赝势、不同代码之间的一致性(数据取自原文):四组交叉验证的 Δ 值都在 1 meV/atom 以内,说明现代代码对同一套势的实现差异很小
四组数字都很干净:GPAW 与 ABINIT 同用 GPAW 0.9 的 PAW 势,两者相差 0.6 meV/atom;Schlipf–Gygi 2015 的 ONCV 模守恒势(SG15)[8],Quantum ESPRESSO 与 CASTEP 之间是 0.3;GBRV 1.4 超软势在同样两个代码之间也是 0.3;GBRV 1.2 在 ABINIT 的 PAW 与 Quantum ESPRESSO 的超软之间是 0.7。
把这两组结论放在一起看,可以得到一条相当实用的判断:换代码带来的差异,基本被压在 1 meV/atom 以内;而换一套赝势,尤其是换回上一代的赝势,可以把这个差异放大数倍。换句话说,当你的结果和文献对不上时,先怀疑赝势文件,再去怀疑软件。
于是“版本”成了一个必须写清的量。GBRV 有 1.2、1.4 之分[9];SSSP 有 efficiency 与 precision 两套;JTH 的 PAW 表在 2014 年一次给出了 71 个元素,并用 Δ 做过验证。这些版本的差别不是格式或元素覆盖,而是精度本身。同一个元素名称,配上一个 2005 年的文件和一个 2020 年的文件,算出来的晶格常数可能就差了小数点后第二位——而审稿人盯的恰恰就是这一位。
写作规范上也因此多了一条近乎义务的要求:方法部分必须写明赝势文件的全名与版本。“采用 PAW 方法”是不够的,“采用 PBE-PAW,VASP 5.4 自带 POTCAR(2019 年 6 月版)”才是可重复的。差别在于,前者读者无法复现,后者读者可以。
5. 第二层坑:收敛测试不能“一测定终身”
赝势的问题解决之后,还有一个更日常的陷阱:收敛参数。
几乎所有教程都教你做同一件事——把平面波截断能从 300 eV 加到 600 eV,看总能量变化是否小于 1 meV/atom,然后定下截断能。这套流程本身没错,但它隐含了一个很少被说破的假设:总能量收敛了,别的量也就收敛了。
SSSP 那一套工作,正是冲着这个假设来的。Prandini 等人在 2018 年为 85 种元素逐一筛选了最多八家公开赝势库的候选赝势,动用了超过 5 万次 DFT 与 DFPT 计算[10]。判据不止状态方程一项,还包括边界声子频率、内聚能、压力与能带结构。结论里最扎人的一条是:不同物理量对赝势精度的要求,几乎是不相关的。
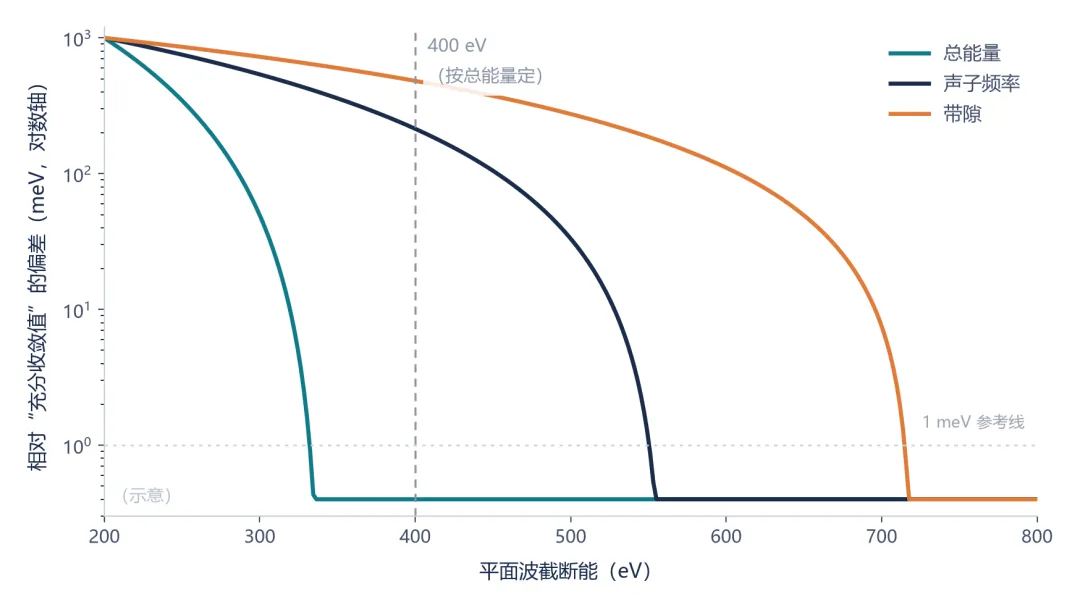
图 4 不同观测量对截断能的收敛速度不同(示意):按总能量定出的截断能(虚线)对能量已经足够,但声子频率与带隙可能仍未收敛。纵轴为该量相对于“充分收敛值”的偏差
具体到实践,这意味着:你按总能量把截断能定在 400 eV,然后拿这套参数去算声子谱,声子频率可能还在漂。你用它去算带隙,带隙可能也还在漂。收敛不是一个可以“传下去”的性质,它跟你要报告的那个观测量绑定(图 4)。正确的做法是对“你将要写进论文的那个数”本身做收敛测试——报带隙就对带隙做,报声子就对声子做,报弹性常数就对弹性常数做。
同一批工作还揪出了一个更隐蔽的问题:鬼态(ghost state)。某些赝势在构造不当时,会凭空引入一个没有物理对应的虚假能级,在能带图上表现为一条几乎不随 k 点弯曲的平带。SSSP 用“能带距离” η10(把价带和费米面以上 10 eV 以内的导带放在一起比,求两套能带的均方根差)来盯它:和一组干净的赝势相比,带鬼态的那一个会让 η10 从筛选标准要求的 10 meV 以内跳到 eV 量级,在图上一眼就能认出来。作者筛查的结果是,鬼态全部出现在导带里,价带里一个也没有——价带若是有,基态性质当场就崩了,根本藏不住。所以它对总能、晶格常数这类基态结果影响不大,却会污染 GW、BSE 这类激发态计算,这也正是它特别容易被忽略的原因。
顺带说一句常被误读的数字:SSSP 给出的平均截断能是 44 Ry(efficiency 版)与 56 Ry(precision 版)。这是跨 85 种元素、跨多个赝势库的平均值,不是给你体系的推荐值。含锰、铁、钴、铪这类过渡金属的体系,所需截断能往往明显更高——SSSP 甚至为铁和锰单独建议了更大的电荷密度截断比;反过来,也有不少元素低于平均值就已经够用。把平均值当成推荐值,是这类数据库最常见的用法错误。
6. 一致,不等于正确
讲到这里,必须踩一脚刹车,否则很容易得出一个过于乐观的结论:“既然大家算得都一样,那 DFT 算出来的就是对的。”
不是的。这里有一个概念上的分水岭,SSSP 的作者在论文里写得很清楚:他们做的是 verification(验证),不是 validation(确认)。前者问的是“我的实现和全电子参考是否一致”,后者问的是“我的理论和实验是否一致”。Δ 值小,只说明第一件事做到了——所有现代代码都在忠实地求解同一个 PBE 泛函。它完全不保证这个泛函本身离真实世界有多近。
最典型的例子还是带隙。硅的实验带隙是 1.17 eV,而 PBE 给出来的通常在 0.6 eV 上下——差掉了将近一半。这不是某个软件写错了,也不是某个赝势坏了;15 个软件、40 种方法高度一致地给出了同一个“错误”答案,因为错的不是实现,是泛函。Borlido 等人 2019 年在 472 种非磁性材料上系统比较了 12 个泛函[11],结论同样清楚:半局域泛函系统性地低估带隙,需要 meta-GGA 或杂化泛函才能把误差压下来。
所以误差其实是两层,得分开治理:
第一层是方法误差——泛函选得对不对。这一层的解药是换泛函:PBE 换成 SCAN、mBJ、HSE,或者干脆上 GW。(PBEsol 不在此列——它是为固体晶格常数调的,对带隙帮助有限。)方法误差常常是主导项,尤其在带隙、强关联体系、范德华体系上。第二层是实现误差——赝势、截断能、k 网格、展宽、收敛判据。这一层的解药就是前面说的那套:用经过验证的赝势库、对目标观测量做收敛测试。Δ 这个体系,治理的仅仅是第二层。
把这两层搞混,会犯两种相反的错。一种是拿着 PBE 的带隙去和实验比,然后感慨“DFT 不靠谱”——其实第一层就没解决好;另一种是花了三个月把截断能从 500 eV 调到 800 eV,指望带隙能对上实验——第二层已经收敛到 1 meV 了,再调也没用,问题在第一层。
这个问题在机器学习势流行的今天,还多了一层现实意义。机器学习势是跟着 DFT 数据学的,它会把训练数据的赝势选择、收敛水平、乃至泛函误差一起继承下来。一个用某套 2015 年赝势、截断能只做到“差不多”的数据集训练出来的模型,它的系统偏差不是随机噪声,而是一个稳定偏移——你甚至无法通过增加训练数据来消除它。这也是为什么,现在讨论大原子模型时,“它是在什么级别的理论下训练的”比“它有多少参数”更值得追问。
7. 三条能立刻用的自查
这篇论文没有提出任何新物理,却在十年里被引用了上千次。它做的事情,本质上是把“计算材料学”从一个依赖个人手艺的行当,往一门有校准标准的学科推了一把。对每天真正在跑计算的人来说,可以落成三条很具体的自查。
第一,把可复现所需的信息写全。代码与版本、赝势文件全名与日期、泛函、截断能(波函数与电荷密度分开写)、k 网格与是否以 Γ 点为中心、展宽方法与宽度、收敛判据。这些不是审稿人刁难你,而是别人复现你的唯一入口。少写一项,你的结果在别人那里就变成一个无法验证的断言。
第二,对关键量换一套赝势重算一遍。不需要全篇重跑,只挑那个支撑你核心结论的量——形成能、相变势垒、带隙、声子频率。如果换一套经过验证的赝势后结论变了,那这个敏感性本身就该写进文章,而不是藏起来。审稿人问“你怎么知道这不是赝势的锅”,你能拿出这张对照表,比任何辩解都有效。
第三,对“你要报告的那个量”做收敛测试,而不是对总能量。总能量收敛是最容易满足的判据,也最容易给人虚假的安全感。带隙、声子、弹性常数、缺陷形成能,各自的收敛速度不同,必须各测各的。
最后说一句听上去有点反直觉的话:这篇论文真正的贡献,不是证明了“DFT 很可靠”,而是证明了可靠性是可以被测量、被量化、被复核的。在此之前,“我算的结果和别人不一样”只能归因于玄学;在此之后,它可以被拆成一个个具体的、可检查的选择——你用了哪套势、你的截断能是多少、你的收敛判据是对着哪个量定的。
可复现从来不是等别人来重复你,而是你主动交出重复所需的全部条件。
写在最后:如果你手上正有一个“怎么调都和文献差一点点”的体系,或者一个“换了个赝势结论就反过来”的案例,欢迎在留言区说说具体是什么量、差多少。这类问题往往不需要重算整篇,只需要把变量一个个隔离出来——下一篇我们可能会挑几个典型的来拆。另外,之前聊机器学习势那篇里提到的“数据继承误差”,其实就是本文第六节那条线索的延伸,两篇可以对着看。
参考文献(References)
[1] Lejaeghere K, Bihlmayer G, Björkman T, et al. Reproducibility in density functional theory calculations of solids. Science, 2016, 351(6280): aad3000.
[2] Blaha P, Schwarz K, Tran F, et al. WIEN2k: an APW+lo program for calculating the properties of solids. The Journal of Chemical Physics, 2020, 152(7): 074101.
[3] Giannozzi P, Baroni S, Bonini N, et al. QUANTUM ESPRESSO: a modular and open-source software project for quantum simulations of materials. Journal of Physics: Condensed Matter, 2009, 21(39): 395502.
[4] Kresse G, Furthmüller J. Efficient iterative schemes for ab initio total-energy calculations using a plane-wave basis set. Physical Review B, 1996, 54(16): 11169–11186.
[5] Perdew J P, Burke K, Ernzerhof M. Generalized gradient approximation made simple. Physical Review Letters, 1996, 77(18): 3865–3868.
[6] Lejaeghere K, Van Speybroeck V, Van Oost G, et al. Error estimates for solid-state density-functional theory predictions: an overview by means of the ground-state elemental crystals. Critical Reviews in Solid State and Materials Sciences, 2014, 39(1): 1–24.
[7] Jollet F, Torrent M, Holzwarth N A W. Generation of projector augmented-wave atomic data: a 71 element validated table in the XML format. Computer Physics Communications, 2014, 185(4): 1246–1254.
[8] Schlipf M, Gygi F. Optimization algorithm for the generation of ONCV pseudopotentials. Computer Physics Communications, 2015, 196: 36–44.
[9] Garrity K F, Bennett J W, Rabe K M, et al. Pseudopotentials for high-throughput DFT calculations. Computational Materials Science, 2014, 81: 446–452.
[10] Prandini G, Marrazzo A, Castelli I E, et al. Precision and efficiency in solid-state pseudopotential calculations. npj Computational Materials, 2018, 4: 72.
[11] Borlido P, Aull T, Huran A W, et al. Large-scale benchmark of exchange–correlation functionals for the determination of electronic band gaps of solids. Journal of Chemical Theory and Computation, 2019, 15(9): 5069–5079.