ARTICLE · 1251992
AI 让更有野心的软件项目变得可行
2026-10-26 Hacker News Top Stories
一句话速览:
1. Dan Luu 以 pgrust、正则引擎和 Rust 工具链为例,主张重新评估 AI 时代的开发成本,同时强调验证仍是瓶颈。 2. Apollo 的 Torsten Slok 指出,七大科技巨头之外的标普 493 家公司,人均营收和利润率尚未出现他所期待的 AI 改善。 3. Steal My Bitcoin 用公开挑战检验 PHP RCE 的现实可利用性,项目作者随后在 HN 更新称已有成功解题者。 4. Goose 用编译器管理的数据栈实现无 GC、无生命周期标注的内存安全,但递归、变长容器和动态调用各有约束。 5. Joseph Politano 统计美国媒体、影视与艺术相关行业四年流失逾 20 万岗位,但指出 AI、外包和流媒体转型难以分开归因。 6. 巴西组织指控 Meta 对 Lula 与 Flávio Bolsonaro 的展示存在差别,法院要求解释;报道所列测试尚不足以单独证明故意偏袒。 7. Cerebras 以三万亿参数 Kimi K3 为示例,按 4 位权重和 256k 请求估算使用 59 片晶圆,通过流水线服务并发请求。 8. Roku 完成开发者仓库向 GitLab 的迁移,要求同步更新 Git、CI、子模块及 AI 检索源地址,文档修改改走 merge request。 9. mike64_t 称三星电视每隔数秒处理 960×540 图像,用 INT8 TensorFlow Lite 模型识别游戏,但效果与数据外传仍需分别核实。 10. 研究比较 14 个模型的英文输出,发现前沿模型偏好多种难读结构;长度惩罚实验支持信息压缩机制,但尚非真人理解测试。
1. Dan Luu:AI 让更有野心的软件项目变得可行 (We should be more ambitious with the software we build)
https://danluu.com/ambitious/
Dan Luu 以 pgrust、正则引擎和 Rust 工具链说明,AI 降低了过去过于昂贵的项目成本。但“自己够用”与成熟产品仍有距离;他承认部分性能比较不够严谨,也强调模型的实现能力增长快于自主验证能力。
HN 热度 736 points | 评论 675 comments | 投稿者:ltratt
https://news.ycombinator.com/item?id=50225695
• 新工具的价值不只在于更快完成旧任务,也在于让开发者尝试以前不敢承担的项目。 • 快速做出原型并没有消除用户需求、安全、集成、维护和商业化等后续工作。 • pgrust 的基准争议使部分读者质疑作者依赖个人信任为项目背书的做法。 • 可以因为低质量项目太多而选择不看,但未经检查就公开断言某个项目质量很差并不公平。 • 有开发者通过 PostgreSQL WAL 到 ClickHouse 的项目体会到,明确的反馈回路有助于驾驭复杂的 AI 辅助开发。
2. Apollo 首席经济学家:科技巨头之外尚未显现 AI 财务回报 (No signs of AI payoff outside the tech sector)
https://www.apollo.com/wealth/insights-news/insights/daily-spark/no-signs-of-ai-payoff-outside-the-tech-sector
Apollo 的 Torsten Slok 比较七大科技巨头与其余标普 493 家公司,认为 AI 财务回报仍高度集中,后者人均营收和利润率大致持平。这是汇总数据下的宏观判断,不能据此认定每个非科技企业的 AI 项目都没有收益。
HN 热度 609 points | 评论 645 comments | 投稿者:the-mitr
https://news.ycombinator.com/item?id=50224463
• 新技术可能需要组织重构和资本投入才能显现收益,短期宏观数据不足以决定长期结果。 • 编译器、测试、静态分析和性能工具让软件开发更容易形成验证回路,其他行业未必拥有同样条件。 • 一名自动化服务提供者观察到,AI 常被用于完成原本被取消或忽略的工作,而不是直接减少人员成本。 • 也有技术从业者反映,AI 对个人项目有帮助,但在日常工作中的净生产率暂时没有改善。 • 传统业务需要较多定制与流程整合,不能把通用模型接入等同于完成企业落地。
3. Show HN:用“偷走我的比特币”挑战检验 PHP RCE 风险 (Show HN: Steal My Bitcoin)
https://stealmybitcoin.com/
Steal My Bitcoin 的投稿者表示,项目用公开挑战检验近日 PHP RCE 漏洞是否真正容易利用。本次网站返回服务错误,摘要仅依据 HN 投稿介绍,未能独立核实规则和环境;作者后续宣布成功解题的进展见下方讨论。
HN 热度 582 points | 评论 430 comments | 投稿者:cloudlandsdev
https://news.ycombinator.com/item?id=50224916
• 项目作者更新称已有解题者成功执行服务器上的标志程序,并说明自己放错了钱包密钥,最终认可解题并另行转付奖励。 • 把“轻易可利用”的说法变成公开挑战,有助于让宽泛的安全主张接受实际检验。 • 较低奖励未必足以吸引持有高价值漏洞利用的人,挑战暂时无人完成也不能直接证明漏洞不严重。 • 反向代理的请求限制会影响攻击条件,实验结果需要结合实际部署配置理解。 • 作者解释默认代理配置旨在贴近常见部署,同时承认流量过大和日志容量限制影响了站点稳定性与记录。
4. Goose:以编译器管理的数据栈替代堆分配 (The Goose Programming Language)
https://aardappel.github.io/goose/
Goose 把动态值放在编译器管理的数据栈上,用作用域释放和引用检查实现无 GC、无生命周期标注的内存安全。项目的性能优势来自自建 16 项基准;变长数组索引、递归数据、闭包和动态调用等方面仍有明确限制。
HN 热度 563 points | 评论 347 comments | 投稿者:bobbydigitales
https://news.ycombinator.com/item?id=50224100
• 相对引用与直接映射的数据布局对追求低开销文件和网络处理的开发者很有吸引力。 • 任意增删的大量变长对象如何表示仍值得追问,必要时可能把分配器的复杂性转移到应用自己的池中。 • 按数据类型建立多个池并非毫无价值,它可能让分配更简单,但也要求开发者理解对象的生命周期。 • 返回动态数组时在调用方目标位置直接构造,可以避免把整个数组复制出去。 • 语言定位需要同时说明安全、性能和开发体验的优先级,而不是仅展示速度数字。
5. 美国创意产业四年流失逾二十万岗位,多少能归因于 AI? (America has lost 200k of jobs in media, film and the arts. How much is AI?)
https://www.apricitas.io/p/ai-and-the-fall-of-the-creative-class
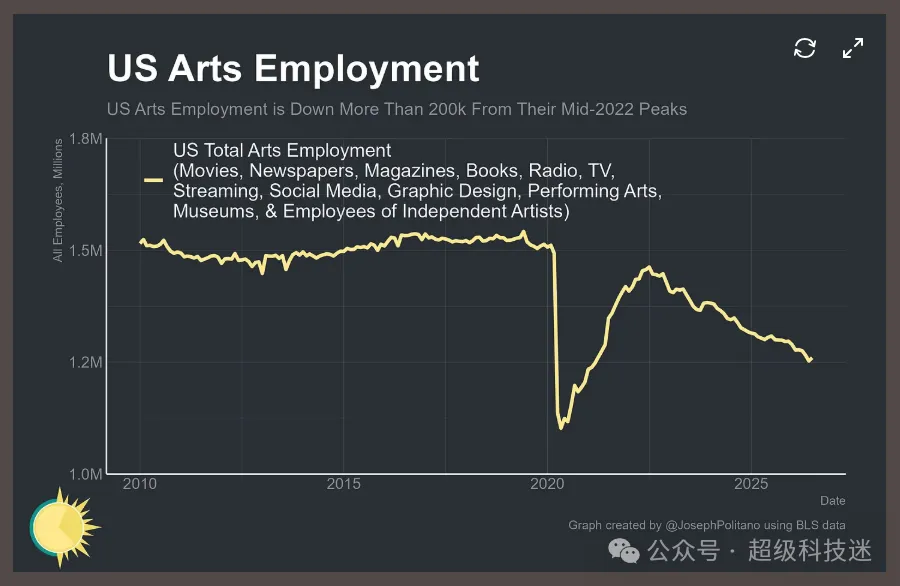
Joseph Politano 指出,美国创意产业四年流失逾 20 万岗位,最近一年约 5 万个,影视与录音行业损失超过 10 万个。但 AI 与流媒体转型、外包、行业整合等因素难以分开归因;文章讨论的是商业模式压力,并未算出 AI 导致的精确失业数量。
HN 热度 500 points | 评论 534 comments | 投稿者:gnabgib
https://news.ycombinator.com/item?id=50226419
• 短视频和长视频平台占用观众时间,本身就可能挤压传统影视需求,不能忽略消费习惯变化。 • 拍摄补贴、罢工、疫情与海外制作成本,都可能推动美国本土影视岗位流失。 • 判断 AI 的独立影响需要控制利率、通胀、购买力和其他宏观冲击,时间上的重合不够。 • 电视与电影的收入结构不同,流媒体改变季数、集数、重播收入和工作连续性,值得分别分析。 • 一名评论者转述业内经历称,某些特效和动画项目即使仍然存在,报价也大幅降低,岗位数之外还需看收入。
6. Meta 被指未消除巴西选举平台差别待遇,证据与结论仍需区分 (Meta Ignores Brazilian Court Order to End Bolsonaro Favoritism)
https://www.panamericandispatch.org/p/meta-ignores-brazilian-court-order
报道介绍巴西组织对 Meta 搜索、GIF 与标签排序的差别待遇指控,Meta 否认故意偏袒。法院公告可确认其要求合规解释,但两次随机数字回答等测试不足以单独证明政治意图,应区分投诉材料、法院程序与最终认定。
HN 热度 466 points | 评论 323 comments | 投稿者:vrganj
https://news.ycombinator.com/item?id=50229587
• 两次随机数字回答不足以支撑选举偏袒的强结论,提出指控时应使用更有说服力的测试。 • 互动率驱动的排序即使没有人工指定候选人,也可能放大情绪化政治内容,因此仍需要审视平台机制。 • 对大型平台而言固定金额罚款可能缺乏威慑力,执行机制应考虑企业规模。 • 选举期间的平台展示与推荐需要更透明的规则,以减少私人平台左右公共信息的风险。 • 要求政府调整算法也可能给未来的政治干预开门,监管权力本身同样需要约束。
7. Cerebras 以 59 片晶圆说明三万亿参数模型的流水线部署 (Cerebras Deploys Trillion-Parameter AI Models)
https://www.cerebras.ai/blog/how-we-deploy-trillion-parameter-frontier-models-on-cerebras
Cerebras 用三万亿参数 Kimi K3 说明多晶圆部署:假设 4 位权重、8 位 KV 缓存及 256k 请求,需要约 59 片各含 44 GB SRAM 的晶圆。权重常驻片上,不同请求在流水线中并行推进;具体并发和吞吐仍受缓存与微批大小约束。
HN 热度 348 points | 评论 127 comments | 投稿者:gmays
https://news.ycombinator.com/item?id=50227356
• 跨越几十片晶圆的流水线需要说明故障域、请求排空和滚动升级方式,不能只看理想运行速度。 • 引用完整精度模型的能力成绩后转用 4 位权重部署,需要补充量化版本的实际质量测量。 • 片上容量应与 SRAM 而非普通内存比较,低延迟和高成本会限制可集成的容量。 • 只说明解码时传递激活值仍不完整,长上下文预填充在该互连上的表现也需要解释。 • 评估系统效率还应计算整套设备的耗电与每个 token 的能耗,不能只比较生成速度。
8. Roku 将开发者仓库从 GitHub 迁至 GitLab (Roku developer repositories moved from GitHub to GitLab)
https://blog.roku.com/developer/gitlab-move
Roku 已把开发文档、示例和工具仓库迁至 GitLab,仓库名不变。已有 Git 远端、子模块、CI、原始文件路径及 AI 检索索引都需更新;文档修订改走 fork 与 merge request。官方没有说明迁移的具体动机。
HN 热度 305 points | 评论 216 comments | 投稿者:cxr
https://news.ycombinator.com/item?id=50222622
• 官方没有说明迁移动机,使读者难以判断这次选择究竟解决了什么具体问题。 • 有开发者因 GitHub 服务中断影响交付而支持迁移,认为可靠性不应被视为理所当然的业务损耗。 • 支持 GitLab 的使用者认为它更贴近企业项目与协作流程,而不只是面向开源社交。 • 也有同时用过两者的开发者认为功能差异有限,需要用具体工作流而非品牌偏好比较。 • 代理带来的仓库和接口负载增长也会影响其他托管平台,换服务商未必能永久消除容量压力。
9. 研究者称三星电视周期性运行 TensorFlow Lite 识别游戏画面 (Samsung running a TensorFlow lite model on 960x540 image to track you)
https://twitter.com/mike64_t/status/2114150399406202896
mike64_t 称三星电视每隔数秒对 960×540 图像运行 INT8 TensorFlow Lite 模型,尝试识别游戏,并认为授权检查晚于前面的计算。原帖缺少跨机型测试和完整数据流证据,不能据此断言电视持续上传截图。
HN 热度 285 points | 评论 1 comments | 投稿者:mashally
https://news.ycombinator.com/item?id=50230181
本帖评论已合并到以下三星电视讨论,下面归并的是该讨论中的观点。
https://news.ycombinator.com/item?id=50218633
• 若拒绝授权后仍运行模型再丢弃结果,就会带来没有用户收益的运算和电力消耗。 • 内容识别也可能服务画面参数优化,具体用途需要与广告追踪分别核对。 • 本地分类与向外上传原始内容的隐私后果不同,讨论应避免把所有处理方式等同。 • 功能是否默认开启、推断结果是否出售,都应有清楚的用户选择与可验证的控制。 • 逆向分析应先核对公开文档和已宣传功能,不能只靠工具输出就把既有功能称为新发现。
10. 研究:信息压缩压力可能让 AI 英文更难读 (Why is AI generated language so hard to understand?)
https://arxiv.org/abs/2610.29162
研究比较 14 个模型的英文输出,发现前沿模型较常使用低频词组、名词堆叠等结构。小模型长度惩罚实验支持“信息压缩可能损害可读性”的机制;但研究只分析英文,使用间接语言指标,并非真人阅读理解测验。
HN 热度 241 points | 评论 197 comments | 投稿者:canjobear
https://news.ycombinator.com/item?id=50223647
• 模型常围绕当前提示和上下文写作,却没有站在最终读者的角度判断哪些信息必须解释。 • 看起来有条理、篇幅长且修辞丰富的回答,未必真正对目标读者有用。 • 请求简单解释有时能改善输出,但需要反复纠正语体也增加使用负担。 • 部分使用者反而觉得 AI 文字更易理解,因此语言指标和个人阅读体验不应直接画等号。 • 长度惩罚改变语法偏好的实验值得量化研究,但默认语体与模型能够生成的全部风格仍需区分。