ARTICLE · 1255534
病历整理,让 AI 做助手:一项人机协同研究的启发
医学 AI 课题 · 技术合作
课题申报|国自然申请书中 AI 研究方案、技术路线与实验设计的梳理和修改。
技术实施|实验验证与代码实施。
有具体问题,欢迎留言或私信交流。
回复「清单」,领取《医生 AI 课题技术路线自检清单》。
先看三个要点
研究问题: 从大量病历中识别免疫治疗相关的皮肤不良事件,需要同时核对症状、时间和归因,人工整理耗时,也容易出现判断分歧。
解决方案: 先检索相关病历片段,再让大模型形成初步判断,由另一个模型角色检查,最后把结论和证据一起交给人工审核。
达到的效果: 在 160 名患者的独立评估集上,AI 辅助组的 F1 从人工组的 0.77 提高到 0.88,审核者之间的一致性也更高。单份病历审核时间从 15 分钟降到 10 分钟,但时间来自事后自报,两组使用不同审核者,尚不能把全部差异归因于 AI。
这项发表在 npj Precision Oncology 的研究(https://www.nature.com/articles/s41698-026-01737-y),给医学 AI 课题提供了一个很具体的切入口:让 AI 帮助人找到证据、整理判断,再研究这套协作流程是否可靠。
病历里出现“皮疹”,并不等于找到了研究终点
假设你需要回顾一批接受免疫检查点抑制剂治疗的患者,判断谁发生过治疗相关的皮肤不良事件。
搜索“皮疹”,只能找到一些候选记录。真正需要回答的是:症状发生在治疗前还是治疗后?医生认为与免疫治疗有关,还是更可能由感染或其他药物引起?这段描述是在记录已经发生的事件,还是在告知患者潜在风险?
同一个患者的线索,还可能散落在肿瘤科记录、皮肤科会诊和后续随访里。
因此,任务的难点包含两个部分:从长病历中找全相关信息,以及按照明确规则作出判断。 一个答案即使看起来合理,找不到对应记录,也很难让研究者放心使用。
这也是这篇论文值得读的地方。它把工作拆成了可以检查的步骤。
一条证据怎样走到最终判断
研究团队先清理重复内容和模板文本,将病历切成片段,建立检索库。检索同时使用语义相似度和关键词匹配,也考虑否定表达。
这里的两种检索各有作用。语义检索有机会找到不同写法表达的同一件事;关键词检索有助于保留明确的医学术语。组合使用,是为了减少只靠某一种匹配方式遗漏证据的风险。
随后,系统设置了两个模型角色。
第一个负责综合判断。 它结合检索结果,判断是否存在目标不良事件,并给出理由和支持判断的病历片段。
第二个负责检查。 它检查前一个判断的推理、归因和内部一致性,对可能的问题提出反馈。这些角色主要由提示词组织,并不意味着团队重新训练了两个医学基础模型。
最后决定仍由人工审核者作出。 人可以接受、修改或核实模型的结果。系统提供的是带证据的工作底稿。
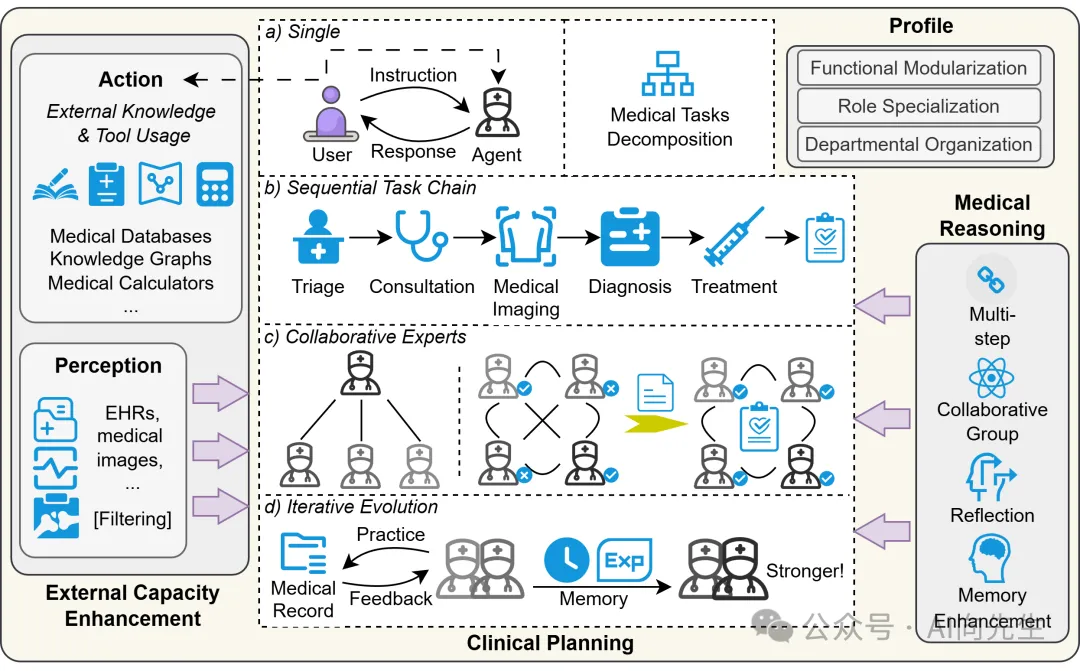
图 1|原论文图 3:病历经过检索后进入模型分析,结果与证据交给人工验证,检查角色提供反馈。原论文(https://www.nature.com/articles/s41698-026-01737-y) · CC BY-NC-ND 4.0(https://creativecommons.org/licenses/by-nc-nd/4.0/)。
这个流程里,我最看重的是“证据跟着判断走”。对于科研数据整理,得到一个标签还不够。后面发现某类样本有问题时,研究者需要能回到原始记录,知道这个标签当初为什么被填上。
效果提升了多少,要连同实验设计一起看
团队先用 100 名患者的数据开发提示词和选择模型,再使用不重叠的 160 名患者数据做评估。
两组接受过培训的非皮肤科审核者分别完成纯人工审核和 AI 辅助审核,以皮肤肿瘤专科专家的判定作为参考。主要结果如下:
F1 同时考虑查准和查全;κ 则衡量扣除偶然一致后,两位审核者的判断有多一致。它们回答的是不同问题:结果是否更接近参考答案,以及不同的人是否更容易形成一致判断。
这两类指标一起改善,说明这种协作方式有进一步验证的价值。研究全文与结果(https://www.nature.com/articles/s41698-026-01737-y_reference.pdf)
但这里有两点不能省略。
第一,15 分钟和 10 分钟来自审核者事后估计,没有通过逐份计时或系统日志测量。可以说研究报告了约三分之一的时间下降,不能写成已经严格测定的提效承诺。
第二,两组由不同的审核者组成,没有交叉换组。人员本身的能力差异,可能参与解释结果。若要更有说服力地回答“AI 究竟带来了多少改善”,后续还需要更严谨的分组和计时设计。
多一个“检查 Agent”,不等于多一份独立保证
这篇研究很容易被概括为“大模型判断,再让另一个大模型纠错”。但如果只记住这个结构,会漏掉关键条件。
两个模型角色可能拿到相同的不完整证据,也可能共享类似的错误倾向。如果检索阶段漏掉了决定性记录,后面的检查未必能补回来。
因此,判断系统是否可靠,需要分别观察:相关证据有没有被找到,证据能否支持结论,模型有没有把不确定的归因写得过于肯定,人工审核后还剩下什么错误。
论文展示的是一套完整辅助流程的评估。不能仅凭总体结果,就认为给任何任务加一个检查角色都能提高准确率。
同样,这项研究针对特定不良事件的回顾性识别,样本规模有限,患者人群也较集中。它支持继续研究病历审核辅助,不能直接推出系统已适用于其他医院、其他不良事件,更没有证明患者治疗结局因此改善。
对医工结合课题,最值得借鉴什么
如果你正在考虑用大模型整理病历,我建议先把研究问题缩到一个明确的变量:例如,某项检查是否完成,某个事件何时发生,记录中是否有明确的因果归因。
然后把交付结果设计成四部分:提取值、原始证据、记录时间、需要人工确认的疑点。 这样医生既能用,也能追查错误。
评估时,同时看质量、时间和人工负担。模型的标签准确率高,并不自动意味着医生更省事。如果每条结果都要重新翻完整份病历,实际收益可能很有限。
还可以把简单规则或普通检索作为基线,再比较大模型辅助。只有这样,才能知道增加模型复杂度究竟解决了什么问题。
这些是我从论文出发提出的课题设计建议。对很多团队而言,一个边界清楚、证据可查、能量化审核成本的小任务,已经足以构成有价值的研究。
医学 AI 的一个现实落点,是把人工判断前的准备做得更充分,让最终的判断更容易核实。
医疗 Agent 离“大白”还有多远?一篇综述看清技术与落地的距离
AgentClinic:医疗 AI 能否问对问题、找齐证据?
我是 AI 向先生,持续分享医学 AI 论文解读与工程实践。关注同名公众号,一起讨论技术怎样进入真实工作。