ARTICLE · 1262348
#74期:AI认知地图|模型训练与微调:AI的性格是怎么被塑造出来的
00 路标
为什么有些AI用起来很顺手,有些总觉得差点意思?很多人以为是模型不够强。但真正的原因,往往出在模型造出来之后,它被怎么教、被教了什么、被要求成为什么样的助手。
不同的AI,风格差异很明显。一个简洁直接,一个详细展开;一个分点列述,一个讲故事。它们用的底层技术大同小异,为什么表现如此不同?
差别主要不在架构,而在训练过程中的两个阶段:预训练和后训练。预训练决定模型的知识底子有多厚,后训练决定模型好不好用、听不听话。
过去几年,行业的注意力都在预训练上。比的是谁的数据多、谁的参数大、谁的算力强。但到了2026年,预训练的红利正在耗尽,后训练成了新的竞技场。它决定了模型能不能真正解决你的问题。
今天探讨三个问题:
• 预训练和后训练,各自在做什么?
• 2026年,后训练发生了哪些变化?
• 这些变化对普通用户意味着什么?
01 大模型的训练是怎么回事
大模型本质上是一个函数。给它输入,它给出输出。
但这个函数不是程序员一行行写出来的,是从数据里学出来的。
让这个函数从随机输出变成合理输出的过程,就是训练的过程。
一开始,模型对输入给出的是随机结果,没有任何意义。
训练的方法,是给它看大量例子,让它不断调整内部参数,让输出越来越接近正确答案。看过的例子越多,调得越准,模型的表现就越好。
实际训练要分两步走。
预训练:让模型学会语言本身:语法、知识、常识、推理。
后训练:教它怎么和人打交道:听懂指令、按要求输出、拒绝不该做的事。
预训练决定了模型的知识底子有多厚,后训练决定了模型好不好用、听不听话。接下来两章,我们分别来看这两个阶段在做什么。
02 预训练:模型的底子是怎么打下的
预训练做的事情很朴素:给模型看海量的文本,让它学会预测下一个词。
这个过程不需要人工标注。互联网上的文章、书籍、代码、对话,都可以拿来用。如今,图像、音频、视频也加入了进来,多模态模型看得懂图片、听得到声音的能力,同样来自这个阶段的预测训练。模型在反复预测下一个词的过程中,逐渐学会了语法、常识、逻辑,甚至一些推理能力。
预训练的数据规模有多大?头部模型的训练数据通常在数万亿到数十万亿token(词元)之间。GPT-6 Astra的训练使用了超过10万块GPU,是有史以来最大规模的训练项目。
但预训练有几个问题。
第一,成本极高。建设1GW算力的成本约为500亿到600亿美元。训练一个前沿模型,电费、芯片、网络互联,每一项都是天价。小米的MiMo大模型训练过程中,每小时的成本超过20万元。
第二,极度耗时。训练一个前沿大模型,通常需要几周到几个月的时间。动用上万张显卡连轴转几个月,是现在的常态。
第三,数据正在耗尽。公开可用的高质量训练数据已经接近枯竭。继续扩大预训练规模,投入产出比在下降。
所以,预训练决定了模型的知识范围和泛化潜力,但它不会教模型怎么和人对话。一个预训练完成的模型,就像一个知识渊博但不太会聊天的学者。你问它问题,它可能会续写你的问题,而不是回答它。
让模型变得可用、好用,是后训练。
03 后训练:教模型怎么做事
后训练是一个统称,包含了多个步骤。不同公司的流程不完全一样,但它的核心目标只有三个(见文末参考来源):
• 行为对齐:让模型按照指令行事,而不只是续写文本。
• 偏好对齐:让模型的输出符合人类的偏好——有用、无害、诚实。
• 能力激活:激发模型在推理、代码、数学等特定领域的潜力。
为了实现这三个目标,行业内通常采用三步走的流程。不同公司的具体方法有差异,但核心逻辑是相通的。
3.1 监督微调
喂给模型大量的问题与答案的示范,让它学会按照指令回答。比如你问“帮我写一封请假邮件”,模型需要学会输出一封完整的邮件,而不是续写“帮我写一封请假邮件”这句话。
这一步用的是人工整理的高质量数据。Nemotron 3 Super在监督微调阶段使用了700万条样本,从4000万条的语料库中筛选出来。
微调:泛指预训练之后的整个后训练流程;业内也有人只把其中的监督微调叫作微调。
3.2 偏好对齐
让模型学会分辨什么样的回答更好。同样是回答“怎么做西红柿炒鸡蛋”,一份详细的分步说明和一份笼统的概述,人类更偏好哪一个?模型通过大量这样的偏好对比,学会输出更符合人类期待的内容。
数据量级通常在几万到几十万条人类偏好对比,但它的算力开销比监督微调更大,因为需要同时跑多个模型(比如奖励模型和策略模型)。
3.3 强化学习
这一步最复杂,也最重要。它的基本方法是给模型一个目标,不给标准答案,让它自己去尝试,做对了给奖励,做错了不给。通过反复试错,模型能发现训练数据里没有的新解法。
不需要海量的人工标注数据,但它最耗算力。因为它需要模型不断生成、打分、更新,算力消耗在整个后训练中通常占大头。
奖励模型:让模型阅读成对的回答,学会判断哪一份更好,并给出分数。
小结
三个阶段各司其职。监督微调完成了行为对齐,偏好对齐完成了价值观塑造,而强化学习则完成了能力的深度激活。后训练做得好不好,直接决定了用户拿到手里的模型好不好用。
这三步是后训练的通用框架。但在实际工程中,不同公司、不同模型的流程并非完全死板。有的是先做监督微调再做强化学习,有的会让两个步骤交替进行,有的则尝试跳过偏好对齐、直接进行强化学习。框架是不变的,具体怎么组合,取决于模型要解决什么问题。
后训练花费的算力,已经占到了模型总训练算力的很大比例。后训练的时间不像预训练那样以月计,但也不短。从数据准备到训练完成,往往需要几天到几周。而且时间的大头不在训练本身,超过60%花在数据准备上。清洗、标注、筛选高质量示范,这些工作极其消耗专家的人力和时间,是整个流程里最慢的一环,比单纯跑模型要慢得多。
04 2026年的变化:强化学习成为主角
后训练的三步流程没有变,但2026年发生了一个根本性的转折:强化学习成了绝对的主角。因为监督微调和偏好对齐撞到了天花板。
前面讲过,这两步极其依赖人工。人类要花大量时间去写标准答案,去给回答排序。但现在,高质量的人类数据正在耗尽,而且人工标注又贵又慢,根本喂不饱越来越庞大的模型。
强化学习改变了这个局面。它不需要人类去写答案,只需要给模型设定目标(比如数学题对不对、代码能不能跑通),让模型自己去试错。
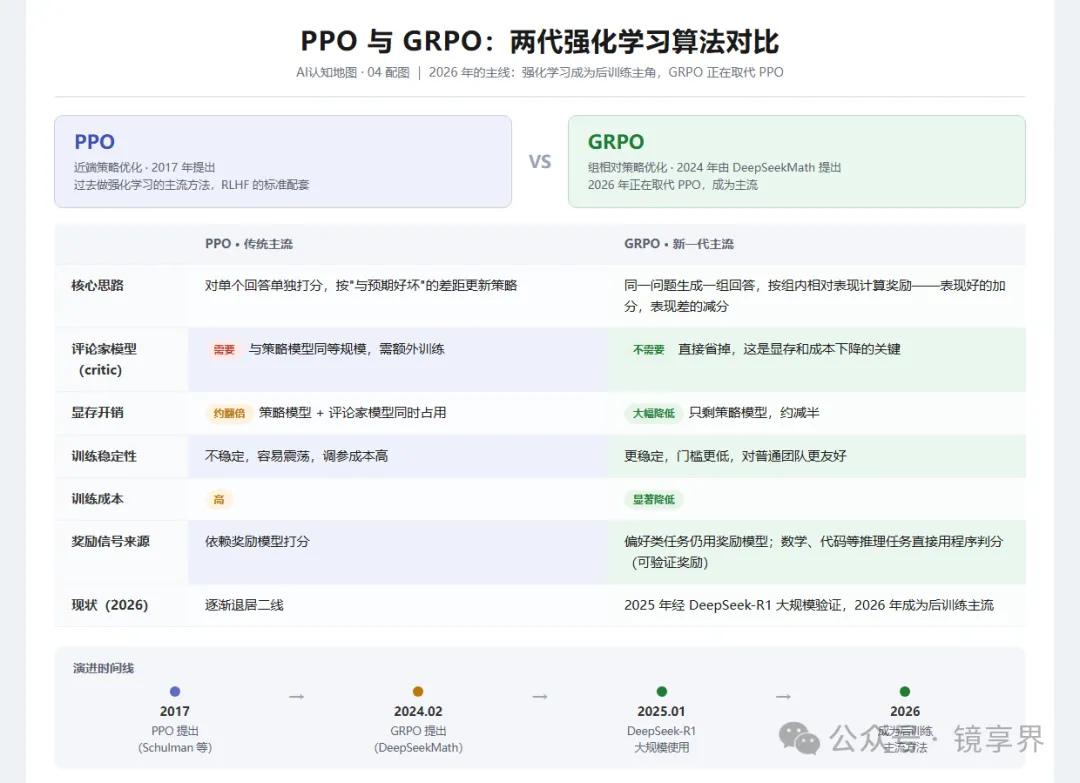
过去做强化学习,主流方法是PPO。它需要额外训练一个与策略模型同等规模的评论家模型(critic)来评估当前策略的好坏,显存占用翻倍,训练不稳定。对于大模型来说,成本太高。
2026年,GRPO正在取代PPO,成为主流的强化学习方法。核心思路是对同一个问题,让模型生成多个回答,然后比较这些回答的得分,用组内相对表现来计算奖励。表现好的加分,表现差的减分。它省掉了庞大的评论家模型,显存占用大幅降低。
GRPO之后,又出现了DAPO、RLVR等方法,解决训练稳定性、奖励设计等具体问题。
这些方法的名字不需要记住。以前强化学习主要用来让模型说话更礼貌、更安全。现在,它被用来提升模型的推理能力、代码能力、工具调用能力,同时解放人力。
与此同时,监督微调和强化学习的关系也在变化。过去是先做监督微调,再做强化学习。现在出现了混合训练的方法,把两种信号交织在一起,让模型在学习示范的同时探索新解法。2026年,清华团队在统一框架方向持续输出进展,从数学上证明了监督微调和强化学习本质上是同一个优化目标的不同侧面。
05 核心挑战
后训练的重要性在上升,但它面临的挑战也在增加。
5.1 成本压力
后训练的算力开销在持续增加。强化学习需要模型反复试错,每一次试错都要消耗算力。如何在有限的预算内获得最大的能力提升,是每个团队都要面对的问题。
5.2 数据瓶颈
高质量的人类标注数据越来越贵,而且覆盖面有限。合成数据正在成为替代方案,但合成数据有自身的风险,模型会放大训练数据的偏差。
5.3 评测困难
后训练的效果很难精确衡量。同一个模型在不同评测集上的表现可能差异很大。
评测集,可以是数学竞赛题(如 AIME)、代码竞赛题(如 SWE-bench),也可以是覆盖多学科的选择题库(如 MMLU)。模型在这些题上的得分,反映的是它某一时刻的能力快照,而不是稳定的能力本身。
如何判断一次后训练是真正提升了能力,还是只是让模型更擅长应付评测,目前尚没有标准答案。
06 未来趋势
强化学习继续扩大应用范围:从数学推理、代码生成,扩展到工具调用、多步规划、Agent任务。未来,强化学习可能成为训练所有复杂能力的默认手段。
自动化数据飞轮:模型部署后,用户的每一次使用都在产生数据。这些数据会先由大模型自动进行筛选和打分,只有少量难点才交由人工校准,然后回流到下一轮训练中。用得越多,模型越强。这个循环一旦跑通,模型的迭代速度会大幅加快。
训练和微调的边界在模糊:过去,训练是一次性的,模型发布后就不再更新。现在,持续学习正在成为趋势。模型可以在部署后继续学习,根据新的数据和反馈不断调整。未来,模型发布只是一个快照,训练和迭代是持续进行的。
但比这些延伸更根本的变化,是后训练的目标正在改变。
过去,后训练是教模型模仿人类。人类给示范、给反馈,模型照着学。但人类数据正在耗尽,而且模仿最多只能达到人类水平。
下一站,是让模型在环境中自己学。这条路上有两个技术路标,一个已经到来,一个还在前方:
一个是推理时自我调整。模型在回答问题的当下,用更多的计算把问题想得更深、更久,好像它真的在思考。这个即时发挥的能力已经被业界视为继预训练、后训练之后的第三个阶段,且已越来越普及。
另一个是持续学习。模型在部署后,利用新的数据继续更新自己。这个还在探索期,离真正落地还有距离。
07 与你我有关
模型训练与微调,对普通用户的影响是间接但实际的。
你用的AI,性格是被设计出来的。不同产品的风格差异,很大程度上来自后训练阶段的不同选择。有的更严谨,有的更活泼,有的更注重安全,有的更注重效率。
但设计不止发生在训练阶段。产品给模型写的人设提示词、回答时的随机度设置、产品团队事后加的过滤层,都在塑造你实际感受到的风格(AI的性格形成参看#39期)。
#39期:AI创意 | 九款AI的“人格漂移”:讨好、内耗、敷衍……AI的性格也会变?
开源模型让定制变得可能。在开源模型上,用少量数据做微调,就能让模型学会一个特定领域的技能。开源模型加上微调,已经能在特定任务上超过通用大模型。这意味着,未来会有越来越多针对特定场景、特定行业的小模型出现(小模型的压缩与蒸馏,参看#56期)。
#56期:AI认知地图 | 端侧AI:AI是怎么从云端走进你的设备?
你也在参与训练。当你使用AI产品时,点赞、修改、重试,所有反馈都在成为训练数据的一部分。模型越用越好的背后,是大量用户行为在持续回流。
08 溯源与结语
2018到2022年:预训练规模决定模型能力,GPT系列验证了规模化法则。
2023年:监督微调和RLHF成为标准流程,模型从能用变成好用。
2024年:GRPO等方法出现,开始替代RLHF中的PPO,强化学习门槛降低。
2025年:合成数据开始大规模用于后训练,数据飞轮概念被广泛讨论。
2026年:强化学习成为后训练的主力,混合训练方法从学术走向工程。
模型训练与微调的故事,是一个重心从预训练转向后训练的故事。预训练给模型打下了知识底子,后训练决定了模型的能力上限和性格特征。当预训练的数据和成本都接近极限时,后训练成了新的竞技场。
对我们普通用户来说,你用的AI会越来越懂你,因为后训练在持续优化。但同时,AI之间的风格差异也会越来越大,因为后训练的选择正在变得多样化。
参考文章:
后训练目标,引用:《大模型后训练全解:SFT、RLHF/PPO、DPO 的原理、实践与选择》,作者:koharu123
文章链接:https://jishuzhan.net/article/2046509977091768322
(作者声明:本文由作者确定核心观点与文章架构,负责文稿撰写及最终定稿,DeepSeek和豆包AI协助素材收集、草稿片段生成及问题证辩。文中信息与数据基于截至2026年9月的公开资料。文中铜管乐插图由作者构思,豆包AI协助生成。)