ARTICLE · 1267791
OpenClaw办公实测:首轮检查全过,更新数据后却漏算了
我们把一组合成项目材料交给OpenClaw:17行订单、两版会议记录,要求它核对金额、整理行动计划,并附上复算脚本。从提交命令到返回用了37.8秒,当前成品的13项预设检查全部通过。
随后,在原始数据的副本里补上一条更晚的有效记录,再运行它交出的原脚本:按既定口径应得525元,实际仍是420元。曾有冲突、如今已被新快照修正的订单,依旧被排除。
105元是测试中的模拟差额,没有真实财务损失。这个案例要回答的问题是:Agent交付正确的当前结果之后,随包脚本能不能接住下一次更新?
先看它交对了什么
任务包只有三类输入:订单CSV、旧版和新版会议记录、写明验收口径的说明。姓名、项目和金额均为本号自建示例,不是客户记录。
订单里有完全相同的重复行、退款、未付款、取消、晚于截止时间创建的记录,还有同一订单在同一更新时间下金额不同的冲突快照。规则是按订单ID取最新快照,金额按币种分别计算;不能确定的记录排除并保留原因。
OpenClaw交回了三份成果:金额与订单归属、上线时间与行动计划、附来源和异常说明的交付报告。另有一份Python复算脚本,只用标准库,没有安装额外依赖。
首轮数字正确:人民币净额420元、美元80元、欧元30元。14个不同订单ID被完整分成8个计入和6个排除,没有把币种混加。有效的全额退款订单留在结果里,净额为零;缺金额、退款超额、快照冲突等情况都有标注。
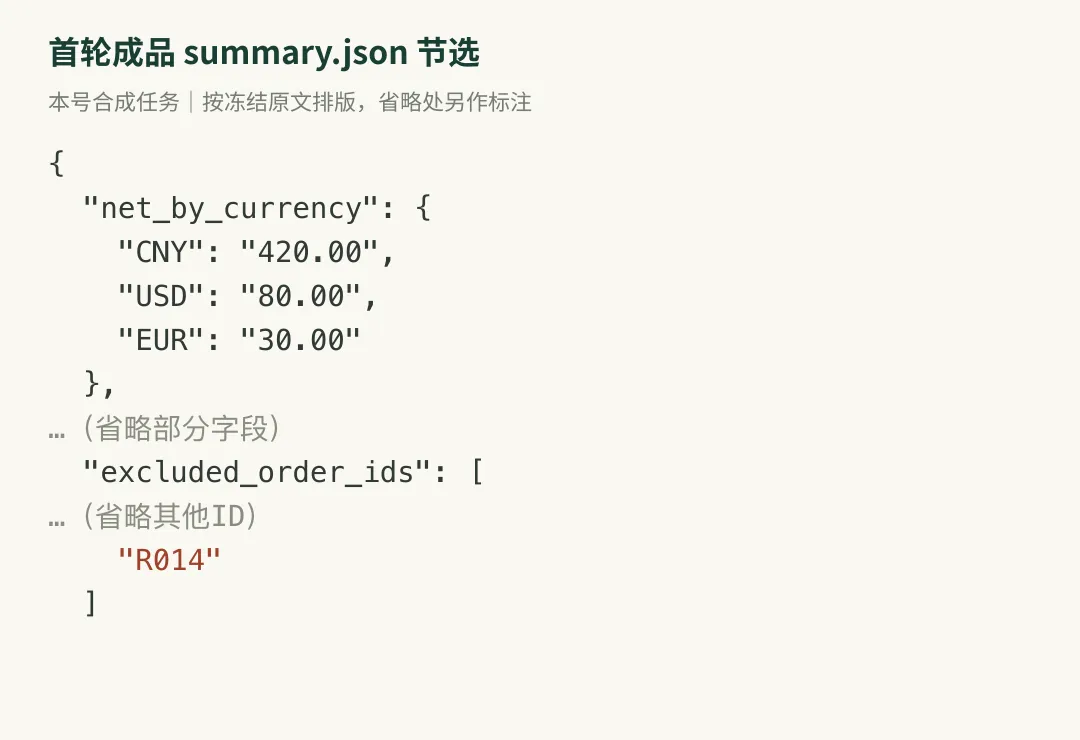
根据本号冻结成品排版的节选,省略部分字段和订单ID;不是官方产品界面。
会议记录的取舍也正确:采用10月27日新版,把上线时间更新到10月30日14:00。旧版讨论的5000元没有被写成已批准预算,未确定的客服负责人也没有被补上一个人名。
这些判断来自独立验收脚本,不是Agent的自评。13项覆盖文件、三币种金额、订单完整分区、异常、最新计划、负责人和时限、未知信息、来源、复算脚本文件存在、原始输入未被修改。这里的“脚本存在”不等于“脚本已经通过复用测试”。
两份更新,各跑一次
首轮结果出来后,我们追加了两种变化,分别放进原始数据的两个独立副本。检查B没有继承检查A新增的订单,也没有再次调用模型。
这两项属于看过首轮结果后的探索性检查,不是事先固定的主测项;每项的预期值在运行副本之前写下。原始输入、成品和脚本均未覆盖。
检查A新增一笔正常订单:人民币10元、已付、没有退款。预期汇总从420元变成430元。脚本输出430元,新订单也进入计入列表,通过。
检查B处理的还是原来的R014。它在14:00有两条互相冲突的快照,金额分别为100和105,所以首轮被排除。现在追加一条15:00的有效快照,金额105元。按“取最新快照”的原规则,这个订单应重新计入,汇总应变成525元。
脚本正常退出,却仍输出420元。R014继续留在排除列表里,理由还是14:00的快照冲突。
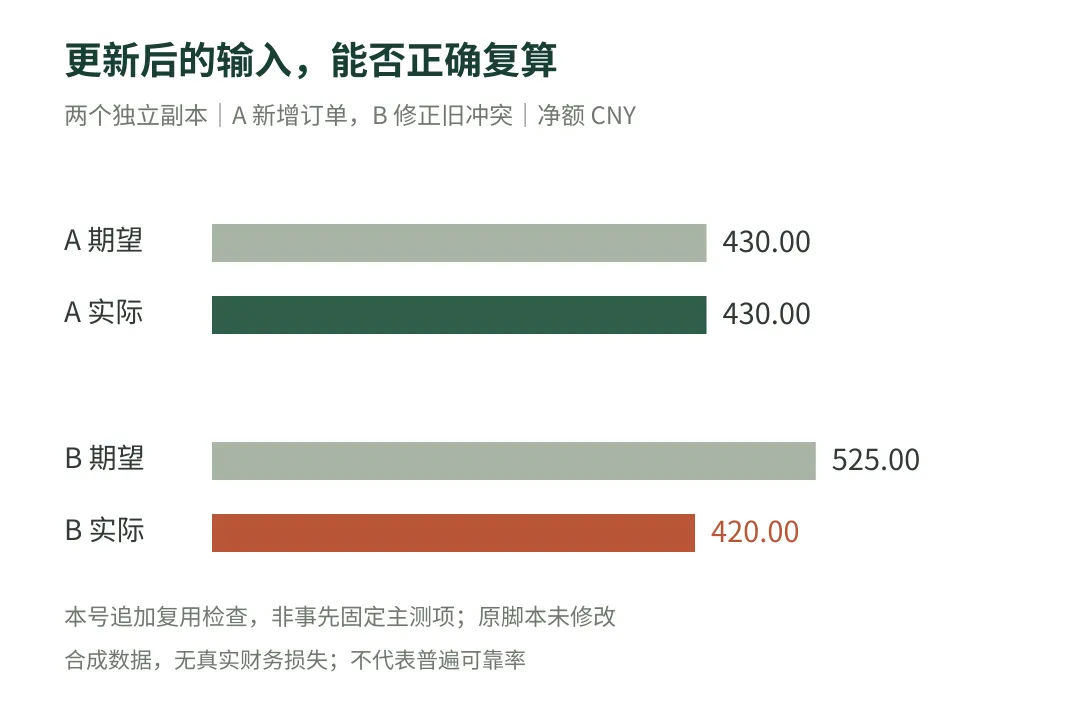
两个独立副本上的本地复用检查;金额为合成数据。A新增订单,B修正旧冲突,不代表普遍可靠率。
旧的排除状态没有清掉
问题可以在原始代码里定位:脚本一边保存每个ID的最新记录,一边用一个集合记住发生冲突的ID。
遇到更晚的快照时,程序更新了记录,却没有同步清除旧的冲突标记。到了汇总步骤,只要ID仍在这份名单里,就被排除。于是,最新数据有效,旧状态仍然生效。
一个修正思路是在确定最新时间之后,只检查该时间对应的记录是否冲突;也可以在更晚快照覆盖旧记录时,同步更新冲突状态。这是编辑给出的修复方向,本次被测脚本的原件没有被改好后再拿回来充成绩。
这也解释了两种变化为什么结果不同:新增一个ID不必处理历史状态,修正旧ID则需要正确处理先前留下的标记。当前答案正确,未必已经覆盖这条更新路径。
验收从当前结果延伸到下一版输入
这次任务里,多文件核对、按最新纪要整理计划、保留未知信息,都得到了可用的当前成果。若工作止于这一份材料,首轮结果有价值。
如果交付物还包括一个准备长期使用的脚本,验收就要再往前走一步:给它一份更新后的输入,核对那些曾经被排除的记录能否恢复资格,确认异常状态会随数据变化。
不必一开始就准备很大的测试集。可以先保存原始输入和首轮结果,再加入一个正常新增样本、一个会改变旧判断的样本,分别运行并独立复核。一次性整理和持续更新,需要检查的路径不同。
测试范围与记录
被测环境为OpenClaw 2026.10.4,使用既有MiniMax-M3.1-Flash-Preview路由。一次新会话、一个任务包,包含三个办公子任务,N=1;没有横评其他模型,运行中没有追加提示。追加检查只执行本地脚本,未重跑模型。
37.801秒是命令的墙钟时间,包含工具执行,不是纯推理时长。没有人工完成同一任务的耗时对照,因此不换算“省下多少工时”。
网关报告input 24,413、output 4,178、cacheRead 190,121、total 218,712。字段按原口径保留;缓存读取和新增输入分开看。没有实际结算账单,不把报告中的成本估算写成Coding Plan实付金额。
这份小样本不能给所有Agent排可靠性名次。它留下的是一条可复核的经验:验收当前成果之后,还要用会改变旧判断的新数据,验收交付脚本的更新能力。
AI翻车实验室|AI深度测评与科技观察
本篇由AI辅助执行、整理与编辑。任务输入、首轮原始成品、独立验收及两项追加记录均由本号留存;图像来自本号自建合成测试资料。
方法参考
Car and Driver|按用途和可比条件评测https://www.caranddriver.com/about/a60870944/how-car-and-driver-rates-vehicles/
RTINGS|统一测试材料与披露限制https://www.rtings.com/laptop/learn/how-we-test
Simon Willison|执行并验证AI生成代码https://simonwillison.net/2025/Mar/11/using-llms-for-code/