ARTICLE · 1271002
当 AI 能够完成软件工程,我们还需要怎样做研发?
引
言
【邰晓梅】:我本月中旬 Coach 的 OPC+SGE+BMAC 试点项目,基于回顾会上分享的内容整理的文章,分享给大家。
2026-10-28
当 AI 能够完成软件工程,我们还需要怎样做研发?
星 期 三
一、一个困惑:人人都在用 AI,为什么研发效率仍然上不去?
1.1 回顾会上的疑问
最近又做了一次 OPC+SGE+BMAC 的 Coaching 辅导,
我和两个人员(BA+Dev)结对,在一个既有、开源项目 DataEase 的基础上,从头开始端到端交付一个真实的需求。
这是他们团队首次做OPC (我把 OPC 定义为 One-Person-Cell 1人或小型工作单元)+ SGE (语义治理工程)+ BMAC (海盗派AI研发新范式)的试点。
“我们团队每个人都在用 AI 提效,但总感觉整体效率还是上不去。” 在试点项目的回顾会上,一位参与者开场就提出这个困惑。
需求人员借助 AI 写规格,开发人员用 AI 写代码,测试人员用 AI 生成用例。每个岗位都可以展示产出速度的提高,但一旦回到完整交付链条,等待、沟通、返工、质量争议并没有自动消失。
回顾会上还提出另外几个当下遇到的难题:
AI 可以快速生成大量文档,怎样知道哪些可信? 环节之间交接时,如何保证输入质量? 同一套模型和 Skill,为什么不同人使用效果差别很大? 个人经验又如何变成组织能力?
1.2 一个真实的图表需求,怎样从“文档写好了”走向反复返工?
试点团队曾经需要处理一个涉及柱状图、折线图组合展示的需求。
我们这次结对Coaching就是把这个曾经做过的需求,采用新的模式重新做一次,以方便事后团队进行研发过程的对比和改进。
在本次结对Coaching之前的这个需求的开发过程先简单了解一下:
团队对存量开源项目了解有限 需求人员主要参考现有文档和外部产品资料,再借助 AI 整理出一份很长的需求说明 BA当时觉得需求的描述已经足够细致:组件怎么改、如何配置、展示细节都有涉及 进入开发后,才发现原方案对现有图表实现的改造代价较大 经过多轮沟通,团队改为基于现有柱状图做相对较小的修改 开发完成后,测试又发现颜色配置、位置等细节没有充分覆盖 继续调整又意味着新的返工 最终在交付压力下,团队放弃了部分原定的折线图修改,回到更保守的实现路径
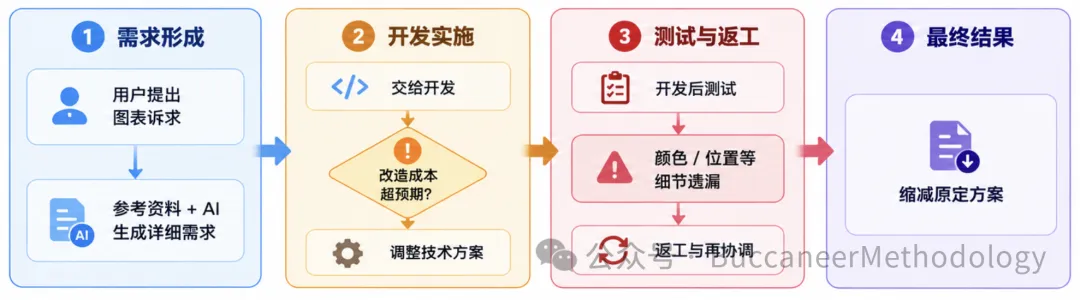
当 AI 把“生产一份文档”变得非常容易时,真正稀缺的就不再是文档生成速度,而是共同理解,准确判断和可信验证。与可信验证。缺的就不再是文档生成速度,而是共同理解、准确判断与可信验证。局部提效不等于端到端提效,这正是三天 Coaching 想探索的起点。
二、一张图的解读:从 AI-Enabled 到 AI Native
过去很多 AI 赋能项目仍然围绕传统软件工程岗位开展:
BA 希望 AI 更像一个资深 BA 开发希望 AI 更懂编码规范 测试希望 AI 模仿资深测试专家 大家投入大量精力编写提示词和 Skill,试图把自己的经验传授给 AI
这当然有价值,却也可能陷入一个“抛接式”的工作循环:AI 的输出不够好,就继续补充旧岗位的操作规则;产出更多了,交接结构却没变。
BA 把文档交给开发,开发把代码交给测试,前后环节仍可能对“到底要做什么”有不同理解。
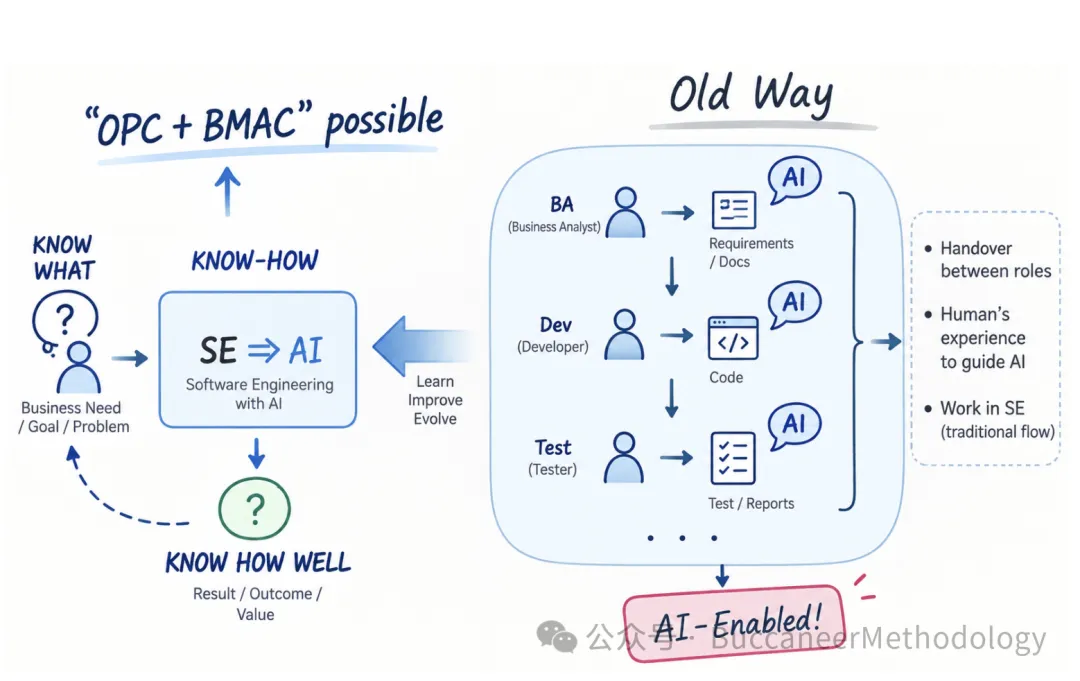
这张图来自 DataEase 三天 Coaching 实践中我的一次思考,试图回答一个关键问题:
当 AI 已经具备独立完成大量软件工程任务的能力,我们是否还需要沿用传统的软件工程分工,只是在每个环节引入 AI 来提高效率?
图的右侧是 Old Way(传统方式),左侧则代表一种新的可能:通过改变人和 AI 的工作分工,让 OPC(One Person Company / 一人责任单元)与 BMAC(海盗派 AI Coding)成为可能。
2.1 右侧:Old Way——AI 赋能传统软件工程
传统的软件研发通常采用分工协作、逐级交付的方式:
BA(业务分析师)负责需求分析,输出需求文档。 Developer(开发工程师)负责设计和编码,输出软件。 Tester(测试工程师)负责验证,输出测试报告。
这些角色通过文档、代码和测试结果完成工作交接(Handover)。
当 AI 出现之后,我们通常的做法是什么?
让每一个角色都使用 AI,更高效地完成自己原来负责的工作。
BA 使用 AI 编写需求文档,Developer 使用 AI 辅助编码,Tester 使用 AI 生成测试用例。
为了让 AI 做得更好,我们还会不断地把人类积累的软件工程经验传递给 AI,例如设计 Prompt、编写 Skill、制定规范和流程。
这就是图右侧的三个特点:
① Handover between roles:仍然依赖不同角色之间的工作交接。
② Human’s experience → AI:试图把人类已有的专业经验传递给 AI,让 AI 按照传统软件工程的方法工作。
③ Work in SE:人的主要工作仍然处于 Software Engineering(软件工程)的各个专业环节中。
这种模式确实能够提高局部效率,但它没有改变软件研发的基本组织方式。
需求、开发、测试之间仍然存在交接成本、理解偏差和信息损失。每个环节的局部效率提升,也不一定能够转化为端到端的整体效率提升。
这就是 AI-Enabled:AI 增强了传统软件工程,但没有改变传统软件工程的基本范式。
2.2 左侧:New Way——重新定义人和 AI 的工作分工
图的左侧提出了一种不同的思路。
如果 AI 已经能够承担需求分析、设计、编码、测试等大量软件工程工作,我们为什么还要让人继续按照这些专业环节分工,再逐个指导 AI 完成任务?
是否可以把整个 Software Engineering(SE)的执行过程交给 AI?
图中间的方框 “SE ⇒ AI ”,代表的正是这一变化:软件工程中的大量 Know How(如何做),可以由 AI 承担。
人的工作重点则转移到两个方向。
第一个方向:Know What——明确到底要做什么。
人需要理解问题、探索需求、确定目标、识别约束、明确范围,并做出关键决策。
例如,在 DataEase 实践中,我们没有直接拿到需求文档就让 AI 编码,而是先理解存量系统,再通过 AI 反向提问,澄清了 156 个需求问题。
这项工作并不是在教 AI 如何写代码,而是在确保:
人和 AI 对“究竟要完成什么”具有一致且足够准确的理解。
第二个方向:Know How Well——判断做得怎么样。
当 AI 完成任务后,人需要判断结果是否符合目标、是否满足质量要求、是否真正创造了预期价值。
这里的关键不是人必须亲自测试代码,而是人必须知道应该如何判断结果的质量。
具体的测试设计、执行、验证和证据收集,同样可以交给 AI 完成。
但最终的质量标准、关键风险接受以及是否可以交付,仍然需要由具备相应责任和权限的人来判断。
因此,新的工作分工可以概括为:
人重点负责 Know What 和 Know How Well,AI 重点承担 Know How。
需要强调的是,这并不意味着 Know What 和 Know How Well 必须由人独立完成。
恰恰相反,人同样可以与 AI 共同探索问题、澄清目标、设计验收标准。
真正的区别在于:人不再需要亲自执行软件工程中的每个专业环节,而是对整个任务的目标、方向、质量和最终结果承担责任。
2.3 为什么这种转变使 OPC + BMAC 成为可能?
传统的软件研发需要多个专业角色协作,一个重要原因是不同角色掌握着不同的专业 Know How。
业务分析师可能不懂代码,开发工程师可能不擅长需求分析,测试工程师则拥有专门的质量验证技能。
但当 AI 能够承担这些专业工作时,个人的能力边界就发生了变化。
一个不擅长编程的业务分析师,可以通过 AI 理解代码、调查技术实现、完成开发和测试。
一个开发工程师,也可以借助 AI 深入开展需求分析、业务建模和验收设计。
这意味着:
一个人可以不具备全部专业执行技能,却有可能对更大范围的端到端成果承担责任。
这正是 OPC 的重要基础。
而 BMAC 则为这种新的人机协作方式提供实践方法:不再要求人按照传统软件工程的专业分工亲自完成各项工作,而是让 AI 承担更多执行任务,人通过问题探索、目标定义、判断、反馈和持续改进来驱动工作。
当然,这并不意味着只要拥有一个强大的 AI 模型,OPC 就能够自然运转。
这里还有一个非常关键的前提。
2.4 图中尚未展开的关键:为什么还需要 SGE?
如果我们直接把整个 SE 交给 AI,会发生什么?
AI 可能不了解当前项目的真实情况,可能依据过时的文档做判断,也可能误解需求、擅自扩大任务范围,或者在长程执行过程中逐渐偏离最初目标。
所以,SE ⇒ AI 并不意味着可以无条件地相信 AI。
要让 AI 可靠地承担端到端的软件工程工作,还需要建设一层新的基础设施:SGE(Semantic Governance Engineering,语义治理工程)。
它至少需要解决三个问题:
1. Know Where:AI 是否真正理解自己的工作世界?
通过知识库(KB)等机制,让 AI 理解项目、代码、业务规则、权威信息以及尚未解决的问题。
2. Know Which Way:AI 是否知道应该以什么方式工作?
通过 SGE 治理 AI 的工作行为,包括任务范围、信息权威性、决策依据、独立审查、质量验证、证据留存以及完成门禁。
3. Continuous Improvement:如何让 AI 越来越可靠?
通过 海盗派的2个重要技能 PDI (Problem Driven Improvement)和 PRE (Practice-Reflect-Explicate),不断发现问题、分析原因、改进工作机制,并把有效经验沉淀为可复用的 Skill 和治理规则。
这也是 DataEase 三天 Coaching 实践中最重要的探索之一。
我们并不是简单地让 AI 完成一个开发任务,而是尝试建立一个能够支撑 AI 持续、可靠执行任务的工作环境。
2.5 这张图真正想表达的认知转变
从右侧走向左侧,并不是简单地减少研发人员,也不是否定软件工程专业知识的价值。
真正发生变化的是:人的专业能力应该用在哪里。
在 AI-Enabled 模式下,人主要思考:
我怎样把自己的专业工作做得更好?怎样教 AI 帮我完成这项工作?
而在 AI Native 模式下,人开始思考:
我究竟要解决什么问题?怎样让 AI 可靠地承担整个任务?我如何判断结果是否足够好?怎样让这种能力持续进化?
这是一种从专业任务执行者(Executor)向端到端成果负责人和 AI 协作者(Orchestrator)的转变。
它不仅改变个人的工作方式,也为重新设计研发团队的组织结构创造了条件。
过去,一个团队可能需要依靠多个专业角色之间的接力来完成一个项目。
未来,一个或少数几个人组成的 OPC 单元,有可能借助 AI 和语义治理基础设施,对一个完整功能、一个系统,甚至多个系统承担端到端责任。
但这是一种需要通过持续实践验证的组织演进方向,而不是仅凭三天试点就能证明的普遍结论。
2.6 核心结论
AI-Enabled 是让 AI 参与传统软件工程;
AI Native 则是重新设计人和 AI 的工作分工,因为在AI Native的组织中,AI已经成为最重要的基础生产力和协作者。
前者主要提升各个专业环节的局部效率,后者则尝试突破传统专业分工和工作交接对端到端交付效率的限制。
当 AI 能够承担越来越多的 Know How,人的价值并不会因此消失,而是进一步转向 Know What、Know How Well,以及建设和持续改进 AI 协作基础设施。
这正是 OPC + BMAC + SGE 所探索的方向:让人从软件工程的具体执行中逐渐解放出来,成为能够驾驭 AI、对更大范围成果负责的人。
这张图也因此提出了一个值得所有研发人员和管理者思考的问题:
我们今天是在教 AI 更好地完成过去由人承担的工作,还是已经开始重新设计 AI 时代的研发工作方式?
三、真实实践:从陌生 DataEase 仓库走到首个开发切片
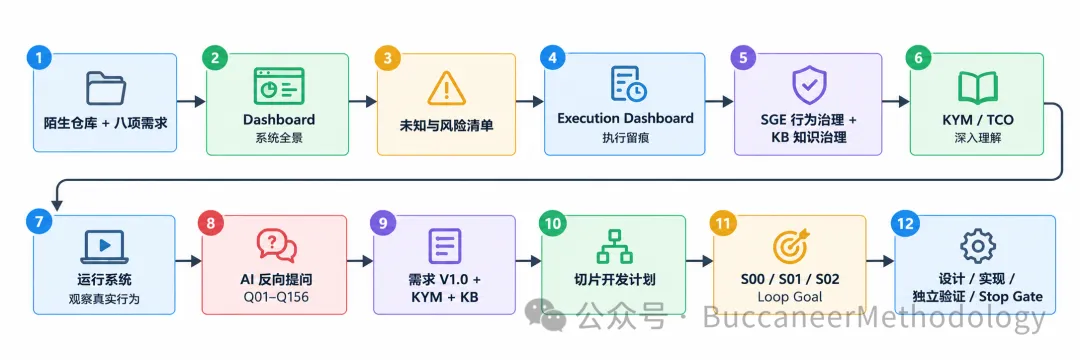
这次试点的输入很朴素:一个我此前并不熟悉的 DataEase 开源仓库,以及一份包含八项仪表盘功能(F01–F08)的需求材料。
在三天的Coaching里,我们主要通过与 AI 对话、检查执行过程、纠正偏差和进行关键裁决来推动工作,而不是自己逐行读代码、亲手编写需求与测试。
回顾会展示了约 14 个工作线程,开发计划被分成约 11 个 Slice,前三个 Loop Goal 对应 S00、S01、S02。
第三个 Goal 涉及首个功能实现,在回顾会时已进入独立验证,但 Stop Gate 尚未通过。
因此,这个案例证明的是一条端到端工程路径已被推进到实现验证阶段,而不是“三天完成全部八项功能”。
下面按照这个流程图,简单讲解一下Coaching的实践过程。
3.1 先理解工作的世界:全景与未知同样重要
代码持续演进,文档却可能停留在旧版本。
我们首先使用海盗派开源的 $ExplorationDashboardSynthesizer skill 让 AI 生成系统的全景图 Dashboard,把仓库的主要领域、模块和关联梳理出来。
第一版 Dashboard 并不够细致,于是挑选部分主题继续深入。
这里的 Dashboard 不是最终答案,而是帮助人和 AI 建立共同地图的起点。
接下来又单独整理未知问题和风险清单。
一个系统的认知面,不只是“已知的事实”,还包括“哪些还不知道、哪些可能有冲突、哪些需要补证”。
如果 AI 只记录正确答案而不记录未知,就很容易把猜测当成事实。
3.2 将聊天记录变成有序执行状态
当对话越来越多,新的问题出现了:关键决定散落在聊天里,下一次 AI 执行任务时究竟该相信哪一条?
于是我们开始使用海盗派开源的另外一个 $dashboard-governance-skill 建立 Execution Dashboard,将 Big Ideas、Sessions、目标、决策、证据和下一步行动有序落盘。
聊天仍可参考,但不再被视为唯一的执行真源。
随后使用另外一个海盗派开源的 $sge-governance-skill,约束 AI 的任务接收、输入检查、Review、证据留痕和阶段门禁。
这里有两类不同的治理:执行面记录“做过什么、目前在哪里”;行为治理规定“AI 应该如何做、何时必须停止”。
3.3 治理知识:不是把所有文档都塞给 AI
旧文档可能过时,探索性讨论可能尚未定稿。
试点采用 Doc-as-Data 的思路,将经过核实的知识结构化存储(实践中主要使用 JSON),并区分权威知识、过程信息与参考材料。
格式本身不保证正确;来源、权威级别、验证状态和更新机制才决定它能否作为执行依据。
这里我们采用的 $doc-system-kb-builder-skill,这个skill 我也开源了,它可以将代码变化后相应的增量知识自动演进,而不是让知识库再次变成历史文档仓库。
注:关于海盗派这些skills,可以参阅历史文章、或文末的附录链接进行查阅。3.4 KYM / TCO 与真实运行:让理解逐层加深
初步全景之后,我们又使用海盗派另外两个skills - build-kym、build-tco-coverage - 生成更深入的系统认知视图 KYM 和 TCO。
KYM 和 TCO 是海盗派方法学的核心技能,可以结构化地呈现一个复杂产品或事物的全景。
这些视图不只是给人阅读,也是测试 AI 是否真的理解系统的一种方式。输出过于粗糙、遗漏关键依赖或者逻辑矛盾,都是继续学习和澄清的信号。
然后,我们让 AI 配置环境、启动项目并观察页面实际行为。
这样,来自文档和代码的推断可以与真实运行互相校验,避免单靠竞品经验去设计与存量系统不匹配的功能。
至此,人与AI一道完成了对这个陌生仓库的学习和认知对齐,并搭建了一层很薄的语义治理基础设施(KB+SGE)。接下来,就可以关注我们本次想要开发的这个新需求了。
3.5 AI 反过来问人:156 个问题带来的震动
参与者原本认为自己的需求文档已经足够详细。
试点却没有立即要求 AI 改写文档,而是让 AI 针对八项功能逐项追问,暴露模糊、遗漏、边界和验收问题。
最终形成 Q01–Q156,共 156 项问题及相应决策记录。
参与者坦言,有些问题自己以前根本没想到,有些甚至不知道怎样回答。
其实,即使是已经实现过的功能,也一定有边界未被充分讨论。问题的价值不在于数量本身,而在于它迫使人正视以前跳过的决策。
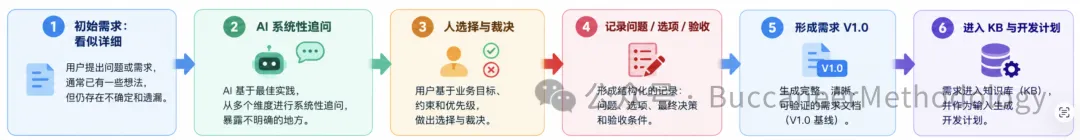
AI 不再只是需求文档的写作者,而成为需求认知的挑战者;人不必独自穷举所有问题,但仍必须对业务选择负责。
这也解释了为什么原来在开发、测试阶段才暴露的许多问题,有机会前移到需求阶段。
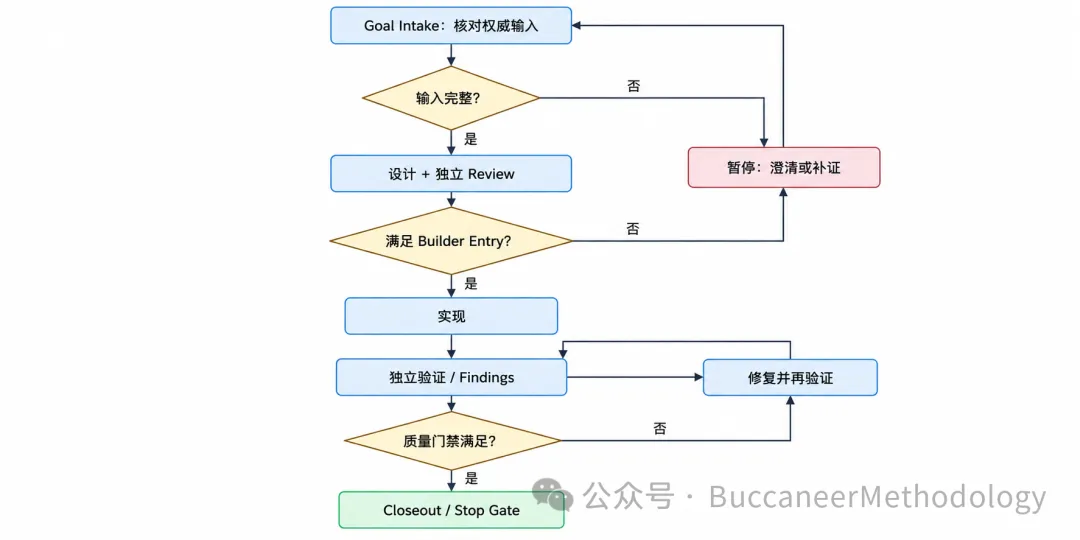
3.6 Loop Goal:一句话指令背后,是完整的工程契约
需求基线形成后,我们让 AI 生成切片计划,并为每个切片设计 Loop Goal。
这个 Goal 包含目标、权威输入及优先级、Scope / Out of Scope、工作包、验收条件、质量门禁、独立 Review、Builder 入口条件、Closeout 与 Stop Gate 等内容,也是AI帮助生成的。
Goal 的内容以及文字本身就彰显了语义治理的基本思想。
这不是形式主义。比如:
AI 可以参考 KYM/TCO 视图,但不能偏离已冻结的需求决策;
如果缺少必需的输入,就应停下来索取,而不是假装已经读过;
如果范围没有授权,就不能顺手多做;
执行过程中产生的 Review Findings、验证结果和过程证据也要有迹可循
其背后的重点在于:AI 遇到缺口会停、发现偏差会纠正、执行过程会留下证据,人才有可能减少频繁的人工介入。
一个高质量的 Goal 是AI能否稳定执行一个长程任务的重要条件之一。有了这个Goal,剩下的设计、开发、测试等执行工作就可以交给AI了。
四、一个关键发现:信息很多,不代表 AI 真正理解了项目
在 DataEase 这次实践中,我们逐渐认识到一个很重要的问题:
给 AI 提供足够多的信息,并不意味着 AI 就真正理解了这个项目。
这个问题看似简单,但它可能是当前 AI Coding 中很多问题的根源。
现在很多团队在使用 AI Coding 时,都会想办法让 AI 获得更多的项目上下文。
例如,把需求文档、设计文档、代码、历史讨论、技术规范等全部提供给 AI;或者建立知识库,通过 RAG、代码索引等技术,让 AI 能够随时检索相关信息。
这些工作当然有价值,但它们主要解决的是一个问题:AI 能不能获得这些信息?
而在真实的软件工程中,我们还需要解决另一个更困难的问题:AI 能不能正确理解这些信息,并利用它们做出符合业务目标的判断?
这两者之间存在很大的差距。
4.1 AI 为什么会在信息充分的情况下,仍然理解错误?
假设一个项目经历了以下过程:
最初的需求文档采用方案 A。 后来团队讨论,认为方案 B 更合理。 经过进一步分析,最终决定采用方案 C。 但是方案 A 的文档没有删除,方案 B 的讨论记录也仍然存在。
现在,AI 能够访问全部信息。
它确实知道 A、B、C 三个方案,但这不代表它知道应该执行哪个方案。
如果 AI 不清楚这些信息之间的关系,不知道哪个是正式决策、哪个已经被废弃、哪个只是讨论中的候选方案,就可能错误地采用 A 或 B。
更危险的是,这种错误不一定会立即暴露。
AI 可能基于错误的方案生成一份看起来很完整的设计,再生成代码,最后甚至生成一组与错误设计完全一致的测试用例。
于是出现一种很有迷惑性的现象:
代码通过了测试,但实现的并不是人真正想要的功能。
这不是传统意义上的代码 Bug,而是更上游的语义偏差。
从这个例子可以看到,AI 理解项目至少需要解决四个不同层面的问题:
| 层面 | 核心问题 | 如果缺失,会发生什么 |
|---|---|---|
这里最值得关注的是:
信息可获得性只是理解的必要条件之一,而不是充分条件。
即使 AI 拥有全部上下文,如果缺少知识权威性、语义约束和验证机制,仍然可能做出错误判断。
因此,我们不能简单地把“建设知识库”理解为“让 AI 看到更多资料”。
更重要的是,让 AI 知道:
什么是当前有效的知识? 什么是已经冻结的业务决策? 什么只是未经验证的推测? 哪些问题仍然没有答案? 当信息不足或者存在冲突时,应该怎么办?
这就引出了 DataEase 实践中一个很重要的工作:建立项目知识库 KB,并将知识治理与研发过程结合起来。
4.2 KB 的价值,不只是存储知识,而是建立可信的判断依据
在 DataEase 项目中,我们没有直接把现有文档全部交给 AI,然后立即开始开发。
而是先开展了几项基础工作:
首先,调查现有代码和文档,建立项目的初始知识库。
接着,通过 KYM(Know Your Mission)梳理项目目标、需求、约束和待解决问题,并通过 TCO(Testable Coverage Outline)组织能力与验证覆盖范围。
然后,在功能优化需求的澄清过程中,我们还对大量业务问题进行了逐项讨论,将原本分散在对话中的判断逐步转化为明确的需求决策和验收条件。
这些工作的目的,不是简单地增加知识库中的文档数量。
我们真正希望建立的是一套 AI 可以依赖的、具有明确权威边界的项目知识体系。
例如,同样是一条关于某个功能的描述,它可能具有完全不同的性质:
| 信息类型 | 典型内容 | AI 应该如何使用 |
|---|---|---|
这里有一个容易被忽略的问题:
知识是否正确,与知识是否具有决策权威,是两回事。
例如,一份旧设计文档可能准确描述了系统过去的实现方式,因此具有历史事实价值;但它不一定有权决定新需求应该如何实现。
同样,一次成功的测试能够证明某段代码在特定条件下符合测试预期,却不能自动证明测试所依据的业务规则就是正确的。
因此,我们需要区分不同知识的来源、状态、适用范围和权威性。
这也是为什么,把资料转换成 JSON、Markdown 或知识图谱,并不等于完成了知识治理。
数据结构只是知识的载体。
真正重要的是:AI 能否识别这些知识的身份、理解它们之间的关系,并在发生冲突时按照明确的规则处理。
4.3 从 KB 到 SGE:不仅要治理 AI 知道什么,还要治理 AI 怎么做
仅仅建立可信的知识库,仍然不够。
即使 AI 已经获得了正确的需求和设计依据,也不意味着它在执行过程中一定会正确使用这些知识。
例如:
AI 可能明明知道某项需求尚未澄清,却为了完成任务自行补充一个假设。
它也可能知道某项修改需要独立验证,却因为本地测试通过,就直接宣布任务完成。
还可能在遇到执行障碍时,擅自扩大任务范围,修改原本不应该修改的代码。
这些问题说明:
我们不仅需要治理 AI 使用的知识,还需要治理 AI 的执行行为。
这也是 DataEase 实践中引入 SGE(Semantic Governance Engineering,语义治理工程)的重要原因。
可以把 KB 和 SGE 的关系简单理解为:
KB 解决:AI 应该依据什么做判断。
SGE 解决:AI 应该如何按照这些依据开展工作,以及如何证明工作已经正确完成。
在本次实践中,我们通过 SGE Governance Skill,对研发过程建立了相应的行为约束。
例如:
开始任务前,需要明确 Goal、范围、约束和完成条件。 执行前,需要获得必要的上下文,识别知识缺口和潜在冲突。 对重要设计或变更,需要经过相应的 Review。 进入 Builder 阶段时,需要满足规定的执行前提。 完成代码修改后,需要进行验证,并保留相应证据。 在 Closeout 阶段,需要核对交付结果与原始 Goal 是否一致。 只有满足 Stop Gate 的条件,才能正式结束任务。
这些约束的意义,不是给 AI 增加更多繁琐的流程。
而是避免 AI 在缺少依据、缺少授权或者缺少验证的情况下,凭借自身推测继续执行。
换句话说:
我们希望 AI 不只是一个能够执行任务的 Agent,而是一个知道自己在什么条件下可以行动、在什么条件下必须停止的 Agent。
4.4 DataEase 的一个真实场景:AI 找不到输入,为什么反而是一件好事?
在本次 DataEase 试点的第一个开发 Slice 中,发生过一个值得讨论的现象。
AI 在执行过程中发现,完成当前任务所需要的部分输入材料无法被完整定位。
它没有直接猜测缺失的内容,也没有自行编造一个看起来合理的替代方案,而是暂停执行,向人提出需要补充的信息。
如果按照传统的效率观念来看,这似乎不是一件好事。
AI 停下来了,任务没有继续推进,还需要人来介入。
但从语义治理的角度来看,这恰恰是一种值得肯定的行为。
为什么?
因为软件工程中有两种完全不同的失败:
第一种是显性失败。
AI 发现自己缺少必要信息,明确指出问题,并停止相关工作。
这种失败通常容易被发现,也容易处理。
第二种是隐性失败。
AI 没有意识到自己缺少信息,或者虽然意识到了,却仍然根据自己的推测继续完成设计、编码和测试。
最终生成的结果看起来很完整,但实际上建立在未经确认的假设之上。
第二种失败的危害通常更大。
因为它可能把一个最初很小的理解偏差,逐步扩散到整个研发链条。
当然,并不是所有信息缺失都需要立即暂停整个任务。AI 可以继续完成不依赖缺失信息的部分,或者在明确授权的情况下采用可验证的临时假设。
关键在于:
AI 必须能够区分哪些未知可以继续探索,哪些未知已经触及任务的决策边界。
对于后者,AI 应该主动暴露问题,并请求必要的澄清或授权。
这实际上是一种非常重要的工程能力:
知道自己不知道什么,并且知道什么时候不能继续。
在 AI Native 研发中,我们不能只评价 AI 完成了多少任务,还应该评价它能否正确识别自己的知识边界和行动边界。
4.5 人的角色变化:从纠正 AI 的答案,到纠正 AI 的判断机制
在 DataEase 的回顾会上,有参与者提到一个观察:
整个过程中,我似乎一直在“调教 AI”。
这个观察是准确的。
但这里的“调教”,并不是不断修改提示词,让 AI 给出一个更符合个人偏好的答案。
它实际上代表了一种不同的人机协作方式。
传统的 AI Coding 往往是这样的:
人向 AI 提出任务,AI 生成代码或文档。
如果结果不符合预期,人就直接修改结果,或者告诉 AI 应该如何修改。
这样做当然可以解决眼前的问题。但它存在一个局限:
人纠正的是这一次的结果,而不是 AI 产生错误的机制。
下一次遇到类似问题,AI 仍然可能犯同样的错误。
在 DataEase 实践中,我们更希望采用另一种方式。
当发现 AI 的执行结果不符合预期时,我通常不会立即接手修改文档或代码,而是先检查它的执行记录、工具调用、使用的知识依据以及对任务的理解。
然后进一步追问:
为什么会做出这个判断? 使用了哪一份需求或知识作为依据? 是否遗漏了已经冻结的业务决策? 是知识库缺少信息,还是检索到了错误的信息? 是任务目标描述不清楚,还是执行过程中违反了约束? 为什么现有验证机制没有提前发现这个问题?
通过这样的分析,我们希望定位的不只是一个具体错误,而是导致错误产生的原因。
随后,修正可能发生在不同层面:
| 问题根源 | 可能的改进措施 |
|---|---|
这里还需要区分一点:AI 展示的执行说明,并不等于我们能够完整观察它的内部推理过程。
因此,我们不能仅仅因为 AI 对自己的错误给出了一个听起来合理的解释,就认定已经找到了根因。
更可靠的方法,是结合实际输入、工具调用记录、代码差异、测试结果等可核查证据,形成原因假设,再通过对照验证确认改进是否有效。
这才是工程意义上的问题定位与纠正。
4.6 从一次纠错,到持续提升 AI 的工作能力
上述做法还有一个更深层次的价值。
当人发现 AI 的错误时,可以选择两条不同的路径。
第一条路径,是直接把错误改对。
第二条路径,是通过与 AI 交互,发现错误、分析原因、提出改进措施,再让 AI 执行修复并验证效果。
在海盗派方法学中,我们把第二条路径称为 PDI(Problem Driven Improvement,问题驱动改进)。
但 PDI 仍然主要解决当前任务中的问题。
如果希望下一次遇到类似场景时,AI 能够表现得更好,还需要进一步把实践经验沉淀下来。这就需要海盗派另外一个重要的技能 PRE:
Practice → Reflect → Explicate
即:
实践 → 反思 → 显性化。
在 DataEase 的实践中,PDI 与 PRE 可以形成两个相互关联的反馈循环。
第一个循环发生在具体任务内部:
发现问题 → 分析原因 → 改进方案 → 验证结果。
第二个循环发生在任务完成之后:
回顾实践 → 提炼经验 → 更新知识与 Skill → 在后续任务中复用并验证。
两者结合,就可以逐步实现一个重要转变:
让 AI 不只是完成当前任务,还能够通过每一次实践,改善未来完成类似任务的能力。
当然,这种改善并不意味着底层大模型的参数发生了变化。
真正发生变化的,是 AI 可以使用的外部知识、工作流程、执行约束、工具能力和验证机制。
这些经过验证、可以持续复用的工程资产,构成了团队 AI 协作能力的一部分。
这也是为什么,在本次 DataEase 试点中,我们不仅关注功能开发本身,还花费了相当多的精力建设 KB、KYM、SGE 和 Dashboard。
因为我们的目标不只是完成这一次开发。
更重要的是,探索如何建立一套可以持续积累知识、纠正偏差、提升执行可靠性的 AI Native 研发体系。
4.7关键启示
回过头来看,这次 DataEase 实践让我们对 AI Coding 有了更深一层的认识。
过去,我们很容易把 AI Coding 的主要挑战理解为模型能力问题。
例如,模型的上下文窗口够不够大?代码生成能力够不够强?Agent 能不能连续执行更长时间?
这些问题确实重要。
但在真实的软件工程中,即使模型能力不断增强,仍然存在另一个不能忽视的问题:
AI 如何确保自己始终在正确理解业务目标、使用正确知识、遵守正确约束的前提下开展工作?
这不是简单扩大上下文窗口就能解决的。
也不是建设一个文档知识库就能自动解决的。
它需要一套贯穿知识、需求、决策、执行和验证全过程的治理机制。
DataEase 试点只是一次有限范围的探索,还不能证明这套方法已经解决了所有问题。
但它帮助我们形成了一个值得继续验证的判断:
AI Native 研发的关键,不只是让 AI 获得更多信息,而是让 AI 能够基于可信的知识和明确的约束,做出正确的判断;
在判断依据不足时主动暴露问题;在出现偏差时能够定位、纠正并验证;
最终通过持续的实践与反思,把这些经验沉淀为可复用的工程能力。
五、方法解释:OPC、BMAC、SGE 、PRE 如何形成一个整体?
这次 Coaching 并非简单展示几种 Skill,而是在尝试组合一种新的工作系统:
OPC 是组织工作与承担结果的方式;
BMAC 是 AI Native 研发运行方式;
SGE 建设可靠协作的治理基础;
PRE 让工作系统持续进化。
5.1 一张图理解:AI Native 研发为什么需要三层协同?
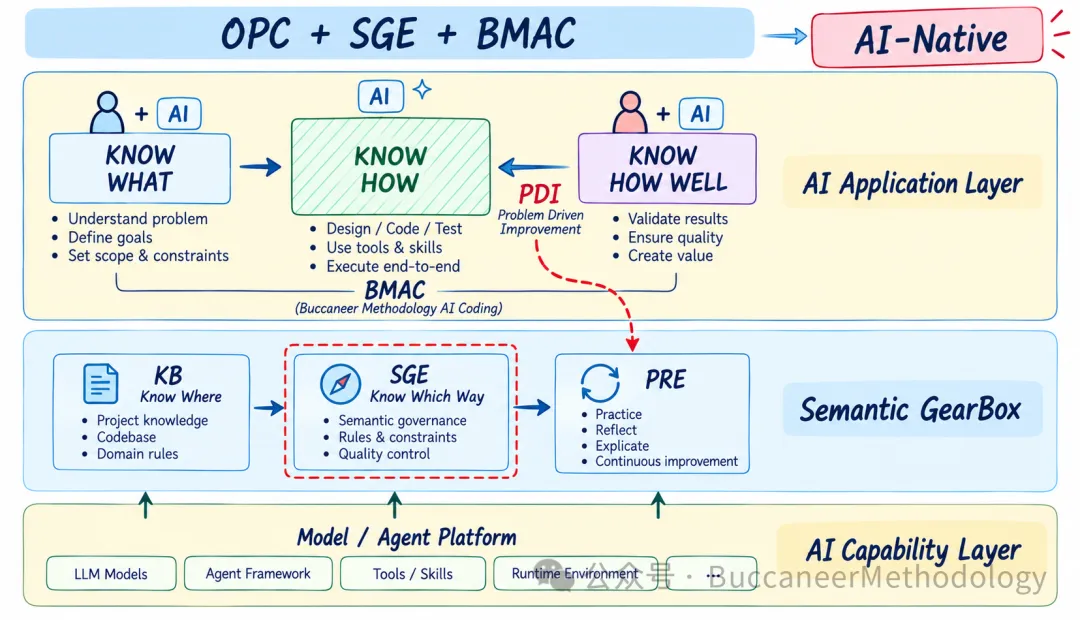
图:DataEase Coaching 回顾会上手绘架构的整理版。上层是 AI Application Layer,中间是 Semantic GearBox,底层是 AI Capability Layer。红色虚线表示由 PDI 发现的问题,进一步进入 PRE 反思与沉淀。
这张图要回答的,不是“再给软件工程增加几个 AI 工具”,而是一个更根本的问题:
如果 AI 已经能够承担软件工程中的大量执行工作,人应该把精力转移到哪里?又需要什么基础设施,才能放心把端到端任务交给 AI?
回顾会上,我们从 DataEase 的实践过程出发,把答案拆成三个相互依赖的层次。
第一层:AI Application Layer——重新组织人和 AI 的工作。
上层从左到右是 Know What → Know How → Know How Well。这不是三个新的岗位,也不是严格线性的瀑布流程,而是三类必须覆盖的责任。
左边的 Know What 由人和 AI 共同探索:到底要解决什么问题,目标是什么,哪些约束不可突破。DataEase 的 156 项需求澄清就是具体例子:AI 负责持续提出遗漏的边界问题,人负责选择、裁决和确认。
中间的 Know How 尽量由 AI 承担,包括设计、编码、测试、环境搭建与验证执行;这正是 BMAC 所推动的分工变化。
右边的 Know How Well 则是人和 AI 一起判断结果是否达到目标、质量是否可信、证据是否充分。人可以委托独立 Agent 做审查和测试,但不能把验收责任等同于“AI 自己说完成了”。
PDI(Problem Driven Improvement)是从结果反推改进的入口。
当 Know How Well 发现结果不符合预期,图中的反馈箭头不是要求人立刻接管代码或文档,而是回到 AI 的理解、判断和执行过程,找出问题并纠偏。
回顾会上举过一个典型对比:过去 AI 做不好,工程师往往自己动手改结果;现在则尝试继续与 AI 对话,调查为什么做错,让 AI 自己完成修正。
这种做法不仅修复当前结果,也为后续治理提供了问题样本。
第二层:Semantic GearBox——把通用 AI 能力适配到具体工作世界。
回顾会上我用“语义齿轮箱”解释:底层模型与 Agent 平台是通用智能,上层 DataEase 这样的项目却有自己的代码、业务语义、需求裁决和交付规则。两者不能仅靠一次提示词自然啮合。
因此中间需要三种能力共同工作:
- KB(Know Where)
- SGE(Know Which Way)
- PRE(Practice / Reflect / Explicate)
这里要特别区分 PDI 与 PRE:
PDI 以具体问题为牵引,推动当前任务改进;
PRE 则进一步通过反思和显性化,将一次实践中的经验转化为下一次可复用的能力。
两者关联,但不等同。
回顾会反复提到的“调教 AI”,核心也不只是调整提示词,而是不断修正它对工作世界的理解、工作行为与治理规则。
第三层:AI Capability Layer——模型和 Agent 平台提供执行能力。
最底层包括 LLM Models、Agent Framework、Tools / Skills 和 Runtime Environment。
它们很强,但本身并不知道 DataEase 的具体需求,也不会天然遵循团队约定的权威层级、验收标准和停止条件。
模型能力是必要条件,却不是可靠交付的充分条件。
图中底层向中间层提供能力,中间层再支撑上层工作,表达的就是从“通用智能”到“可用于具体项目的可靠协作能力”的适配关系。
因此,图顶端的 OPC + SGE + BMAC → AI Native并不是三个术语的简单相加:
OPC描述端到端结果责任如何组织;
BMAC描述人和 AI 如何开展研发工作;
SGE 及其知识与反馈机制为这种协作提供可信赖、可持续改进的运行基础。
三者结合,才使“一人或小型工作单元承担更大范围成果”从设想变成值得实践检验的方向。
这张图也解释了为什么 DataEase 试点的前三天投入了大量时间在 Dashboard、KB、需求澄清、Goal 契约、Review 和验证准备上,而不是一开始就让 AI 写代码.
这些工作不是软件工程之外的额外负担,而是在建设让 AI 能够可靠开展软件工程的协作条件。
不过,回顾会时首个实现切片仍在验证,不能据此推断整套机制已在长期运行或组织规模上完成验证。
5.2 OPC:端到端 Outcome Ownership
OPC 不是要求一个人亲自写完所有需求、代码和测试,而是让个人或一到三人的小型工作单元承担更完整的业务结果。
组织未来可能由多个小型 OPC 单元构成,减少按岗位分段交接,让人员更容易切换项目。
这是我目前猜测的组织演进方向,尚非三天试点已经验证的组织绩效结论。
5.3 BMAC:AI 承担工程执行,人负责目标与判断
BMAC 在这次试点中的核心体现,是尽可能将传统软件工程的具体执行交给 AI。
人不再执着于把自己写需求、编码和测试的每一步经验都翻译成 Skill,而是定义任务的目标、约束、验收与风险。
AI 做得不好时,先研究其理解和行为偏差,而不是立即把任务收回自己完成。
详细的关于BMAC的介绍,可以看文末的参考链接。
5.4 SGE:连接通用智能与具体业务的语义齿轮箱
模型和 Agent 平台具备通用能力,却不了解组织内特定的系统、知识、业务规则和历史决策。
我把中间的适配与治理层称为 Semantic Gearbox(语义齿轮箱)。
其中,KB 提供 Know Where——知道工作世界是什么;SGE 提供 Know Which Way——知道应该以什么规则工作。
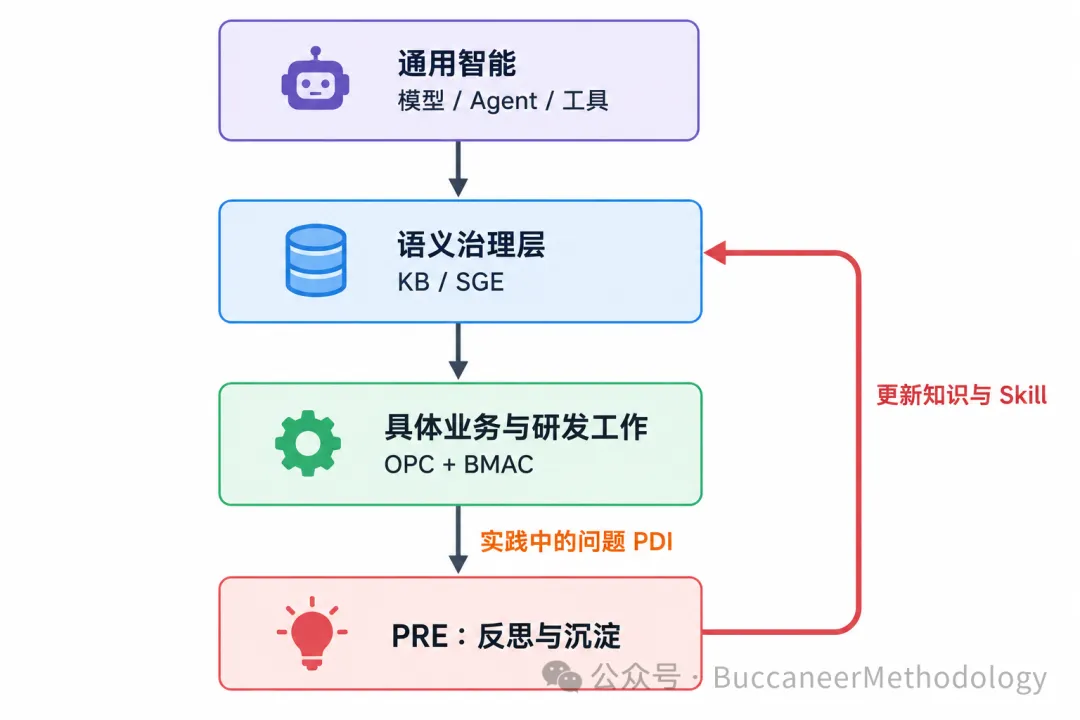
详细的关于SGE的介绍,可以看文末的参考链接。
六、PDI + PRE:从解决一次问题,到让 AI 持续进化
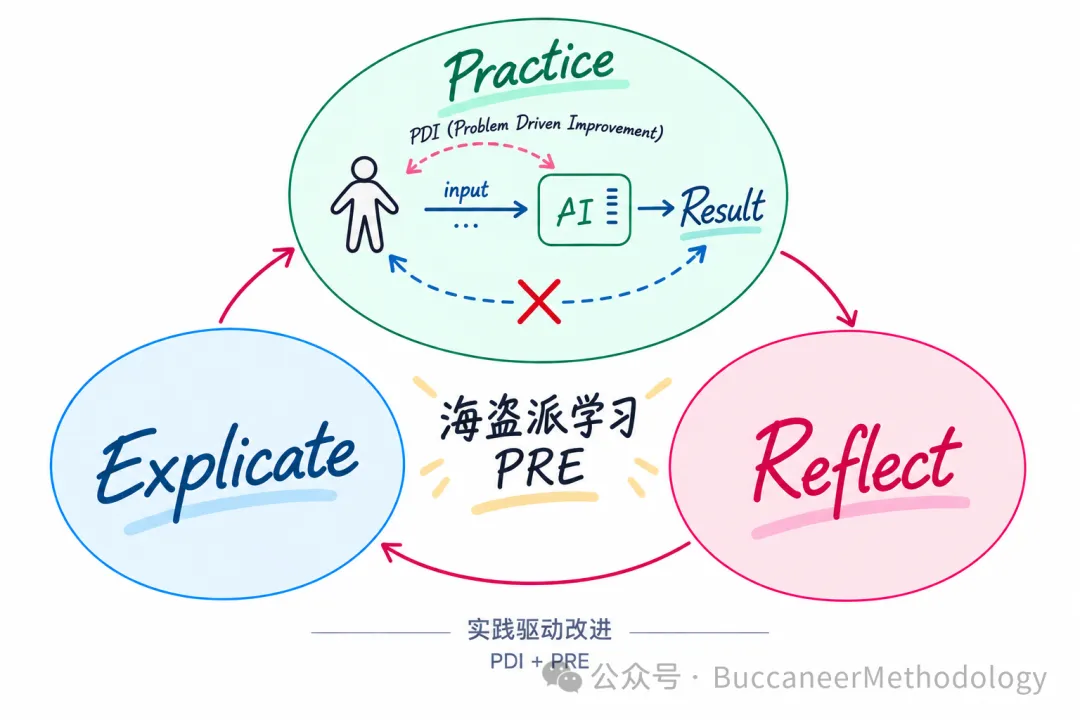
在 AI 时代,人最值得培养的一项能力,不只是学会使用 AI,而是学会如何通过持续的实践、反馈和反思,让 AI 越来越能够按照我们的期望完成工作。
这张图展示的,就是海盗派学习反馈环 PRE(Practice、Reflect、Explicate),以及 PDI(Problem Driven Improvement,问题驱动改进)在其中发挥的作用。
它不仅是一种学习方法,也是一种人与 AI 持续协作、不断改进 AI 工作能力的方法。
鉴于PRE 的重要性,这里专门设立一个章节阐述它。
6.1 Practice:当 AI 的结果不符合预期,我们通常会怎么做?
我们先来看图中最上面的绿色圆圈——Practice(实践)。
这是一个非常常见的人机协作场景。
人向 AI 发出一个 Prompt,交给它一项任务。AI 接收任务,经过处理,生成一个结果。
但在实际工作中,我们经常发现,AI 的输出并不完全符合预期。例如:
让 AI 编写一份需求文档,结果发现它遗漏了重要的业务规则;
让 AI 修改一段代码,结果发现它没有正确处理某个边界条件;
让 AI 生成一份开发计划,结果发现它对任务范围的理解存在偏差。
当我们发现 AI 的结果有问题时,接下来怎么做?
这恰恰是人与 AI 协作方式发生分化的地方。
第一种做法:人直接修改结果。
图中下方那条带有红色叉号的蓝色虚线,代表的就是这种方式。
很多人看到 AI 的输出不符合预期,第一反应是:“算了,还是我自己来改吧。”
于是,人开始利用自己过去积累的专业经验,直接修改需求、代码或者测试用例。
这种做法看起来很高效,因为人熟悉这些工作,可能几分钟就能把问题解决。
但从 AI Native 的角度来看,它存在一个值得反思的问题:
人实际上又回到了传统的 Know How 工作中。
我们虽然使用了 AI,但当 AI 做得不够好时,仍然需要依靠人亲自完成专业执行工作。
更重要的是,这种做法没有帮助 AI 改进。下一次遇到类似问题,AI 仍然可能犯同样的错误,人仍然需要再次介入。
当然,在紧急故障处理等场景下,人直接修复问题可能是必要的。这里强调的不是禁止人工干预,而是:
如果希望建立一种能够持续提升的人机协作方式,就不能总是依靠人来弥补 AI 的执行不足。
第二种做法:人指挥 AI 修改结果。
这就是图中上方粉红色虚线所表示的 PDI(Problem Driven Improvement)。
当我们发现 AI 的结果有问题时,不急于自己动手修改,而是尝试和 AI 一起分析:
问题究竟出在哪里?
AI 为什么会产生这样的结果?
是对需求理解错了,还是缺少必要的上下文?
是任务边界不清晰,还是执行方法存在问题?
然后,基于发现的问题,继续与 AI 交互,指导它重新分析、调整方案、修正结果。
在这个过程中,人主要承担的是发现问题、提出问题、判断方向和验证结果的责任,而 AI 继续承担具体的分析、修改和执行工作。
这就是 PDI 的核心:
以问题为驱动,通过人与 AI 的持续交互,让 AI 自己完成问题的修正。
这种方式不仅解决了当前的问题,也让人逐渐学会如何更有效地指挥 AI。
6.2 从 PDI 到 PRE:解决了问题,为什么还不够?
假设我们已经通过多轮交互,成功指挥 AI 修正了问题。
现在,AI 生成了符合预期的结果,任务完成了。
很多人到这里就会停止,转而开始下一项工作。
但我认为,如果到这里就停下来,其实非常可惜。
因为刚刚发生的整个过程,无论经历了多少轮交互,解决了多少问题,本质上都只完成了一次 Practice。
我们完成了一项任务,也许学到了一些经验,但这些经验很可能仍然是零散的、模糊的,甚至只是停留在当时的对话上下文中。
下一次遇到类似问题,我们可能仍然需要重新经历一遍相同的探索过程。
那么,能不能让这次实践产生更大的价值?
这就需要从 PDI 进一步进入 PRE。
PDI 重点解决当前的问题,而 PRE 则进一步追问:我们能从这次问题解决过程中学到什么?怎样让类似的问题以后更少发生?
这也是为什么图中绿色的 Practice 圆圈并不是终点,而是通过箭头继续连接到 Reflect 和 Explicate。
6.3 Reflect:让 AI 帮助我们反思实践
PRE 的第二个环节是 Reflect(反思)。
过去,我在教授 PRE 时,经常遇到一个困难:很多人不知道应该如何反思。
他们可能知道反思很重要,却不知道该从哪里开始、应该问什么问题、如何从一次具体实践中发现更深层次的问题。
但在 AI 时代,反思这件事变得容易了很多。
因为我们可以让 AI 成为自己的反思伙伴。
当完成一次 PDI 之后,不要急着结束对话,可以继续问 AI:
为什么这次会出现这样的错误?根本原因是什么? 在刚才的任务执行过程中,哪些地方存在理解偏差、行为偏差或者方法上的不足? 如果希望以后避免同类问题,我们应该改进什么? 这个问题是否暴露了当前知识库、任务定义、Skill 或者 AI 工作规则中的缺陷? 从这次实践中,我们能够总结出哪些具有普遍意义的经验?
这些问题并不复杂,但往往能够带来非常有价值的发现。
例如,某次 AI 编码任务失败,表面上看是代码实现错误。
但经过反思,我们可能发现,真正的原因并不是 AI 不会写代码,而是它在执行任务之前,没有正确理解某个业务规则。
继续追问,又可能发现,它之所以理解错误,是因为知识库中存在一份过时的设计文档,而 AI 没有正确区分这份文档与当前权威需求之间的关系。
这样,我们就从一个具体的代码问题,逐步发现了一个更深层次的语义治理问题。
反思的价值,正在于帮助我们从一次具体的错误中,发现背后更具普遍性的改进机会。
当然,AI 给出的反思并不天然正确。我们仍然需要结合执行记录、实际结果和相关证据,判断这些分析是否成立。
6.4 Explicate:把一次实践中的经验,沉淀为可复用的能力
只有反思还不够。
如果我们只是得到了一些很好的洞见,却没有进一步采取行动,那么这些洞见仍然可能随着对话结束而消失。
因此,PRE 还有第三个环节:Explicate(显性化)。
它的核心,是把实践和反思中获得的经验,从零散、模糊、依赖个人理解的状态,转化为明确、可复用、可持续改进的知识、规则或方法。
在 AI 协作中,这些沉淀物可以有很多种形式,例如:
一条新的 AI 行为规则; 一个经过改进的 Prompt 或 Skill; 一项新的质量检查或验证机制; 一条需要补充到知识库中的权威业务规则; 一种可以在后续任务中重复使用的工作方法。
这里有一个非常重要的区别。
我们不是简单地把这次问题的解决过程记录下来,而是希望从中提炼出一种能够解决同类问题的能力。
例如,前面那个 AI 因为使用过时文档而产生错误的案例。
如果只是修正当前代码,这次问题就结束了。
如果进一步完成 Reflect,我们可能识别出:AI 缺乏对信息权威性和有效性的判断机制。
接下来,通过 Explicate,我们就可以和 AI 一起设计并落实相应的改进措施:
让 AI 在执行任务之前,先识别权威知识来源;当发现不同来源的信息相互冲突时,不能自行猜测,而应该主动暴露冲突、请求澄清;在没有获得足够证据之前,不得把未经验证的信息当作事实。
这些规则经过设计、验证后,就可以沉淀到 SGE 治理机制或相关 Skill 中。
于是,下次 AI 执行类似任务时,就能够按照改进后的规则开展工作。
这意味着什么?
我们不只是修正了一个错误,而是改进了 AI 以后处理同类问题的工作方式。
这才是 Explicate 真正的价值。
6.5 PDI + PRE:让 AI 协作能力形成持续进化的反馈环
现在,我们再回过头来看整张图。
整个过程形成了一个完整的学习反馈环:
Practice → Reflect → Explicate → 新的 Practice。当然,真实的PRE学习反馈环不总是依照这样的现行顺序发生的,而是P、R、E的各种可能的组合。
在 Practice 中,人通过 PDI,不断发现问题、指挥 AI 修正问题,完成当前任务。
在 Reflect 中,人和 AI 共同分析问题产生的原因,识别值得改进的地方。
在 Explicate 中,人和 AI 把这些改进机会落实为具体的规则、Skill、知识或工作机制。
这些改进成果又会进入下一轮 Practice,帮助 AI 更好地完成后续任务。
随着这个循环不断发生,我们积累的不再只是一次次任务的完成结果,而是一套不断完善的 AI 协作能力。
这也是我在实践 SGE(Semantic Governance Engineering,语义治理工程)过程中,一个非常重要的体会。
最初,我使用的也只是通用的 AI 模型和 Agent 平台。
它们已经非常强大,但在实际工作中,仍然会出现各种各样的问题:误解任务、偏离目标、擅自扩大范围、依据不足却做出判断、缺少必要的验证,等等。
面对这些问题,我并不是每次都自己接管任务,而是不断通过 PDI 与 AI 交互,尝试纠正它的行为。
当问题得到解决后,再通过 PRE 反思这些问题为什么出现,思考如何避免重复发生,并把改进措施沉淀为新的治理规则和 Skills。
经过持续的实践、反思和改进,逐渐形成了现在的 SGE 治理机制。
因此,SGE 并不是先设计出一套完美的规范,然后要求 AI 遵守;它更是通过大量真实问题驱动,不断实践、反思、改进和积累形成的治理基础设施。
而且,这套基础设施并不是静态的。
不同的人、不同的项目、不同的工作环境,会遇到不同的问题,也需要不同的治理方式。
即使使用同一套开源 Skill,经过各自的 PDI 和 PRE 实践之后,也可能逐渐演进出适合各自工作场景的版本。
6.6 AI 时代,人最值得培养的能力之一:学会 PDI + PRE
回到我们最初讨论的 AI Native 研发范式。
当 AI 能够承担越来越多的软件工程 Know How 时,人应该把精力投入到哪里?
我认为,除了明确目标(Know What)、判断结果(Know How Well)之外,还有一项非常重要的工作:
持续改进人与 AI 的协作方式,让 AI 能够越来越可靠地承担工作。
而 PDI + PRE,正是完成这项工作的一种重要方法。
它并不要求每个人都成为 AI 模型专家,也不要求每个人都掌握所有专业领域的 Know How。
但它要求我们逐渐养成一种新的工作习惯:
当 AI 做得不好时,不要总是急于自己接手,而是尝试找到问题,指挥 AI 把它做好。
当 AI 最终做好之后,也不要急于结束,而是再多问几个问题:
为什么刚才没有做好? 我们从中学到了什么? 怎样让 AI 下一次做得更好? 能不能把这次学到的东西,沉淀成一种以后可以重复使用的能力?
这几个看似简单的问题,正是从一次性使用 AI,走向持续培养 AI 协作能力的重要转折。
随着 PDI + PRE 不断循环,人会越来越善于发现问题、提出问题、判断结果和指挥 AI;与此同时,AI 的工作环境、知识基础、行为规则和 Skills 也会不断完善。
人驾驭 AI 的能力在提升,AI 能够为人提供的有效能力也在提升。
两者相互促进,形成一个持续进化的正向循环。
6.7 核心观点
PDI 让我们解决眼前的问题,PRE 让我们从解决问题的过程中获得持续改进的能力。
如果只做 PDI,我们可能成为一个善于指挥 AI 完成任务的人。
如果进一步做好 PRE,我们就有机会把一次次实践中获得的经验,转化为可以持续复用和演进的 AI 协作基础设施。
这也是 AI Native 时代值得关注的一种能力转变:
从学习如何亲自把事情做好,转向学习如何让 AI 把事情做好;再进一步,学习如何让 AI 下一次做得更好。
而这,正是海盗派学习反馈环 PRE 在 AI 时代的重要价值。
七、人还需要做什么:Know What、Know How 与 Know How Well
这次Coaching实践,人几乎没有亲手读代码、写需求或设计测试,却推动了一个陌生仓库的工作。这并不是说工程知识不再重要,而是在挑战我们对“人必须亲自做什么”的假设。
7.1 Know What:想清楚到底要做什么
DataEase 试点为一个 Goal 做了大量准备:理解仓库、识别未知、澄清 156 项问题、冻结需求决策、划定范围、确定验收标准。
人真正要把握的,是目标是否值得做、需求是否清楚、哪些决定不可偏离、哪些风险必须控制。
7.2 Know How:让 AI 承担具体执行
需求整理、设计、编码、环境搭建和测试都可以越来越多地委托 AI。
但委托不等于放弃责任:涉及架构、安全、生产变更或不可逆操作时,仍需必要的专业判断、授权和人工审核。
7.3 Know How Well:用证据判断做得怎样
Goal 运行数小时不等于成功;测试通过也不自动等于业务正确。
独立 Review、Validation、Closeout 和 Stop Gate 的意义,是把“看起来完成”与“有证据证明满足完成条件”区分开来。
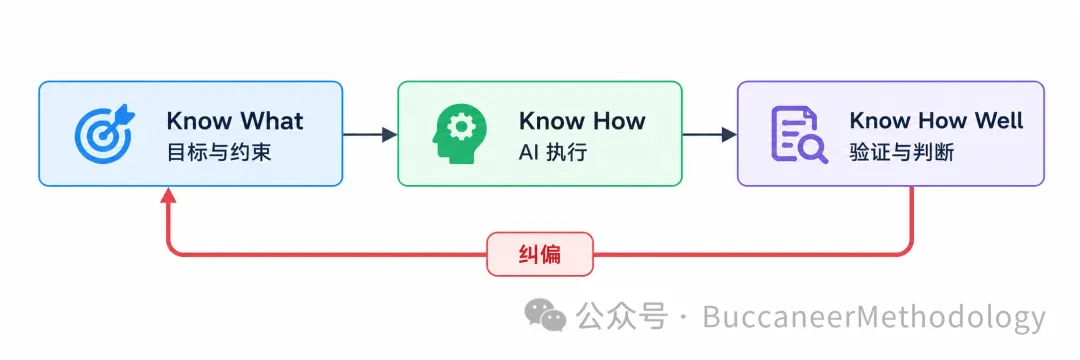
值得强调的是,Know What 和 Know How Well 也不是纯人工工作:人可以让 AI 帮助提出问题、比较方案、设计验收和调查缺陷,但关键裁决与结果责任仍由人承担。回顾会最后还提出另一个重要区分:
三天试点主要围绕 R&D 中的 “发 - Development”——把相对明确的需求推进到实现;
而 R&D 中的 “研 - Research”——从模糊想法出发,与 AI 长期对话、逐渐形成高质量方案——是另一种值得专门培养的能力。
未来人的价值不仅在于指挥实现,也在于提出更值得实现的问题。
NoteBTW,如果你或你的团队,希望提升与AI长程深度对话的“研 - Research”的能力,我很乐意提供相关的Coaching服务,这是我十多年教练/顾问生涯一直在练习的能力,也是我感兴趣的研究领域所在。
八、组织启示:从培养会用 AI 的人,到建设 AI 协作基础设施
三天试点并不能证明“一个人三天替代整个研发团队”。
它更有价值的地方,是提出一个可继续验证的方向:当知识、任务、行为规则和质量证据得到治理,个人或小型团队可能承担过去需要多个岗位反复交接的工作。
8.1 管理者需要建设新的团队工作环境
管理者过去关注谁在写需求、谁在开发、谁在测试。
新的管理问题还包括:
团队有没有可靠的知识真源?
重要决策能否冻结并追溯?
AI 遇到缺失输入会停吗?
质量门禁是否有效?
错误能否变成下一次更好的工作方式?
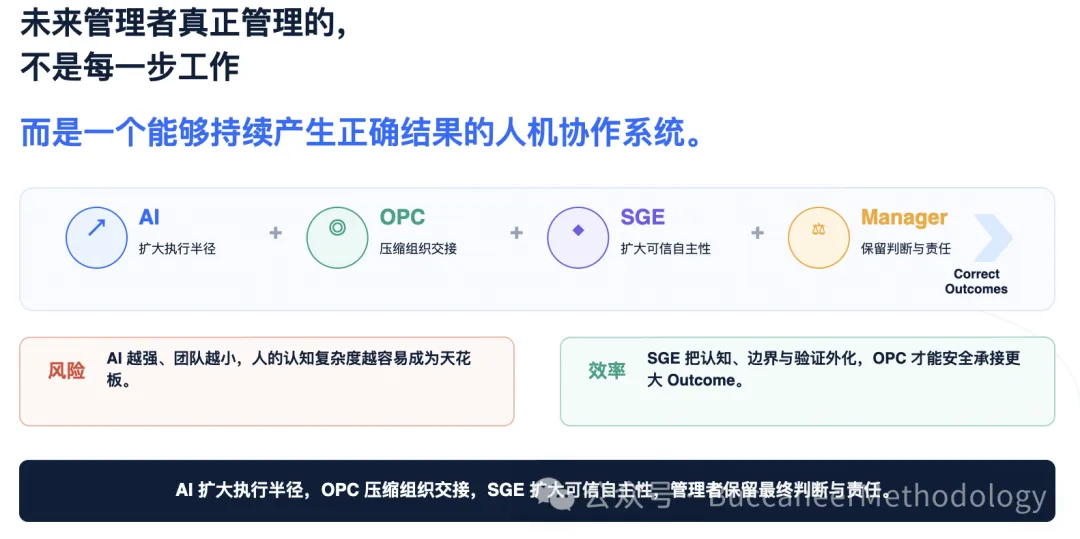
今年我讲的最多的一门课,名字就叫做 “AI Native时代,管理者的新任务 - 建设 AI 协作基础设施”,因为AI时代,管理的对象不再是一个个执行具体任务的个体,而是一个个“人与AI协作的系统”。事实上,每一个与AI协作的个体,都是一个微型管理者。
8.2 SGE 需要明确的工程责任
我甚至建议设置 SGE 工程师角色,持续维护和调优治理基础设施。
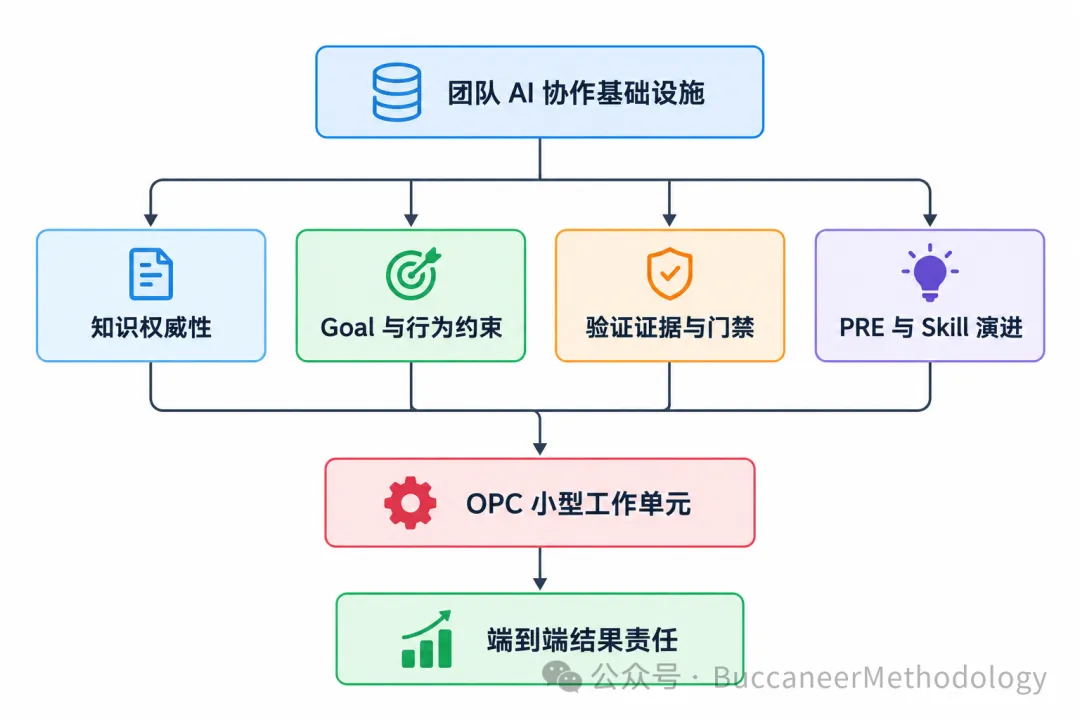
组织可以从明确职责开始,不一定立即设立独立岗位:谁维护权威知识,谁治理 Agent 行为,谁维护验证规则,谁把重复出现的问题沉淀为团队可复用的 Skill?如果这些事情无人负责,个人仍会在各自线程里重复试错。
当然,这并不等于组织有专人建设和维护SGE治理基础设施,于是其他成员就只需要坐享其成、直接使用就可以了。
每个人都需要持续地使用 PDI+PRE 不断“调教”自己的AI,建设属于自己的、独一无二的那套基础设施。
九、结语:下一代研发能力,首先是一种驾驭 AI 的能力
如果 AI 时代只学一种本领,不妨学会与 AI 持续深入对话,发现问题、纠正偏差,并把经验沉淀下来。这不是一个更复杂的 Prompt 技巧,而是一种持续学习与组织智能的能力。
回到最初的问题:当 AI 能够完成越来越多的软件工程工作,我们还需要怎样做研发?
DataEase 三天 Coaching 给出的方向不是取消软件工程,而是重新安排软件工程中的人机分工。
需求、设计、编码、测试依然存在;改变的是谁承担执行、谁定义目标、谁治理语义、谁对最终 Outcome 负责。
这三天里,团队从一个陌生仓库和八项需求出发,逐步建立系统认知,识别未知,完成 156 项需求澄清,并将开发工作组织成带有明确约束与质量门禁的 Loop Goal,然后交给AI执行,过程中不断通过 PDI+PRE 校正AI的行为与输出。这是一段真实的探索,也仍有未完成的验证。
它最重要的启发或许是:AI Native 研发不是让每个旧岗位都跑得更快,而是让人重新学会定义问题、组织智能、建立可信协作,并持续进化整个工作系统。
当 AI 越来越擅长回答“怎么做”,人的核心竞争力将更多体现为:发现什么值得做、判断什么是对的,以及如何让人和 AI 长期、可靠地做成同一件事。
【邰晓梅】如果您的企业和团队,也想实践 SGE、BMAC,或者 OPC 转型、或者 知识工程建设等,欢迎预约我的AI 落地的 Coaching辅导、以及相关培训课程
参考阅读:SGE相关的介绍和skills
开源 LLM Artifact Evaluator Skill:为 AI 生成物建立独立验证层
AI Native组织,管理者的新任务:建设团队协作基础设施
BMAC - 海盗派AI研发新范式
Semantic Governance Engineering:在 AI Coding 时代构建可治理的 Agent Systems
AI Coding时代,真正的问题开始变成:Semantic(语义)
把探索过程交给 Dashboard:从 RSEM 到 dashboard-governance-skill
BM Dashboard:一种用于管理探索性认知过程的框架
开源Doc-System-KB-Builder skill:把项目文档从“可阅读文件”变成“可治理知识系统”
记录最近一次的Coaching实践活动:SGE+BMAC
开源contract-first-delivery-skill:帮助降低 AI 编程中的返工与失控风险
热爱学习
勇于探索
孜求匠艺
交付以则
Buccaneer Methodology
Share Learning,Share Success!
学习 和 分享 是人生中的两大趣事: 学习,从未停止过分享,感谢有您的参与
Buccaneer Methodology 海盗派方法学关注公众号,回复“海盗派”:了解如何加入海盗派微信群