ARTICLE · 1271821
世界模型的本质,让 AI 先在心里演练一遍
LLM大模型能背出抛物线公式,但它没接过球。
它知道答案,但没做过题。
一、演练是什么
人伸手拿杯子之前,脑子已经演过一遍,全过程不到一秒。
世界模型就是把这件事搬进机器。
输入是当前画面加上我要做的动作,输出是下一秒世界的样子。
大模型输入上文,输出下一个词,本质是概率问题。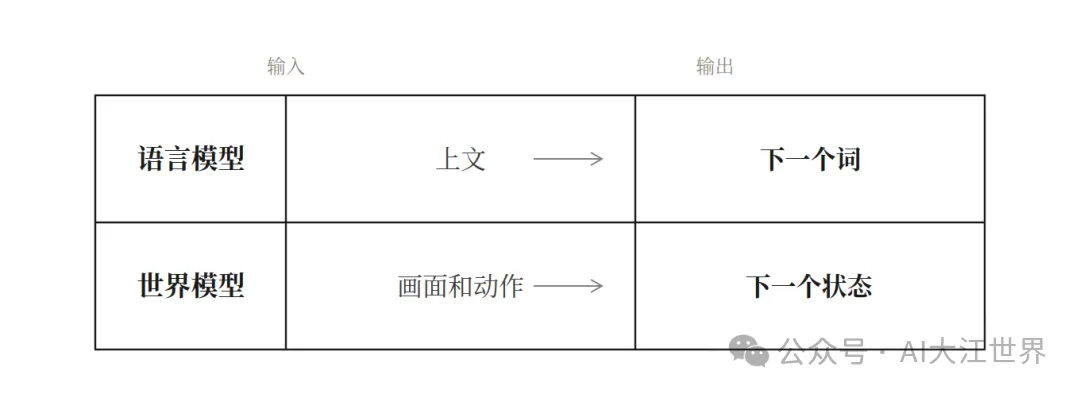
图 1 输入换了,预测的对象就换了
一行之差,差的是因果。
二、大模型缺的是过程
问大模型,端一杯满水会怎样。它答会洒。答对了,这是常识里的高频结论。
再问,手腕转多少度。它答不出。书上没写过这个。
今天的AI大模型对物理世界的理解,还不如一只老鼠。
这话有数据撑着。人类写下的所有文字约 10 的 14 次方字节,是一个四岁小孩用眼睛吸收的量。
三个缺陷靠堆数据解决不了:数据里只有发生过的事,没有如果;文本离散,物理连续;小孩烫一次就记住,模型要几百万条样本。
语言是世界的摘要。摘要读得再熟,也没见过原件。
三、机器人缺的是练功房
现在机器人最大的开销是摔。真机上摔一次,可能几十万。
所以行业里有句话:机器人不缺身体,缺的是练功房。
世界模型就是那间练功房。在里面摔一万次,重启就行。
四、三条路,一堵墙
今年 6 月,World Labs 把世界模型拆成三类。
数据来源:World Labs 技术文章,2026 年 6 月
7 月,上海 AI Lab 发 58 页论文反驳:分的是输出,没分到本质。摘要里有句大实话,全世界都在做世界模型,没人说清它该预测什么。
国内,腾讯、阿里、字节 4 月密集发 3D 模型,中科院 PAIWorld 6 月在 WorldArena 排第一。国外比谁像,国内比谁能在工厂用。
墙在一致性上。
Genie 3 能实时生成 720p 画面,一致性维持几分钟。几分钟后,桌子可能变形,杯子可能穿模。
五、未来
语言模型会消失吗?
我认为不会,但位置会变。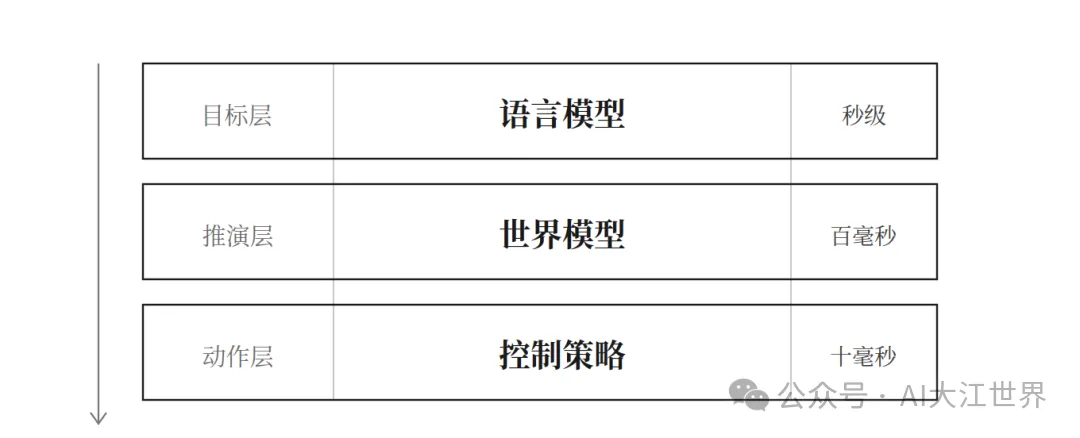
图 2 三层分工与各自的时间尺度
最上面想,中间演,下面动。
语言模型不会丢。因为人下指令用语言,总得有东西做翻译。世界模型也不知道这是客户的杯子不能碰,规矩在语言里。
Figure 的 Helix 已经在这么干。70 亿参数的慢系统理解指令,8000 万参数的快系统出关节动作。
模型的结构,正在决定芯片的结构。渲染器吃显存和带宽,模拟器吃几何和物理管线,规划器吃低延迟推理。
真正的检验,一台从没进过这间屋子的机器人,能不能自己把桌上那杯水端起来。
你觉得是模型不够大,还是它压根没见过世界?