ARTICLE · 1272986
58行只剩5行,PDF抽取为什么没有报错
58行的表格,最后只拿到了5行。JSON能解析,请求也没有异常,程序继续往下走
我觉得,这比直接报错更值得开发者留意
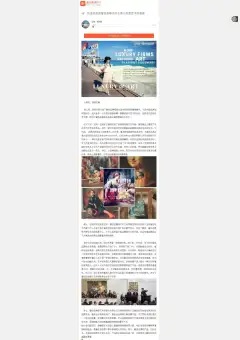
今天AIHOT收录了一篇OpenRouter的PDF表格抽取教程。里面最吸引我的,不是哪一个模型又拿了满分,而是作者专门拆开的两类静默失败
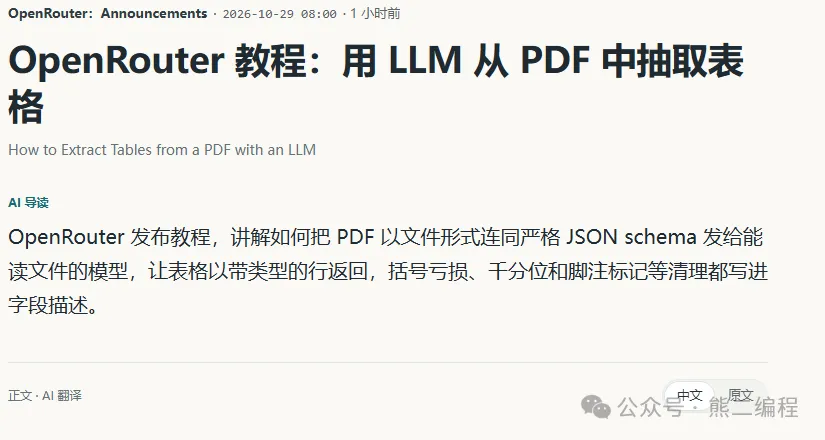
图|AIHOT收录的OpenRouter教程,真实页面截图
一种连一行都没读到,另一种只读到了一部分。它们都可能穿着正常响应的外衣,进入下一段流程
你如果只检查请求是否成功、返回值是否为合法JSON,这两道检查还真未必拦得住
这篇教程的测试并不大。五份PDF,共六页、644个单元格,其中两个文件是扫描件。文档由已知数据生成,因此可以把返回的每个单元格与原始数据对照
三个直接读取PDF的模型,在这组测试里都答对了全部644个单元格
但从这个结果走到一条能放心处理文件的流水线,中间还有一段路
我没有独立重跑这组测试。下面的数字和案例,都来自AIHOT收录的OpenRouter原文,讨论的是它给出的现象,而不是替任何模型作普遍准确率保证
先从一个很容易忽略的问题说起
同样叫PDF,模型拿到的未必是同一种东西
教程区分了带文本层的数字文件,以及扫描得到的文件。数字导出的发票,文字可以被解析器直接取出;扫描页则需要能理解页面的模型,或者先经过OCR
这一步发生在模型给出答案之前
如果入口没有把页面内容送进去,后面即使换一种更漂亮的输出格式,也补不回那些没有被读到的内容
复盘把一份扫描采购订单发给DeepSeek V4.1 Flash。该模型可以接受图像,但不接受文件,因此PDF要先走解析器
经mistral-ocr处理后,返回了六行,模型与解析路径的这次调用费用为0.00211美元
换成免费的cloudflare-ai文本解析路线,结果变成零行
真正让人停一下的,是失败的外观
如果没有教程里额外写的空结果检查,第二次调用会返回200 OK,finish_reason也是stop,同时交回一个空的rows数组
通信完成了,生成也结束了,格式也对。可是要交给下游的数据没有了
程序甚至不一定有机会进入异常处理,因为这条路径上的各个环节,都没有用异常表达问题
文本解析器在扫描件里没有找到文本,模型便根据自己拿到的输入返回空表。放到完整任务里看,这是抽取失败;拆开看某一个接口,却可能显得一切正常
所以我觉得,这个问题不能简单归到模型会不会看错字上
要问的还有,原始文件经过了什么处理,模型究竟看见了什么
同一条免费解析路线在另一份粗糙扫描件上也没有抽出任何行,而源表有30行。与此同时,它对测试中的三个数字PDF都处理正确
这就让选型变得具体了
便宜不便宜,要连着文件类型一起看。某条路线在数字文件上表现正常,不能直接当作扫描件也可用的证据
不过,空结果检查也有自己的边界
如果业务本来就允许没有表格的文件,零行未必永远等于错误。关键是你得知道当前这份文件预期有没有数据,而不是让一个空数组替你默默作决定
这是我顺着案例作的工程判断,教程演示的提取任务本身是明确存在表格的
另一个静默失败,发生在输出的另一端
教程里的发货日志跨了两页,一共有58行。不同模型为它消耗了约2500到7700个输出token,每行约43到133个token
这也解释了一个常见误会。文件能放进输入,不等于抽出来的全部行一定能塞进输出
每一行都要重新写成字段、键名和数值。表格越长,schema越复杂,输出空间就越不能靠感觉留
复盘把max_tokens压到600,触发了截断
正常情况下,不完整数组会让JSON解析失败,这至少能让程序停下来。但开启Response Healing之后,语法被修好了,返回值可以解析,58行却只剩5行
问题没有因为JSON变合法而消失
没有写出来的那些行,语法修复无法替模型补上。它修的是表达形式,不是把缺少的数据重新抽取一遍
这就是第二类静默失败
我甚至觉得,它比空表更容易混过去。毕竟五行记录看起来已经像一份可以交付的结果,字段也都在那里
教程保留的检查,是识别finish_reason为length的响应,然后拒绝这次提取结果。需要提高输出上限,或者拆分文件之后再处理
这里有个很重要的区别。JSON能不能解析,和整项任务有没有完成,是两个问题
你当然需要前一个检查,但不能指望它顺便替后一个问题作答
在这份58行样本上,作者建议预留每行约150个输出token作为起点,再根据自己的模型和字段测量。这个数是估算起点,不是所有表格通用的额度公式
模型不同,字段描述不同,行里长文本多少不同,实际消耗都会变化。finish_reason的检查仍然要留下
说到这里,再回头看教程里最先出现的严格JSON schema,就容易理解它负责什么了
它为一行定义字段、类型和必填项,限制额外字段。支持严格模式的提供商,可以据此约束返回结构
但严格模式的支持因提供商而异,而且结构符合要求,也不等于内容天然完整
前面的空数组就是一个很直观的例子。数组为空,并没有自动违反一个允许数组存在的结构定义
所以schema值得认真写,但别把任务验收都压给它
教程在字段描述里放入了具体的清理要求。这部分反而很实用,因为它把文档里的表达习惯,转换成程序能够继续使用的数据约定
例如,页面里的6,067.00,返回后是数字6067.0。括号里的3,878按负数处理,成为-3878。名称上的脚注标记则按要求去掉
这些只是教程中的格式处理样例,不需要把示例数值当成真实业务数据
它们说明,你要的并不只是把文字抄出来
千分位怎么处理,括号代表什么,单位是否保留,脚注要不要进名称,这些决定如果没有说清楚,就会被留给某一段代码或模型自行解释
合并单元格也是这样
粗糙扫描样本里的Category列,一个单元格覆盖六到九行。作者在描述里要求把类别重复到它覆盖的每一行,三个直接读PDF的模型,都在30行上填入了类别
这比单独说识别表格多走了一步
你开始定义一行数据究竟代表什么。跨行的视觉关系,需要怎样落成一个平坦列表,才能交给后面的程序
我自己的理解是,字段描述在这里承担了部分数据契约,而不只是提示词里的客气补充
当然,描述写过也仍然可能失败。复盘中的DeepSeek加OCR路线,在两个名称上保留了本来要求移除的脚注标记
有要求、有结构,依然需要对照
跨页处理也不能只看是否返回了一个列表。教程把58行发货日志写入CSV时,第二页重复出现的表头被合并,最后只有一行表头和完整的58行数据
如果你只数输出里有多少条对象,却没有弄清楚表头是不是被当成了记录,数量看上去接近,也可能藏着另一种偏差。这是从样本整理方式延伸出来的检查思路,不是这次测试额外发现的一项故障
这也是五份测试文档由已知数据生成的意义。作者可以知道某个单元格应该是什么,而不只是看返回结果像不像
否则,光看一份排得整整齐齐的JSON,很难发现它在某处少了一行、多留了一个符号,或者错误理解了合并关系
教程还给了一个挺克制的对照,pdfplumber
在相同样本里,它找到了三个数字PDF中的全部表格,但返回的是字符串。多级表头拆成多行,合并单元格里有None,两页发货日志则各自成为一个表格
在两个扫描件中,它没有找到内容,因为没有可读取的文本层
看到这里,我反而不觉得一定要把所有抽取都换成模型
对于简单、稳定、带文本层的表格,传统库已经能完成不少工作。是否引入模型,要看你需要处理多少版面关系、跨页合并和字段清理
这也是原文保留的选择,而不是一个为了衬托新方案专门安排的失败对手
回到那组644个单元格全对的数据,它仍然值得看,只是要把范围一起留下
每条路线在五份文档上各运行一次,文件总共六页,使用默认提供商路由,再逐格比对。这里没有足够证据把结果扩成任何扫描质量、任何版式都能满分
原文自己也强调,这些结果描述的是这组测试,而不是模型的一般性能
成本同样如此
教程给出的每千页约0.77美元和1美元,是GPT-6 Luna与Claude Haiku 5.5在六页样本上的总usage.cost按比例放大,并不是实际跑完一千页后的统计
OCR路线还要把每千页2美元的解析费用算进去。模型token单价低,不代表经过整条路径之后一定更便宜
这些是测试采用的价格口径,文章里的目录和折扣也有各自日期。真到选路线时,还是要读自己请求返回的用量,再看文件密度和布局
我不会从这六页测试里,替你推一个固定的全年处理预算
更有用的,也许是把比较的对象从模型名称,移到完整的数据路径
输入有没有被读到,字段关系有没有说清,输出有没有写完,最后的行数和小计能不能对上
这几件事,分别卡在不同位置。只在最外层捕获异常,还看不见其中所有问题
坦率地讲,我自己还没有把这套方案放进真实文档积压任务里跑过。面对一批版式各不相同的文件,先做一组能逐项对照的样本,会比盯着一次成功响应更踏实
你可以先看原件预期有多少行,再看返回了多少。遇到扫描件,确认使用的究竟是文本解析还是OCR;遇到长表,先看结束原因,再考虑把数据写下去
这些动作听着没有换一个更强模型那么兴奋,却离数据是否真的可用更近
还有一点得说清楚。拒绝空数组、拒绝截断响应,能抓住教程演示的两种失败,并不覆盖所有漏行
如果模型正常结束,却漏看了其中一部分,finish_reason可以是stop,rows也可以不为空。两项检查都过了,完整性仍然要拿原件核对
原文提到,五份文档的25次提取中,没有观察到编造行。作者同时说明,这不能排除其他文档里出现这种情况
我喜欢把这句话和满分数据一起看。一个小测试能告诉你某条路值得继续验证,也能帮你找出明确的失败方式。它不需要装成一个覆盖所有文件的保证,才算有价值
这篇教程里,我最后记住的还是那5行
它们不是乱码,也不是报错。恰恰因为看起来正常,才需要有人记得,原来的文件有58行
资料来源AIHOT · PDF表格抽取教程全文OpenRouter · How to Extract Tables from a PDF with an LLM案例与数字来自原文测试,非作者独立实测