ARTICLE · 1278216
多模态大模型文档智能解析与复杂版式信息抽取平台详细设计方案(WORD)
多模态大模型文档智能解析与复杂版式信息抽取平台详细设计方案(WORD)针对政务与企业文档在多栏排版、无线表格、公式、印章和手写批注混排场景下,传统OCR版面还原失真、语义割裂、跨页断裂,且人工核验成本高等问题,项目拟建设多模态大模型文档智能解析与复杂版式信息抽取平台。平台建设图像预处理、细粒度版面分析、复杂表格与公式结构化还原、跨页合并,基于多模态大模型的动态字段抽取、联合置信度回填与人机协同复核闭环,并对批量处理吞吐进行工程优化,提升非结构化数据治理与业务自动化水平。 PART.01 宏观政策背景 在政务公文流转、金融财报审计、招投标管理和历史档案数字化等业务中,海量非结构化文档需要标准化入库并支撑业务自动化。视觉与语言多模态大模型的语义理解能力,为复杂文档解析提供了新的技术条件。项目参照GB/T 8567-2006、GB/T 39046-2020和GB/T 22239-2019等标准,落实等保三级、国密算法、数据脱敏和信创适配要求。 PART.02 行业现状与痛点 传统OCR在面对多栏排版、密集无线表格、数学与化学公式、印章遮挡和手写批注混排时,常出现版面还原失真、语义割裂和跨页表格或段落断裂等问题。印章会覆盖正文,手写签批难以与印刷体正文关联,字段抽取的可靠性也难以量化。这些环节高度依赖人工录入和核验,批量处理效率低,制约了数据资产化和业务自动化。 PART.03 建设必要性 建设具备高并发批量处理能力的文档智能解析平台,可以把复杂版式文档统一转化为可检索、可校验、可追溯的结构化数据,降低人工录入核验成本。联合置信度评估和人机协同复核机制,能把有限的人力集中到低置信度字段上,同时让人工修正数据回流到模型迭代中。这对政务和金融等对准确性要求高的场景尤其重要。 PART.04 主要建设内容 项目覆盖复杂文档全流程,建设四方面内容: PART.05 技术路线 平台以“图像增强—版面分析—分块路由—多模态抽取—跨页合并—置信度评估—人工复核—模型回流”的DAG工作流为主线。CPU密集的预处理与GPU密集的多模态推理异步解耦,通过Kafka分区队列、Redis令牌桶和背压机制应对瞬时高并发。置信度由OCR字符概率、大模型Token对数概率和边界框定位得分联合计算,低于阈值的结果进入复核队列。技术上采用Spring Boot 3.3、Python 3.11、PyTorch 2.4、vLLM、Milvus 2.4、PostgreSQL 16和Kafka,并基于昇腾与鲲鹏、麒麟系统、达梦数据库做信创适配。 PART.06 预期目标与效益 按项目规划,平台预期达到版面分析mAP不低于95%、复杂表格结构识别TEDS不低于92%、公式识别BLEU不低于90%、关键字段抽取F1不低于94%,单节点复杂PDF吞吐量不低于15页/秒,在线解析P99响应不高于1.5秒。经人工复核后入库数据的准确性目标不低于99.9%。 这些指标属于规划目标,应在选定文档类型和测试集上实测验证,不作为已实现成效。 平台建成后,有望提升文档处理准确率和流转时效,降低人工录入核验成本。 PART.06 以下为方案全文 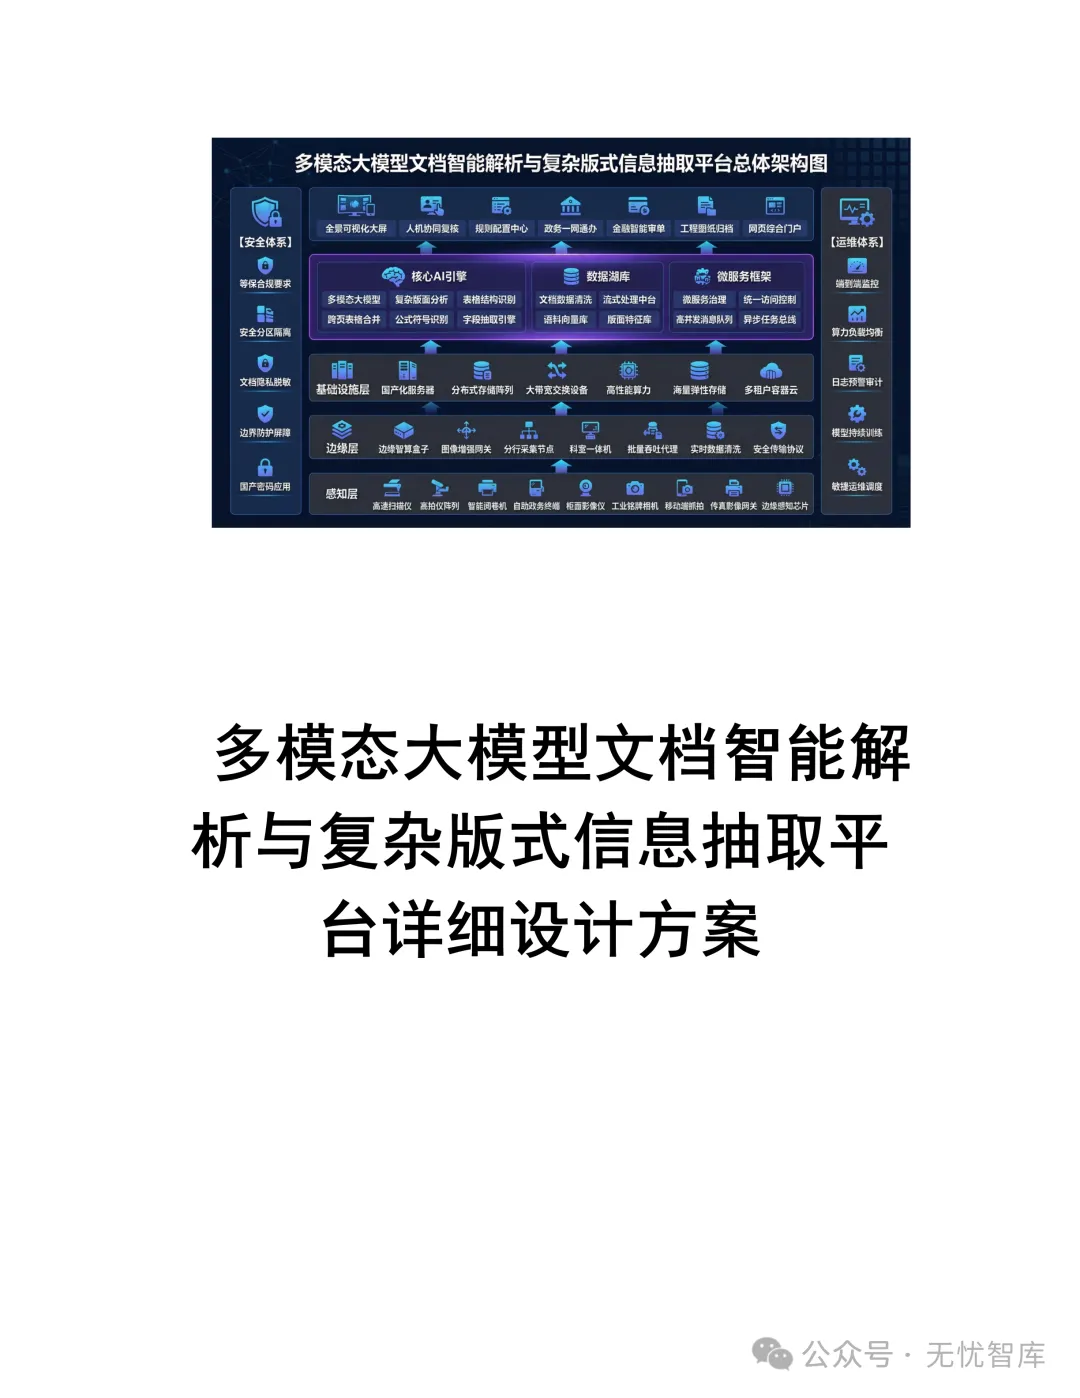
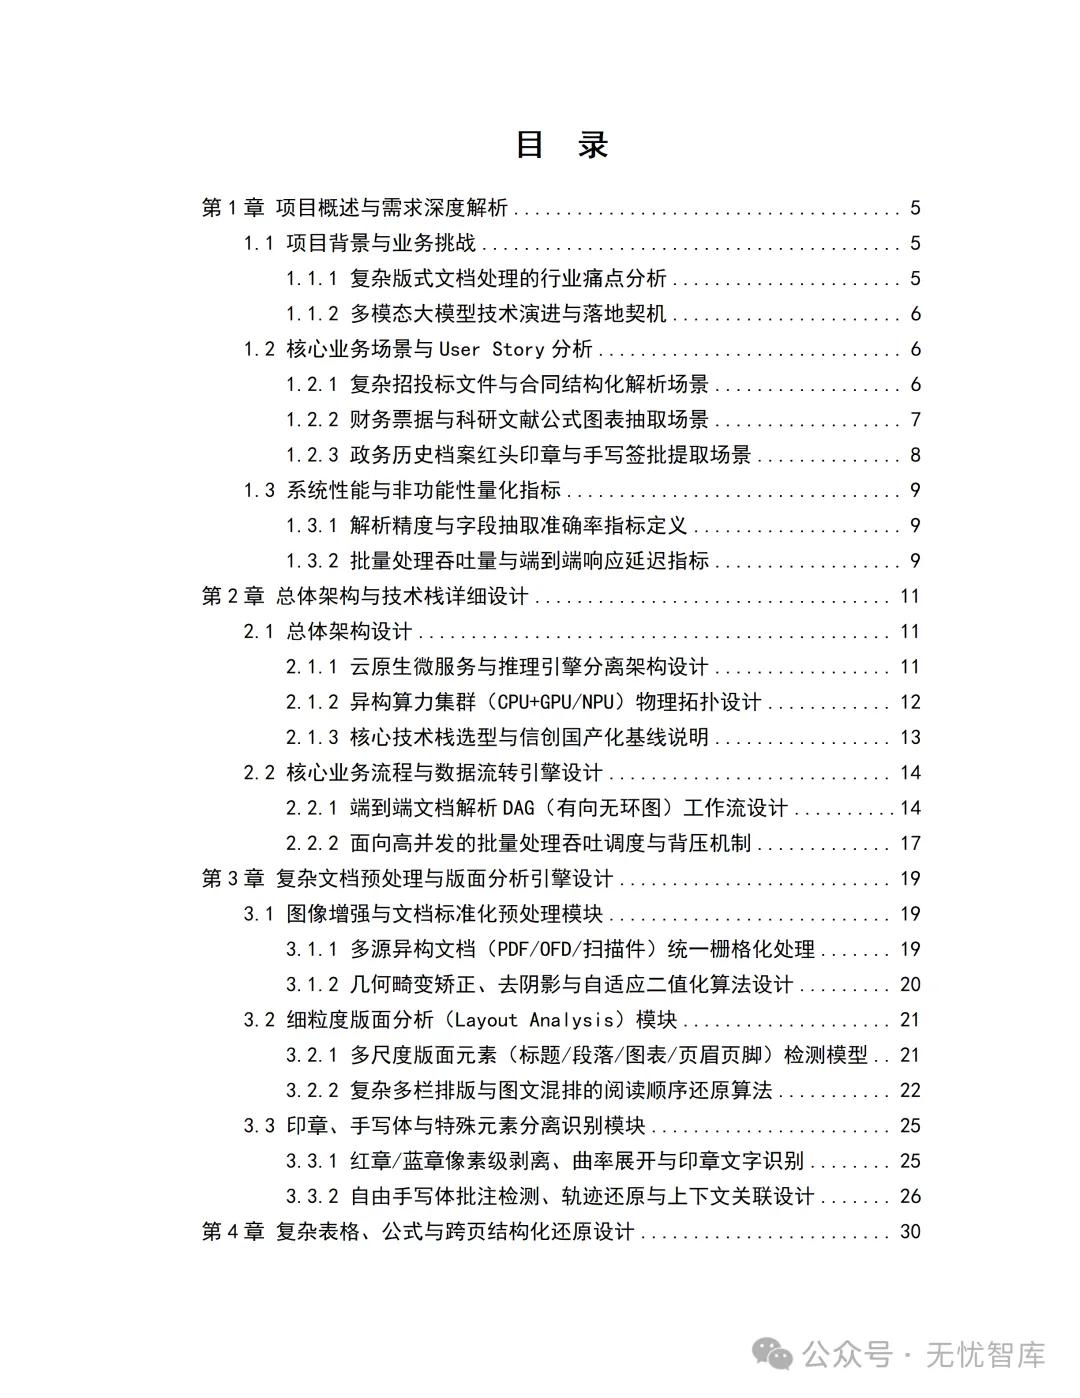
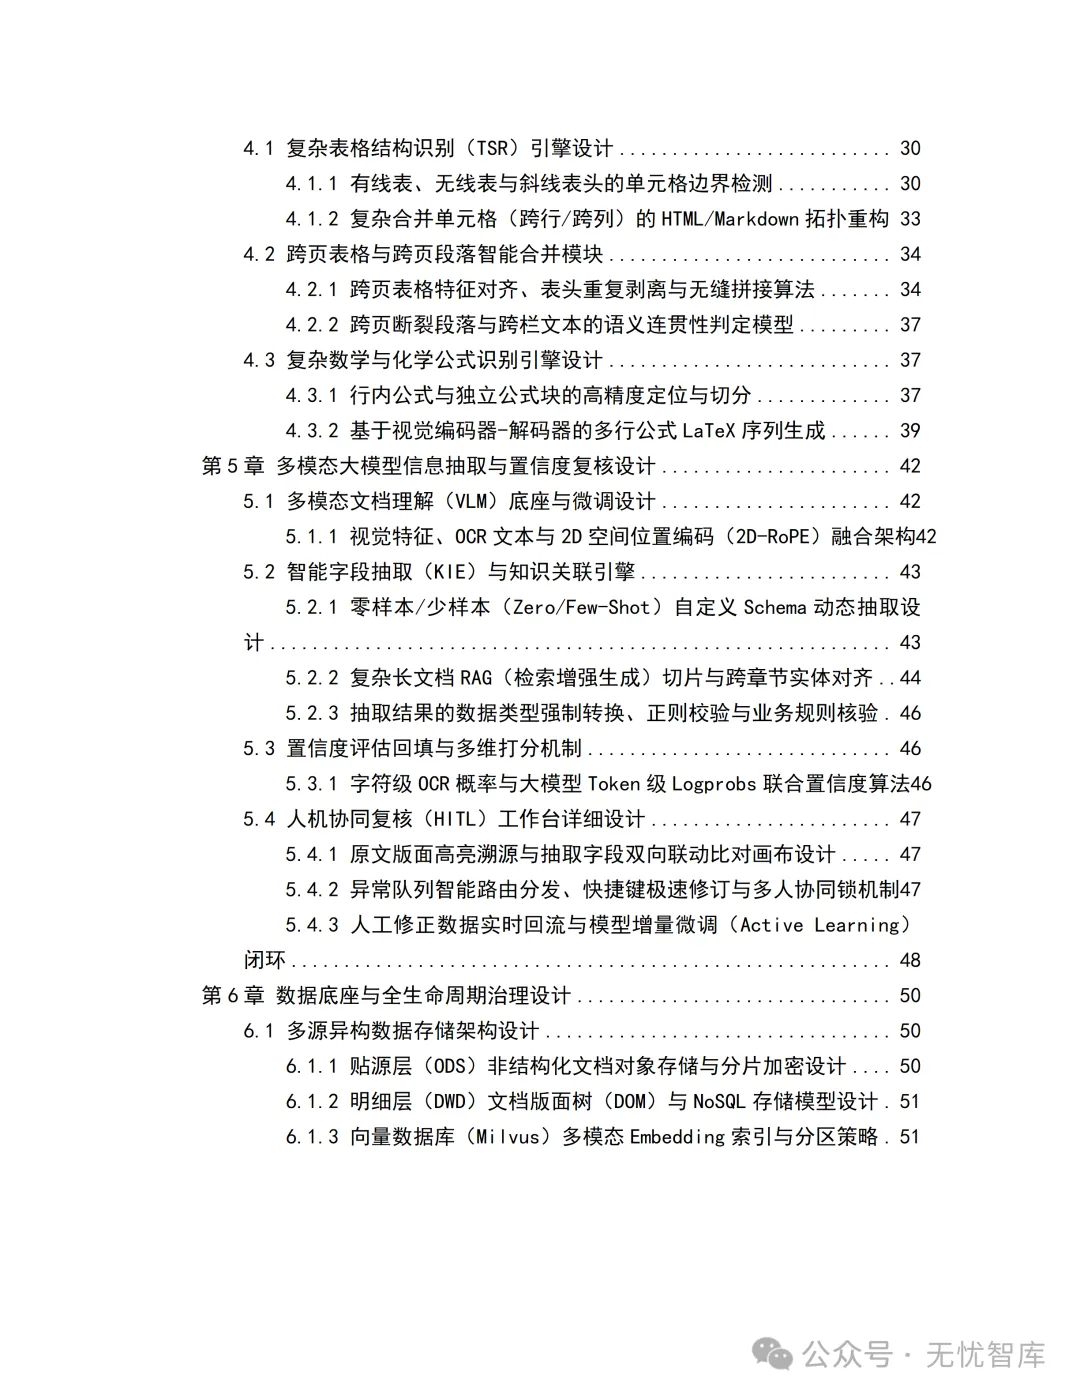
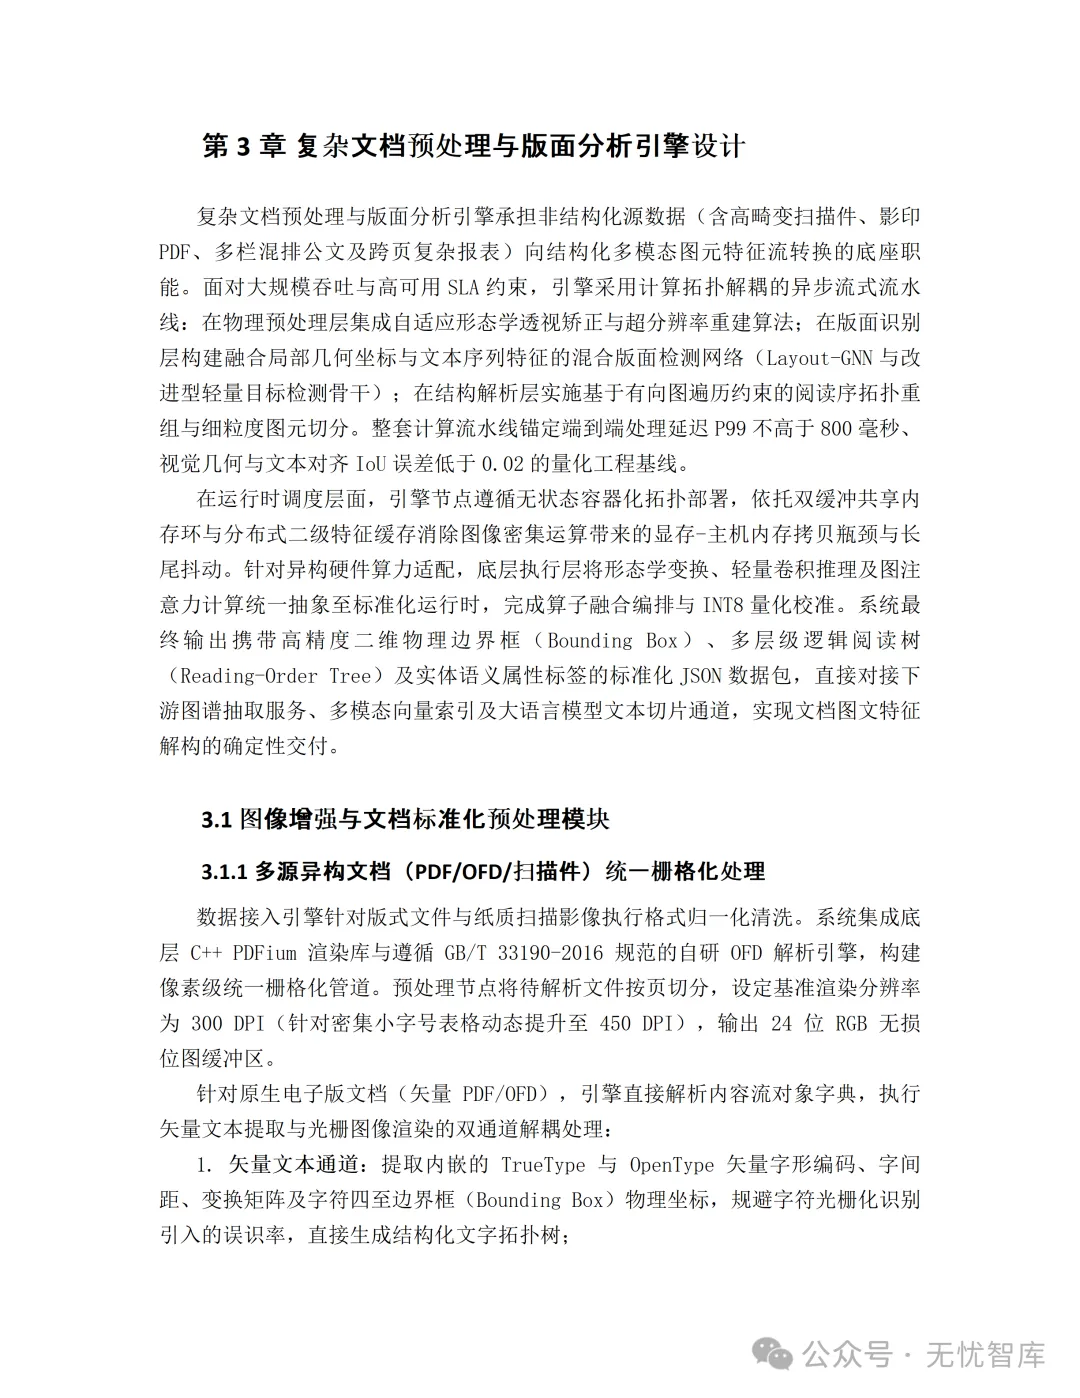
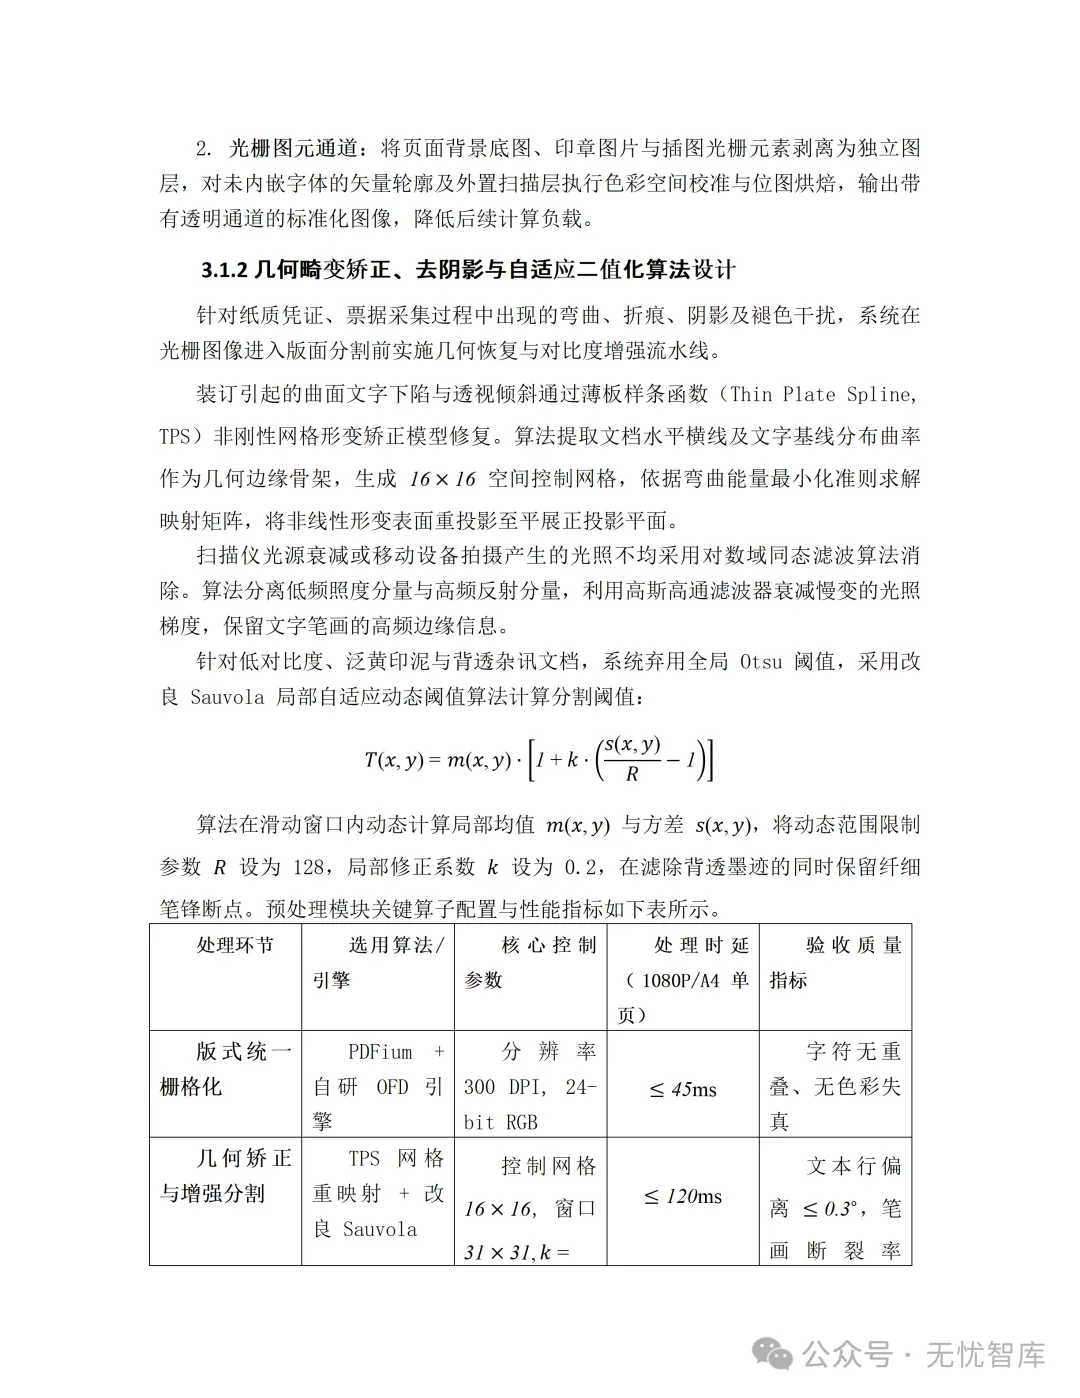
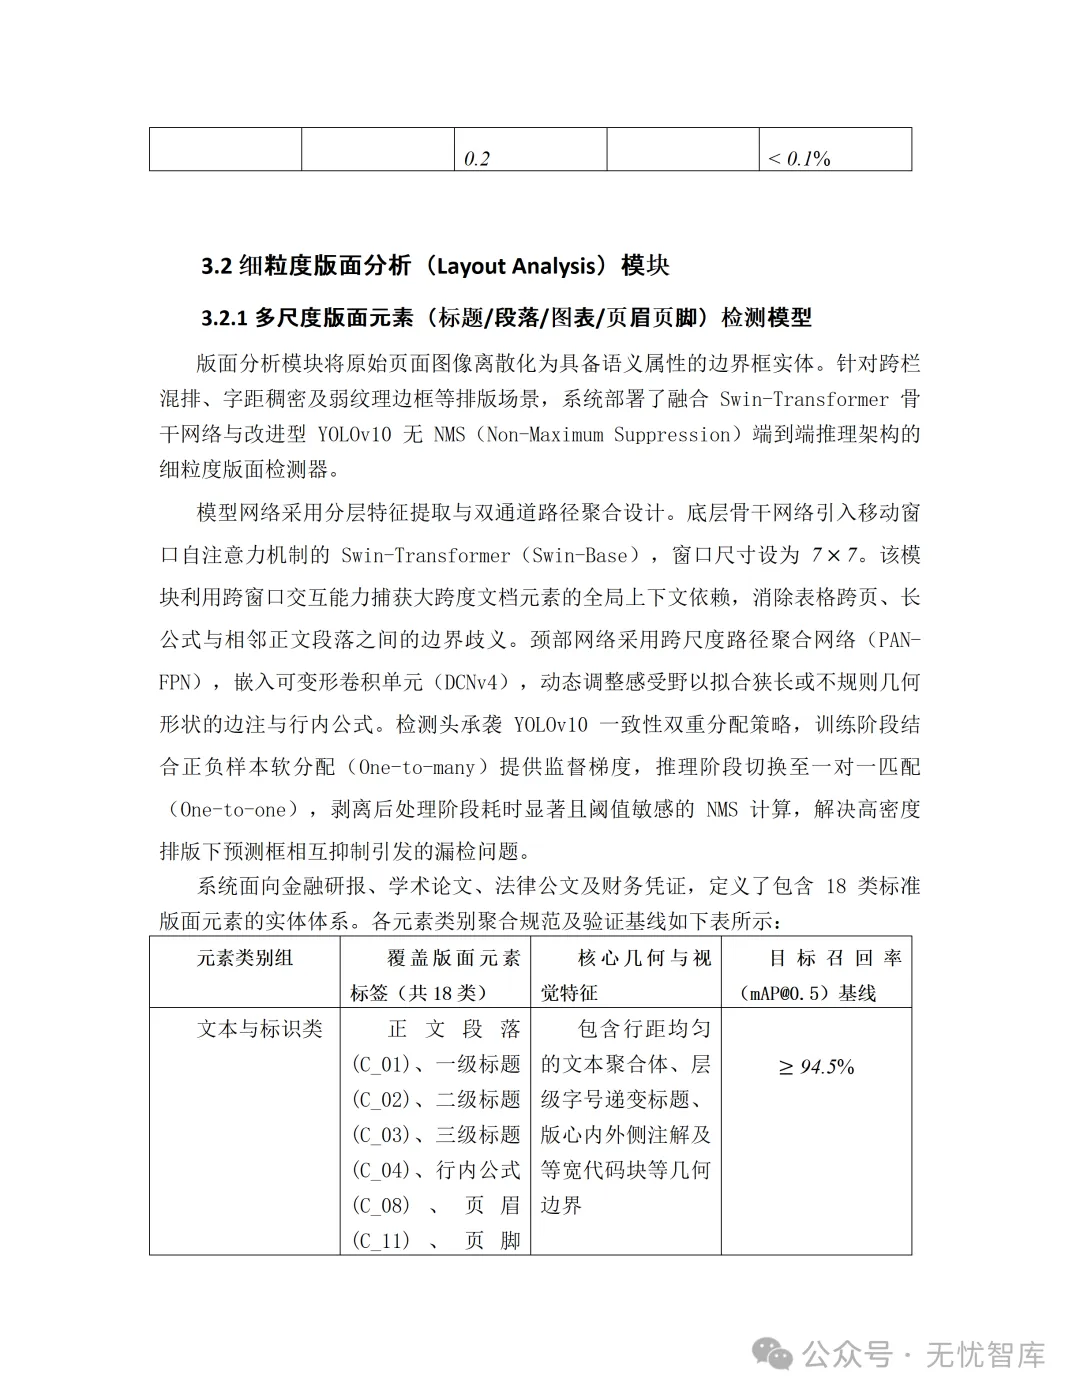
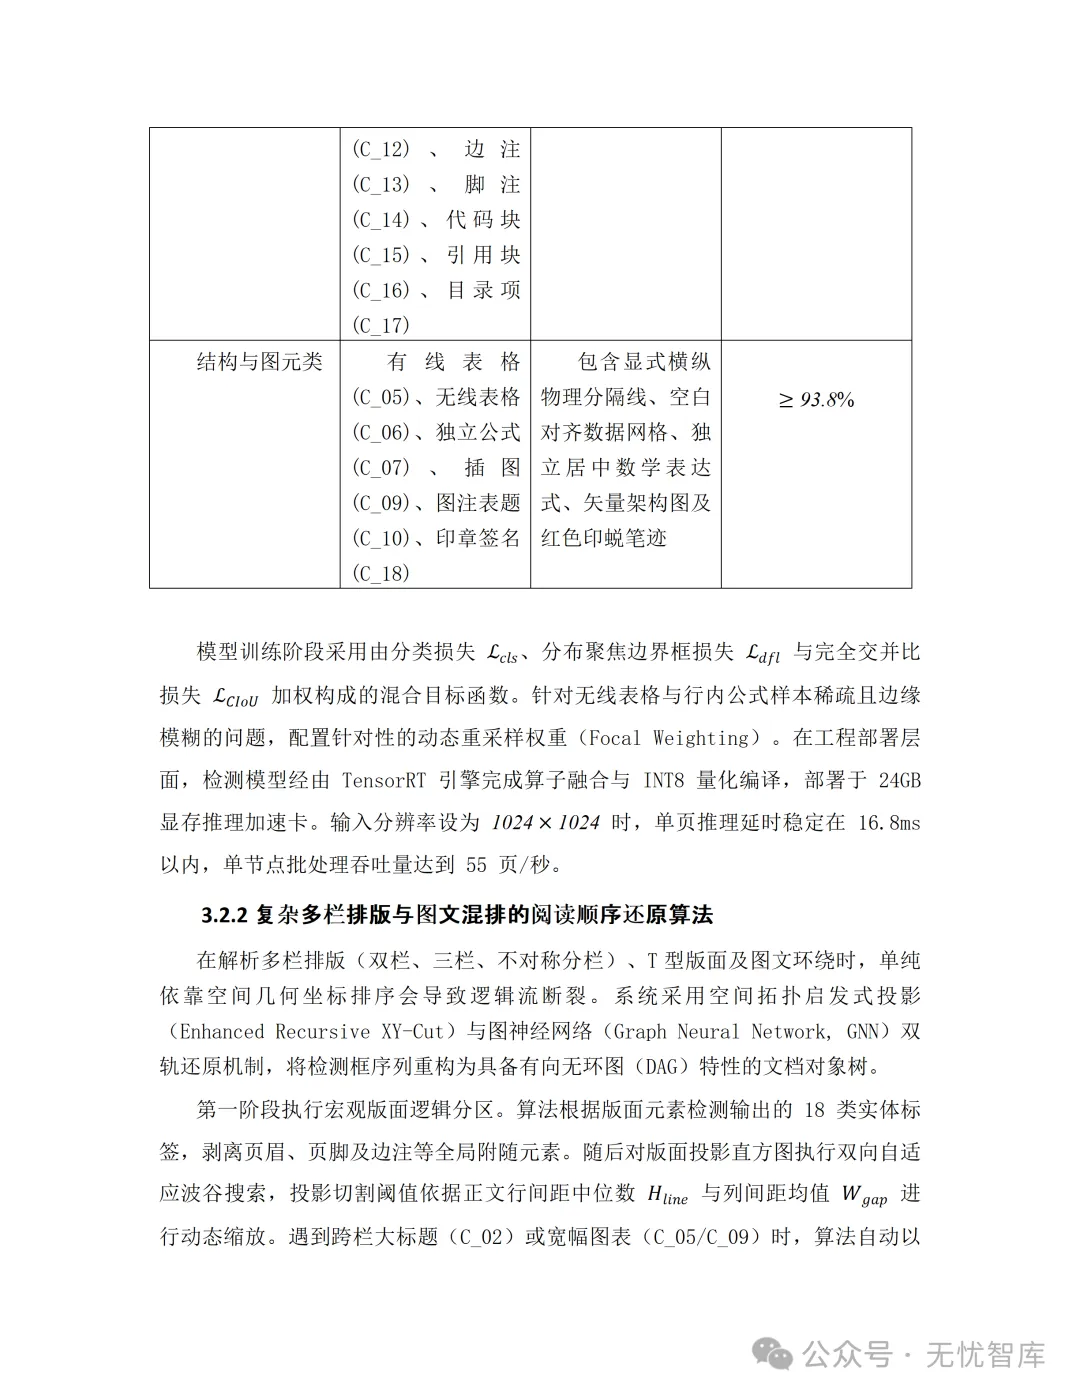
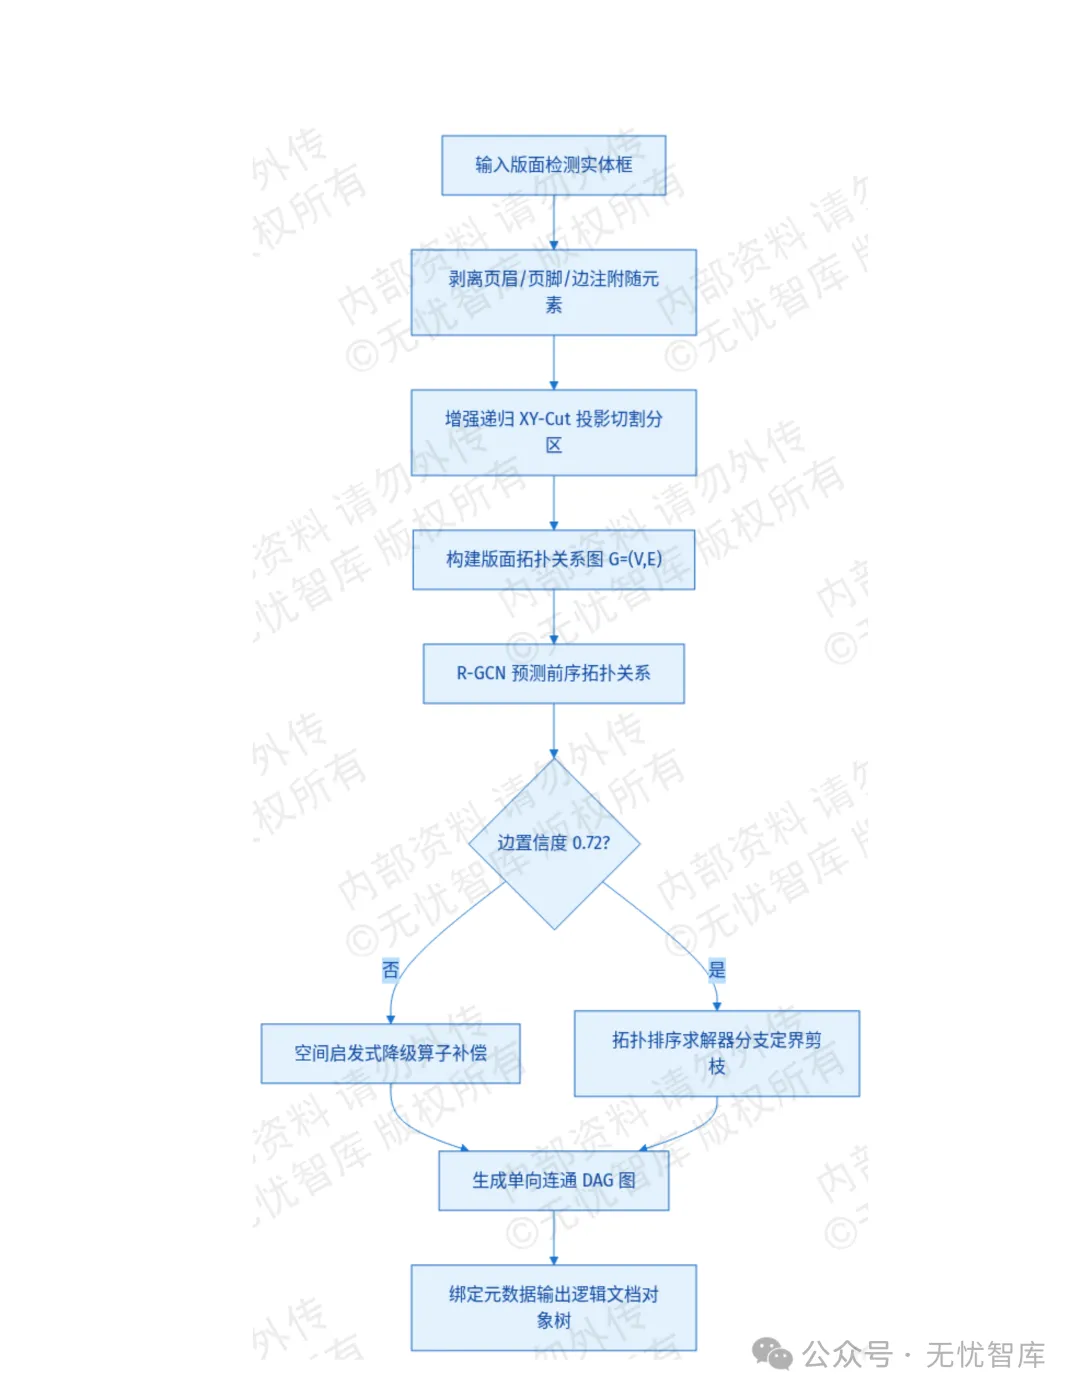
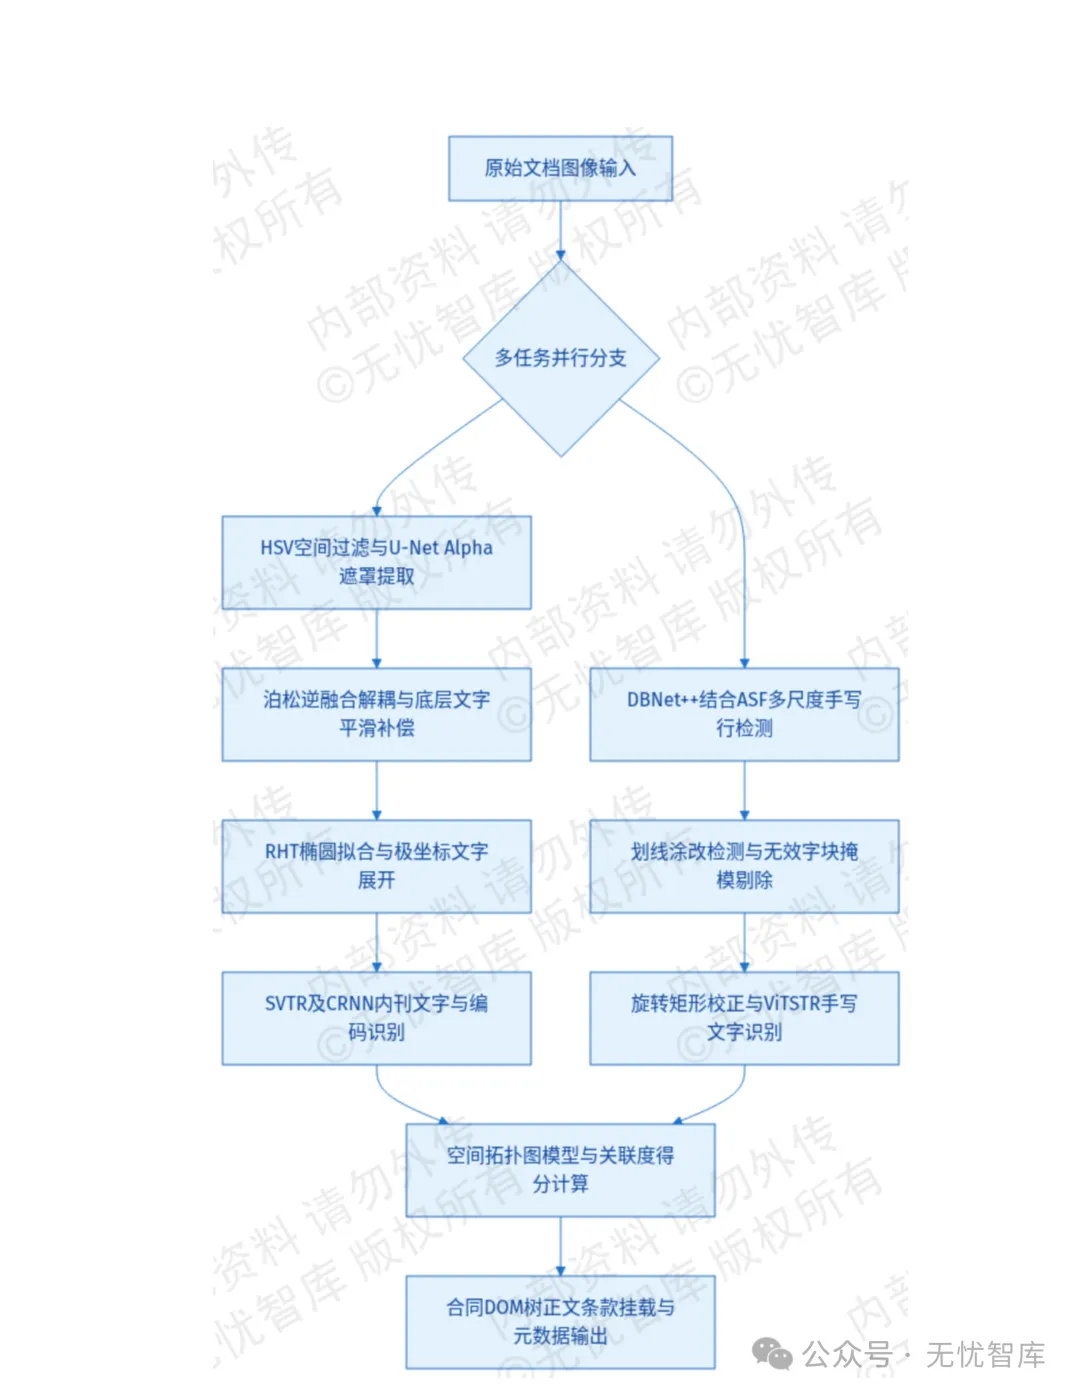
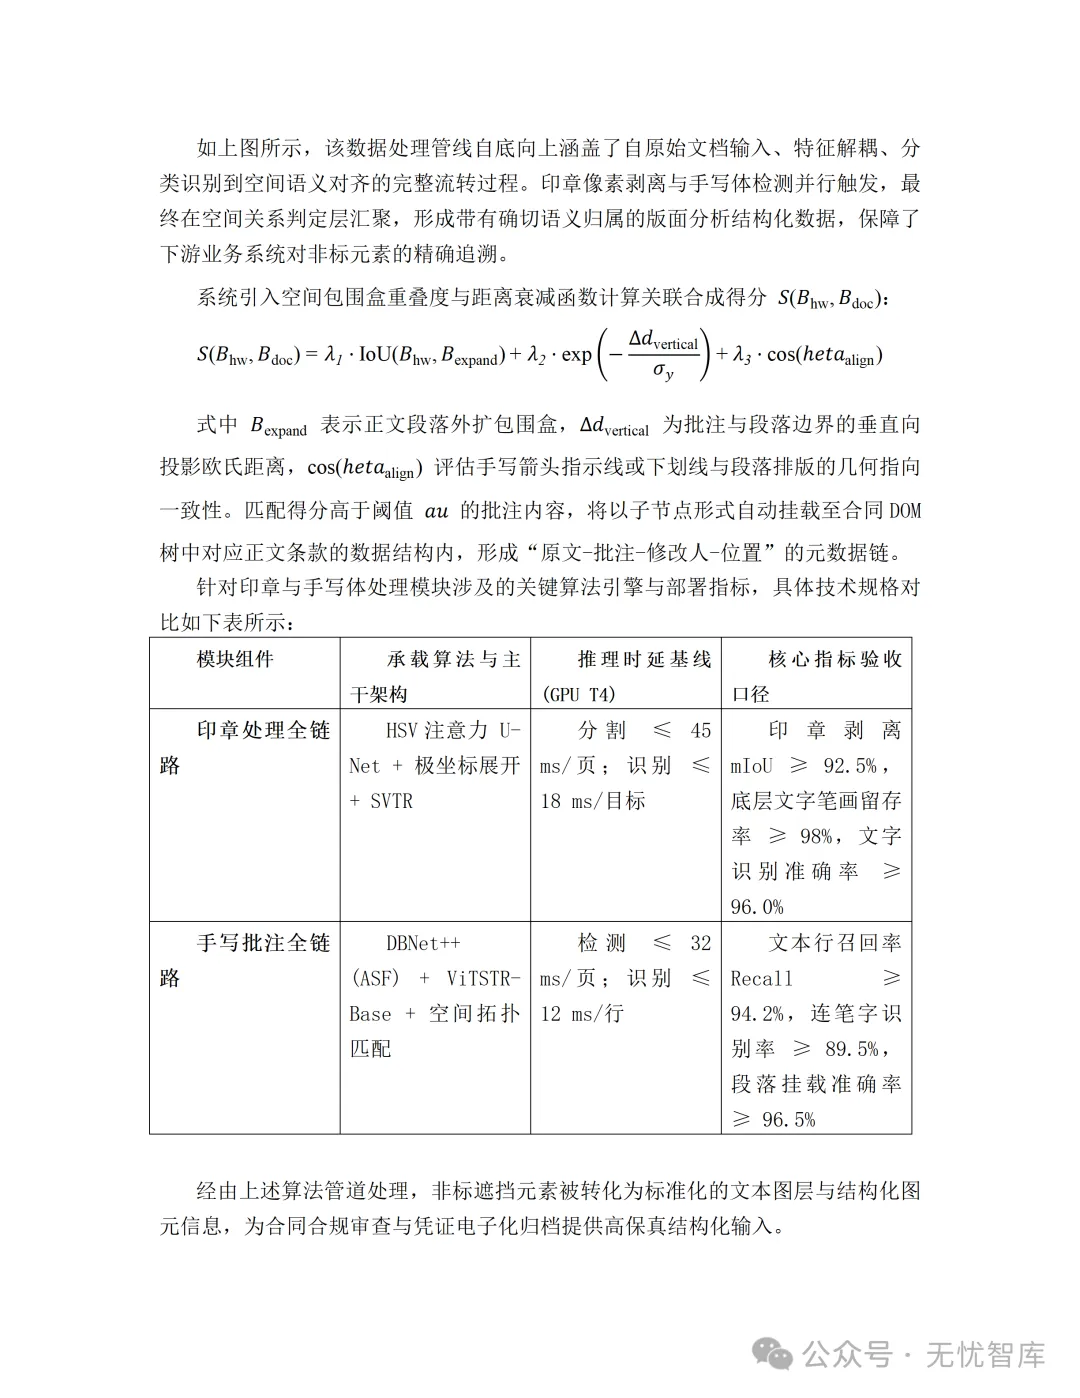
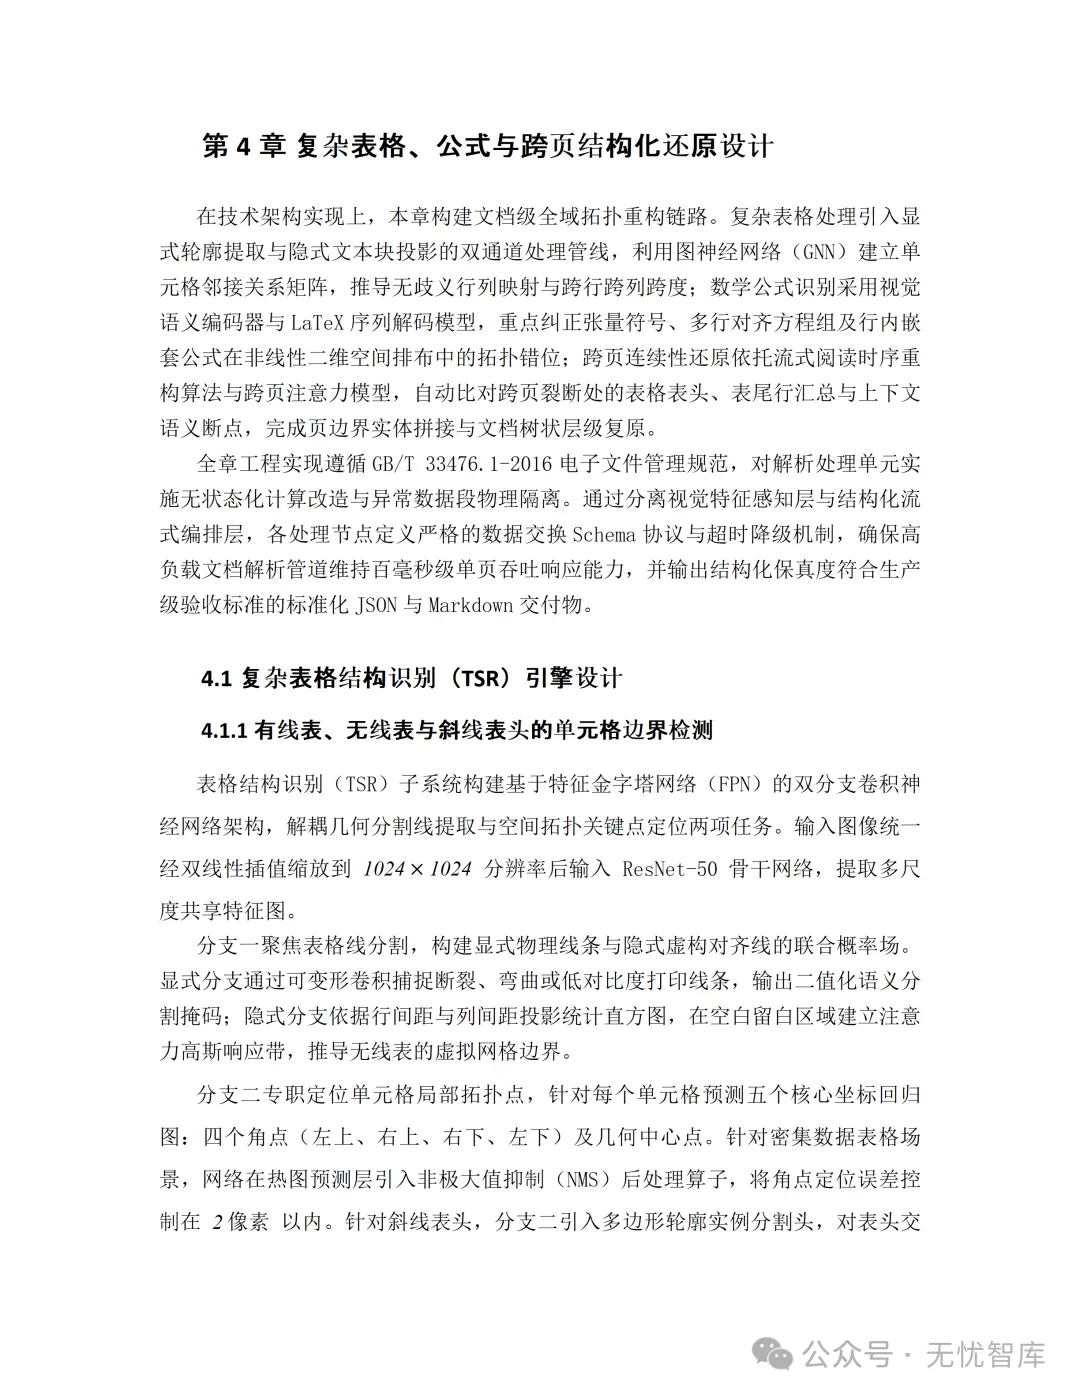
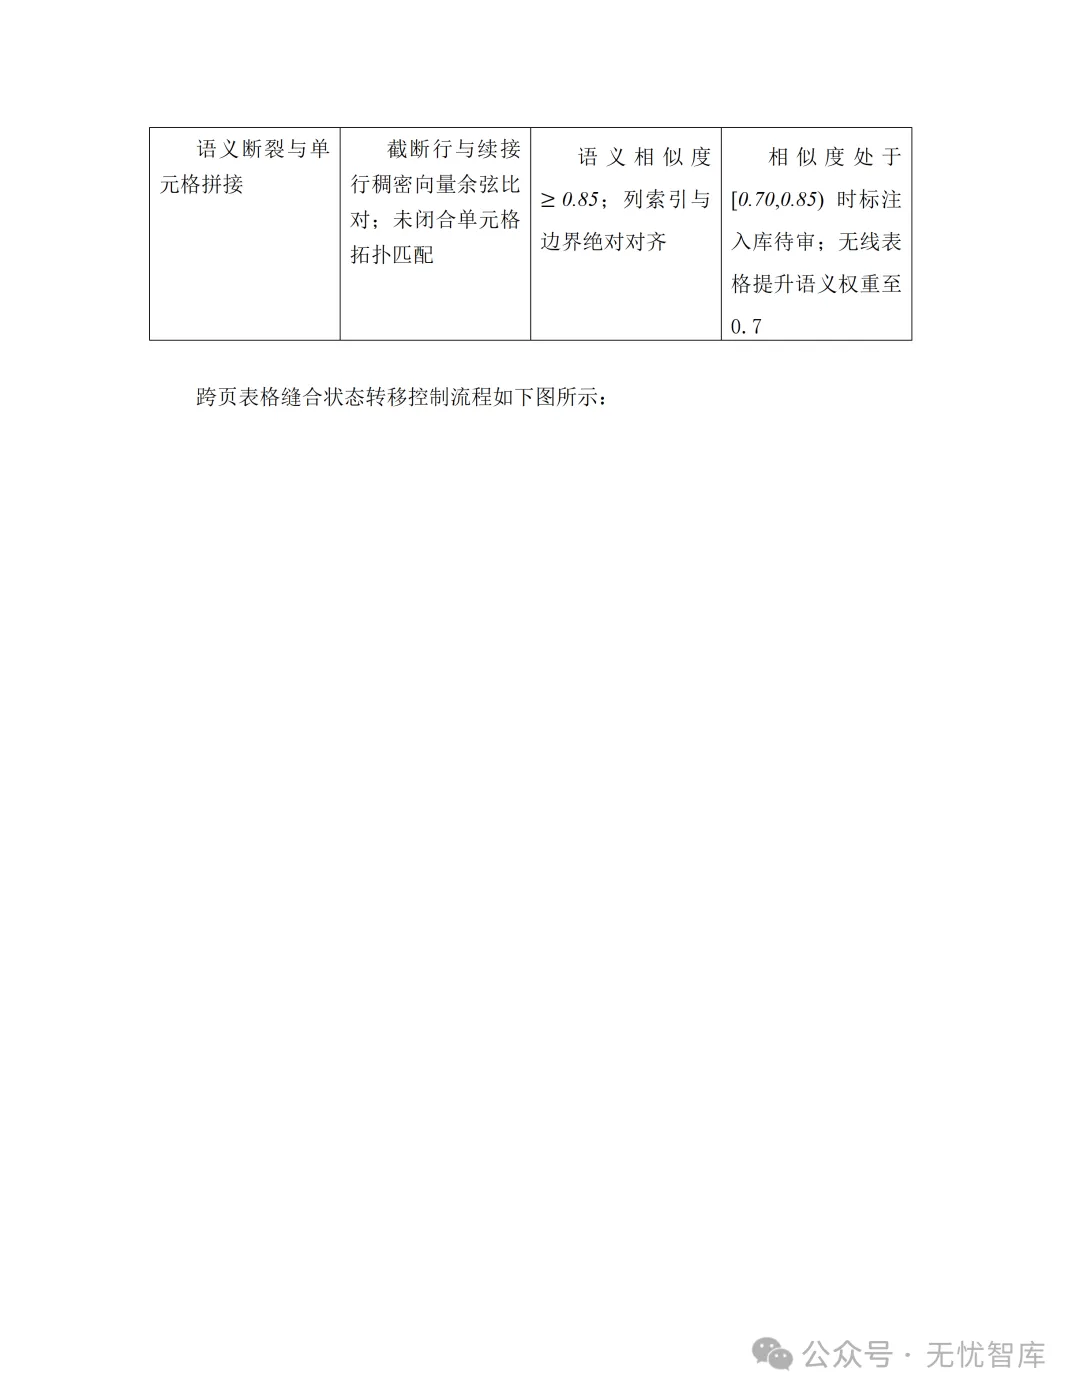
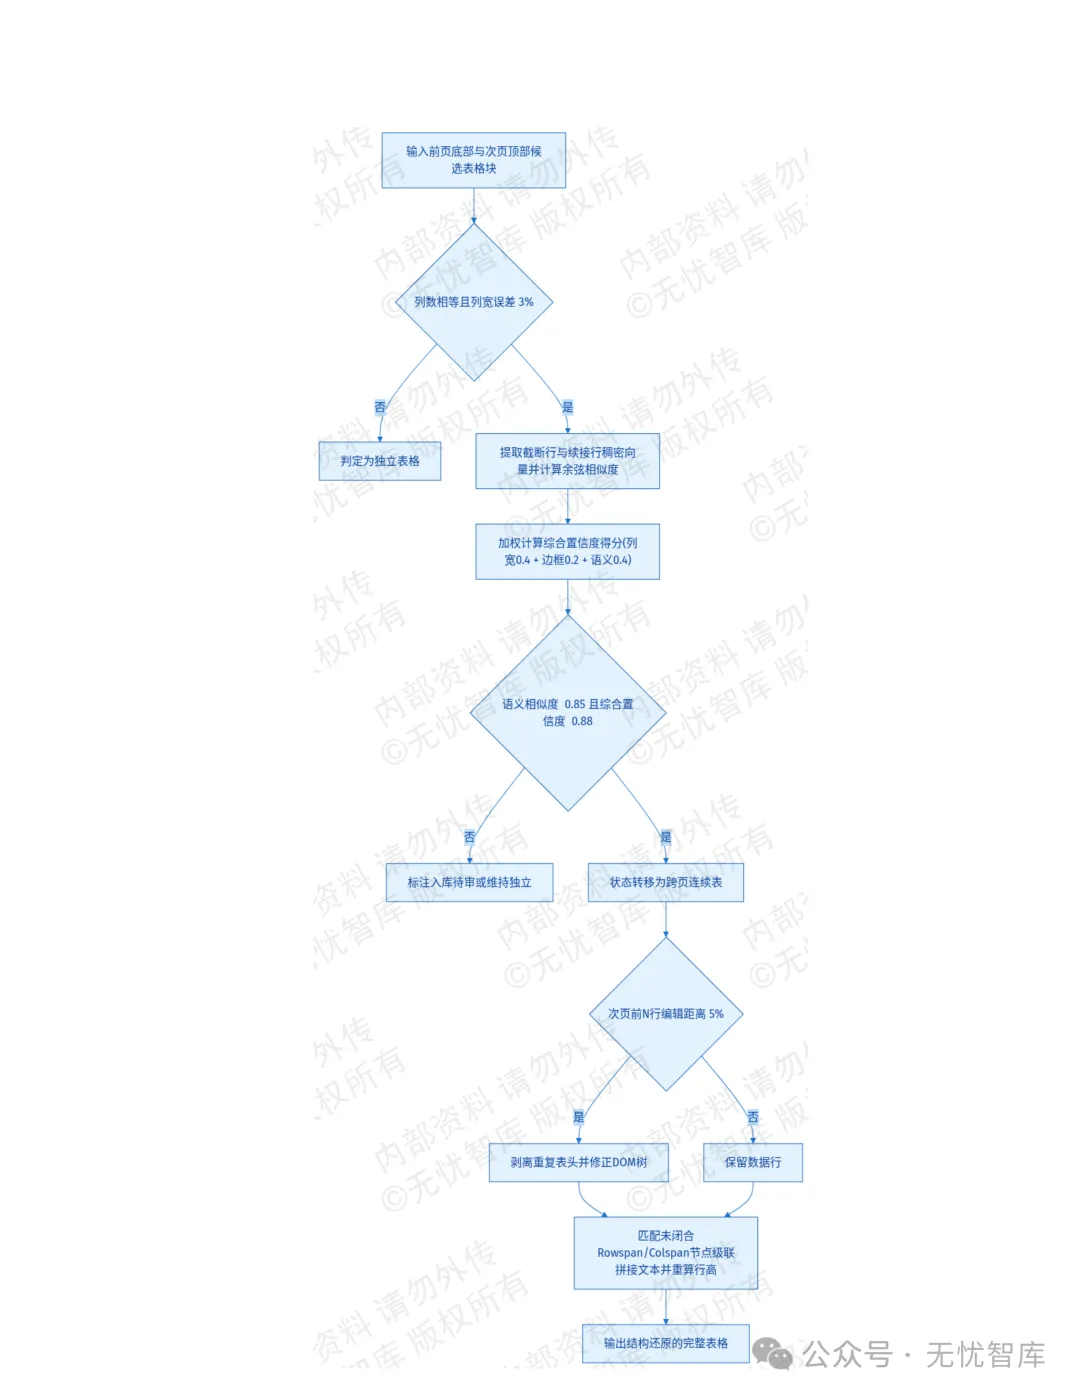
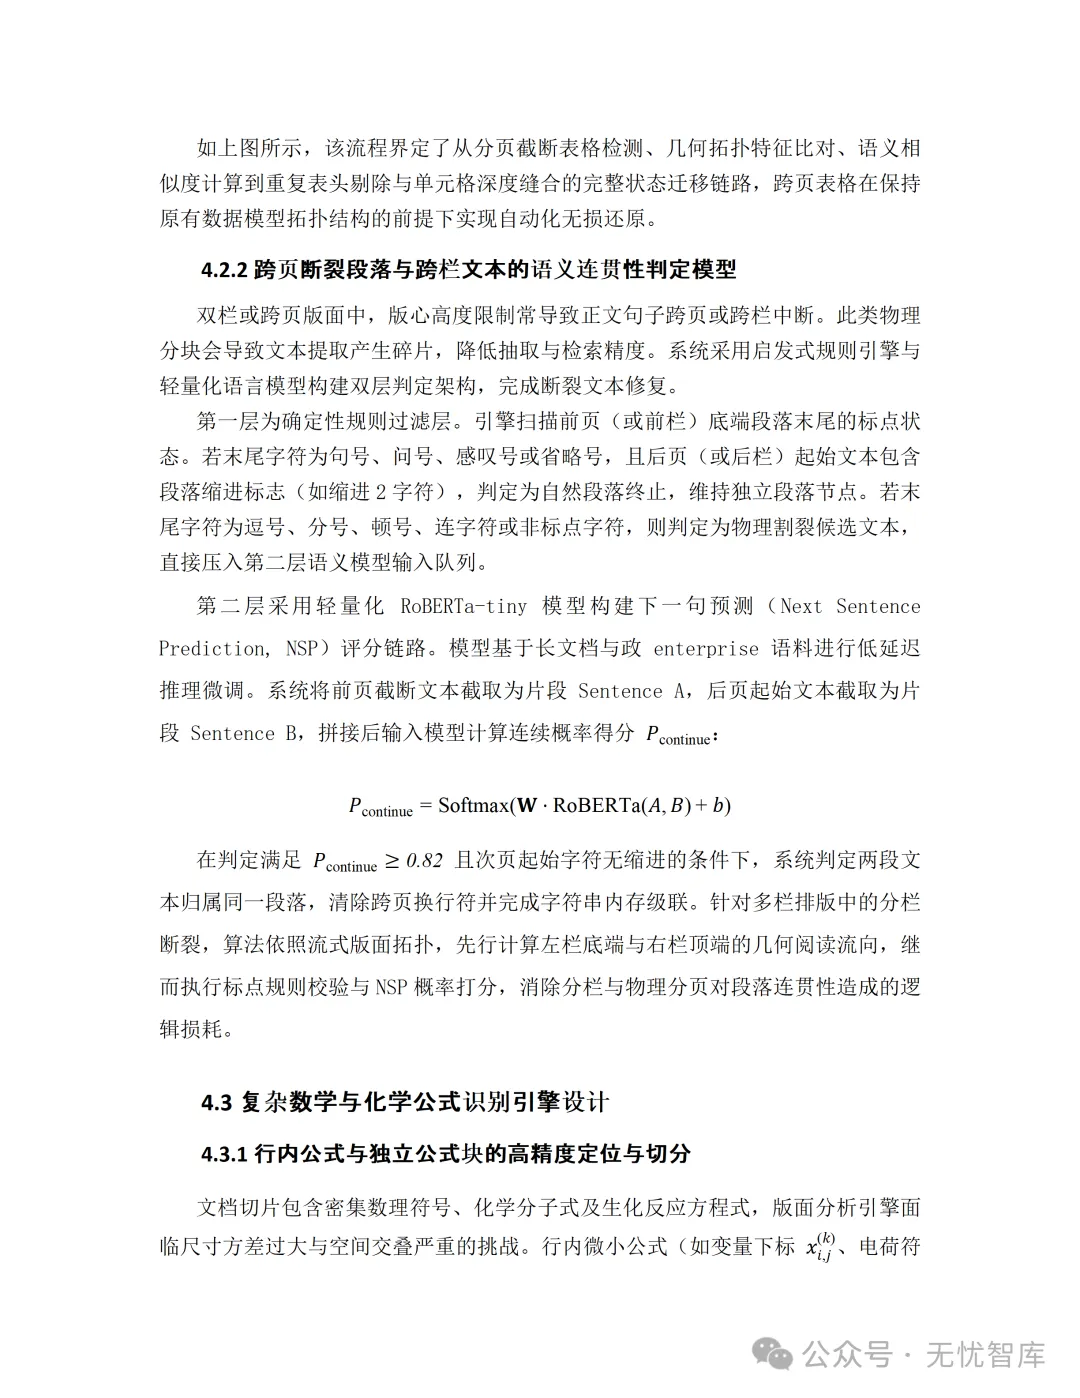
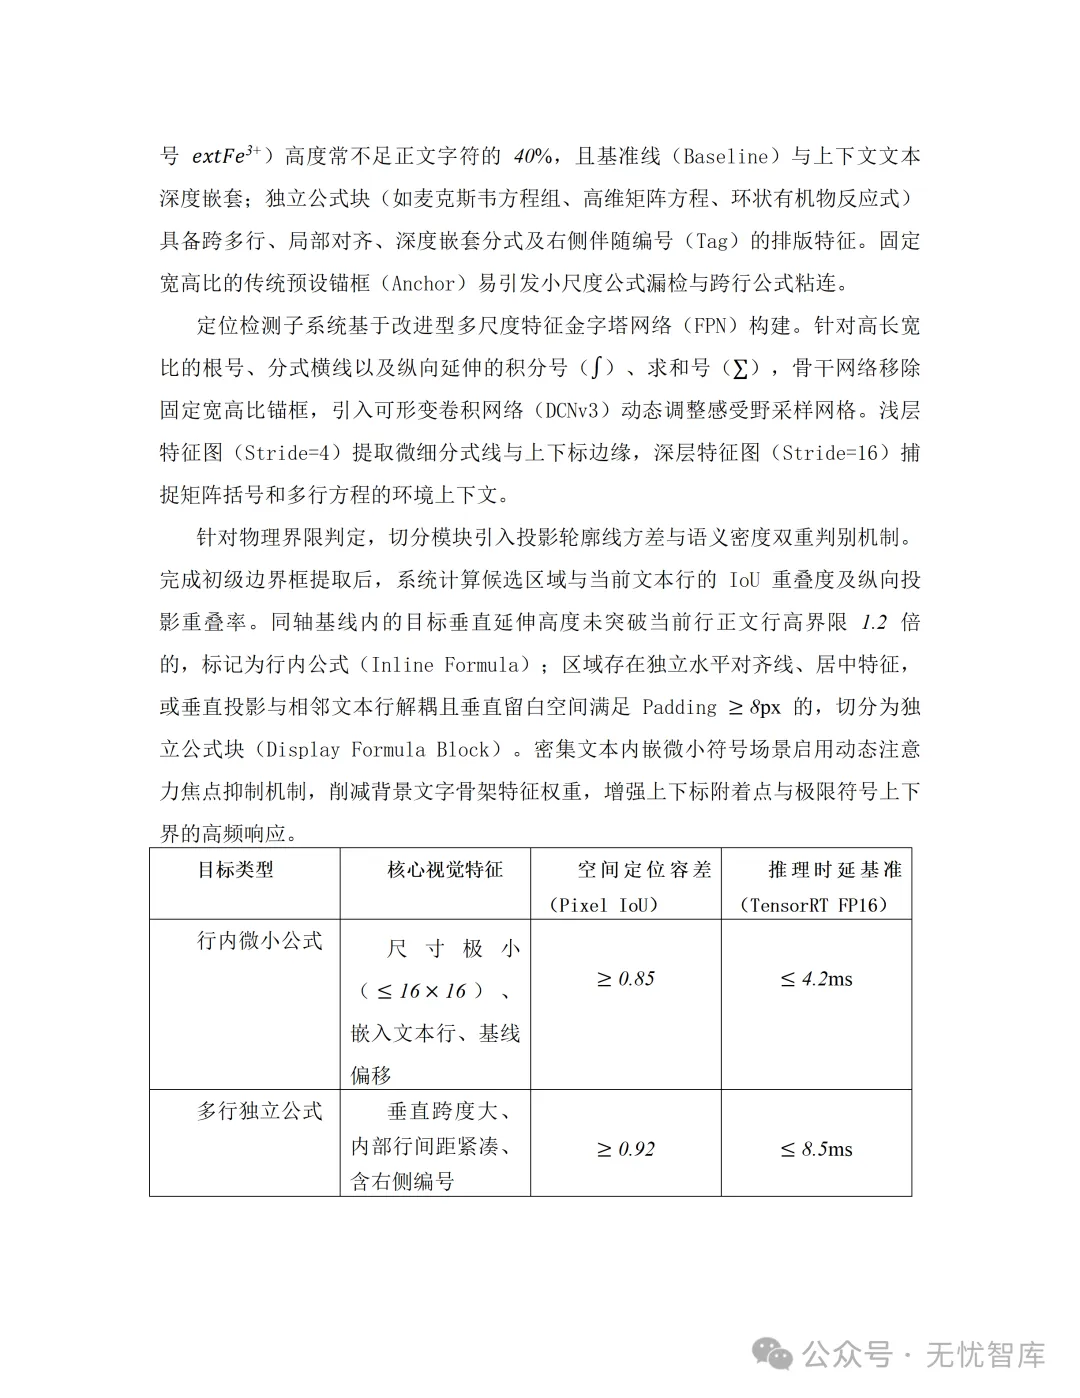
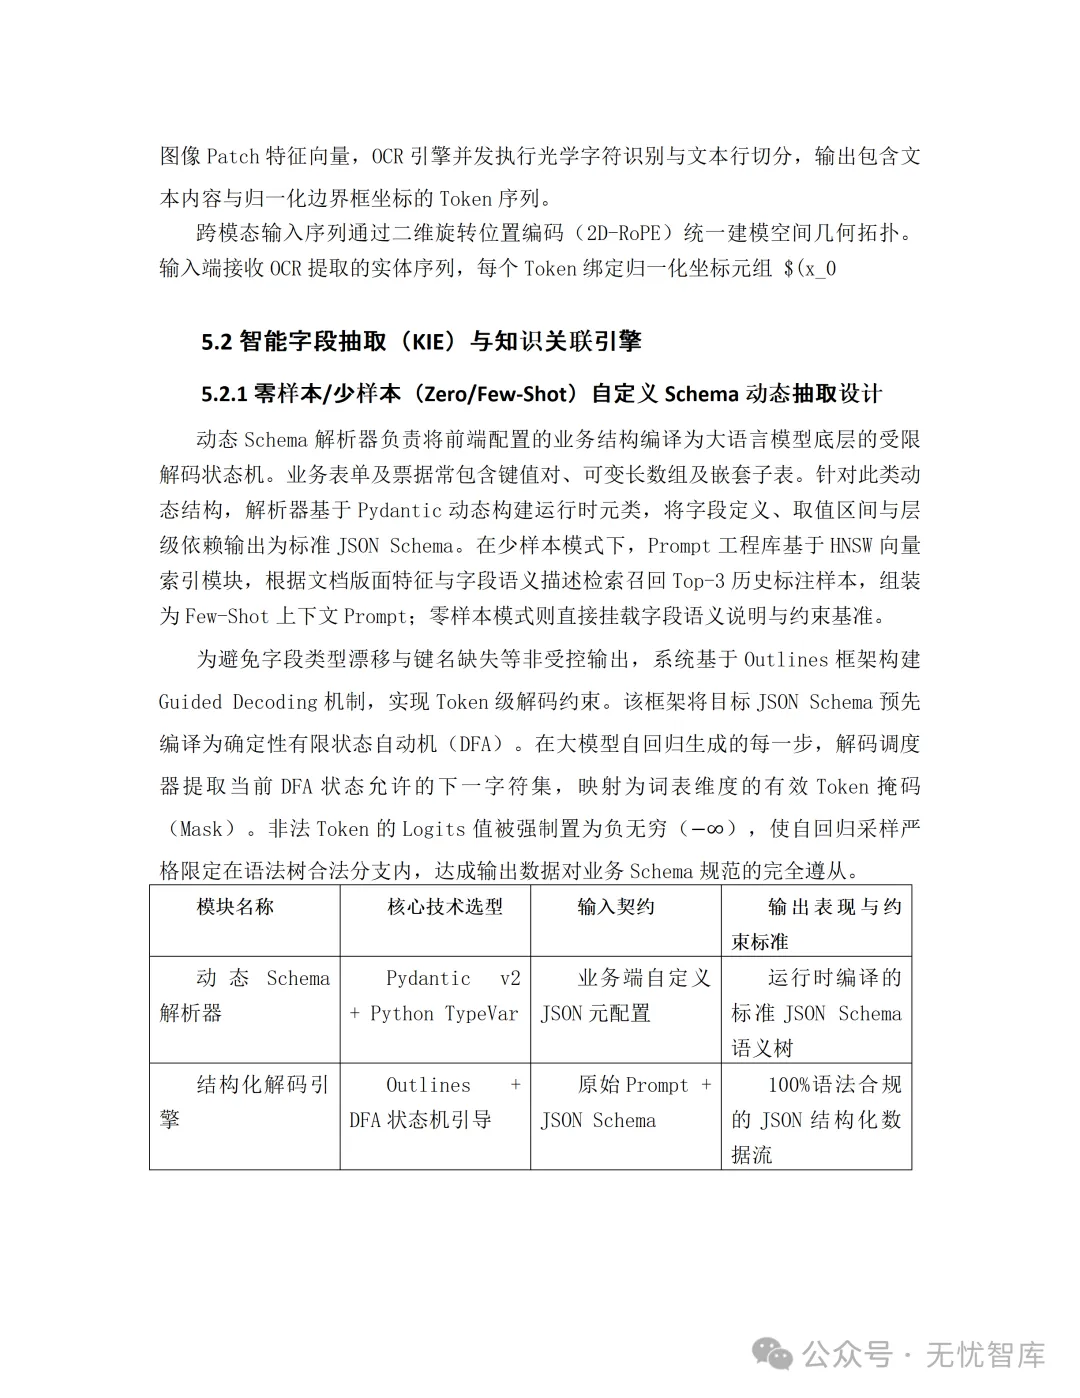
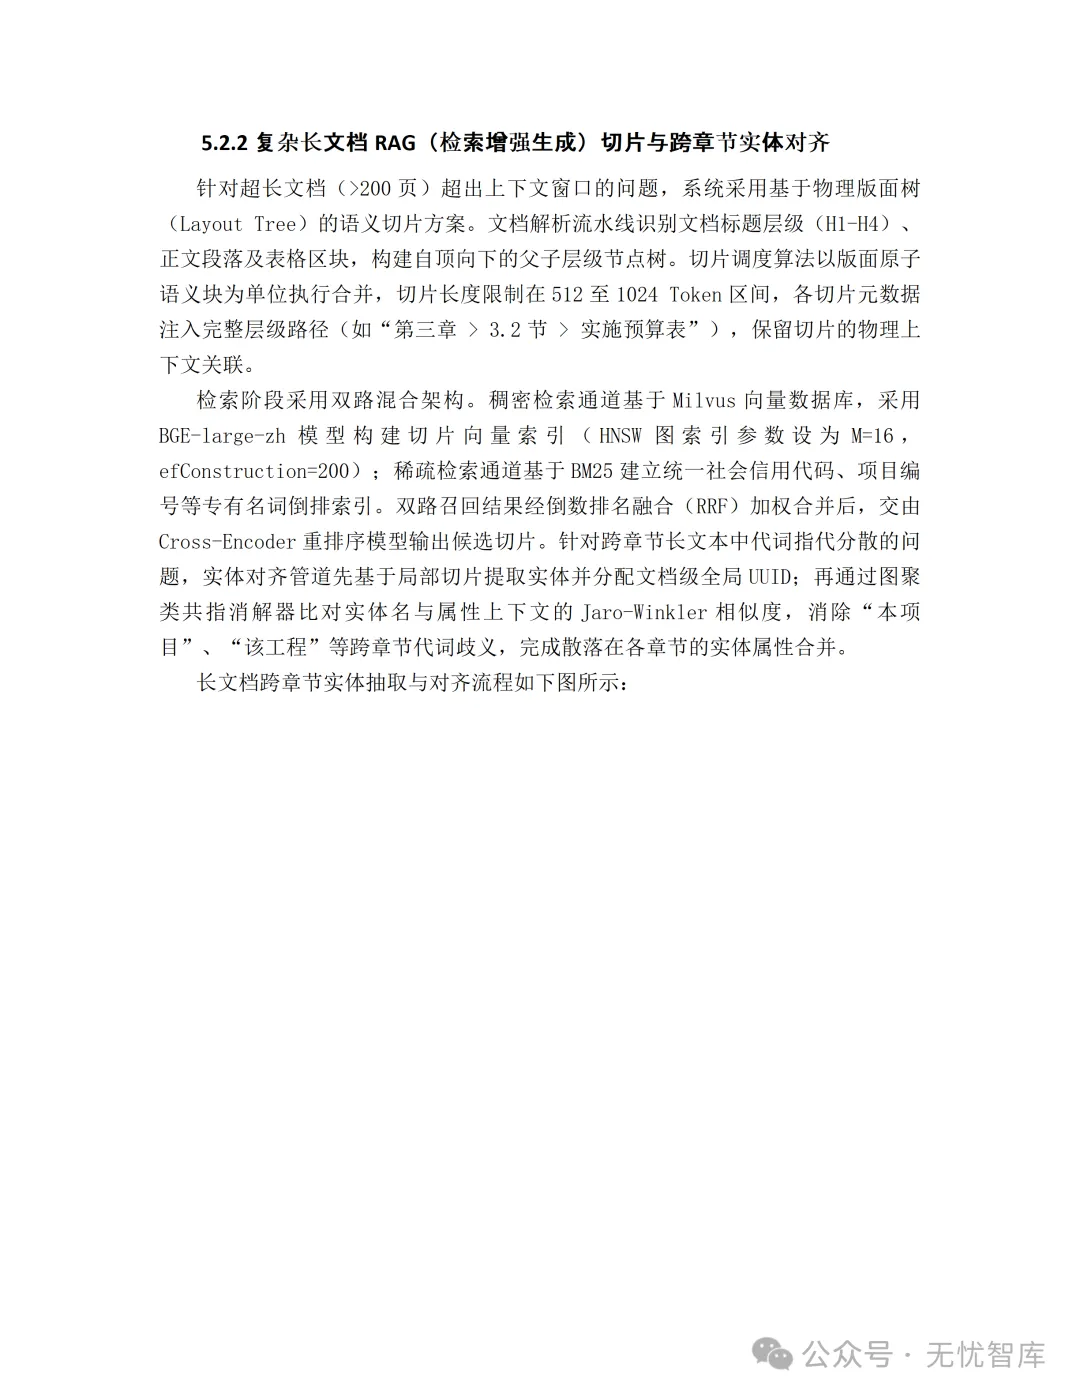
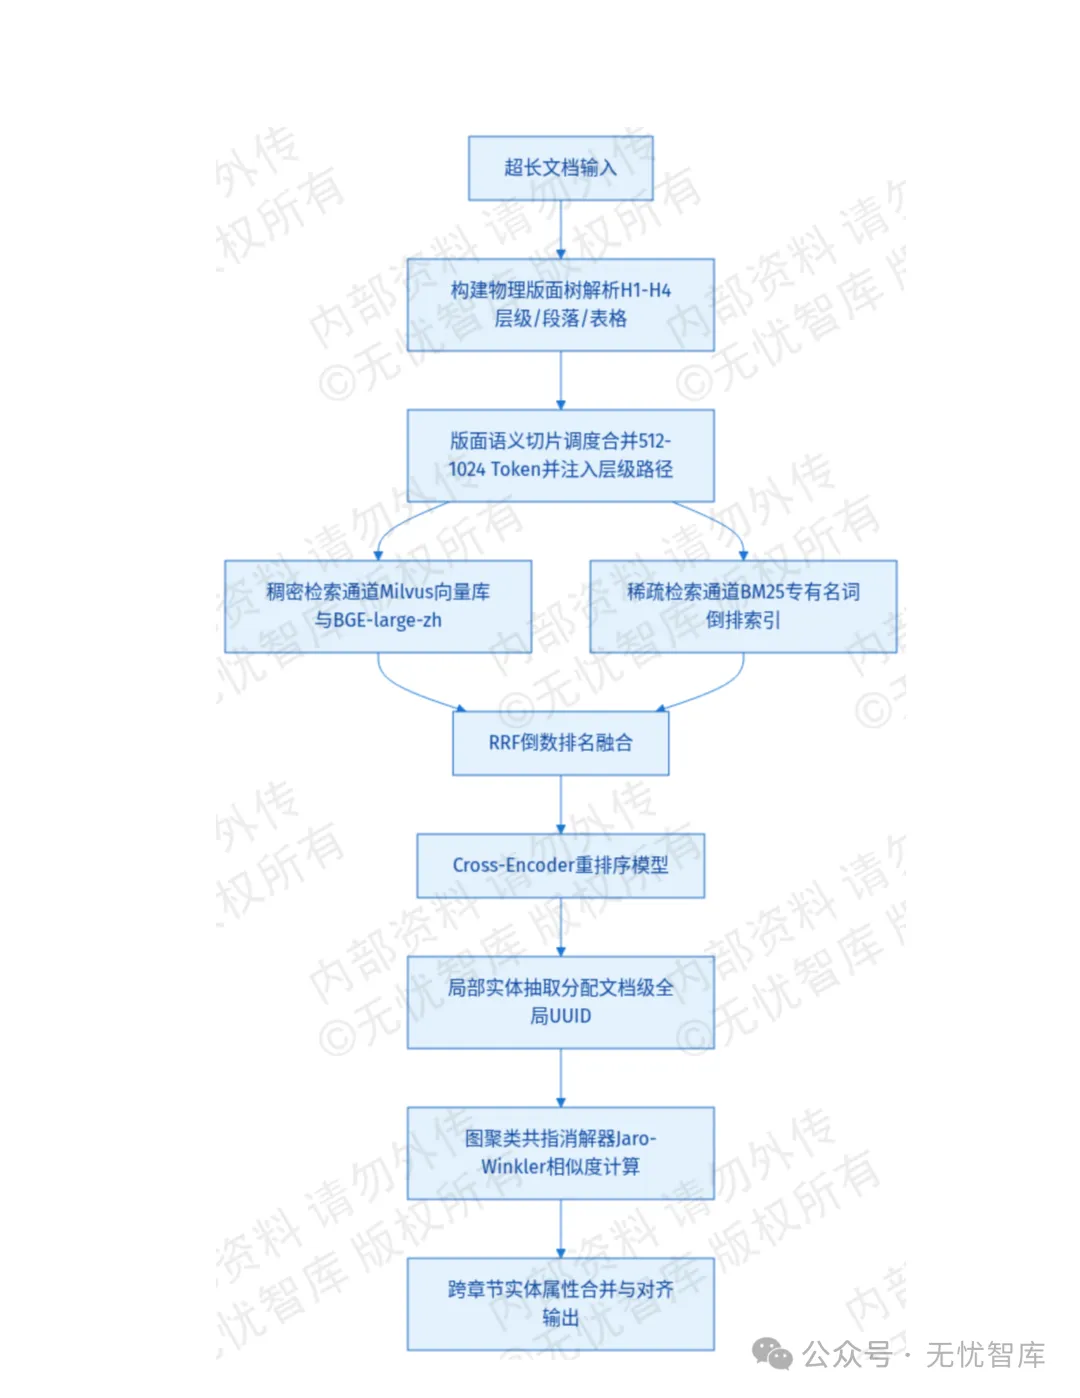
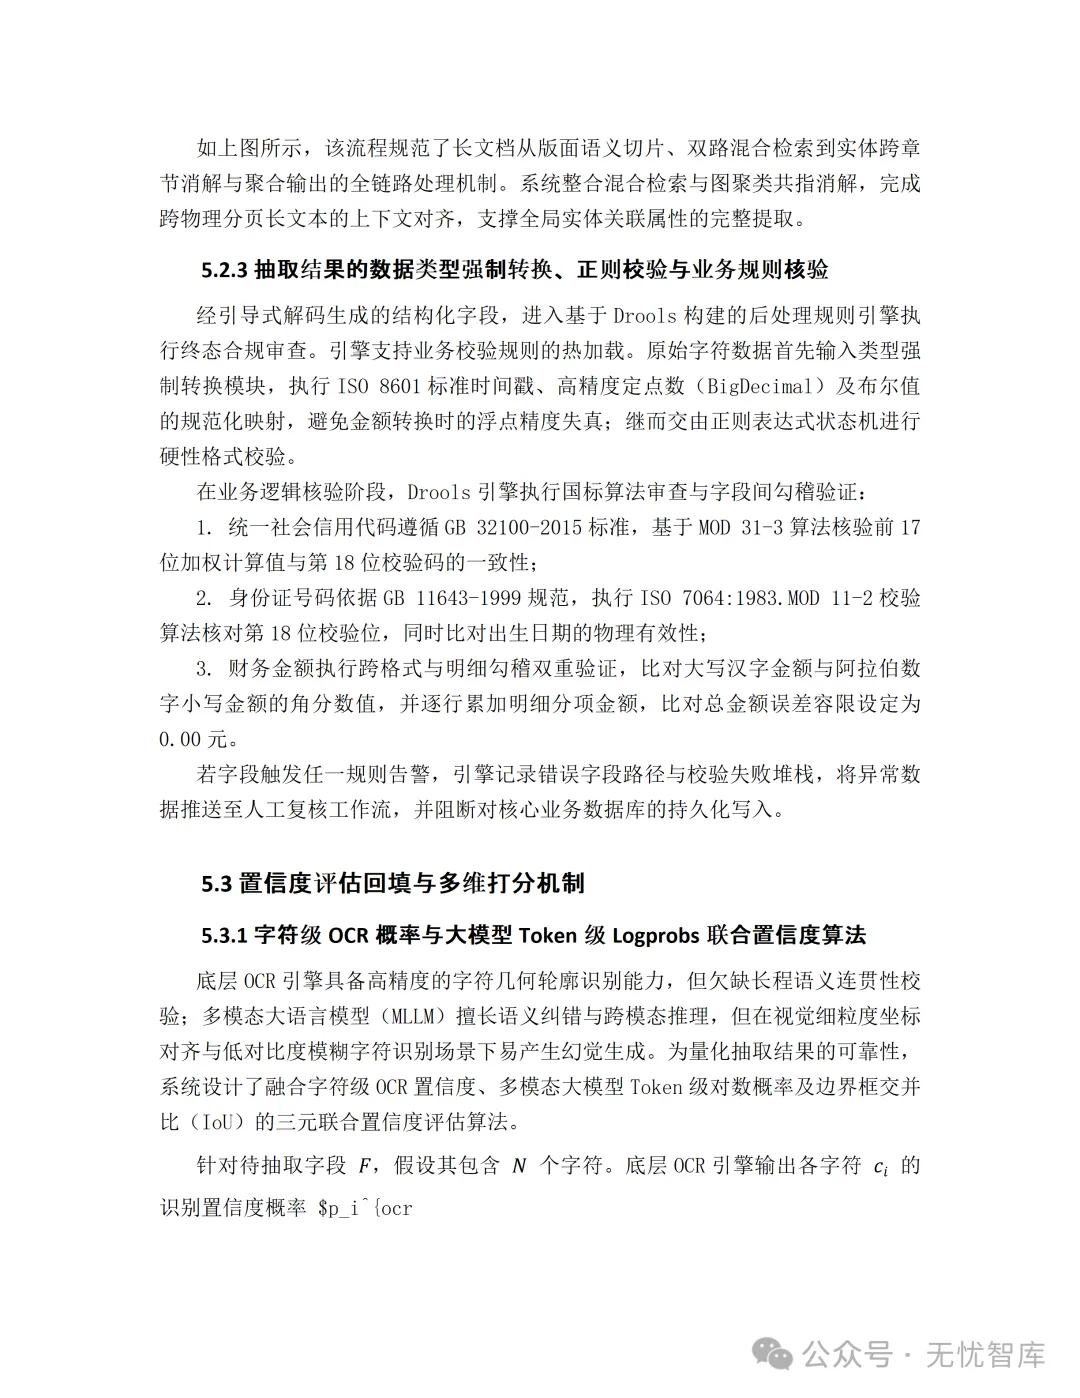
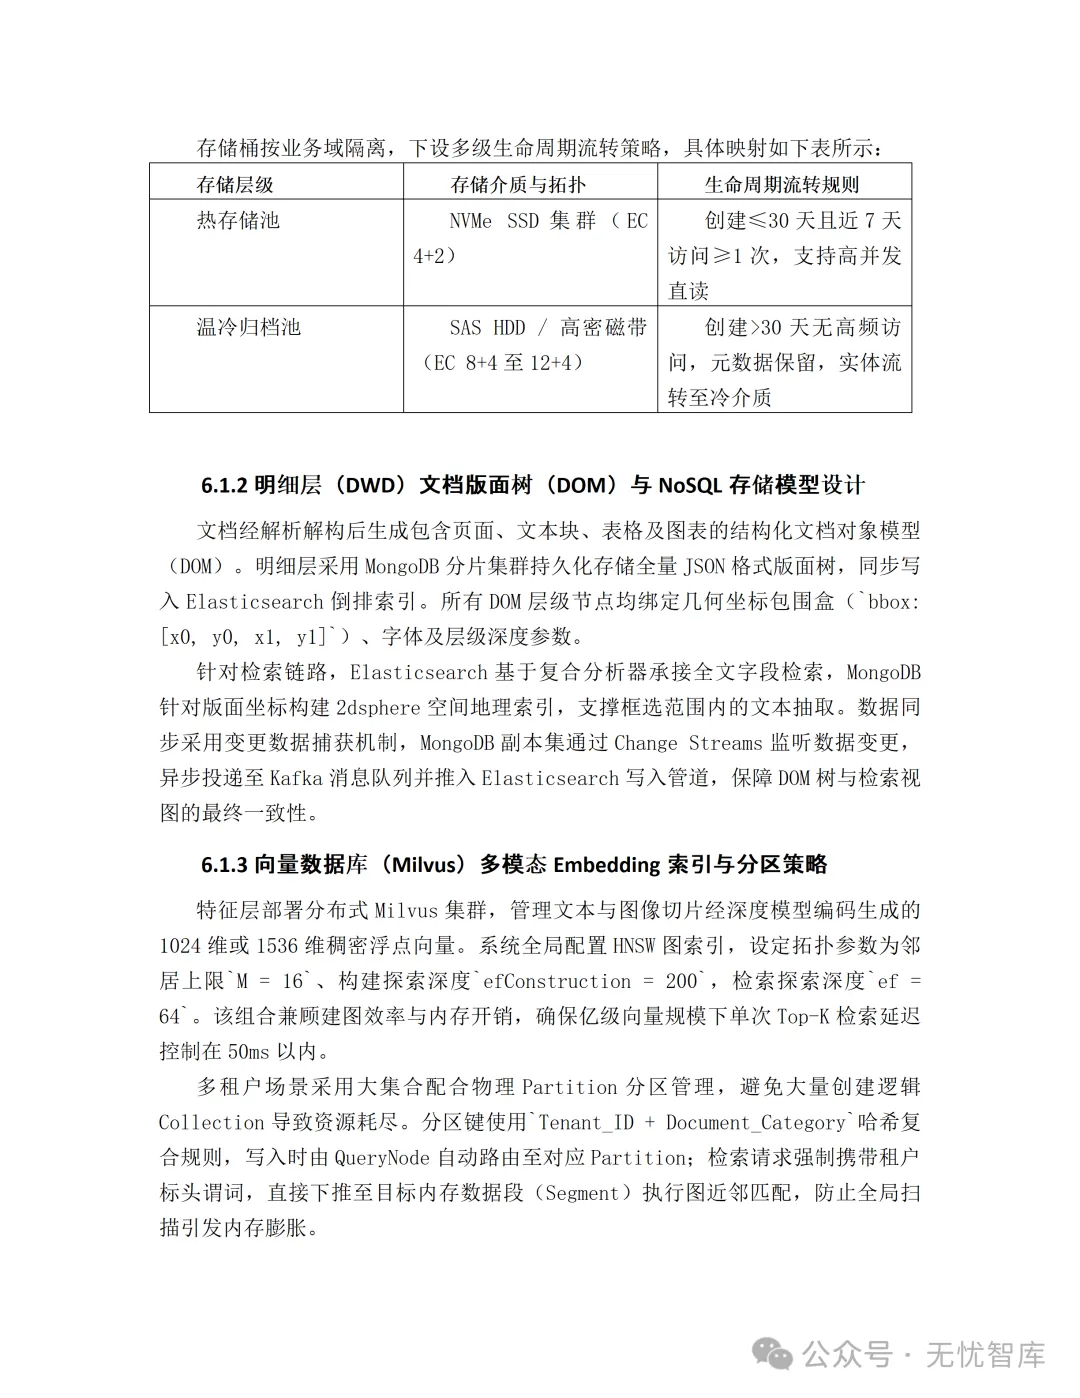
预处理与版面分析,包括PDF、OFD和扫描件的高分辨率栅格化、畸变矫正、阴影去除、18类版面元素检测与阅读顺序还原,以及印章像素级分离展开和手写批注识别 复杂结构化还原,包括有线、无线和斜线表头表格结构识别、合并单元格HTML重构、跨页表格与断裂段落缝合,以及公式到LaTeX的转换 多模态抽取与复核,包括融合视觉、OCR文本和2D空间位置编码的模型、零样本与少样本自定义Schema抽取、业务规则校验、联合置信度回填,以及原文高亮溯源的复核工作台和修正数据回流微调 数据底座与推理加速,包括对象存储、版面树存储、Milvus向量索引、核心业务表设计、vLLM连续批处理和混合精度量化,并配套API网关、等保与信创适配