ARTICLE · 1278644
天天用AI还在加班?教你用智能体跑通自动化闭环
收藏夹里塞了五六十个AI工具,下班时间却一点没提前。
早上打开对话框敲提示词,输出稍微偏了一点,只能反复修改重新问,再把内容复制到文档逐字校对。折腾两小时,发现还不如自己动手写。
麦肯锡落地报告显示,生成式AI近八成商业价值集中在形成闭环的场景中;智联招聘调研也指出,超60%白领日常用AI,但跑通自动化工作流的不到12%。
多数人不是不会用AI,而是从一开始就用错了姿势。
把大模型当单向答题机,永远是用体力伺候工具。只有把它当成自主流转的系统节点,效率红利才会真正兑现。
认知破局:淘汰你的是单点思维
很多人以为用好AI的关键,在于收藏上百条万能指令。
事实恰恰相反。
你在对话框里输入一句话,模型吐出一段文字,这叫单点交互。它的本质,依然是人在充当整个流程的传送带。从构思、检索到排版,每一步都要手动接盘,人一停流程就瘫痪。
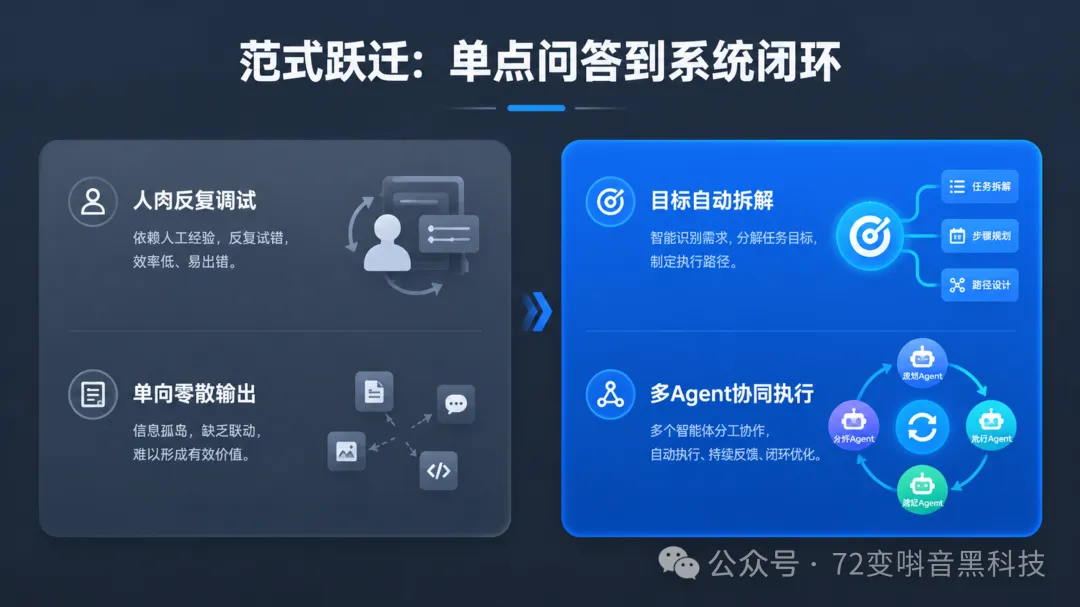
真正的生产力跃迁,在于把思维从「单向提问」切换到「智能体工作流」。
智能体与普通聊天的分水岭,在于三大核心机制:目标自主拆解、知识库环境感知、外部工具自主调用。
面对复杂任务,你只需定好交付标准与边界,系统就会自动分解子任务,调用不同角色与工具协同推进,直到产出最终成果。
未来的分水岭不是看谁会打字提问,而是看谁拥有把混乱业务拆解为自动化系统的架构能力。
工具减法:删掉90%的多余插件
工欲善其事,不是把货架上的工具全买回家。
打开很多人的浏览器,侧边栏挂满了各种插件。每个都要注册付费,数据分散在各处,维护成本极高。
搭建高效生产力,第一件事是做断舍离。
筛选铁律很简单:凡是功能孤立不能导出通用格式的、生态封闭无法接口联动的、只能解决单一细微痛点的,一律不进核心工作流。
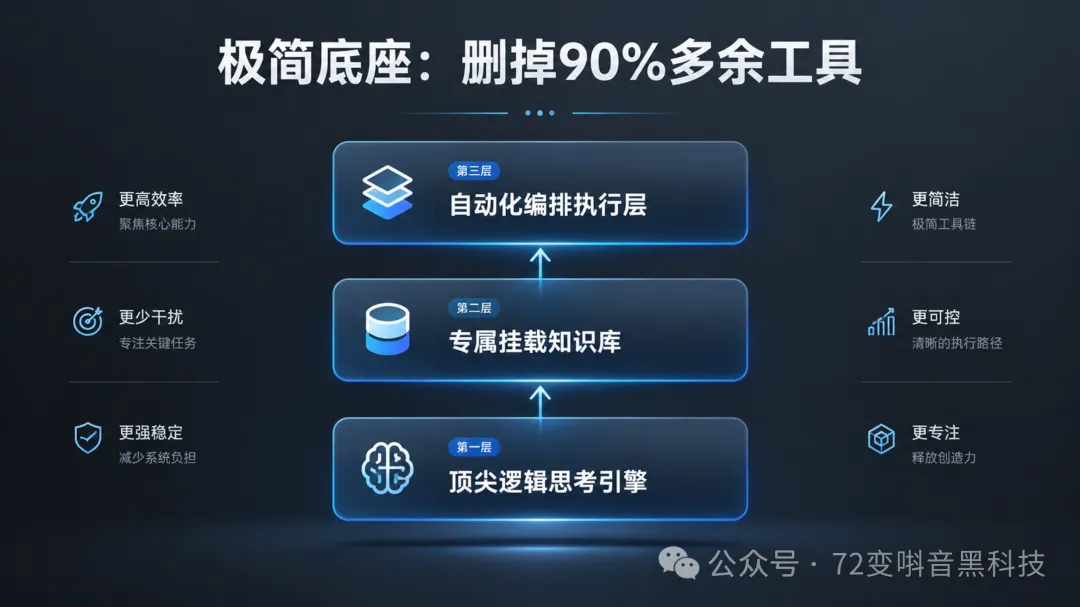
一个高容错、低维护成本的AI底座,三层架构就够了:
第一层是核心逻辑思考底座。这是系统的中枢大脑,专门负责复杂的推理、拆解与抽象总结。选择逻辑严密、长文本推理稳定的头部模型即可。
第二层是专属挂载知识库。大模型不懂你的企业规范、过往经验与业务数据。把沉淀的Markdown文档、标准规章和案例挂载起来,它才有给出可靠答案的锚点。
第三层是自动化编排执行层。这层负责把输入端、大模型推理和输出终端无缝串联。无论是低代码工具还是通讯软件自动化节点,核心作用都是让数据无需人工搬运、自主流转。
守住这三层底座,就能覆盖日常工作中绝大多数复杂需求。
手把手实战:3步跑通你的智能体
不用懂底层代码,只要理清三件事,三十分钟就能在日常软件里搭出一套运转系统。
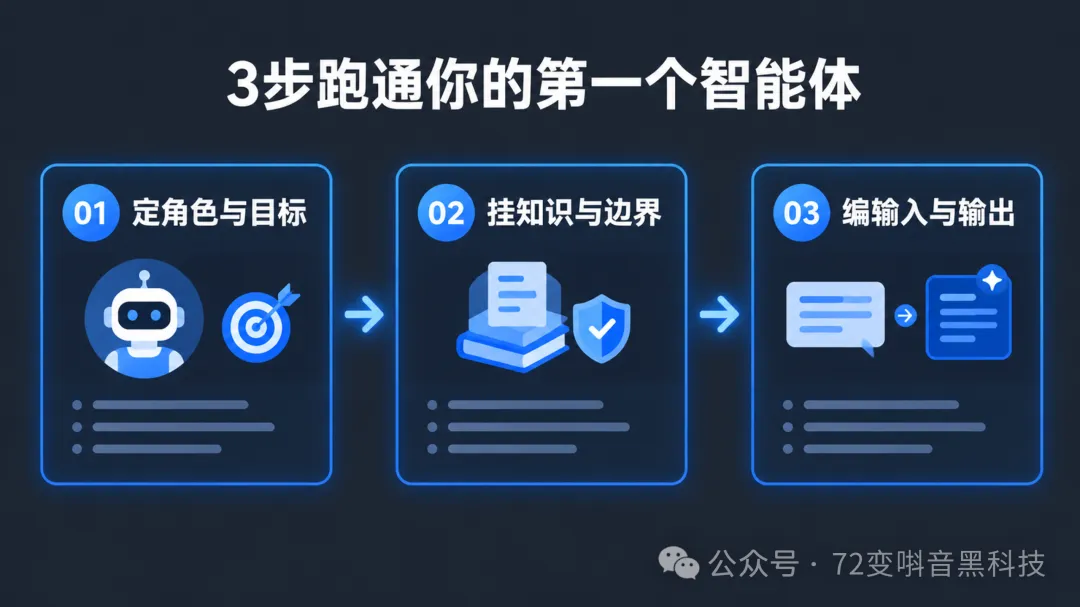
01 定角色与目标
多数人写设定喜欢堆砌华丽词汇,比如「你是极其资深的顾问」。这种描述对模型几乎没有实质约束。
有效的角色设定必须包含三个硬指标:身份边界、输入规范、输出标准。
举个例子,定义研报拆解智能体,应该明确告诉它:「从输入的行业白皮书中提取核心事实、关键支撑数据与冲突观点。严禁添加未在原文出现的推测,按Markdown三级标题输出结构化摘要,字数控制在600字以内。」约束越具体,发挥越稳健。
02 挂知识与边界
没有行业上下文,模型就会开始一本正经地胡说八道。
给它喂入专属背景素材并严格圈定范围:「只基于我上传的这三份产品手册作答。手册中未提及的参数直接回复暂无记载,绝不许结合外部常识随意猜测。」
给智能体划定红线,比给它灌输一千条操作建议都管用。
03 编输入与输出
找出手头最繁琐的日常任务,把流转逻辑画成接力棒连线图。
比如内容初筛:第一步抓取指定表格文本;第二步触发大模型按设定评分打标签;第三步若高于80分自动推送到群聊,低于80分则归档留存。
通路编排完成,系统就会默默在后台执行,你只需在终点验收半成品。
全场景模版:四大即插即用工作流
针对不同人群拆解四套极简模版,拿走就能照着配置。
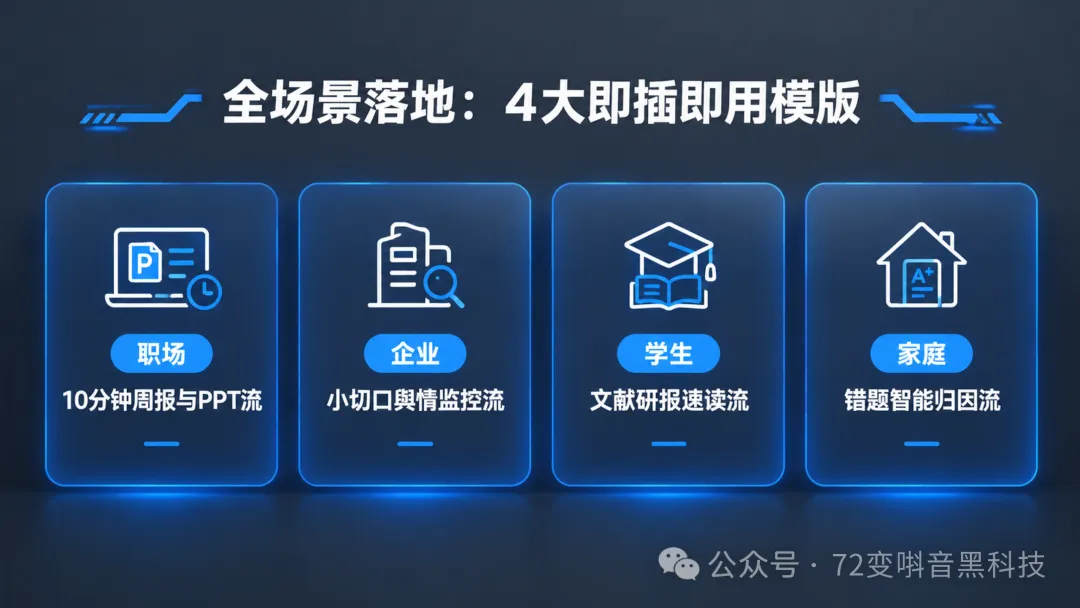
职场新人:10分钟周报与汇报骨架
不要等周五下班前才临时硬编总结。
- 输入端
:在备忘录随手记下当天的3件核心产出与未决问题。 - Agent处理
:挂载岗位考核标准,设定指令:「提取原始流水账,按『关键目标达成—量化数据结果—协同卡点与对策』三个维度归类,过滤细碎动作。」 - 输出端
:一键生成逻辑严密、带量化支撑的周报草案,两分钟复核即可提交。
企业管理:小切口竞品舆情监控
企业引入智能化,从小切口切入见效最快。
- 输入端
:定时自动聚合行业公开网站、招投标公告与主流资讯。 - Agent处理
:设定监控关键词与预警权重,智能体自动阅读长文,过滤公关水文,提取技术更新、价格变动与高管变动的核心情报。 - 输出端
:每天清晨八点,把提炼好的100字快讯汇总推送到手机端,决策效率直接提升。
学生群体:文献与学术研报精读
把原本几天的文献阅读压缩到一个下午。
- 输入端
:批量上传待精读的行业研报或学术PDF文件。 - Agent处理
:配置审阅角色,要求按「核心假设—实验方法—关键数据结论—局限性讨论」四段式抽离骨架,并标注每条结论在原文中的页码。 - 输出端
:输出带页码索引的对照笔记,无需通读全篇就能快速定位核心争议。
家庭教育:个性化错题智能归因
利用智能体可以实现高质量的耐心辅导。
- 输入端
:拍照录入错题与原始解题步骤。 - Agent处理
:设定为启发导师,明确要求:「不要直接给答案,先分析考察的核心知识点,指出在第几步出现逻辑偏差,并给出一道相似的变式例题进行引导。」 - 输出端
:生成具针对性的辅导话术,帮家长卸下辅导焦虑。
避坑铁律:绝不能踩的3个深坑
搭建自动化系统,有几个隐蔽陷阱,踩中一个就会白白浪费数周时间。
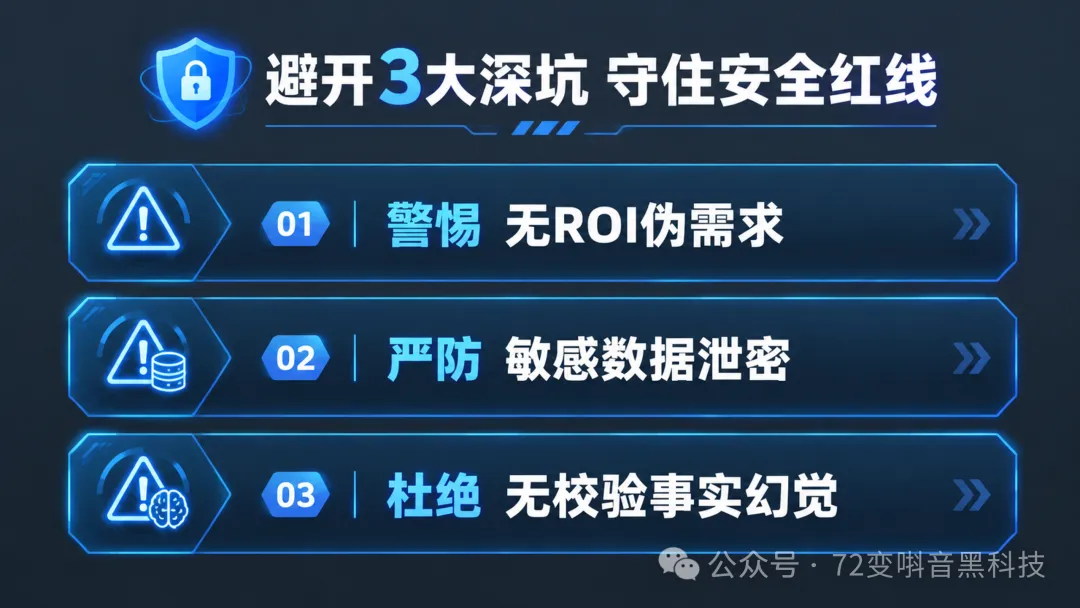
坑一:为了上AI而上AI的伪需求
很多团队看到同行做智能体也匆忙立项。但仔细一看,他们处理的任务用Excel简单函数就能搞定。
记住一个标准:如果一项工作原本手动操作只需两分钟,就不要花两天去搭自动化。 把时间留给重复频次极高、信息吞吐量大、人工处理枯燥的流程。
坑二:把内部敏感数据直接喂给公共平台
这是最容易忽视的安全雷区。在未开启数据隐私保护协议的前提下,随意把未经脱敏的客户名单、财务明细直接粘贴进公有大模型对话框,极易引发严重合规风险。处理内部业务,务必在本地先做关键词与敏感字段匿名化。
坑三:盲目信任输出,放弃人工校验闭环
大模型是概率预测,只要涉及事实性表述就一定存在幻觉。最稳健的架构永远是「AI负责干苦力初筛打底,人负责最终判断与责任把关」。在系统输出到最终交付之间,务必保留人工确认节点。
终局思考:构建你的第二大脑
AI从诞生至今,从来不是为了把人类变成失业者。它的真正意义,是把我们从繁重、机械、无休止的低效打字和信息搬运中彻底解救出来。
时代正在奖励那些懂得抽身而退的人。
当别人还在为学会一条新提示词沾沾自喜时,你已经在安静地构建自己的第二大脑与自动化智能体军团。让他们替你跑腿检索,把杂乱信息梳理成规整资产。
不用等到明天,今晚就挑出手头最繁琐的重复任务。坐下来,按三步法把它拆解成你的第一个自动化闭环。把机械劳动归零,把你真正的时间,还给你热爱的创造。