ARTICLE · 1289497
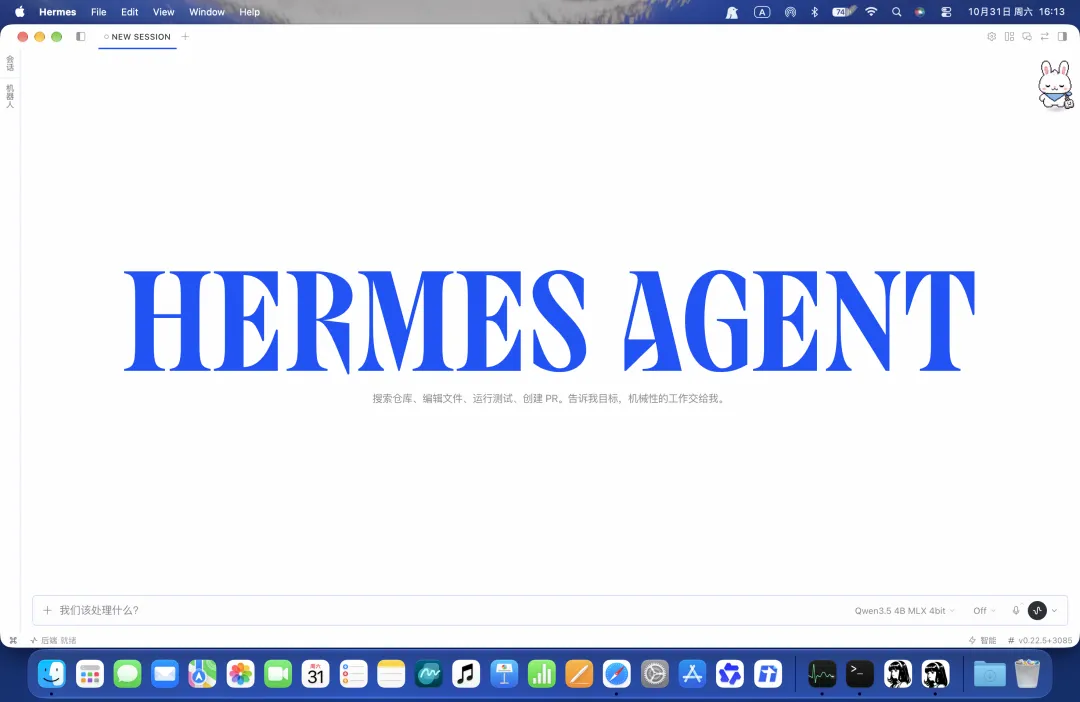
Hermes和ollama分手,桌面app支持运行本地模型了
Hermes和ollama分手,桌面app支持运行本地模型了今天插播一篇it文章。 前几天在更新Hermes时,不知道因为什么问题,总是更新失败,后面在折腾过程中把Hermes给搞崩了,后卸载后打算重新安装,结果折腾了好几天都安装不上,本来都打算放弃的,后面又不甘心的最后折腾了一遍,没想到折腾成功了,你要问我怎么安装成功的,因为我也不懂,所以我也说不上来,但就安装成功了。 在我进入设置,查看有没有需要设置的地方时,突然间就发现Hermes桌面app内部竟然支持直接下载运行本地模型了,这就意味着在运行本地模型时,可以不用以来ollama、lm-studio、omlx这些二手中间商了。 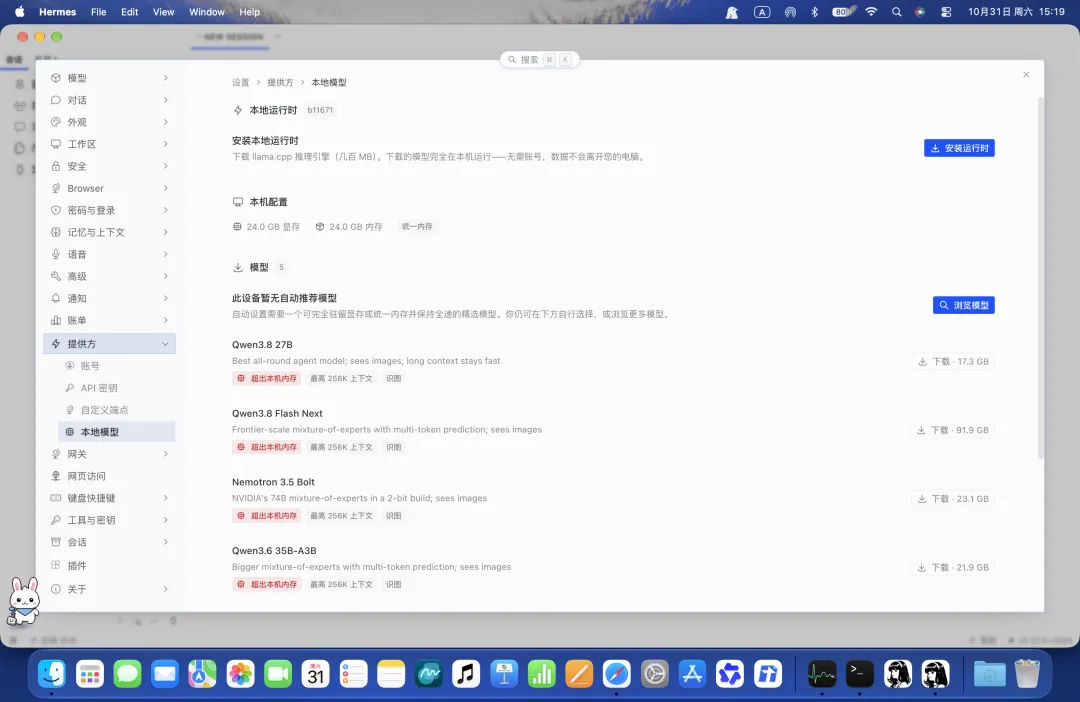
原来Hermes想要连接本地模型或者云端模型,需要一个中间桥梁,就是先连接ollama或者lm-studio、omlx平台,通过这些平台连接上本地模型,然后运行工作。 翻译一下,就是原来运行Hermes工作的时候,相当于至少要开两个软件,一个Hermes软件本身,另一个是ollama或者lm-studio、omlx软件,多开一个软件,相当于多浪费一份内存。 另外,再从流程上说,工作运行的时候,在Hermes中发一个命令,这个命令先传到ollama,ollama再传到本地模型,本地模型想出执行步骤后,再传到ollama,ollama再传给Hermes,流程步骤比较多,这样会影响运行速度。 现在Hermes桌面app内部直接支持下载安装本地模型后,不仅可以少开一个软件,省一份内存,还可以简化流程,在Hermes中发一个命令,这个命令直接到软件内到本地模型,本地模型想出执行步骤后,再直接给Hermes,这样就省了中间两个传递步骤,理论上是可以节省时间,提高运行速度的。 但是呢,因为Hermes为了跨平台通用,内部只内置了llama.cpp推理引擎,这个推理引擎对于苹果电脑用户来说,相对于苹果电脑自带的mlx推理引擎速度相对慢30%,所以这里就出现一个问题,省下的两个步骤提高的能效和更换推理引擎后降低的能效相比,到底是变快了,还是变慢了呢? 不知道,因为Hermes推荐的那几个模型太大了,我电脑内存不支持,想下载一个小的,结果连不上hugging face,所以暂时也体验不了,后面等我从其他地方下载完成加载后再说吧。 这个问题其实没啥意义,也许在使用体验中相差不大,只是有点好奇而已。就像我自己折腾这个Hermes,对于我个人而言可能并没有带来什么大的用处,只是在小龙虾(openclaw)和爱马仕(Hermes)爆火的时候好奇他们是什么东西,而自己去折腾体验一下,作为一个非计算机编程课班出身的人,对编程一无所知,在折腾的过程中对一些基础命令、逻辑关系有了一点的了解,其实也没啥用,就是单纯的享受那种折腾成功的感觉吧。 好了,今天的文章到此为止,纯纯的就是在今天折腾成功复装Hermes成功后的新发现而写的一篇,记录一下,纪念一下。