ARTICLE · 1294593
FDE 的 Agentic AI 通用模板: 从逻辑数据对象到可恢复工作流
每隔一段时间,我们就能看到不同大厂发布的一系列新模型,这些新模型总在基准测试中表现得越来越出色。现在的很多中国企业都在公司内部大量的使用模型,期望这些模型能解决公司内部最棘手的难题。但是,现实情况是随着模型的引入,反而出现了越来越大的“部署鸿沟”,模型没有构建出值得信赖的解决方案,没有带来切实显著的成效。
这究竟是为什么?最强大的模型无法在现实中的各种变量和约束下完成工作。我认为,在企业中需要这样一类角色,能将科研突破转化为生产系统,这样的角色,就是本篇博客讲述的第一人称,Forward Deployed Engineer (FDE) ,中文翻译“前线部署工程师”,这类工程师会处于客户交付与核心 AI 能力开发的交汇点。FDE 与产品团队及客户合作,设计解决方案,对于模型能力尚有不足的地方,FDE 与客户和研究团队共同明确差距,通过系统工程设计,一起推动改进。
本篇博客,我站在 FDE 的第一视角,来讲述 FDE 如何在快速变化或模糊环境中对复杂系统进行实战交付。我希望读者读完这篇博客,能从这篇博客中找到可以被复制的成功点,应用到读者的实际工作中去!
一 原生化的 Agentic AI 系统
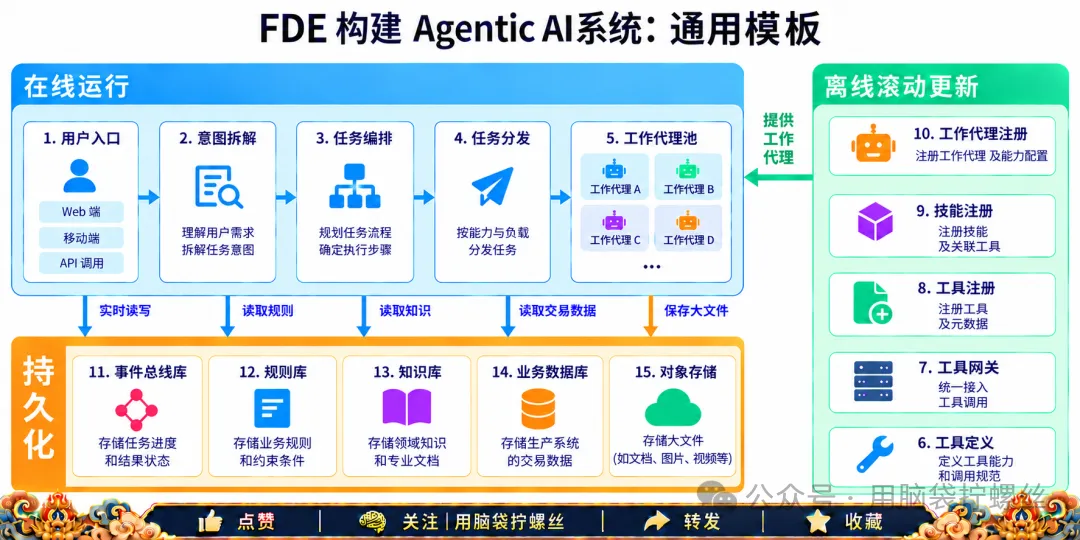
图1通用模板
FDE 去到任何一个行业驻场,必须从第一天起就了解所在行业。但是FDE不会每次都重新构造一套解决方案,因为 FDE 有一套让成功可以被复制的通用模板!
通用模板的作用,它可以快速帮助客户理解未来是什么,未来是如何实现的系统分工。通过这套模板:
FDE 可以轻松地和客户团队的业务对话,把业务流程抽象成工作代理,把业务成功经验封装成技能,为将来的业务流程自动化提供更好的起点
FDE 可以轻松地和客户团队的技术对话,把各类基建的部署抽象到持久化层和离线滚动更新层里的不同模块。部署精力的减少,使得 FDE 留出更多时间把关键功能做成插件,可能将来只需要工具网关多接入一个 MCP 服务器,就能快速拥有某项工作的专有技能,及时快速地解决更难的问题
在线运行层负责把用户需求变成任务,并接收执行结果 离线滚动更新层负责准备、验证和发布可用能力 持久化层保存规则、知识、业务事实以及执行记录
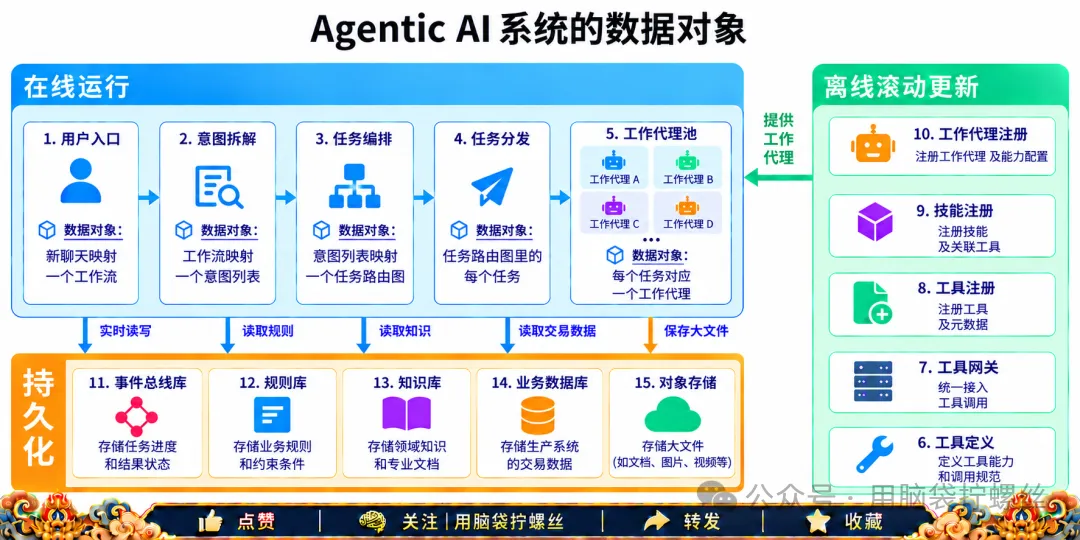
图2 各式各样的数据对象在 Agentic AI 系统中穿行
刚才被 Agentic AI 系统里提到的这些逻辑数据对象,都是可复用的是对象契约。FDE 驻场在不同行业的任何场景中,都能复用这套建模作为起点,再做领域适配。如果要搭建的AI 系统十分简单,那可以只用一个顺序的 Pipeline、一个 Task 和一次 Tool-Calling;如果要搭建非常复杂的 AI 系统,FDE 可以建立多级工作代理来负责不同 Task 的执行归属。下表可以作为参考手册:
逻辑数据对象 | 建议的必选字段 |
|---|---|
Workflow | 原始目标、状态、版本号、启动时间、结束时间、最终结果 |
Intent | 意图列表 |
Task | 业务目标、待补信息、验收条件、结果状态 |
Job | 执行步骤、检查点、尝试次数、下一次重试时间 |
Tool-Calling | 工具、参数、调用输出、状态码 |
Command | 命令、参数、工作日志、状态码 |
... |
通用模板的方法论讲完了,接下来,用一个电商场景来验证它...
三 在线运行层:把用户指令变成可执行的任务计划
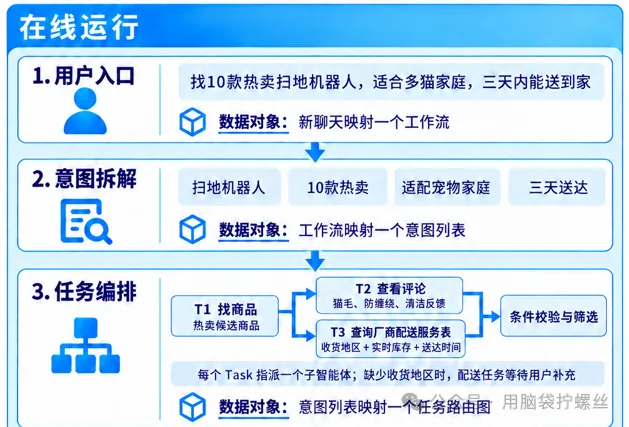
从一层架构里先剥离出“在线运行层”,用一个实际的用户指令:“找10款热卖扫地机器人,适合多猫家庭,三天内能送到家”,一步步理解逻辑数据对象变成一个个不同的数据实例:
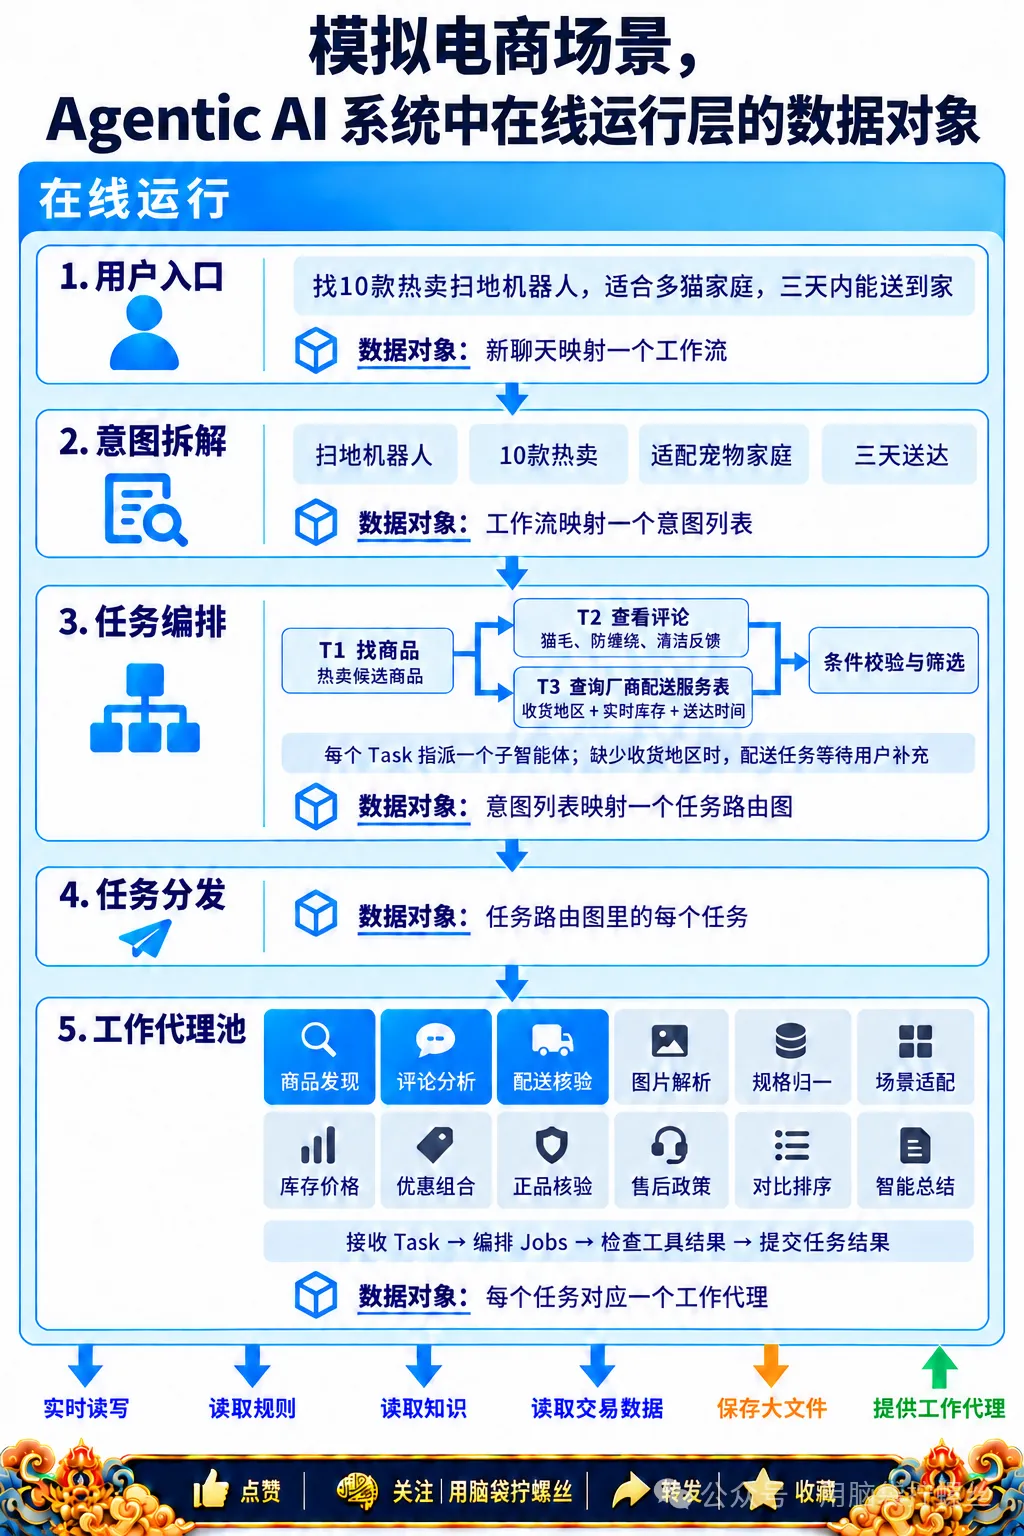
图3从用户指令到任务路由与工作代理
新聊天的用户指令 >> 新工作流的原始目标字符串(json)
原始目标 >> 变成意图清单 “扫地机器人、10款热卖、适配宠物家庭、三天送达”(list),清单里的元素是体现智能的重要里程碑
意图 >> 用业务话术构成可调度的任务路由图,“T1先取得候选商品集合、T2读取这一集合的评论证据、T3查询配送知识库、T2和T3两条分支可以并行、最后的筛选节点读取两个分支的结果集合、在条件约束下、生成对比报告”(graph)
T任务 >> 预定义的执行流程需要有清晰的计算口径、约束、目标(task)
“商品发现”里要有“热卖”需要约定统计的时间窗口和渠道口径
“适配宠物家庭”需要明确评论分析的证据维度,例如猫毛清理、防缠绕、避障与耗材维护
“三天”需要确定起算时刻和业务时区
“配送核验”任务必须要求收货地址,不能让模型在调用接口时悄悄替业务决定这些口径,如果缺少地址,这个 Task 的状态会被设置成 WAITING_INPUT。等用户补充地址后,再唤醒这个任务
工作代理池 >> 和业务充分沟通讨论抽象出能力。模拟电商场景,图3列出了12项能力包括商品发现、评论分析、配送核验、图片解析、规格归一、场景适配、库存价格、优惠组合、正品核验、售后政策、对比排序和智能总结(agents)
工作代理 >> 可能包含多个job,一个job再拆出工具调用(tool-calling)或者命令执行(command)
所有这些形形色色的数据对象都会实时的存储和读取,作为上下游的执行状态被管理起来。
四 持久化层:提升代理的成效并减轻推理的幻觉
图4把持久化层和工作代理池连在一起,是为了突出工作代理在执行过程中需要依赖可信的数据:
Rule帮助工作代理,在执行过程中必须遵守的约束
Knowledge帮助工作助理理解问题
Reference为具体结论提供依据
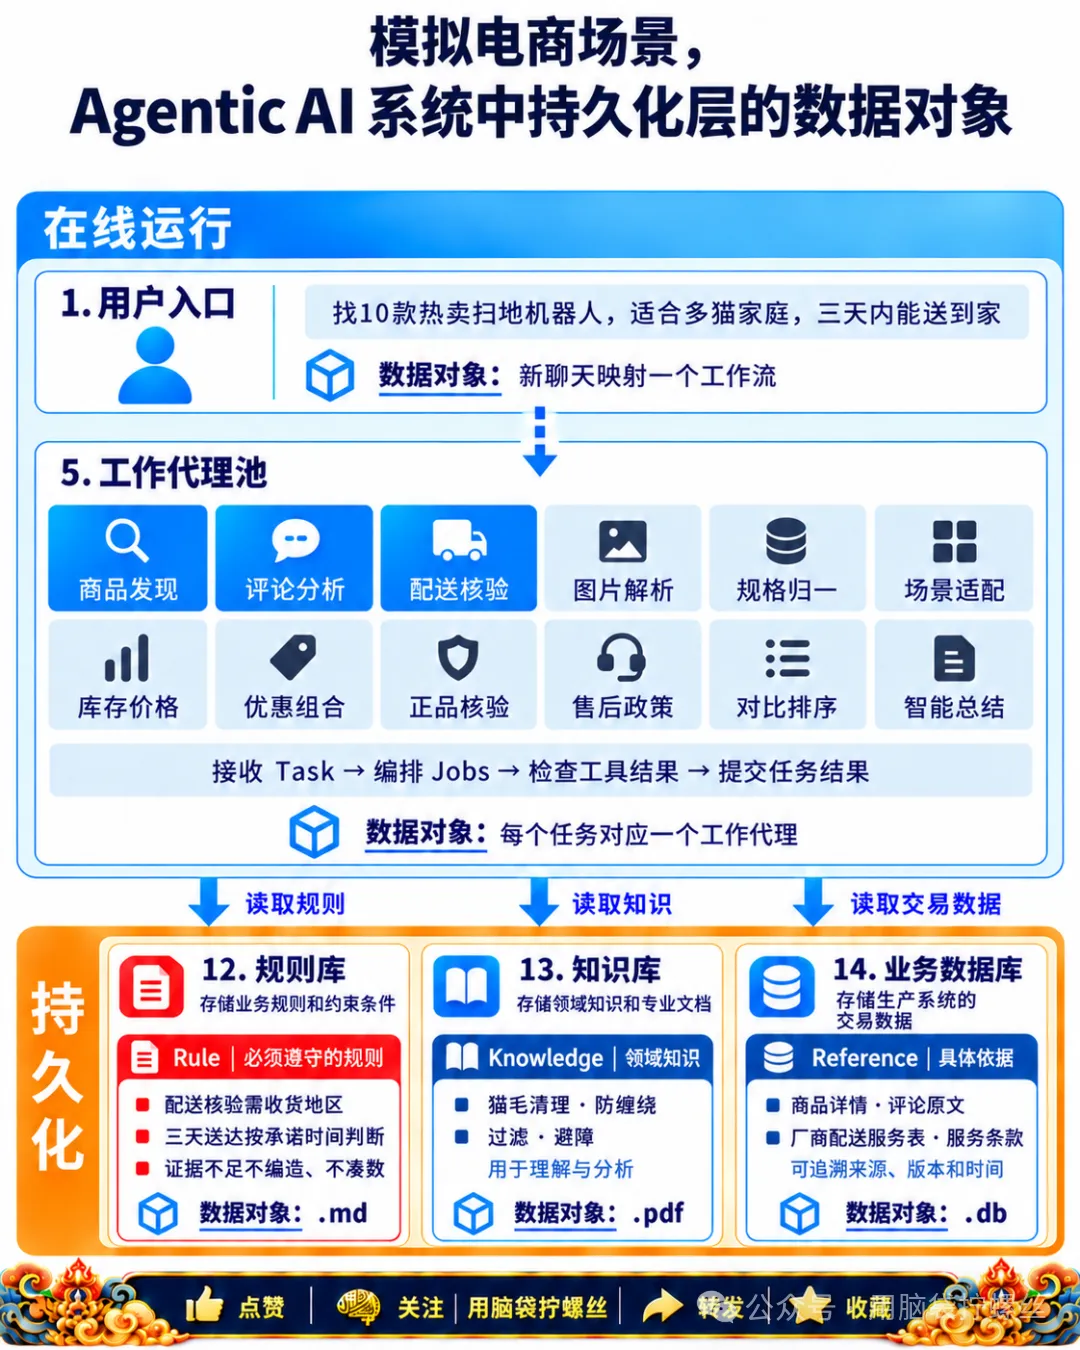
图4规则、领域知识与业务依据共同支撑工作代理作出结果判断
用户下达指令 “找10款热卖扫地机器人,适合多猫家庭,三天内能送到家”
工作代理池的“配送核验”在理解“三天内送达”的用户需求时,需要实时访问规则库,调用工具来查看“收货地区规则”、调用工具解析用户地址是否满足“三天送达,如果传入工具时缺少destination,就不能把“配送核验”工作标记为已成功
工作代理池的“商品发现”在理解“适配多猫家庭”的用户需求时,需要实时访问知识库,调用工具解析产品规格文档里支撑具体判断“猫毛清理、防缠绕、避障”的关键字是否存在
工作代理池的“评论分析”在理解“适配多猫家庭”的用户需求时,需要实时访问业务数据库里评论证据,调用工具检索某款商品(工具的必选参数)的相关评论是否涉及“猫毛清理、防缠绕、避障”的语义信息是否存在
要注意一点,持久化层里的各种证据,它们的权威性并不相同,并且证据还有时效性,工作代理在执行过程中,要对这些元数据分配不同的权重系数,使得工作代理的结果得到更好的受控保证。
五离线滚动更新层:把能力发布给运行时
图5展示工具从定义、接入到注册的过程;技能亦是如此。这里的“离线”表示能力的开发、验证与发布阶段;网关处理请求、动态装载工具则发生在滚动更新的运行时,两者通过注册信息衔接。
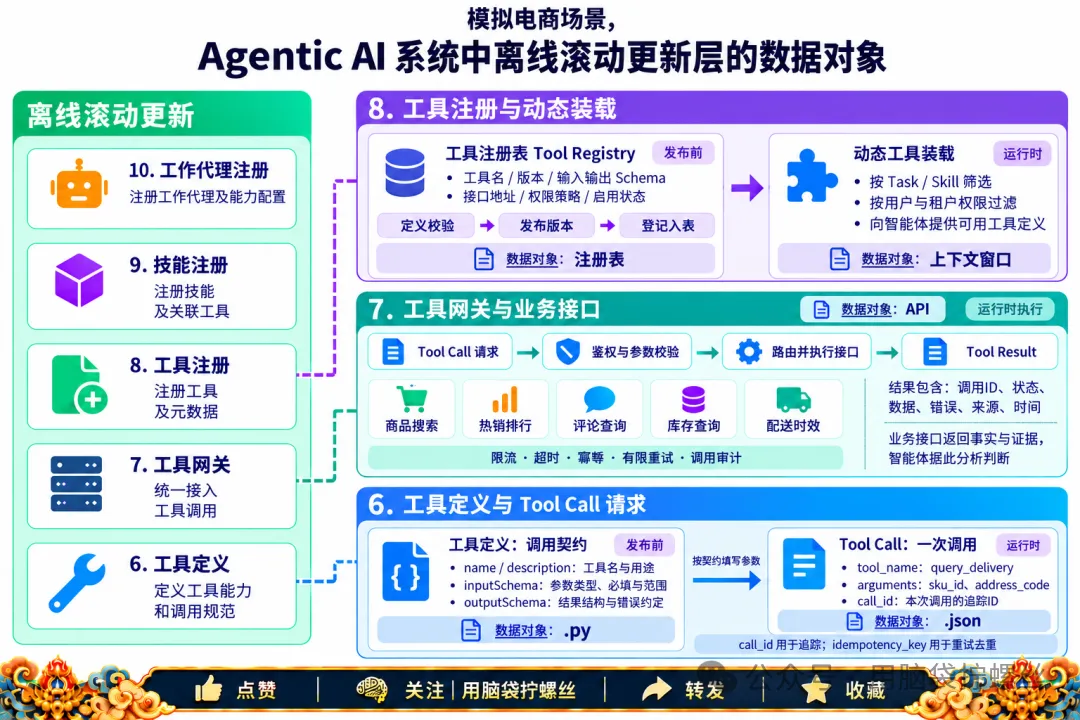
图5将发布前的能力转化为运行时可调用的组件
框6“工具定义”里工具实现与调用契约的数据对象,.py表示Python工具实现的一个例子,实际生产环境里,执行代码可以采用Python、Go或其他语言。在运行时,真正交给模型理解的是工具名称、用途、输入结构和结果约定,.json里规范清楚请求对象应明确tool_name、arguments和调用标识,结果对象则保存状态、输出或错误。MCP官方工具规范提供工具发现与调用方法,并以Schema描述参数及可选的输出约束,为这种接口约定提供了通用协议基础
框8“工具注册”的工具注册表保存能力名称、版本、契约、路由位置与启停信息,权限策略由可信服务执行。动态装载依据当前任务与授权范围选出相关工具,再把必要定义交给模型。上下文窗口由这些定义与当前任务信息共同组成,窗口本身无需被当作注册表或长期存储
框7“工具网关”中的API代表执行边界;更严格地说,跨边界流转的是请求与响应对象。网关完成鉴权、校验、路由、限流和审计,工具发现阶段的权限过滤不能替代调用时的授权检查
技能Skill与子工作代理Sub-Agent也需要对运行时发布,工具提供动作,Skill约定步骤与结果形态,Sub-Agent结合与业务约定的工作能力执行这些步骤
即使所有请求都有JSON格式,系统也不会自动可靠。决定可靠性的,是这些对象何时持久化、谁有权修改状态,以及失败后能否找回原来的执行位置。图6正是在回答这个问题!
六 技术落地:用状态机推进任务执行链路
花了三个篇幅,讲述了通用模板里的数据对象。现在,应该谈谈技术上如何做到数据对象的生命周期管理、执行过程中的临时结果和在上下游中需要共享的各种事实。在实战中,FDE 会考虑采用 RabbitMQ 投递任务,PostgreSQL 保存执行事实。把 Workflow、Pipeline、Tasks、Jobs、Tool-Calling、Commands、Skills 等等分别提供整体目标、业务责任、恢复检查点与具体调用记录、中间进展等发生的状态都被留痕住。
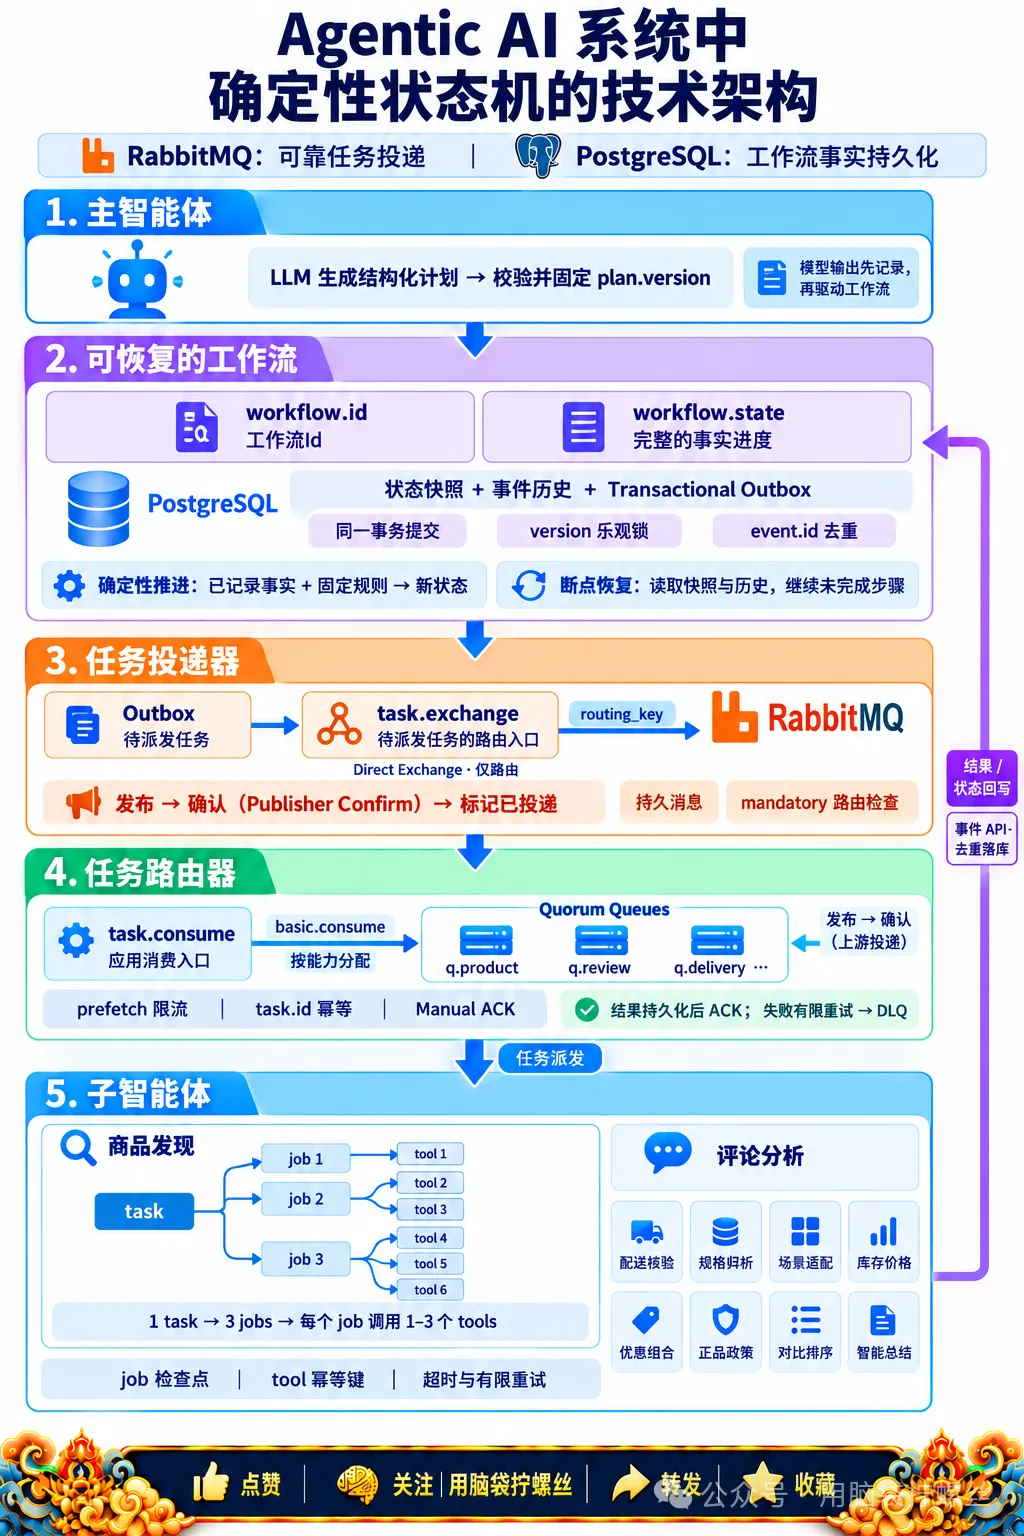
图6 状态机机制保障实现可恢复工作流
抛给读者一个问题“为什么要采用状态机的系统设计?”
答案十分朴素,作为整个 Agentic AI 系统的“中枢”是 LLM 大模型,LLM 大模型本质是个通晓世界知识,采用文字接龙的概率模型,那它每次生成的计划可能带有不确定性(推理答案的不一致性),计划的不稳定性会带来各种下游结果的变化。因此,想要恢复工作流,就必须得把各种信息都记住。核心就一句话:先记账、再处理。当前最常用的 Agent 设计范式是 Main Plan/ Multi-Agent Execution/Validation/Loop。一个主智能体负责理解用户需求,编排出一个长程计划,然后由多个子智能体互相协作来完成计划,把各项结果汇总给主智能体,主智能体输出结论,另一个智能体充当核验,对结论提出修改动作,迭代到预设终止条件满足。因此,随着 Agentic AI 系统的复杂性越来越大,系统设计中引入状态机承担记账工作是一个提升强壮性、稳定性的正向工作。
把执行链路的信息保留下来,当遇到故障时,可以快速恢复。正常的执行进展是T1得到20个候选SKU,写成不可变结果R1。T2和T3都读取R1,前者产生评论证据R2,后者产生配送证据R3。最终筛选以SKU为键合并R1、R2、R3,再按规则版本筛选排序。每个结论都能追溯到相应的证据引用。这里的20个候选是检索预算,不是固定算法要求。
如果T3需要等待地址,R1和R2可以先保存。用户补充地区后,系统把输入变更写入工作流,并只唤醒受影响的分支。如果等待过久导致库存或配送事实过期,则按时效策略重新查询,而不是把过期缓存当作当前承诺。
先记账的优势: 每个数据对象都应有可解释的去向。
再处理的机制保证:采用 RabbitMQ 实现事件总线,它负责运输任务。
七 最后总结
本篇博客,讲述了 FDE 驻场后,采用通用模板快速部署 Agentic AI 系统。着重讲解了通用模板中各个模块的数据对象,利用 PostgreSQL 保存运行事实、RabbitMQ 实现执行链路里状态存储的职责。把六张图连起来,FDE交付的是一条可以检查的业务链:用户目标形成 Workflow,Pipeline 把目标变成 Tasks,工作代理用Jobs 组织工作,Tools 闭环可追溯的事实,持久化记录承接每一次状态变化。场景可以继续扩展,接口和模型可以更换,责任边界与恢复规则仍然清晰。通用模板让多方团队知道组件如何分工;数据对象让组件真正协作;可恢复工作流让一次业务请求有始有终。这三件事连在一起,Agentic AI 才具备持续交付业务结果的基础。