ARTICLE · 1300192
奥特曼回应数学界争议:AI 成果还要继续发,但谁来为“理解”买单?
当 AI 开始批量挑战数学难题,数学家迎来的,会是一场知识的丰收,还是一场来不及消化的冲击?
最近,OpenAI CEO 萨姆·奥特曼在 Cheeky Pint 播客上的一番回应,把这个问题推到了台前。
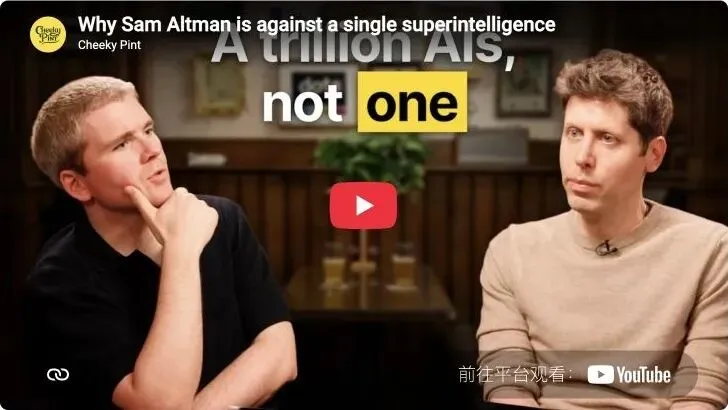
在这期于2026年10月29日发布的节目中,他坚持认为,人类应当获得基础科学知识,重大科学发现不应被公司捂在手里;同时,他也承认,需要更体谅那些推动相关学科发展了数百年的研究群体。
一些传播将其概括为“奥特曼向数学家致歉”。
但小鸽鸽核对节目文字稿后发现,更准确的表述是:他表达了理解与感伤,也承认发布方式需要斟酌,但没有明确撤回继续推动、公开 AI 科学成果的立场。
文字稿中,也没有找到他明确向数学家道歉的表述。这个细节很重要。因为这场争论涉及的,远比一句道歉复杂。
先把最震撼的数字,放回它们原本的语境。
2026年9月8日,OpenAI 宣布,其内部系统提出了纳维–斯托克斯存在性与光滑性问题的一项解答,并公开证明文本与 Lean 形式化材料。
按照公司的说明,找到相关解答的小组使用了约一万个并发 AI 代理。代理在启动约88小时后得到解答,随后形式化与验证又用了17小时。
// 这些数字来自 OpenAI 的自述,并不是小鸽鸽独立测算的结果。
这里还有一道不能省略的边界:OpenAI 所称的结果,是在光滑外力作用下构造有限时间出现奇性的情形,对应官方问题表述中的特定版本。把它扩写成“AI 彻底破解了流体运动和湍流的一切秘密”,显然超出了公告内容。
克雷数学研究所在9月11日的声明中,对这一问题“看来已被解决”的消息表示兴奋,同时强调,成果评估与贡献认定有既定程序,而且这一程序会审慎推进。
接着,是另一组被反复转发的数字。
10月6日,OpenAI 批量发布数学手稿。发布时的统计为722篇、372个相关成果组。
这两种计数不能混用:一个成果组可能包含主结果、配套论证或不同证明,722篇手稿并不意味着解决了722个独立难题。
截至小鸽鸽本次核查,官方仓库首页列出的是721篇手稿、373个成果组。

为什么数字会变?官方更新记录显示,10月7日撤回了三篇存在问题的手稿,10月26日又新增两篇。因此,“发布时722篇”和“目前721篇”各有时间口径。
更关键的是,仓库明确说明:这些成果处于不同验证阶段,并非全部附有 Lean 形式化证明,更适合被理解为原始研究数据。
小鸽鸽认为,准确报道这件事,首先就要避免把“数百篇手稿”写成“数百项已获公认的数学定理”。
机器能检查证明,人类为什么还要花时间读?
这可能是普通读者最容易困惑的一点。
Lean 这类工具,可以检查形式化证明的逻辑。但它检查的命题,是否忠实对应研究者原本想解决的问题,仍需要审查定义、假设和表述。
陶哲轩博客刊载的一篇技术文章就强调:证明需要经过内核检查,同时还要有人核对,被验证的定理究竟是不是人们以为的那个定理。
此外,还有一个不同层面的问题:即使结论成立,人类能否理解其中的方法,并把它用于下一个问题?
对数学研究而言,一份证明的价值,也包含它教会同行怎样思考。
小鸽鸽觉得,这正是“生成答案”与“形成知识”之间最值得关注的距离。前者的速度可以迅速提高,后者仍需要讲解、讨论、质疑和吸收。
数学家的不安,也有具体的职业处境。
把这场争议归结为“数学家输不起”,很容易,却解释不了真实反应。
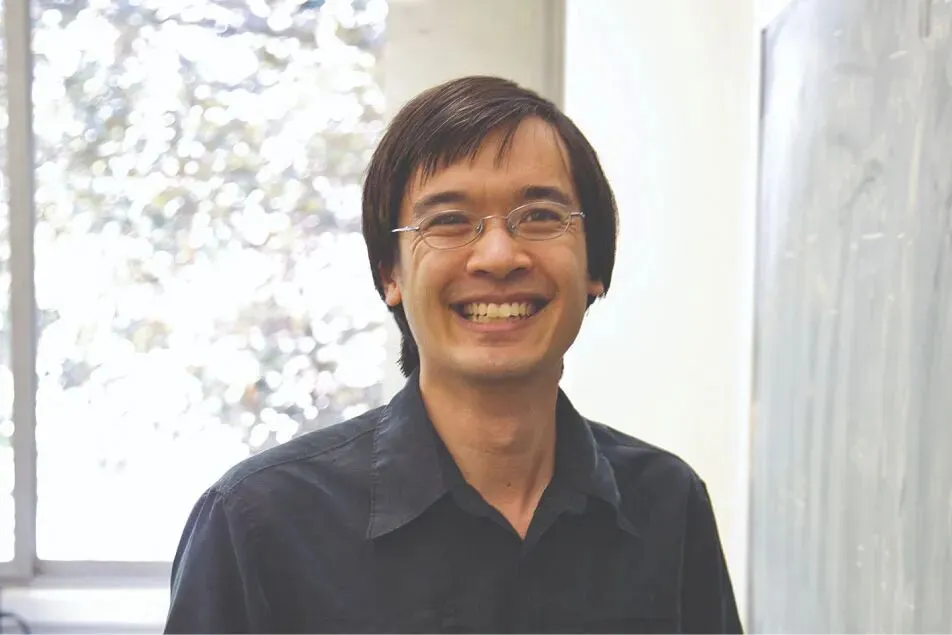
他尤其担心,研究生和博士后投入多年的研究计划,被突如其来的批量发布打断。
同一组公开回应中,也有数学家表示兴奋,期待理解这些成果。数学界并没有一种整齐划一的情绪。
小鸽鸽更在意的是由此提出的问题:如果研究训练的价值,不能完全由“是否最先解决某道题”衡量,那么博士培养、项目评价和职业晋升,是否也需要调整?
青年研究者需要能继续学习、建立能力并获得认可的路径。仅仅告诉他们“还有无穷多个问题”,未必能解决眼前的困境。
一道题目背后,可能是一个学生几年的训练、一份尚未完成的博士论文,以及一个刚刚建立起来的研究方向。
技术进步带来的收益值得期待,转型的成本也需要有人承担。
当数学成为模型测试场,双方追求的东西未必一致。
OpenAI 在官方仓库中解释,原有数学评测趋于饱和后,公司把评估扩展到了开放研究问题。
从企业的角度看,一道著名难题,既能检验模型能力,也容易向外界展示技术进展。
从研究共同体的角度看,同一道题却可能连接着多年积累的方法、合作关系和人才培养。
小鸽鸽认为,这种目标差异,是冲突的重要来源:公司关心模型能推进多远,学界还关心成果怎样进入公共知识体系。
假如公司的成果发布速度越来越快,而检查、解释和整理的工作主要留给外部数学家,便会产生一个现实问题:谁来支付把机器输出变成人类知识的成本?
对此,数学与人工智能咨询小组 AGMAI 的建议相当明确:如果 AI 实验室发布了重大成果,却没有同时提供人类理解,就应承担促进后续理解的责任,包括给予实质性资金支持。
这也意味着,发布责任不能在上传文件后结束。
接下来,该看公开承诺如何落地。
OpenAI 已在10月15日更新公告,宣布向西蒙斯基金会的一项计划投入500万美元,支持数学家检查、理解并发展 AI 产生的成果,同时提供模型与计算资源。
这提供了一个可以继续观察的起点:资金是否真正支持了验证与讲解?研究者能否获得必要工具?贡献认定、引用和更正机制是否足够清晰?
在小鸽鸽看来,未来评价 AI 数学成果,至少需要同时看见三件事:结论是否可靠,方法是否被理解,研究共同体是否有能力继续发展它。
如果这些环节跟不上,再庞大的发布数量,也无法单独说明知识进步的实际程度。
奥特曼强调,人类值得知道宇宙如何运行。
这份愿望令人期待。实现它,还需要把一份份机器输出,变成人们能够检查、理解、传授和使用的知识。
当 AI 越来越快地交出证明,人类更需要有人把“为什么”讲清楚。