ARTICLE · 1310952
腾讯、中科院找到检索关键:多模态文档召回提升 6.03 个百分点
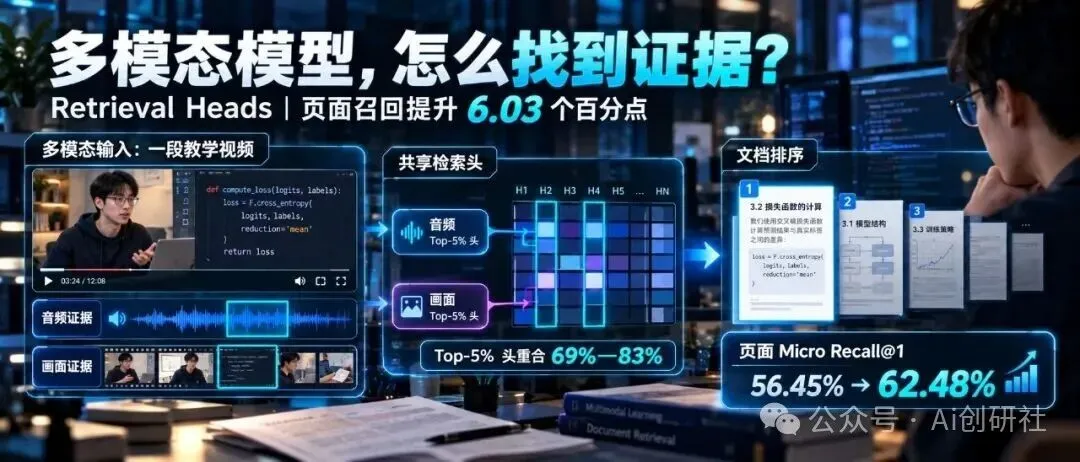
同一个六位密码,念出来和写在画面上,大模型会动用同一批注意力头吗?笔者这次读的 Retrieval Heads 研究,把答案内容固定、只切换证据模态,发现音视频检索大量共用少数头。更有意思的是,作者把这套机制变成可训练的文档排序器:Qwen3-VL-8B 的页面 Micro Recall@1 从 56.45% 提高到 62.48%。
链接速览
📄 论文:A Broader Look into MLLM’s Retrieval Heads
🔗 链接:https://arxiv.org/abs/2610.32411
先看结论
- 做了什么
:在 18 个语言、视觉语言和全模态检查点上,用统一方法定位检索头,再通过消融与文档排序训练验证它们的作用。
- 关键发现
:同一份证据换成声音或画面,top-5% 检索头有 69%—83% 重合;音视频共享头占全部头不到 2%,却会影响空间感知与视觉数学等下游任务。
- 落地结果
:固定选出的检索头,用页面排序损失训练注意力投影的 LoRA。页面检索提升,并迁移到没有训练标签的版面区域检索。
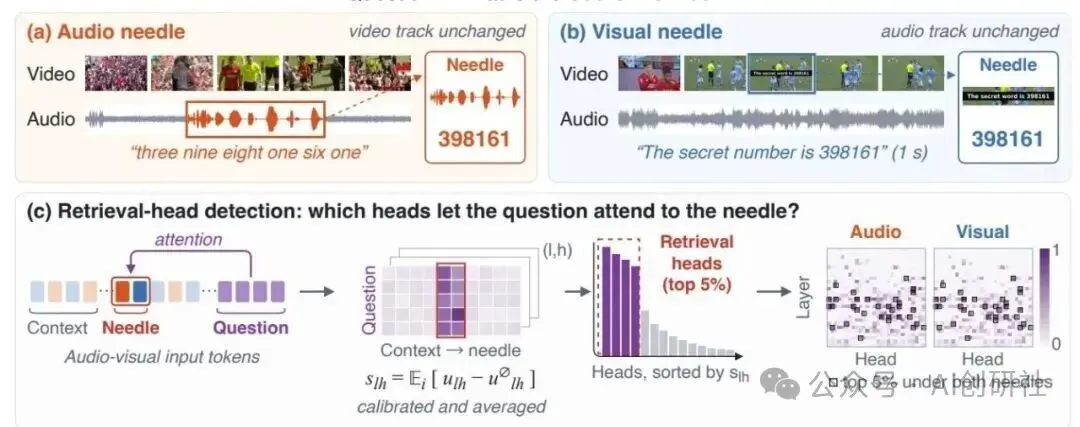
图 1|同一个密码分别藏在音轨和画面中;对问题到证据的注意力做校准,再定位承担检索功能的头。
背景与动机
多模态 RAG 经常在输入端下功夫:怎样切页、选帧、做 embedding。但长材料送进模型后,还有一个问题:模型内部到底靠什么把正确证据取出来?
此前语言和视觉语言研究发现,少数 attention heads 承担了重要的检索功能。可一旦加上音频,机制是否还成立?如果声音用一套头、图像用另一套头,就需要不同的解释;如果共用,说明模型可能已经形成某种跨模态的证据访问机制。
笔者认为,这篇最聪明的实验设计是控制住“内容”。比较一句话与一张自然图片,会同时改变模态和语义,很难解释差别来自哪。作者直接用同一个六位数字,让它被念出或短暂显示,先把这个混杂因素拆开。
核心方法
1. 先扣掉“本来就爱看这里”的注意力
对每个样本,研究者把问题 token 指向证据 token 的注意力加起来,再对问题位置求平均。只看这个分数还不够:某些头可能本来就偏爱某个位置,或者对醒目的数字特别敏感。
所以作者保留同一上下文,把问题替换成无信息问题,再算一次。两者相减,才更接近“有效问题让这个头额外看向了多少证据”。在检测样本上取平均后,按分数排序,默认把前 5% 作为检索头。
2. 机制是否共用,要看排名,也要看干预
作者同时比较全体头的排名相关性与头部集合重合度。音频、视觉证据下的排名 Spearman 相关系数为 0.88—0.92;高分头的重叠也明显超过随机情况。
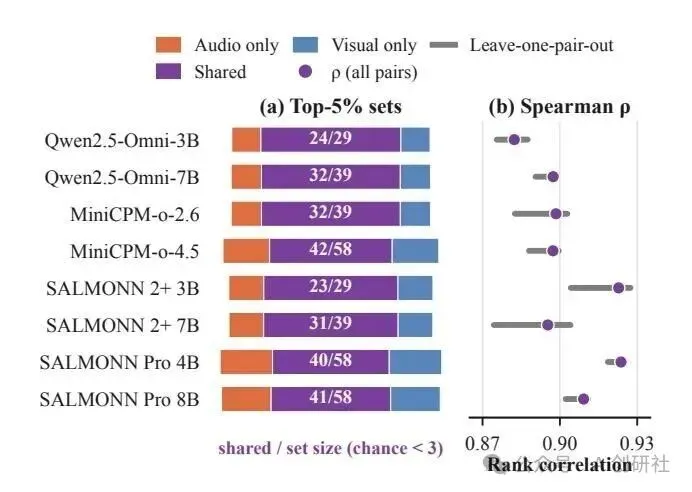
图 2|紫色部分表示两种模态共同选中的头。共享不仅存在于一个模型,而是覆盖受测的八个全模态模型。
接着做真正的干预:在注意力输出投影之前,把目标头的输出置零。随机对照不仅头数相同,而且每一层的数量也匹配;检测头与评估消融使用不同样本。
这一步很关键。笔者不会仅凭热力图就说某个头“负责检索”,但同位置、同规模的随机破坏伤害不大,定向移除却让结果崩掉,证据就强得多。
3. 从解释模型,走到训练检索器
作者在文档任务上固定选出 16 个头,把问题到候选页面的注意力之和当成相关性分数。训练样本包含一个相关页和一个来自同文档的困难负例;对注意力分数归一化后,使用排序损失。
这里不是“只训练那 16 个头的独立参数”。损失由选定头的分数构成,梯度更新的是注意力投影上的 LoRA。推理时再减去无信息问题的分数,延续前面的校准思想。
核心公式
校准后的头分数,对应原文公式(2):
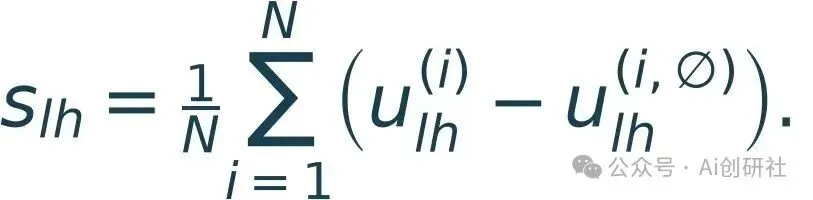
其中, 表示问题对证据的注意力质量,空集上标表示无信息问题。大白话:真正的检索贡献,要扣除不问有效问题时也会出现的关注。
排序训练的目标,对应原文公式(6):
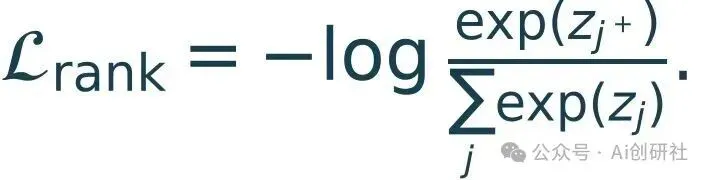
把相关页的归一化分数 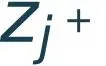 拉高,让它在候选中获得更大的概率。头的位置固定,证据路由的强弱通过训练改变。
关键实验结果
1. 消融:问题出在证据访问,而非随便删头都一样
在 Qwen2.5-Omni-7B 的音频检索实验中,原始 EM 为 98.3%,匹配随机消融后为 96.9%,移除 top-5% 检索头后降到 0(原文第 4.4 节、图 5)。
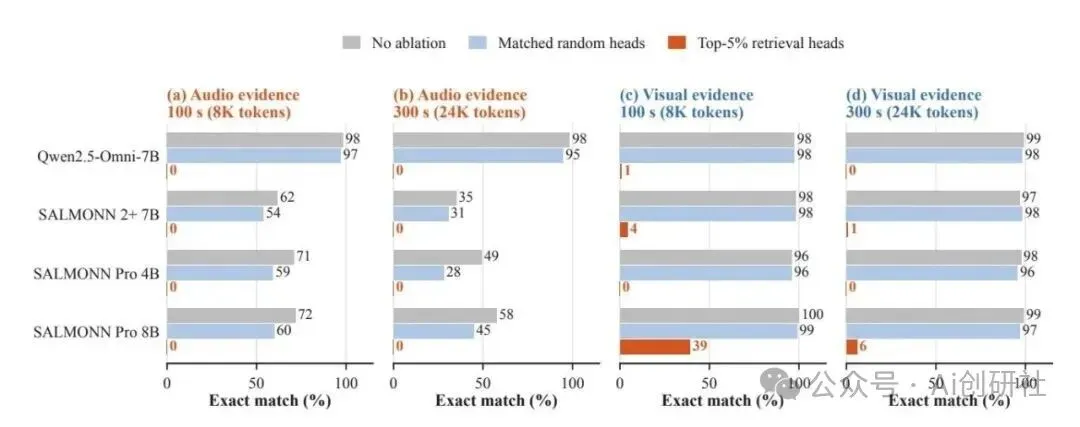
图 3|同样移除少量注意力头,定向消融与随机消融的影响截然不同;作者还比较了不同背景长度。
共享头的作用也不限于找密码。原文表 2 中,音视频共享头的消融,在 16 个模型—任务组合中的 15 个上,比相同规模的自然图像检索头造成更大额外损伤。这让“共享头是跨模态证据接口”的解释更有说服力。
2. 文档检索:同配置训练前后,收益明确
| 62.48% | 48.60% |
来源:原文表 3,固定 16 个头、共享评估配置。页面 Macro R@1 同样从 58.81% 升至 63.86%。训练只使用页面标签,区域检索的提升说明信号能向更细粒度迁移。
跨模型也不是孤例:表 4 中,Qwen2.5-VL-7B 页面 Micro R@1 从 52.41% 到 58.10%,Gemma3-12B 从 44.75% 到 46.92%。各模型候选窗口不同,适合比较各自训练前后的变化。
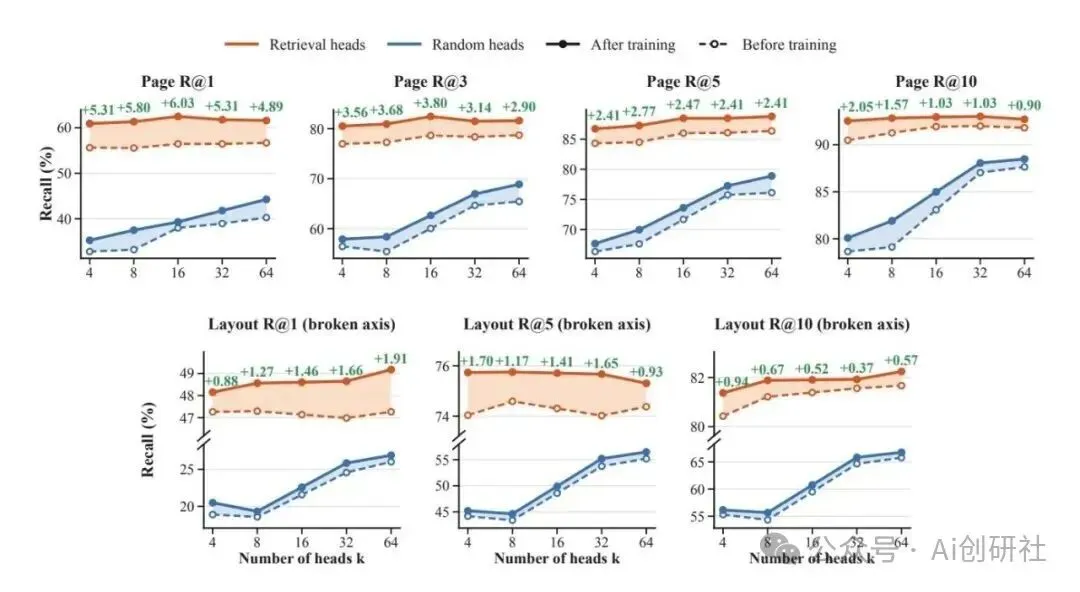
图 4|改变选头数量和召回截断位置,功能性选头仍优于随机选头;训练进一步提升排序质量。
思考与启发
笔者最在意的是,这篇给多模态检索增加了一条路线:除了外挂一个检索器,也可以寻找大模型已经学会的证据定位能力,再对它做定向训练。
机制研究的闭环也很完整:配对输入排除模态与内容混杂,匹配消融检查必要性,最后在实际文档任务上验证用途。比“展示一张漂亮的注意力热力图”多走了两步。
边界集中说清:这些结果来自受测模型与任务;访问注意力需要模型内部接口;少数头重要,不代表其余网络可以删除。对于落地,笔者会先检查自己的长文档能否稳定定位证据,再决定它是否值得替代或补充现有检索器。
参考资料
A Broader Look into MLLM’s Retrieval Heads,arXiv:2610.32411。https://arxiv.org/abs/2610.32411