ARTICLE · 1316313
PDF 里的表格怎么转成 Excel?文件不出本机就能转完
收到一份 PDF 结算单,要用里面的表格做统计。截图识别太糊,手打八行又太蠢,于是去搜"PDF 转 Excel"。
搜出来的头几个都是网页工具:先上传,等它转完,再下载。不少还卡着页数或者文件大小。
问题是你要转的那份,可能是合同附件、报价单、体检报告。往陌生服务器上扔,心里总归不舒服。
今天这个工具走的是另一条路:装在你电脑上,不用登录也不用上传,转换过程在本机跑完。
纸序 PDF,便携版 51MB,解压就能用,MIT 开源,作者是 GitHub 上的 d8349565。Python + PyQt 写的。
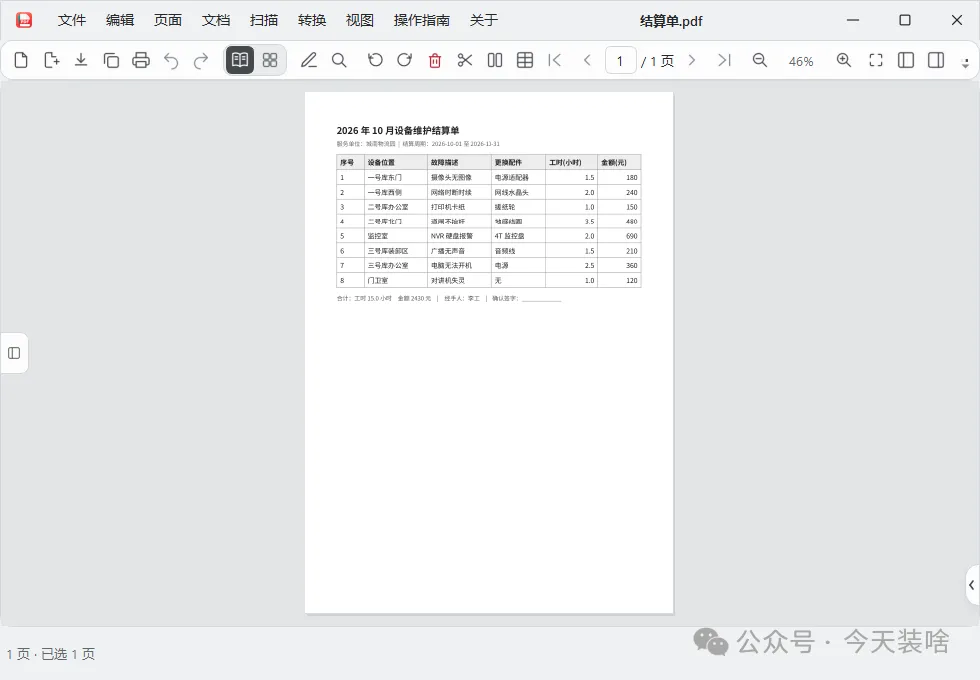
界面就这样,很朴素,没有花哨的东西。菜单栏里有一项叫"转换",我要用的功能在那儿。
随便找份 PDF 测没意义,因为不知道原文该长什么样。
所以我做了一份:8 条设备维护记录,六列,有中文有数字,还有人名和签字栏。用它转一遍,对得上才算数。
打开 PDF,点「转换」→「PDF 转 Excel」,右边滑出面板:
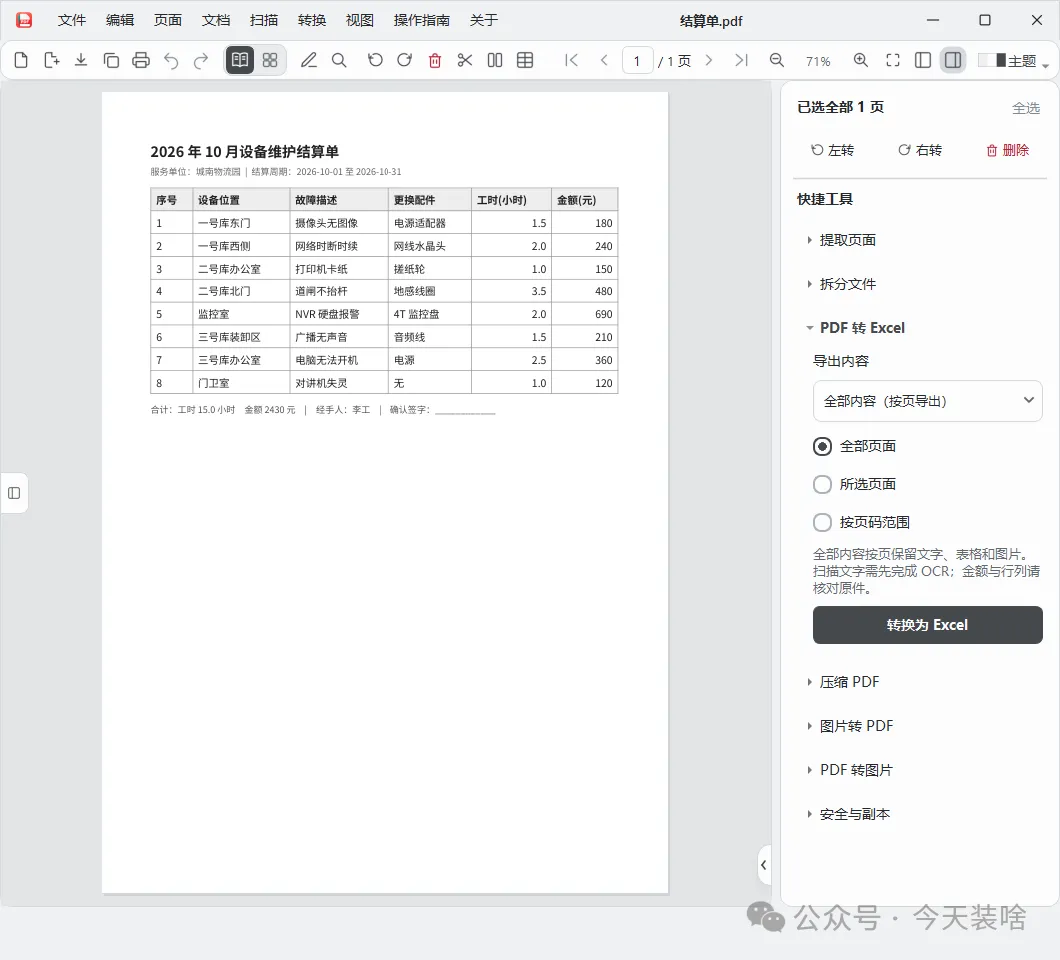
面板上有三个选项:全部页面、所选页面、按页码范围。单页文件直接默认。
点「转换为 Excel」,弹保存框,回车,几秒钟后程序目录里多了个 结算单.xlsx。
转出来的东西对不对
我把它拆开逐格看了,八行数据一行不少:
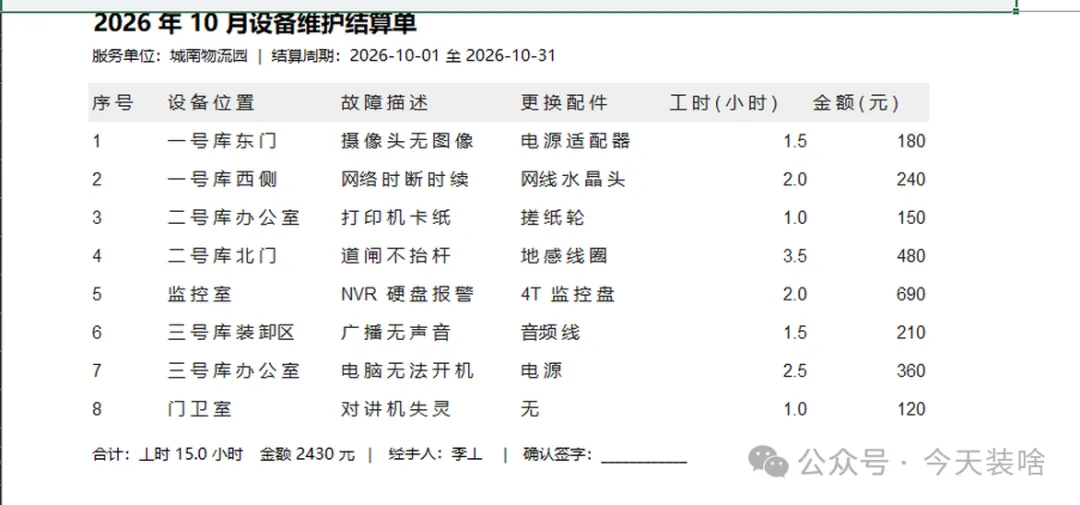
中文一个字没丢,数字一个没错,连"合计:工时 15.0 小时 金额 2430 元"那行都在。
代价是每个中文字之间多了一个空格。
原因我猜是:PDF 里每个汉字都是独立定位的,提取器多半把每个字形当成了单独的词,拼回去的时候用空格连了起来。具体怎么实现的我没去看源码,不敢说死。
清起来不难,Excel 里查找替换把空格删掉,或者用公式 =SUBSTITUTE(A1," ","")。但如果表格大、列数多,这一步挺烦。
这是它目前最明显的短板,用之前得知道。 好在数据本身是准的,清理只是体力活。
面板上那行小字值得看一眼
导出按钮上面有一行灰字:
全部内容按页保留文字、表格和图片。扫描文字需先完成 OCR;金额与行列请核对原件。
作者自己把话说在前面了:扫描件得先 OCR,转完要核对。
第二条我这次验证下来确实成立:数字虽然都对,但位置和行列还得自己看一遍,毕竟是按坐标还原的表格结构。不过这次只试了单页的简单表,合并单元格、跨页表格我没跑过,不知道它碰上这些会怎么样。
扫描件那条也有解:作者另外发了个带 OCR 的版本(91MB),程序菜单里还有个"扫描"入口。不过 OCR 版我没测,这里不下结论。
顺带看了一眼别的功能
转换菜单里除了 PDF 转 Excel,还有转 Word、转 TXT、转图片、转图片版,反过来也有 Word/图片/Markdown 转 PDF。
右侧面板往下滚,还有压缩 PDF、安全与副本(加密、去密码那一类)。
页面管理是它的另一个主打:拖拽调序、多选、旋转、提取、删除,还支持 Ctrl+Z 撤销。整理合同附件那种"扫描顺序全乱了"的活儿,比在阅读器里一页页挪快。
这些我只看了菜单和面板,没逐个跑,写出来是让你知道它有什么,不代表我都验证过。
用之前要知道的
体积不小。 51MB 便携版,OCR 版 91MB,安装版 40MB。比那些几 MB 的小工具重,但它是 PyQt 打包的,里面带着 Python 运行时,这个体积算正常。
便携版解压后是个文件夹。 主程序 ZhiXuPDF.exe 旁边有个 _internal 目录,一百多个文件。别只把 exe 拷走,拷走就打不开了。要放 U 盘就整个文件夹一起放。
保存位置默认在程序目录。 我这次转出来的 结算单.xlsx 直接落在程序文件夹里,不是 PDF 旁边。找文件的时候别只盯着原目录。
中文空格问题。 上面说过了,转完记得清。
扫描件要 OCR 版。 普通版对纯图片 PDF 没辙,它自己也提示了。
工具信息
工具名:纸序 PDF(ZhiXuPDF)v0.11.2作者:d8349565(GitHub)许可:MIT,可自由分发仓库:https://github.com/d8349565/pdf-manage
三个版本:安装版 40MB、便携版 51MB、带 OCR 的 91MB,都放在 release 页,另附了 SHA256 校验文件。