ARTICLE · 1318595
两台Spark加一个REA,够不够接老软件的活
最近REA火了,正巧我手上有一台Spark,本来想自己把模型跑一遍,再逆一个小软件,拿实测数据写这篇。后来翻了一圈公开记录,发现该有的数都有人测过了,省了我一晚上。
先说硬件这边。
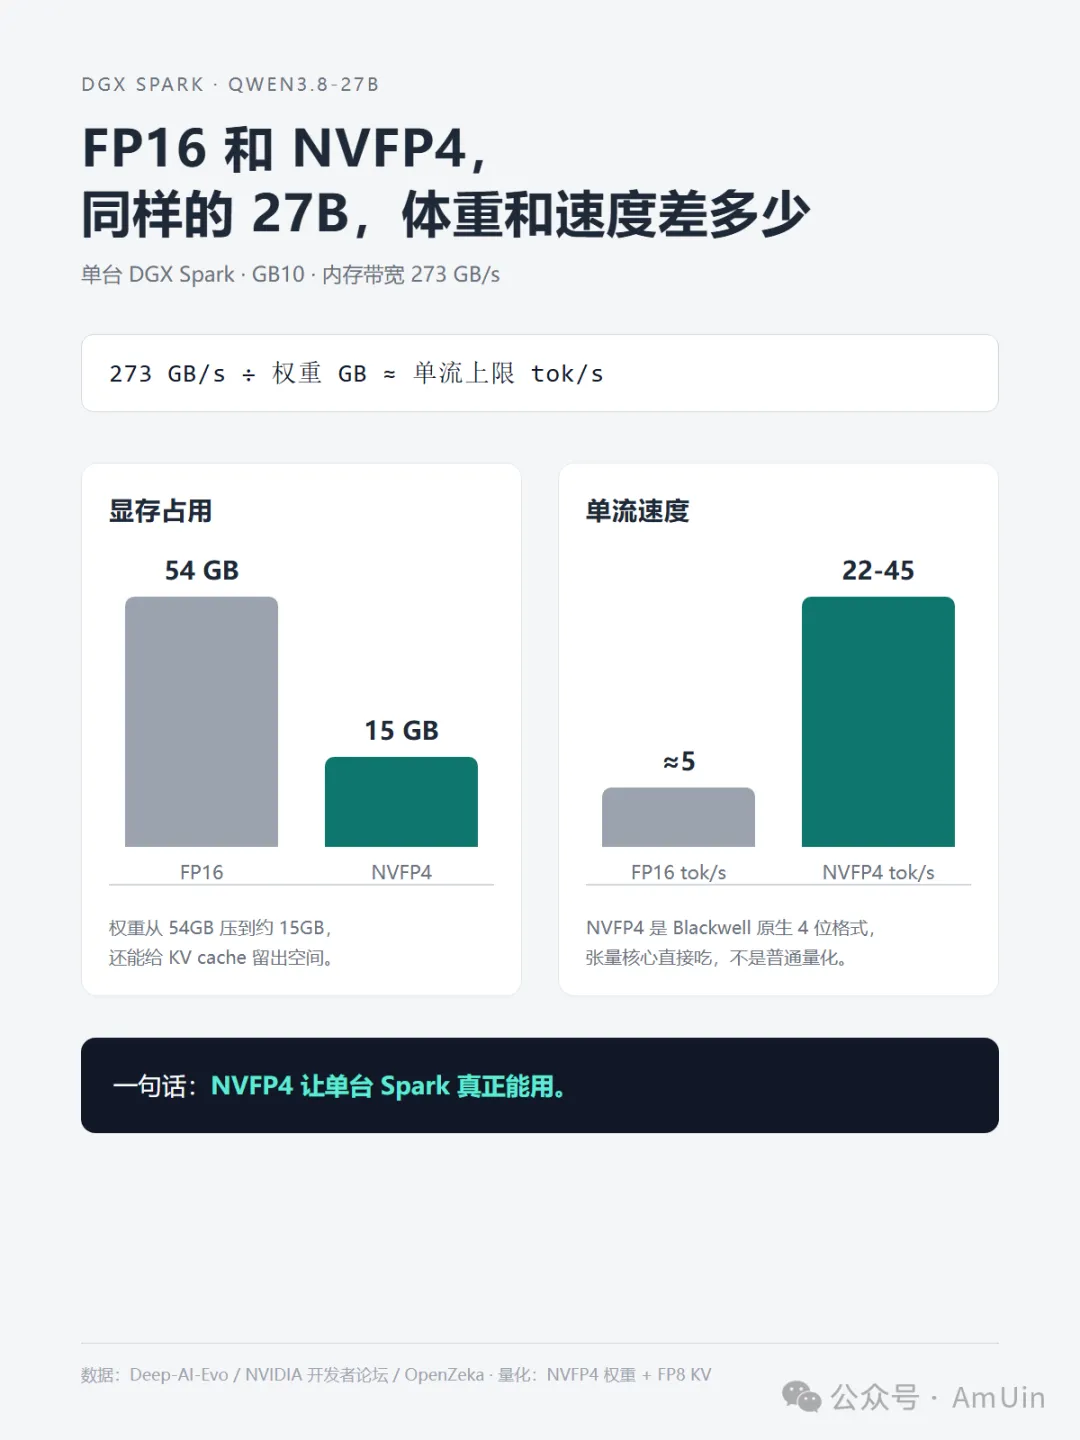
Spark的128GB版6950美元,GB10的芯片,内存带宽273GB/s。跑Qwen3.8-27B,vLLM加MTP大概22.7 tok/s(思考模式),非思考16.7;换SGLang加DFlash2能到34.7,峰值42.8;中文散文会掉到17左右。Q4的GGUF走llama.cpp,单流10到15。
上面这些数都是NVFP4跑出来的。27B的权重压到十几GB,单流才有这个速度。换FP16,权重五十多GB,单流会掉到个位数。
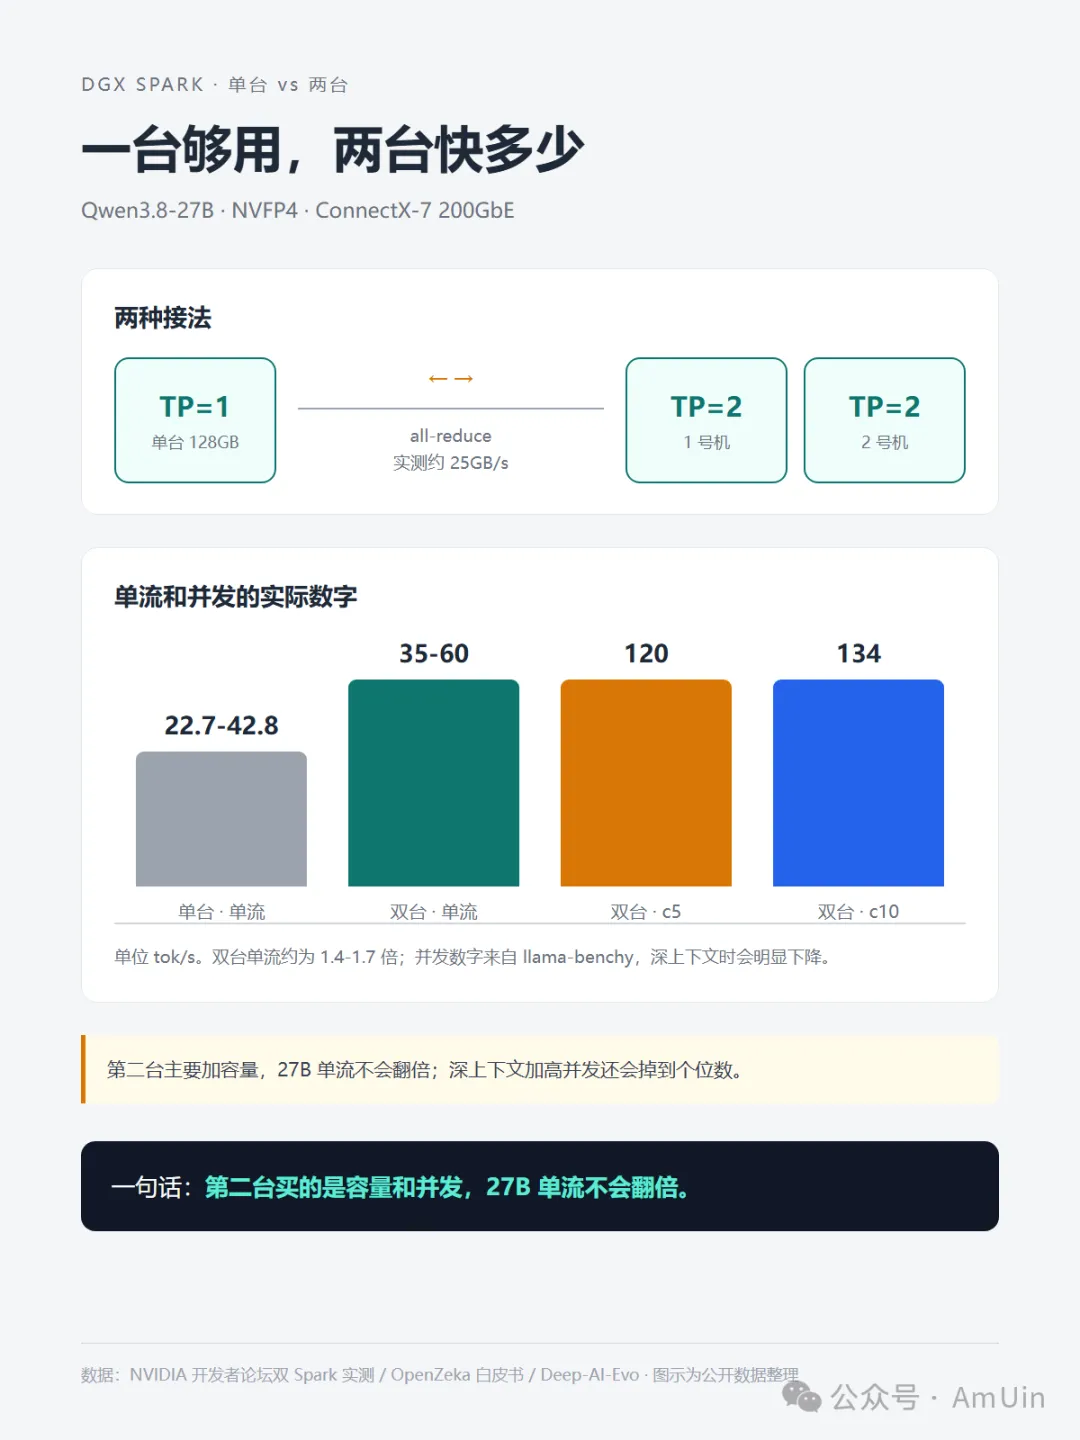
两台Spark用ConnectX-7连起来,NVIDIA官方说最高1.7倍。第三方实测大概1.4到1.6倍,代码负载52.7到76.0,英文散文24.7到38.4。第二台主要是加容量,27B单流不会翻倍,深上下文加高并发还会掉到个位数。
这个速度够干什么?写代码、改文档、跑agent,够。要拿它当多人服务,不够。
再看REA。
它是开源的,MIT协议,命令行加MCP服务器,把Ghidra、IDA、Hopper、JADX这些工具包成Claude Code、Codex、Cursor能直接调的接口。它自己不带模型,也不带反编译器。值钱的是那套“提问、取证、解释、验证”的工作流。
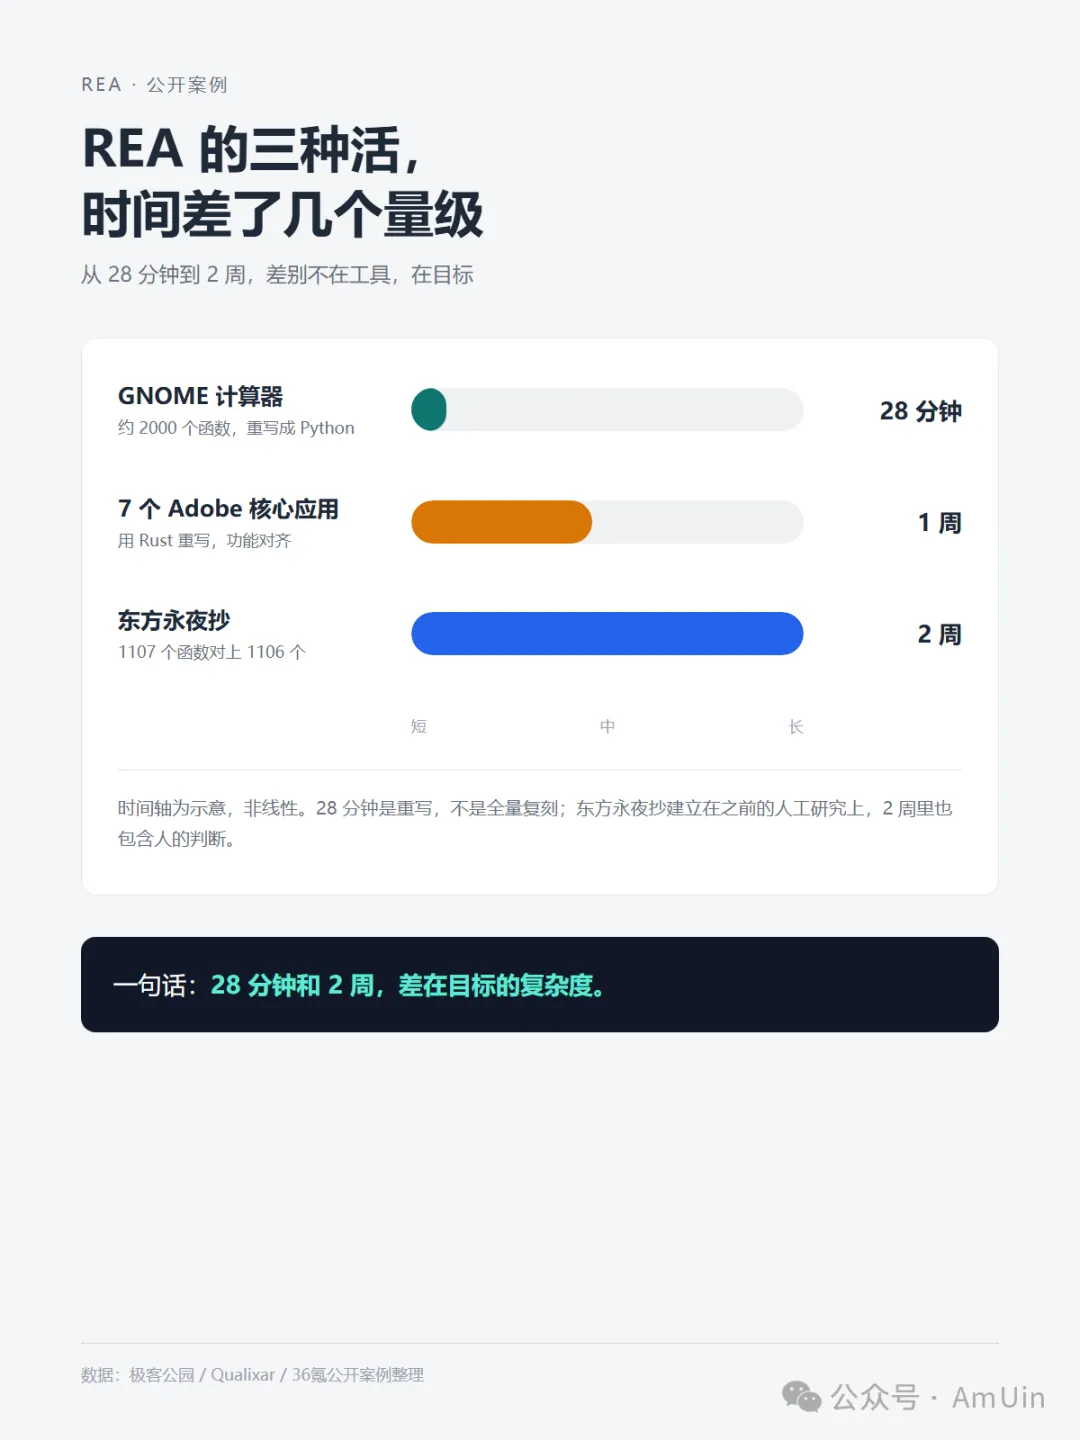
公开案例里,有几个数挺具体。GNOME计算器,90MB的ELF,约2000个函数,28分钟重写成Python,功能基本对上,UI有小毛病。DX-Ball那个1996年的游戏,一个声像函数,agent追了调用链、还原了浮点常数和公式,跑了3205组行为测试,VC4.0重编译后63个字节全对。东方永夜抄1107个函数对上了1106个,但花了两周,而且建立在之前的人工研究上。7个Adobe核心应用,一周用Rust重写了一遍。光环也被拆开移植到了浏览器。
听起来像“软件已死”。先别急。
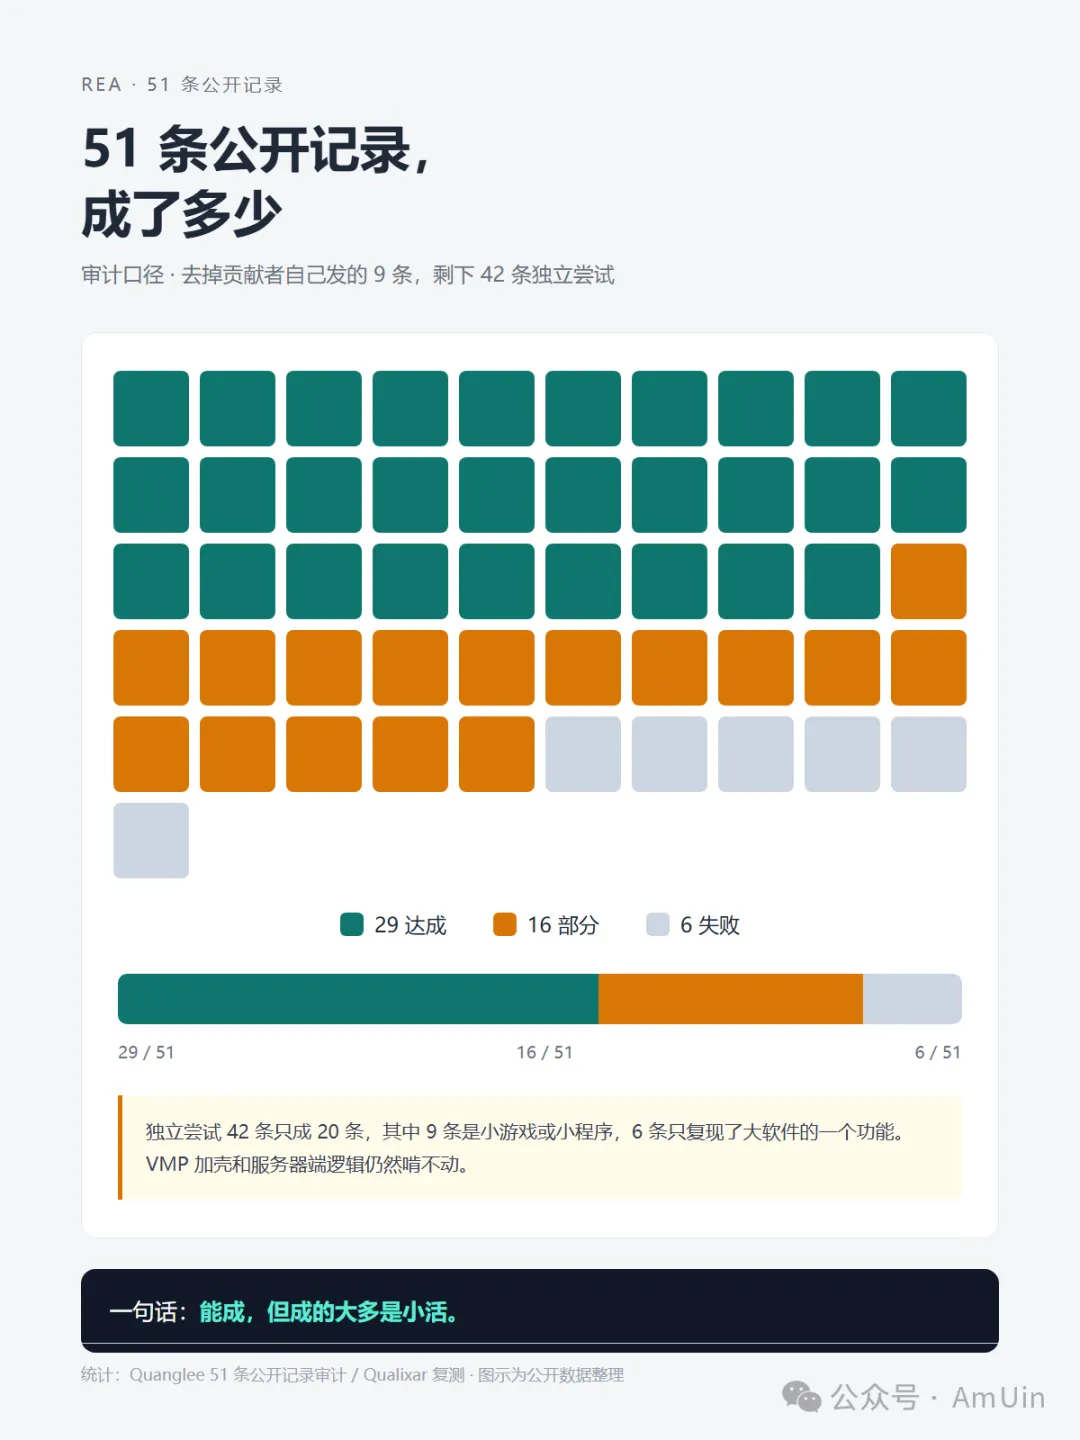
有人统计了51条公开的REA记录,29条达成目标,16条部分达成,6条失败。去掉贡献者自己发的9条,独立尝试42条只成了20条,其中9条是小游戏或小程序,6条只复现了大软件的一个功能,5条没写清楚目标是什么。Quarkslab那边试过,Claude在沙箱里对加壳的二进制一个隐藏字符串都掏不出来,被挡住的时候还会编一份看起来很像的报告。VMP这种强虚拟化保护啃不动,服务器端逻辑永远拿不到。
成本也不便宜。REA的200多个工具,在一个小请求上能烧40万token,按API价格差不多160美元。有人用一个8KB的精简skill加shell工具做对照,速度快38%,便宜35%,token少60%,准确率只差一个。
法律那边也在收紧。拆开研究是一回事,照着重建是另一回事。AI一边读反编译结果一边写新代码,把“净室开发”那道防火墙拆穿了。用户协议大多禁止反编译,DMCA和NDA的风险都在。
那这门生意到底能不能做?
有报道提到,招聘网站上出现过日薪五千的游戏逆向岗位。老软件、老游戏、历史数据迁移,需求是真的。原公司跑路、源码丢失、数据还要拿出来接新系统,这些活以前要靠老师傅一点点啃,现在AI能先把结构摸出来。
但成交的多是细活。一个函数、一个许可证检查,几十分钟到几天。大工程还是要人工收尾,两周啃一个游戏那种,算不上便宜。
所以两台Spark加一个REA,能接活,接的是细活。软件没死,只是修它的人换了一批工具。