ARTICLE · 1319958
工业AI大模型数据训练软件测试方法
11月25日-27日 | |
报名咨询:熊老师 13517202453(微信同号)
随着工业智能化和数据要素化进程加快,工业AI大模型逐步应用于工艺优化、设备运维和质量管控。与通用模型相比,工业模型深度依赖生产机理和现场数据,训练软件不仅要完成数据接入、清洗、对齐和训练调度,还要保证模型、算力与业务流程协同运行。
工业数据具有多源异构、强时序、高噪声和场景强依赖等特征,传统软件测试难以充分覆盖协议适配、极端工况、多模态输入和长时稳定性。深度学习框架缺陷还可能沿训练链路放大并影响模型结果,因此需要从软件、数据和运行环境三个层面实施系统测试。
现有研究多关注算法性能或单一场景应用,面向工业AI训练软件的数据适配、功能、性能、容错和安全一体化测试仍缺少可复用流程。本文据此构建闭环测试方法,提出五项工程化优化策略,并通过流程工业软件内部测试验证其可行性。
1 工业数据对大模型训练软件的约束与影响
1.1 工业数据四大类型及测试侧重点
工业数据贯穿生产全链路,可归纳为设备运行、工艺参数、质量检测和环境业务四类。多模态模型训练对样本组织、检索与输入一致性提出更高要求,不同数据类型的测试侧重点如表1:
表1 工业数据类型、核心特征及测试重点
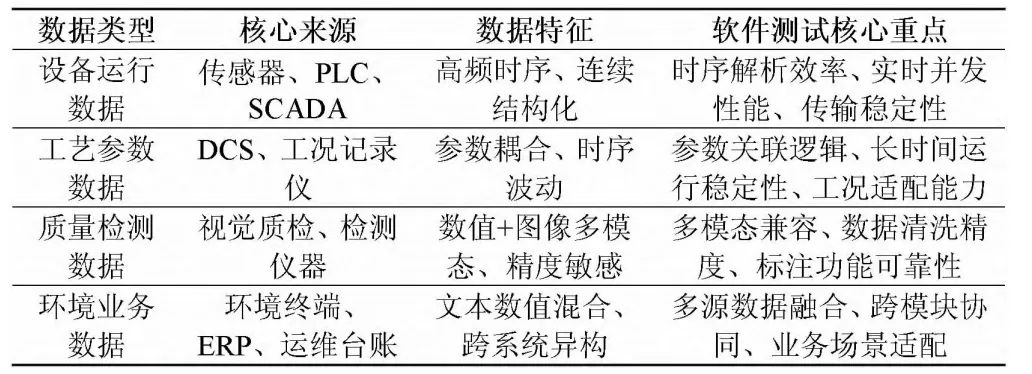
四类数据分别支撑设备预警、工艺优化、质量判别和全流程决策。测试既要验证单类数据处理的正确性,也要检查跨来源关联、时间对齐和多模态融合结果。
1.2 工业数据五大核心特征
工业数据的以下特征直接决定测试设计:
1)多源异构:设备、系统协议和存储格式不统一,需要验证接口、字段映射、单位换算和编码兼容性;
2)强时序性:数据具有采样周期、先后关系和因果约束,需要检查时间戳、乱序处理、窗口计算和断点续传;
3)高噪声:设备误差和现场干扰会产生缺失、漂移、重复及异常值,需要评估清洗规则的准确性;
4)场景强依赖:数据分布与行业、装置和工况绑定,测试数据必须覆盖稳态、启停、切换和故障状态;
5)高价值与敏感性:工业数据包含配方、参数和生产规律,测试需兼顾数据可用性与隐私安全。大模型红队测试可覆盖有害输出、提示攻击及隐私安全等风险,应将访问控制、脱敏、审计和对抗测试纳入测试范围。
1.3 数据对软件与模型性能的三重影响
1)功能完整性:多形态数据要求软件具备采集、清洗、对齐、训练、评估和部署能力,测试需验证模块内逻辑及跨模块数据传递;
2)运行稳定性:海量时序数据并发接入和长时间训练会持续占用计算、内存、网络与存储资源,需要检查吞吐、时延、资源峰值和恢复能力;
3)模型训练有效性:脏数据、格式错误和处理偏差会传导至模型,导致训练失败或结果偏移,因此应将数据质量校验与训练结果核查关联起来。
2 工业AI训练软件测试需求与量化目标
2.1 核心测试需求
1)数据适配:兼容主流工业协议和多源异构格式,保证字段、单位、时间戳及数据类型转换正确。
2)功能完整:覆盖数据预处理、样本管理、训练调度、模型导出和推理验证等关键流程。
3)性能稳定:在峰值并发、资源受限和长时间运行条件下保持可接受的时延、吞吐和资源占用。
4)容错与安全:能够识别、隔离和恢复异常数据或中断任务,并对敏感生产数据实施全流程保护。
2.2 量化测试目标
1)数据适配指标:统计正确解析样本数占有效输入样本数的比例,并分别记录协议、格式和字段映射兼容情况。
2)性能指标:记录数据接入吞吐量、平均及P95时延、并发任务数、CPU和内存峰值,阈值根据部署环境与业务实时性要求确定。
3)质量指标:统计场景覆盖率、缺陷检出率、异常数据容错率和回归通过率。智能软件测试用例生成需兼顾覆盖率、有效性和揭错能力,评价不应只依赖单一覆盖指标。
4)安全指标:验证未授权访问、敏感字段暴露、传输篡改和审计缺失等风险;高风险安全缺陷应在上线前清零。
3 测试技术与闭环实施流程
3.1 核心测试技术
针对工业数据特点,测试采用真实脱敏数据、合成边界数据和仿真异常数据相结合的方式,并为每类用例设置输入、预期结果、监测指标和通过准则。核心技术包括:
1)异构数据适配测试:构造不同协议、编码、单位、采样频率和字段缺失组合,验证协议解析、格式转换及错误提示。
2)全场景功能测试:采用黑盒与白盒相结合的方法,按业务链路覆盖主要模块,并利用数据变异提高高风险用例的揭错能力。
3)性能压力测试:逐级增加数据规模和并发任务,模拟峰值负载及72h连续运行,监测时延、吞吐、资源占用和任务成功率。
4)容错与安全测试:注入缺失、重复、乱序、漂移、协议中断和篡改等异常,检查告警、隔离、重试与恢复;基于大语言模型的模糊测试可生成异常输入、扩展边界场景并提高缺陷发现效率。
3.2 闭环测试流程
测试流程包括测试准备、测试执行、缺陷分析和优化验证四个阶段,各阶段循环衔接,形成持续改进闭环,具体实施流程如图1所示:
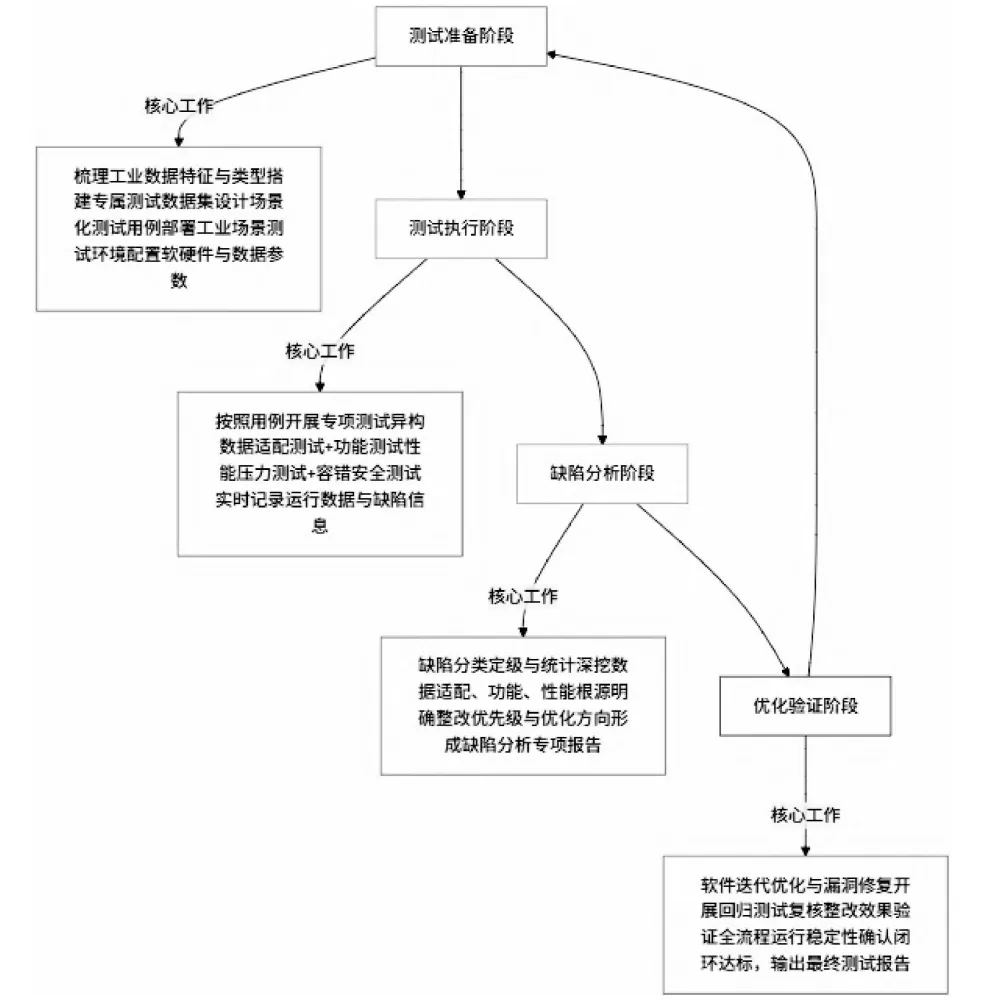
图1 测试实施流程
1)测试准备:分析产线数据特征和风险,确定指标阈值,构建标准化数据集,配置软硬件、网络及仿真参数。
2)测试执行:按风险优先级开展适配、功能、性能、容错和安全测试,记录输入版本、环境配置、日志及运行指标。
3)缺陷分析:按严重程度、影响模块和触发条件分类,关联日志、数据样本与软件版本,定位数据、功能及性能根因。版本演化中的缺陷跟踪有助于保持问题状态和修复信息一致。
4)优化验证:完成修复后执行定向复测和全量回归,确认缺陷关闭、指标达标且未引入新问题,再形成测试报告。
该流程以可追溯数据和可重复环境为基础,通过复现典型与边界工况缩小仿真环境和真实产线之间的差异。
4 工业AI训练软件测试的主要困境
1)数据适配难:工业协议、字段语义和采样方式不统一,标准化测试数据集建设成本高,通用工具缺少工业语义校验能力。
2)场景覆盖不足:测试多集中于常规稳态工况,对启停切换、网络中断、数据漂移和高噪声等边界状态覆盖不足。
3)评价口径不统一:指标定义、阈值和环境配置缺少统一记录,导致测试结果难以复现和横向比较。
4)测试效率偏低:自动化覆盖不足,数据准备、执行和报告依赖人工,难以跟随软件与模型快速迭代。
5)容错与安全难协同:异常模拟不充分,直接使用生产数据又可能泄露配方、工艺参数和设备状态。
5 系统化测试优化策略
5.1 构建标准化工业测试数据集
按行业和装置建立数据字典,统一字段含义、单位、采样频率、协议和异常标签;融合真实脱敏数据、规则合成数据与仿真异常数据,形成基础集、边界集和回归集。数据集应记录来源、版本、适用场景及预期结果,并通过抽样复核保证标签质量。
5.2 建立全场景分层测试用例体系
围绕稳态运行、高并发、数据异常、极端工况、多模态混合和跨系统协同建立“场景-风险-用例-指标”映射。优先覆盖高影响、高发生概率链路,再通过仿真与现场验证复现网络波动、设备抖动和任务中断,减少环境偏差。
5.3 完善量化指标与测试规范
从数据适配、功能性能和容错安全三个维度定义指标、计算方法、数据来源及合格阈值。测试报告同步记录软件版本、数据集版本、环境配置、执行时间和缺陷状态,使结果可追溯、可比较、可复现。
5.4 构建云边协同自动化测试架构
自动化框架统一完成数据装载、用例编排、异常注入、指标采集、缺陷记录和报告生成。云端承担大规模数据与多任务压力测试,边缘端复现协议接入、实时响应和弱网工况;云边端协同架构可根据实时性与负载进行资源分配。
5.5 加强容错与数据安全协同管控
建立覆盖缺失、重复、乱序、漂移、越界、协议中断和恶意篡改等情况的异常库,验证告警、隔离、降级和恢复能力。测试数据采用分级分类、脱敏、最小权限和全程审计,并检查传输与存储完整性;远程证明等机制可用于数据服务完整性验证。
在缺陷分析环节,可融合信息检索结果与深度模型特征,以提高缺陷定位的准确性;大语言模型还可辅助测试用例生成、错误追踪和缺陷定位,但其输出仍需人工复核。同时,工业AI训练软件的安全保障应贯穿需求、数据、模型、部署与维护全生命周期。
6 工程案例验证———中控TPT工业AI训练软件
6.1 案例对象
选取中控TPT流程工业AI大模型训练软件作为验证对象。该软件面向石化、煤化工等流程工业,具备数据接入、清洗、时序对齐、多模态融合、训练调度、测试验证和轻量化部署等功能,可连接PLC、DCS等工业系统并支持OPCUA等通信协议,覆盖设备预警、工艺优化、质量管控和能耗调节场景,具有工程代表性。
6.2 测试设计与结果
本次内部测试依据统一指标口径记录优化前后结果。测试数据由真实脱敏样本和仿真异常样本构成,用例覆盖常规、边界、异常、压力和安全场景;主要结果如下:
1)数据适配:构建52.7万条样本,其中真实脱敏数据占75%、仿真异常数据占25%。数据适配率由91.3%提高至99.2%,10万条时序数据单批接入耗时由120s缩短至35s。
2)场景覆盖:设计216项分层用例,场景覆盖率由67.2%提高至100%,发现19项潜在缺陷;结合仿真环境与3条试点产线开展15d现场验证,以检查环境差异。
3)指标与容错:建立12项量化指标,结果均达到预设阈值;异常数据容错率由86.4%提高至96.8%,测试期间未发现数据泄露事件。
4)自动化效率:应用自动化测试框架和云边协同调度后,单轮测试周期由15d缩短至6d,缩短60%;测试人力成本和算力成本分别降低55%和42%。
5)安全与稳定性:异常注入验证了系统的告警、隔离及恢复能力,数据脱敏合规率达到100%,连续72h稳定性测试通过。上述结果来源于项目内部记录,受数据规模、软硬件配置、阈值设置和应用场景影响,尚不能直接外推至其他行业。后续需在不同装置、协议和算力环境中开展重复试验,并补充模型精度变化与统计显著性分析。
7 结束语
工业数据的多源异构、强时序、高噪声和高敏感性决定了工业AI训练软件不能仅沿用通用功能测试。本文方法能够提高数据适配率、场景覆盖率和测试效率,但其外部有效性仍需更多项目验证。未来可将大模型辅助用例生成、变异算子推荐和缺陷定位引入测试平台,同时建立跨行业指标基线和可共享的脱敏数据集。通过融合检索结果、代码语义、运行日志和深度特征等多源信息,可进一步提升缺陷定位的准确性与可追溯性。后续还应重点评估生成用例的有效性、可解释性和安全边界,并针对大模型可能产生的幻觉设置人工复核与结果校验机制。此外,工业AI训练软件的安全保障应覆盖需求分析、数据处理、模型训练、部署运行和维护演化的全生命周期,逐步形成可复制、可验证、可推广的测试规范。
原文刊载于《工业控制计算机》2026年第10期 作者:胡灿娣 李波波 王勇 郑群辉