ARTICLE · 1321745
AI工具更新后,Token多消耗了30%,我用两台电脑跑了7轮测试
大家好,我是朱小五。
我桌面上有两台 Mac mini,一台装的是今年上半年的老版 CodeBuddy(4.9.7),另一台顺手升到了最新版(4.12.1)。平时两台换着用,我总隐约觉得新版扣积分更快。
这让我想起今年 Claude 换新分词器时被大家抓出来的「隐性涨价」。我干脆用完全一样的模型(DeepSeek-V4.1-Flash)和项目,实测了 7 轮对照任务,把每次回车多掏三成积分背后的账本和底层机制彻底摸清了。
01
PART
双机 7 轮实测
BENCHMARK TEST
我把两台机器的文件路径、测试任务和账号严格分开,前后交叉跑了 7 轮:
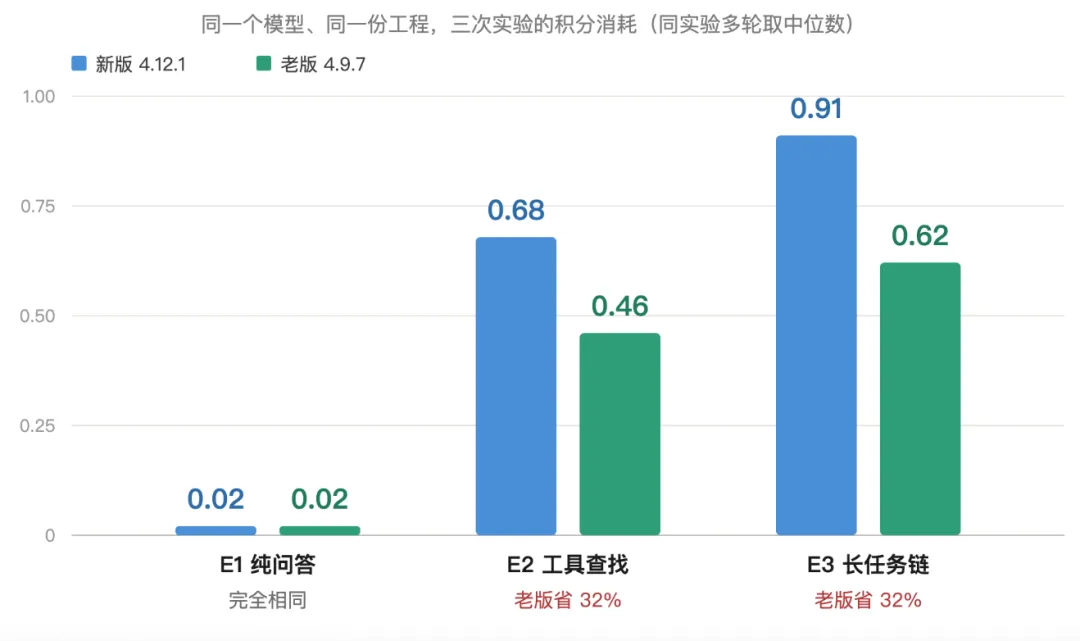
对比结果一目了然:只要不调工具,两边底噪完全一样;但凡开始调用工具,老版稳稳省下三成。 我跑完 7 轮一算,新版花了 3.28 积分,老版只花了 2.48 积分,综合省了 24% 到 32%。
平时大家在工位上用 AI,有没有也觉得哪个工具越更新扣费越快?在评论区跟我说一声。
02
PART
同样动作更贵了
COST ANALYSIS
新版更新了这么多功能,会不会是因为它比老版干了更多的活?
我顺手抓了两台机器后台的调用日志,核对跑同一道题时的真实动作步数:
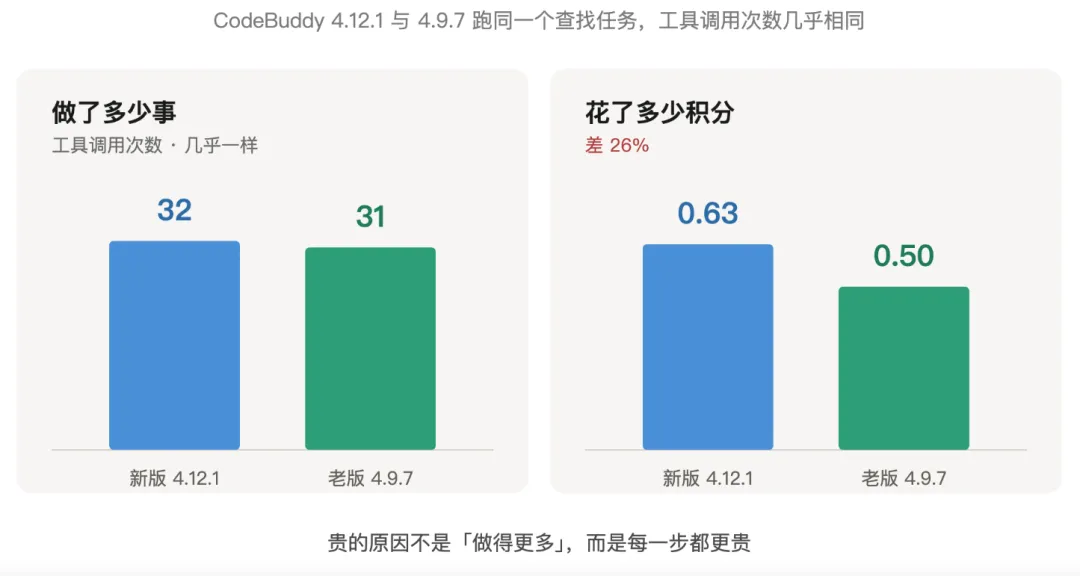
结果推翻了我的假设。两个版本调用工具几乎一样(32 次比 31 次),读文件、写答案每一步我都对得上,账单却整整差了 26%。
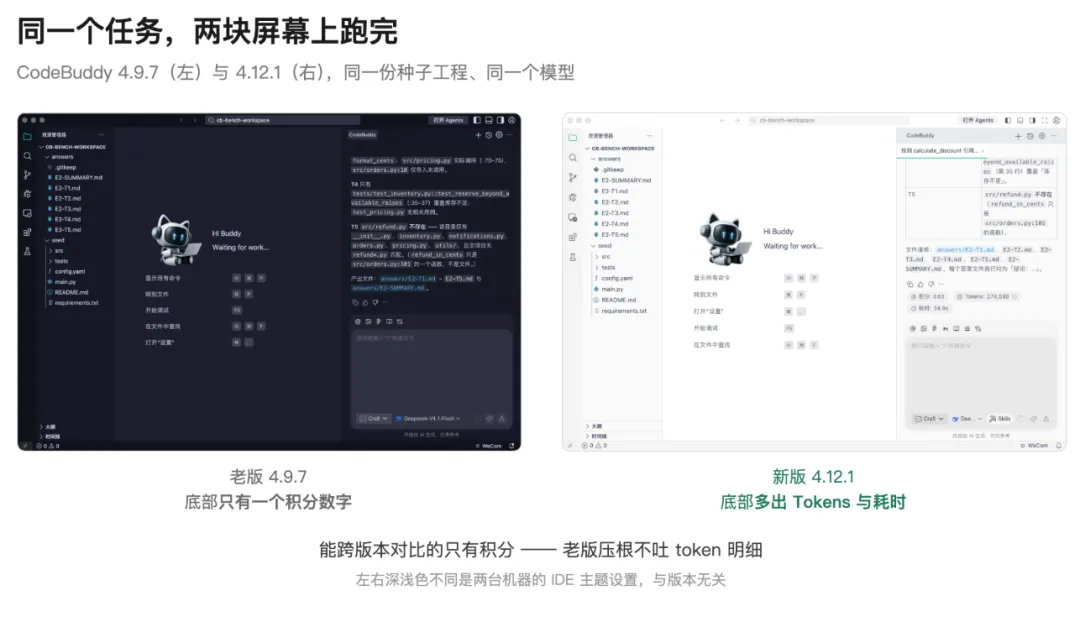
新版不是做得多才变贵,而是同样的动作,它每一步都比以前更花钱。
那多掏的三成积分换来更好的答案了吗?我把最后一轮两边交出来的代码质量报告,原样拿出来让 Codex 当裁判打分:
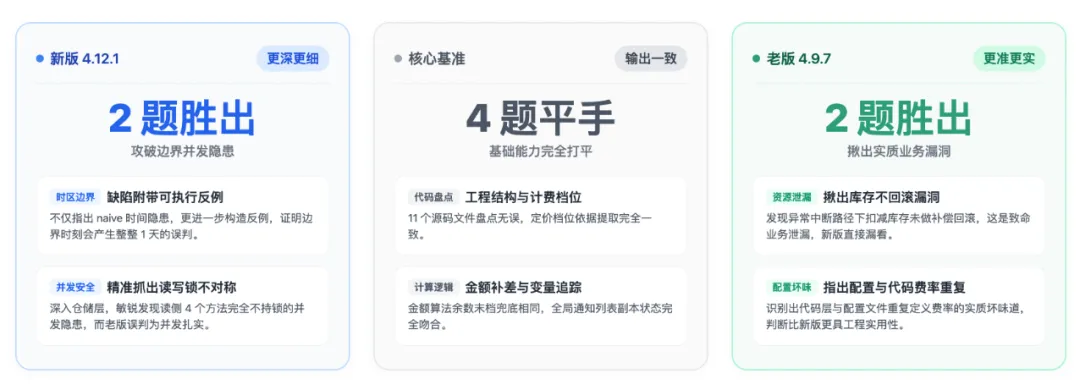
我仔细一对,两边打了个 2:2 平手。多花三成积分,并没有换来质量上的明显优势。
03
PART
官方日志的秘密
LOG SECRETS
为什么同样的动作,新版单步更贵?我翻出官方近半年的更新日志,抓到了两个核心机制:
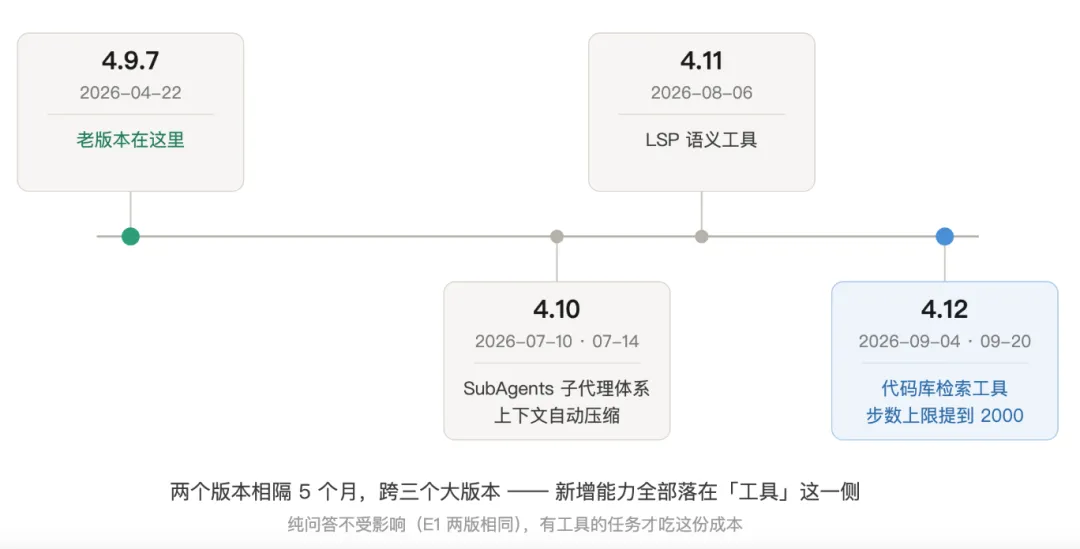
第一是「上下文自动压缩」。以前我以为压缩是帮咱们省钱,这次抓了日志才发现根本不是软件本地删代码,而是它在后台又调了一次大模型做摘要,压缩本身就在额外烧 Token。
第二是「上下文越滚越大」。我顺着更新日志一看,新版加入了子代理(SubAgents)、LSP 语义工具和全库检索,它们在后台跑一圈,把成百上千行代码顺手全倒回了主对话里。只要我一让它当 Agent 干活,塞进上下文的内容停不下来,每次一回车都在累积扣费。
折腾完这 7 轮实测,我倒不是劝大家死守老版本。新版功能更全,处理超大工程确实吃得开,但会多消耗Token这件事也是真的。
我是朱小五,我们下篇见。