ARTICLE · 1324154
每周一讲丨AI 是怎么学会的?
11 月 6 日晚上 8 点,丁玉海名师工作室编程创客项目组的李萌老师,带来了人工智能通识教育第九课——面向六年级学生的《AI 是怎么学会的?》。课程延续系列“先上课、再说课”的形式:30 分钟真实课堂 + 10 分钟面向教师的设计拆解。前八期里,孩子们认识了 AI 的“眼睛”和“耳朵”,学会了让 AI 画画、听懂提示词、批改作业,也在 L1 收官课上,把七样本领拼成了一张“AI 成长地图”。地图拼完了,可上面始终缺一块——AI 这些本领,到底是从哪儿来的?
这一课,李萌老师把缺的那一块补上了。而且她没有直接讲答案,而是先递给孩子们一个新身份。
情境导入:你不是使用者,你是AI小老师
课堂第一句,李老师就把题目的重音拧了个方向:
“这节课的题目是《AI 是怎么学会的?》。注意,不是问‘AI 有多厉害’,是问‘它怎么学会的’。就像我们不问‘你怎么这么会骑车’,而要问‘你当初是怎么学会骑车的’。”
接着是三个孩子们天天在用的东西:手机相册——拍了八百张照片,它自己就分好了类,还能认出你家那只猫;小音箱——喊一句“放首歌”,它就放了;短视频——刷什么多就一直推什么,比你自己还清楚你喜欢看什么。
然后是一个只要三秒钟的问题:“它们,上过学吗?”
没有老师讲课,没有课本,没有考试。可它们就是会。
“那它们是怎么会的?这就是今天要拆开看的秘密。拆开之后你会发现:它们用的办法,和你学东西的办法,是同一种。”
这就是这节课的第一次身份置换:孩子不是 AI 的使用者,而是 AI 的小老师。它认对了,是老师的功劳;它认错了,是老师没教好。
三个选项:教电脑认「3」,你会怎么教?
第二个任务更像一道选择题。
一台电脑,这辈子从没见过数字。你说“3”,它一点感觉都没有。现在请你当老师,教它认识“3”,你会怎么教?
A:把规则写给它——先画一个弯,再画一个弯,最下面来一横,这就是 3。
B:给它看很多很多例子——几百张写着 3 的图片,让它自己琢磨。
C:什么也不说——丢一堆图片过去,看它能不能自己分出来。
孩子们举手、喊答案。李老师不急着判对错,只多问一句:“你凭什么这么想?你选的这个办法,你自己小时候学东西的时候用过吗?”
答案揭晓的方式很妙——“这三个选项,正好就是人类研究 AI 的三条路。有成功的,有失败的,也有今天特别火的。”
一条选择题,就这样变成了整节课的路线图。
原理揭示:AI 的课本:一张一张的「题 + 答案」
AI 要学会,第一样东西是数据。李老师把它翻译成一句孩子立刻懂的话:数据,就是 AI 的课本。台上是一叠卡片,每张正面写着一个数字。但关键在背面——每张卡片背后都写着答案。正面是 3,背面写着“3”。这个写在背后的答案,正式名字叫标签。“我们的课本是知识,它的课本是一张一张的‘题 + 答案’:题是图片,答案是标签。你想想,如果有人给你看字,却从来不告诉你念什么,你能学会吗?学不会。AI 也一样——没有例子,它什么也学不会;没有答案,它连自己在学什么都不知道。”
讲到这里,李老师埋了一颗很深的伏笔:“这些答案,是谁写的?这个问题先记着,课快结束的时候我们回来算账。”
(1)AI 眼里的「3」:784 个数字
人看一眼就知道是 3。AI 没有眼睛,它看见的是另一回事——把图放大、再放大,变成一格一格的小方块,每个方块里藏着一个数字:亮的地方数字大,暗的地方数字小。接着是一道现场算术题:这张图 28 格宽、28 格高,一共多少个格子?全班一起算:28 × 28 = 784。
“所以在 AI 眼里,这张‘3’根本不是‘3’,而是 784 个数字排成的一个方阵。这 784 个数字,就是它的特征——它拿来认人的‘长相的特点’。”
有意思的是后半句:“AI 说不清自己找到了什么特点。它不会说‘这是耳朵’,它找到的是一堆我们说不出口、但特别好用的特点。”
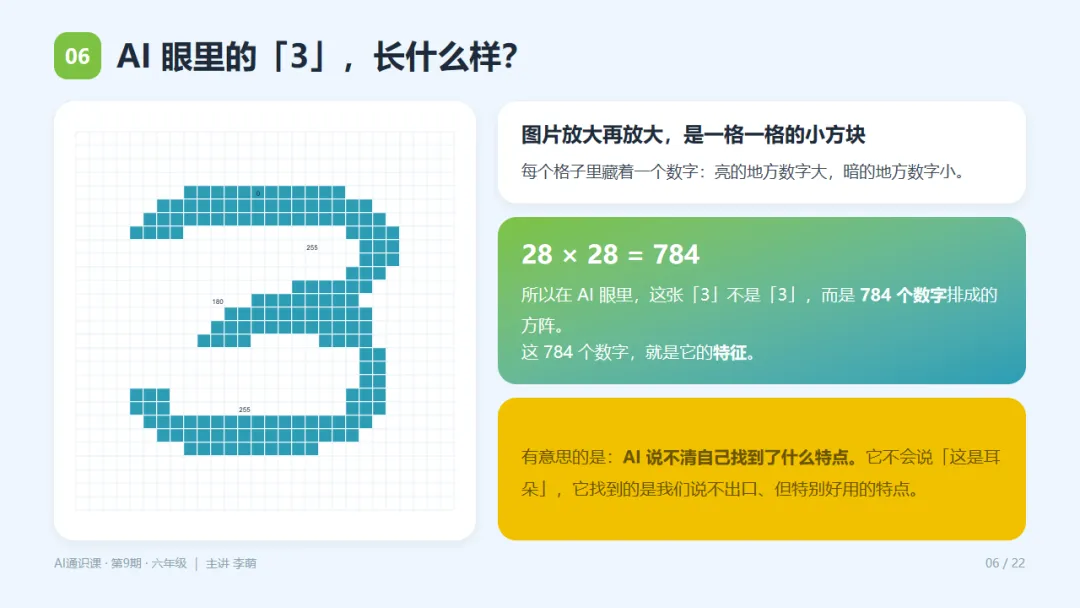
图:课件页
(2)它凭什么猜?——比「像不像」
重点来了。一张没见过的新图,它凭什么猜出这是 3?三步:第一步,新图来了,它不认识;第二步,它干了一件特别笨但特别管用的事——把新图跟课本里每一张老图都比一遍,算出“有多像”;第三步,找出最像的那一张,那张老图背后写的是 3,它就猜 3。这个办法有个名字,叫最近邻——“最近的邻居”。
“它根本不认识‘3’这个字,它只是找到了长得最像的那一页,然后照抄那一页的答案。”紧接着,两个问题被留在教室里,暂时不许回答:如果课本里只有 5 张,最像的那张能有多像?如果最像的那张,背后的答案被人写错了呢?
(3)数据、算法、模型:骑自行车的那个“说不清”
算法,是一套“看例子、比一比、归归类”的规矩。就这三步,但要重复成千上万次。“学过编程的同学你注意——这本质上就是一个循环,只是循环次数特别多。”
模型,是最难讲、也最重要的一个。李老师没有下定义,而是给了一个每个孩子都有的经验:
“你学骑自行车的时候,是不是摔过很多次?后来有一天,你突然就会了。现在我问你:你是怎么保持平衡的?你说得清吗?说不清。但你就是会。那个‘说不清但你就是会了’的东西,就是模型。”它是练出来的,看不见摸不着,装在 AI 的“脑子”里。你没法把它掏出来给别人看,但只要给它一张新图片,它立刻就能用上。
总结:数据是原料,算法是规矩,模型是练出来的结果。
(4)猜、对答案、改一点点:训练的真面目
AI 第一次看 3,也会猜错。可能猜成 8,可能猜成 5。
这就像学投篮:第一次投,砸框了,偏左。教练说“往右 1 厘米”,你挪 1 厘米,再投,还是偏,但比刚才近了。
AI 学东西也是三步:猜一个答案;对答案,有人告诉它“错了,这是 3”;改一点点,把“我差在哪儿”记下来。
“注意,是‘一丁点儿’。挪一次没用,它要挪成千上万次。所以‘训练’这个词,听起来很高科技,说白了就是——猜、对答案、改一点点,重复几万遍。”
这也解释了为什么 AI 要那么大的电脑、那么长的时间。“不是它聪明,是它练得多。跟你刷口算题一个道理:刷一百道和刷一万道,手感能一样吗?”
实践探索:三轮实验:5 张 → 20 张 → 故意改错 5 张
每组一叠印章卡,上面是两个外星部落——甲族和乙族。图案、边框、大小、角度都不一样,可真正的标准只有一处,卡片上一个字都不写,得自己从答案里找回来。四人分工:两个数据员,负责点屏幕、记分、掐时间;一个 AI,负责判断;一个裁判,负责对答案、喊停、监督规则。规则只有一条,特别重要:当 AI 的同学,只许按自己选的那条规律判断,中途不许改主意。
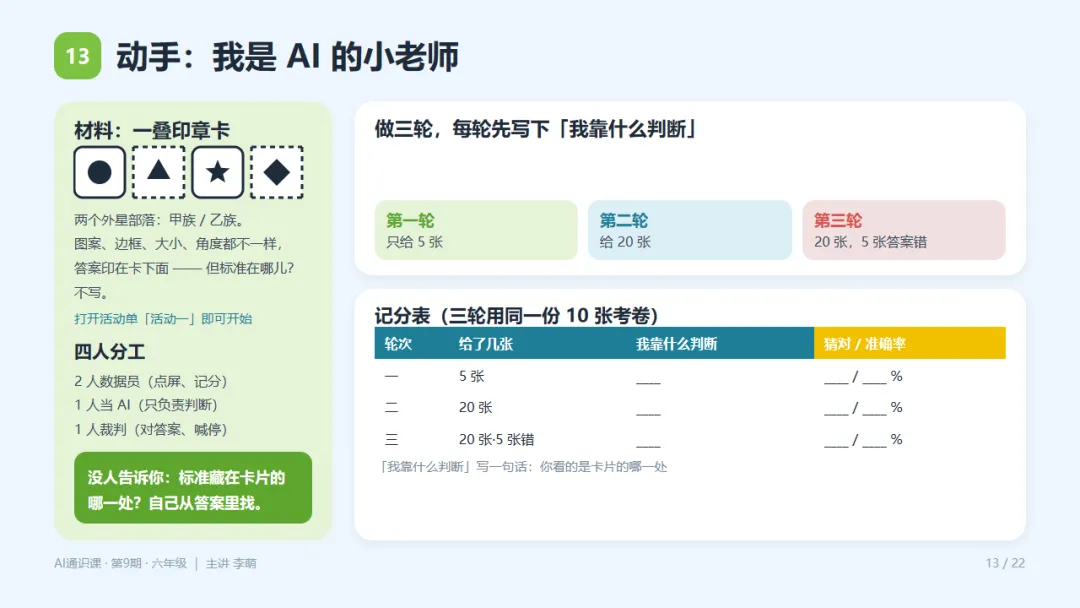
图:课件页
第一轮,只给 5 张。 各组报数,普遍在 40% 上下。为什么?因为 5 张太少,能解释它的说法不止一种——这 5 张里,三角的全是甲族、圆的全是乙族,可“看边框”也刚好对得上,两套说法都说得通。5 张凑出来的“规律”,很可能只是碰巧。
第二轮,给 20 张。 数字明显上去了,有的组还考了满分。同样一个人、同样的规则,为什么?因为这回四种图案都齐了,“圆”里既有甲族也有乙族,“三角”也是。按形状猜,猜不通了。假规律自己塌了,真正的标准才露出来:外框的线——虚线是甲族,实线是乙族。
第二轮,给 20 张。 数字明显上去了,有的组还考了满分。同样一个人、同样的规则,为什么?因为这回四种图案都齐了,“圆”里既有甲族也有乙族,“三角”也是。按形状猜,猜不通了。假规律自己塌了,真正的标准才露出来:外框的线——虚线是甲族,实线是乙族。
“这句话今天最值钱——不是例子多就行,还得例子对。你给它错的答案,它就认认真真把错的学进去,它不会怀疑你。”
数据三件事:多、杂、对
实验做完,概念才登场。数据好不好,看三件事。
第一,多。 只有 5 张的时候,碰巧就能凑出一条假规律;20 张,就不容易碰巧了。
第二,杂。 光多还不够。李老师举的例子很扎心:“给 AI 看 100 张同一个人写的 3,和给它看 20 个人各写 5 张,哪个更好?”后者更好——因为考试时遇到的是它没见过的人写的字。把一个人的字背得滚瓜烂熟,换个人它就傻了。
第三,对。 第三轮已经证明了。
那这三条哪个最重要?李老师给了一个明确的排序:对 > 杂 > 多。
“因为——数据一错,它学得比谁都认真。少,它学到的是‘碰巧’;错,它把假话当成真理记住了,而且它永远不会怀疑你。”
现场挑战:你来标注,AI 来学
讲完规矩,就上场干活。屏幕上是 10 张手写数字,都没有答案。
李老师先放大最潦草的那张:“你们觉得这是几?A 是 3,B 是 8,C 是 5。”
教室里意见不一致。有人说是 3,有人说是 8。“连我们人都意见不一致,你说 AI 难不难?”揭晓:是 3。
然后是一个很轻、却很关键的动作——点一下,把这张图标成 3。就这么一点,这张图就进了 AI 的课本。
“这个动作,正式名字叫数据标注。全世界有无数的人,每天的工作就是干这个——一张一张地看图、写答案。AI 有多聪明,很大程度上取决于这些人写得有多认真。”
随后是三个现场实验:只用这 10 张训练,准确率不太行,例子太少、字迹又都差不多;再补 150 张不同字迹的,准确率一下子上去了,因为多了、也杂了;故意把 60% 的标签标错,成绩立刻掉下来。
同样的数据量,只是答案错了,成绩就掉。“你们说,是多重要,还是对重要?——都对。但记住那句话:错的数据,比少的数据更可怕。”
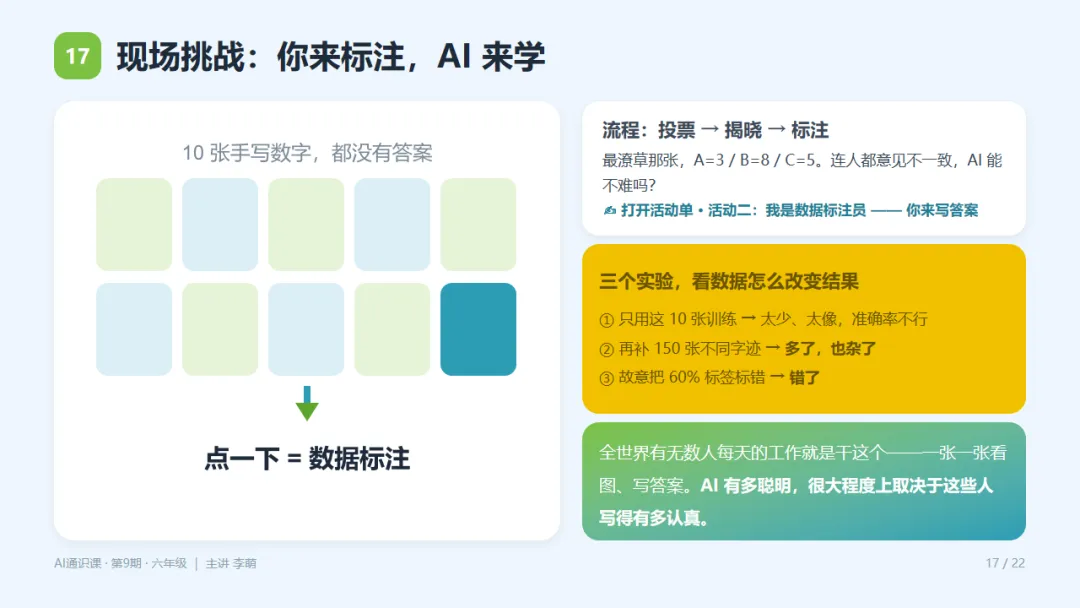
图:课件页
两种学习:只差一个「答案」
回过头看,活动一、活动二里,孩子们其实一直在干同一件事:给例子、写答案。这件事有个正式的名字,而且分两种给法。
有答案的学习,叫监督学习。 每张卡片背后都写着答案,AI 看完一张翻过来一对:“哦,这是 3。”学完最擅长一件事——分类。智能垃圾桶就是靠这个:几十万张图片,每一张都被人标好了“可回收”“有害”“厨余”。
没答案的学习,叫无监督学习。 卡片背后什么也没写,没人告诉它谁是谁。它能干的事很有意思:分堆,也叫聚类——把长得像的放一起。短视频为什么总推你爱看的?平台把几亿用户按“看什么、看多久”分成一堆一堆,你被分进了某一堆,那一堆人爱看的就推给你。
但这里有个关键:“AI 只会说‘这几张像’,它说不出‘这是什么’。它没有答案,只能看见‘像不像’,看不见‘是什么’。”
追问更狠:“平台给你分完堆,它知道你叫什么名字吗?——它不需要知道。它只要知道‘你跟谁像’。”
课堂随即打开活动单“活动三”:一堆背后什么都没有的卡片,只能按“长得像”分成 3 堆。分完点“揭晓答案”,再点“让 AI 也分一次堆”,看它怎么分——孩子刚才干的事,正式名字就叫聚类。
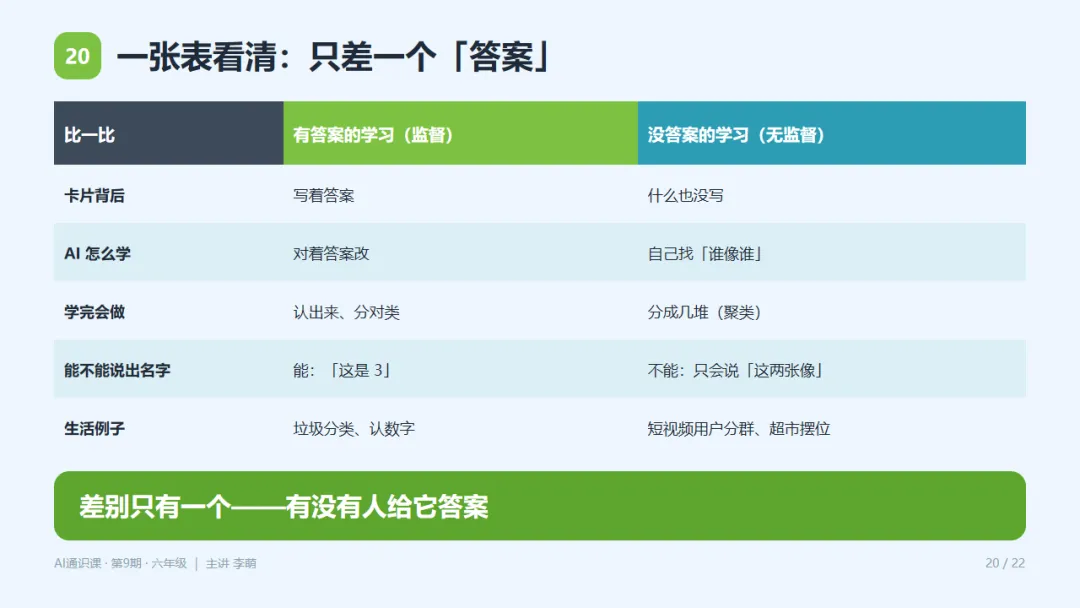
图:课件页
AI 学歪了,算谁的?
课快结束,李老师回来“算账”了——那些答案,是谁写的?
一个真实场景:假设要做一个“认医生”的 AI,收集了十万张医生的照片来训练,结果这十万张里,九成是男性。训练完了,给它一张女医生的照片,它猜:这不是医生。
第一,AI 错了吗?——它没觉得有问题。它不会怀疑,只会照着学。数据里九成是男性,它就学到了“医生长这样”。
第二,那是谁的错?数据里本来就藏着偏见。这个东西有个名字,叫数据偏差。照片是谁拍的?标签是谁写的?他们的想法,会进 AI 的“脑子”。
第三,我们能做什么?换一批更全面的数据;标注的时候,多想一步。
“标注的时候多想一步”是什么意思?活动单“活动四”给了答案:这一叠卡片已经被人标好了答案,但里面混进了几张标错的,任务是当“数据医生”,把“病人”找出来。找完点“对答案”,再看“修好前 vs 修好后”两次准确率——同一批数据,只是把标错的改回来,AI 的成绩立刻就上去了。
“所以‘多想一步’,就是你刚才干的事:当那个把关的人。”
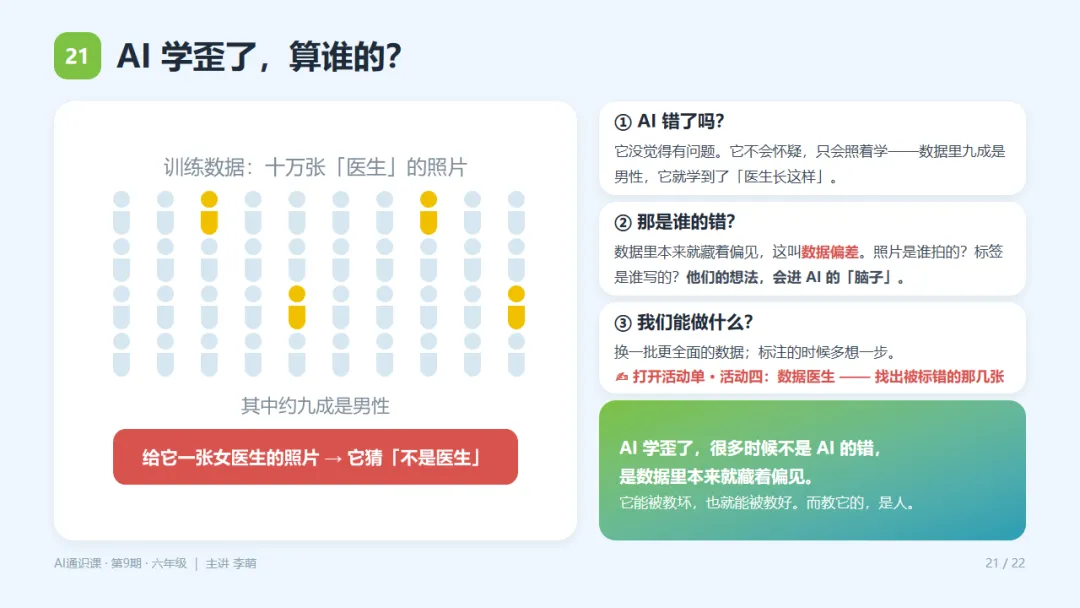
图:课件页
总结提升:给例子——找特征——练模型——考一考。
给例子就是数据,找特征就是特征,练模型就是模型,考一考就是推理。这四个词,以后看到任何一个 AI 都能套一遍——你家的智能音箱:它听了多少人的说话?它怎么分辨“放歌”和“关灯”?它认错过吗?准确率多少?
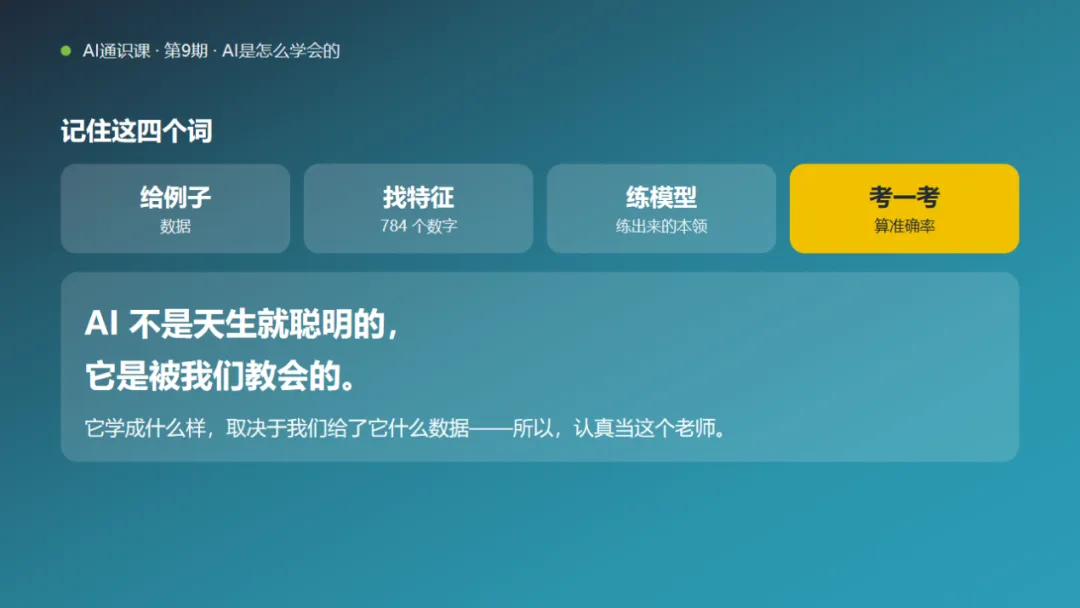
图:课件页
“AI 不是天生就聪明的,它是被我们教会的。它学成什么样,取决于我们给了它什么数据。所以,认真当这个老师。”
课后拓展找一个 AI 可能学错的例子,说出它可能看了什么样的数据;或者给家里的智能音箱出 5 道题,记录它答错几道、算出准确率;或者画一张“AI 学习四步”的四格漫画。
这堂课的几个设计亮点
① 身份置换——学生不是 AI 的使用者,是 AI 的小老师,责任与动机一起到位。
② 一条“公平”暗线——从“怎么比才公平”到“只改一个条件”,控制变量贯穿三轮实验,科学思维与技术认知同时长。
③ 数学真刀真枪——28×28=784、准确率、百分点,六年级的数学在这里第一次有了真实用途。
④ 概念全部后置——先体验、再命名,五个术语没有一个是被“讲”会的,都是被“做”会的。
④ 概念全部后置——先体验、再命名,五个术语没有一个是被“讲”会的,都是被“做”会的。
AI 不是魔法,是被教出来的
一节课下来,孩子们未必能说清“最近邻”“聚类”的技术细节,但他们一定记住了一件事:AI 的本领不是天生的,是看例子学来的;例子要多、要杂、更要对;答案是人写的,人写错了,AI 就学歪了。
而这,恰恰是 AI 通识教育最想留给孩子的态度——不神化,也不轻视;知道它从哪儿来,才知道该怎么用它、怎么教它。
那颗关于数字素养的种子,终有一天会生根发芽。
课程信息
主题:《AI 是怎么学会的?》
主讲:李萌(丁玉海名师工作室编程创客项目组)
时间:2026 年 11 月 6 日 20:00—21:00
形式:线上直播
对象:高段小学生
系列定位:AI 通识教育第九期
直播平台:CCTALK
直播回看链接
https://www.cctalk.com/v/17939654532493?xh_preshareid=0cbabf4c-602a-4d62-a826-bf30cca67125&xh_fshareuid=82731625&sid=1635467596840316&xh_preshareuid=82731625END
END
供稿:李 萌
编辑:张 波
监制:丁玉海