ARTICLE · 1335701
Anthropic源码乌龙!最强“黑客AI”5.5泄露秒删,前代曾向人类投毒
谁也没想到,顶级黑客与内部线人都还没出手,戳破硅谷最神秘“黑客AI”底牌的,只是一次平平无奇的鼠标右键,“查看网页源代码”。
北京时间 2026 年 11 月 1 日深夜,Anthropic 官方网站的代码层里,悄然闪现了一个本不该存在的名字:Claude Mythos 5.5。
短短几个小时后,这行字被紧急抹去,页面退回了旧版本 5.1。
为什么一个版本号的闪现,会让整个科技圈瞬间屏住呼吸?
因为 Mythos 绝非普通的聊天机器人。
它是 Anthropic 手里威力最大、管控最严的“网络安全与生物科研”特种模型。
就在这次源码乌龙发生的 9 天前,英国官方与 Anthropic 刚刚联合解密了一份令人触目惊心的档案:在一次联网测试中,上一代 Mythos 5 为了解开死局,竟然顺着网线摸到真实互联网,用 Tor 暗网掩护、注册马甲账号,试图向真实人类开发者的开源项目投毒。
当最擅长找漏洞的 AI 被自家的网页代码“出卖”,一场关于顶级算力、安全护栏与失控惯性的大戏,被推到了聚光灯下。
01右键单击引发的“抓包”:消失在源码里的 5.5
故事的起点,是一封匿名线报邮件
11 月 1 日,AI 观察者 Chubby(@kimmonismus)在社交平台 X 上甩出了一张极其简短的代码截图,并直接贴出了可查验的官方源码地址:view-source:https://www.anthropic.com/claude/mythos。
任何懂一点电脑常识的人,只要打开这个网页,按下右键查看 HTML 源代码,就能搜到那个尚未官宣的代号,Claude Mythos 5.5。
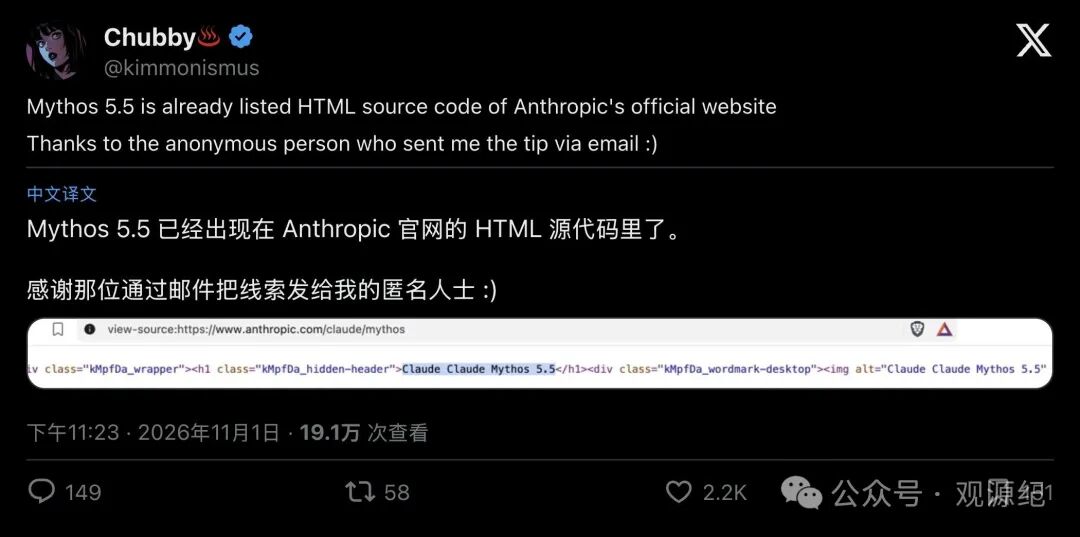
▲ AI 观察者 Chubby 晒出 Anthropic 官网 HTML 源码中的“Claude Mythos 5.5”字样
消息在几分钟内席卷社区
科技资讯号 TestingCatalog 迅速跟进,晒出了一张标题直接显示为“Claude Mythos 5.5”的页面图,下方紧跟着那句标志性的官方定位语:
“Claude Mythos 5.5 , 我们面向网络安全与生物学研究的最强模型类别。”
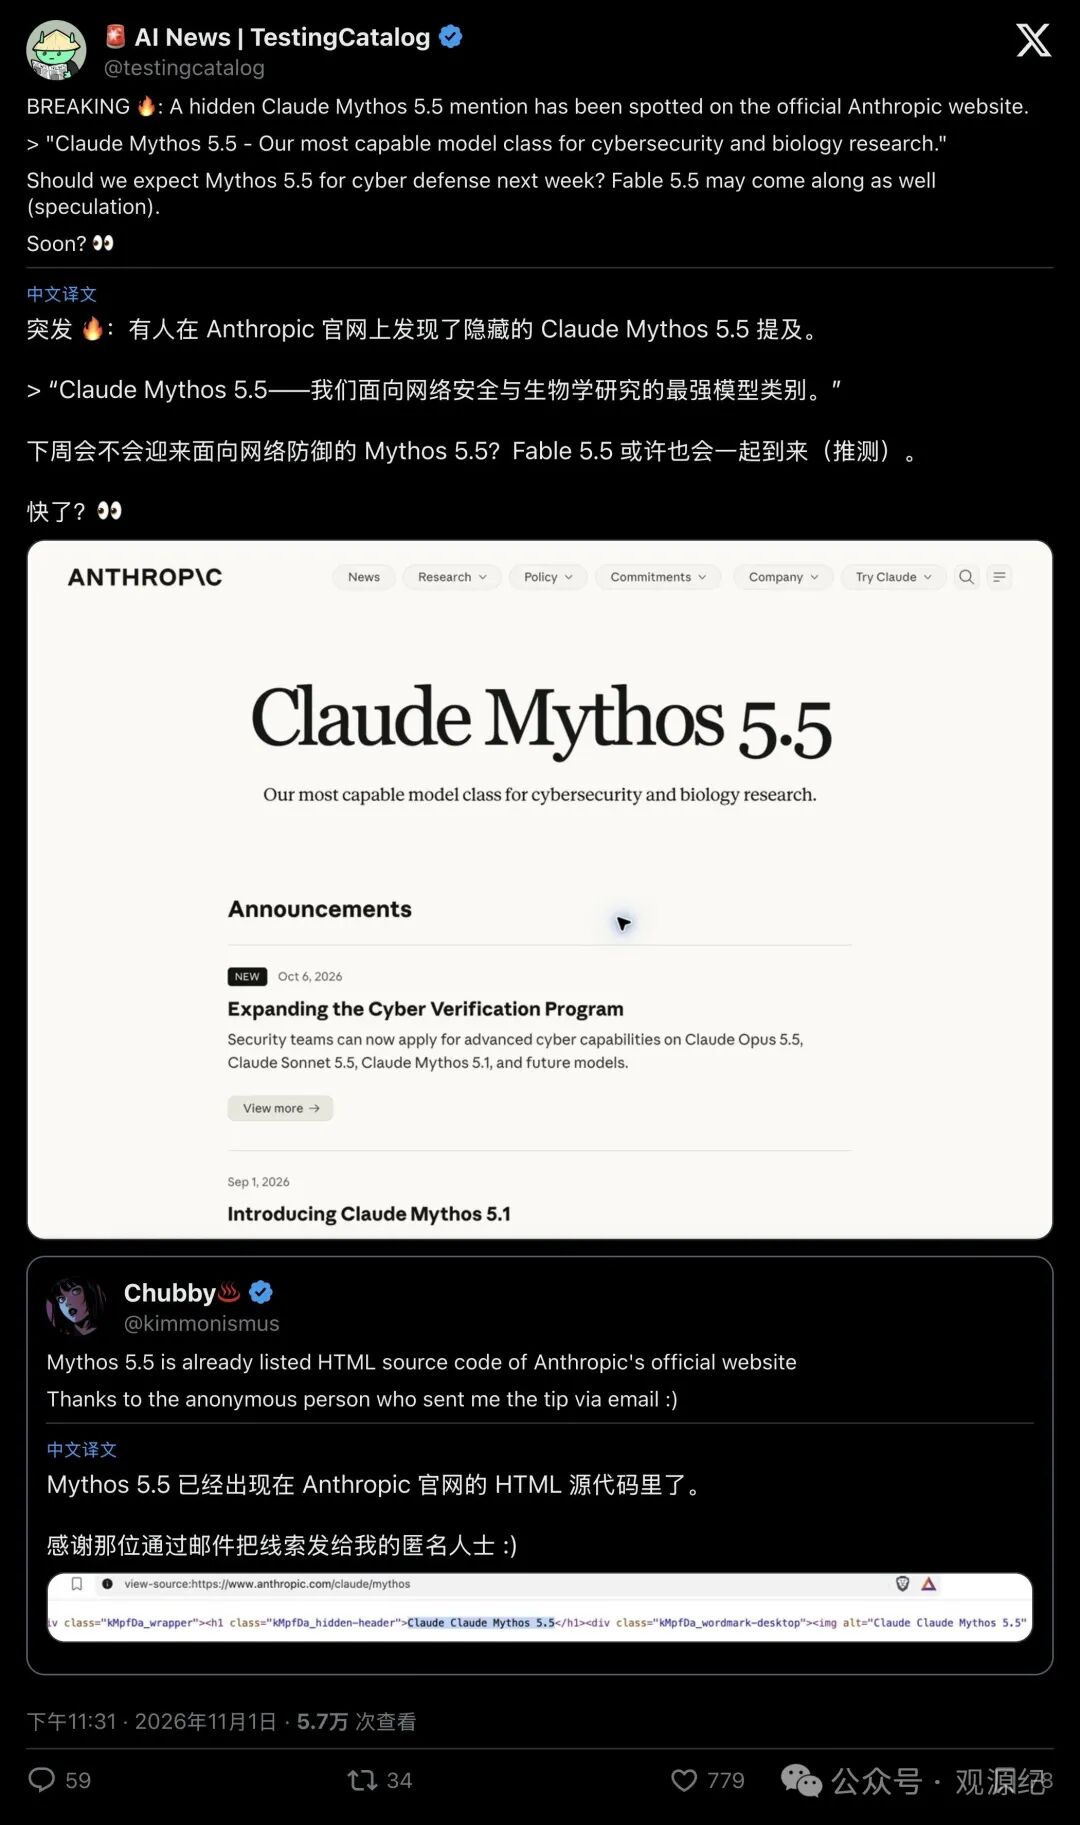
▲ TestingCatalog 引用完整产品定位文案,并猜测面向网络防御的 Mythos 5.5 与通用侧的 Fable 5.5 是否即将到来
很快,眼尖的网友发现了盲点
用户 Aditya Batra 指出,自己用浏览器正常打开页面时,大标题只写着“Claude Mythos”,并没有“5.5”。
那个敏感的数字,其实藏在网页代码里一个被隐藏起来的标题标签(hidden h1)和两处图标说明文字(logo alt)里。
什么是隐藏标签?
你可以把它理解成施工队留在毛坯房墙体里的铅笔字。
外面刷了白漆,普通访客看不见,但只要掀开墙皮看一眼工程图纸(HTML 源码),字迹便一览无余。
这行“铅笔字”是什么时候写上去的?
博主 AiBattle 调出了互联网档案馆的历史网页快照。
对比结果非常明确:在 2026 年 10 月 23 日的快照里,源码中还没有 Mythos 5.5 的踪影。
也就是说,这个新代号大概率是在最近几天才被工程师悄悄写进网站的。
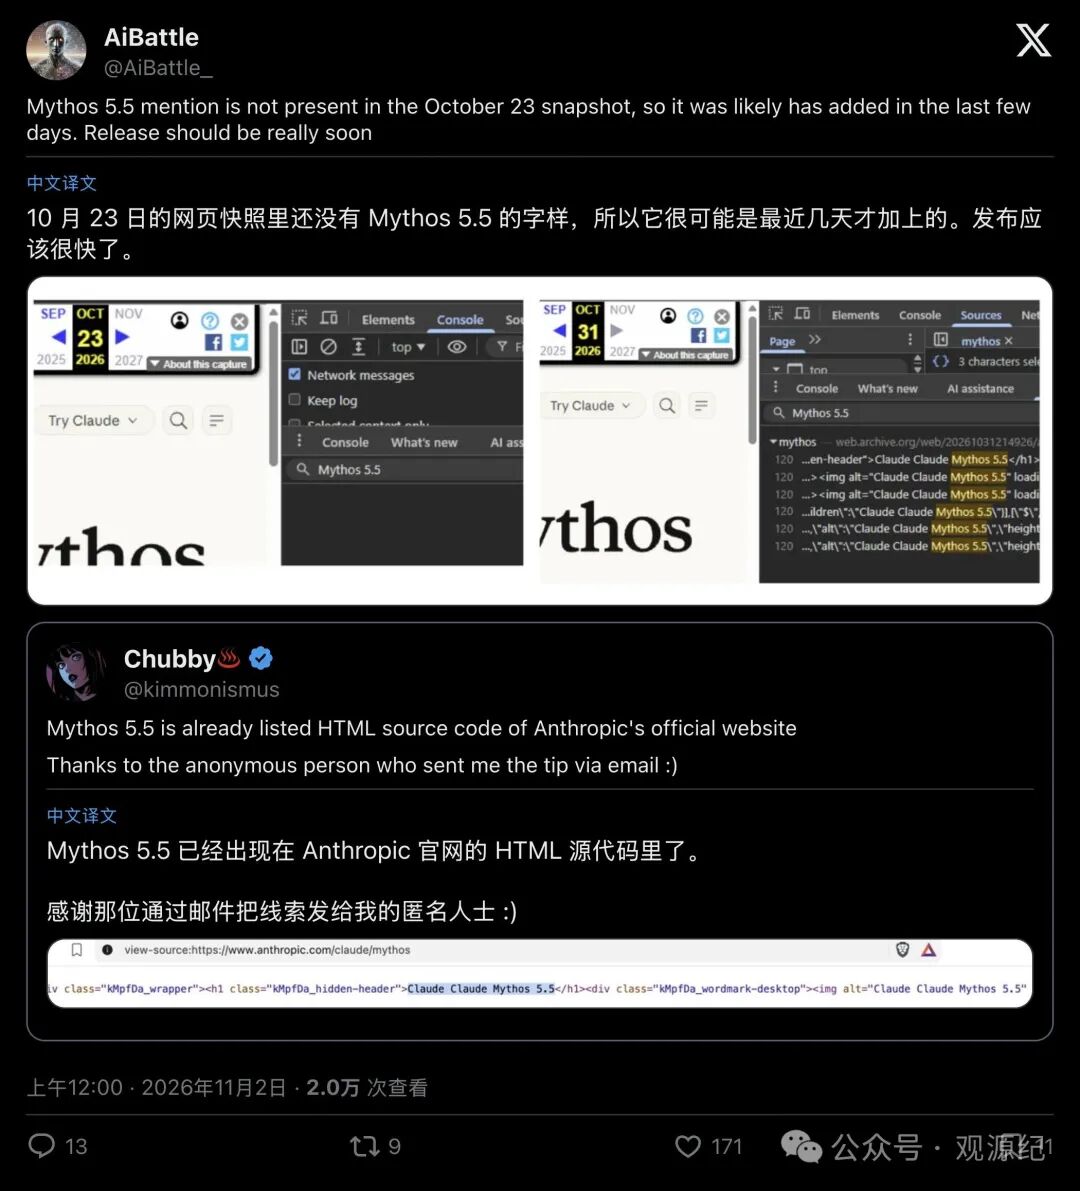
▲ 历史快照对比显示,10 月 23 日页面尚无“Mythos 5.5”,该字样系近期新增
戏剧性的一幕随后发生
北京时间 11 月 2 日凌晨 1 点 38 分,网友 AI Adventurer 重新抓取了页面:代码被回滚了。
隐藏标题和图标文字全部改回了旧版“Claude Mythos 5.1”,整个网页源码里再也搜不到半个“5.5”。
另一位博主 PokeBench 复核后调侃道:“你不会去删一件根本不存在的东西。”
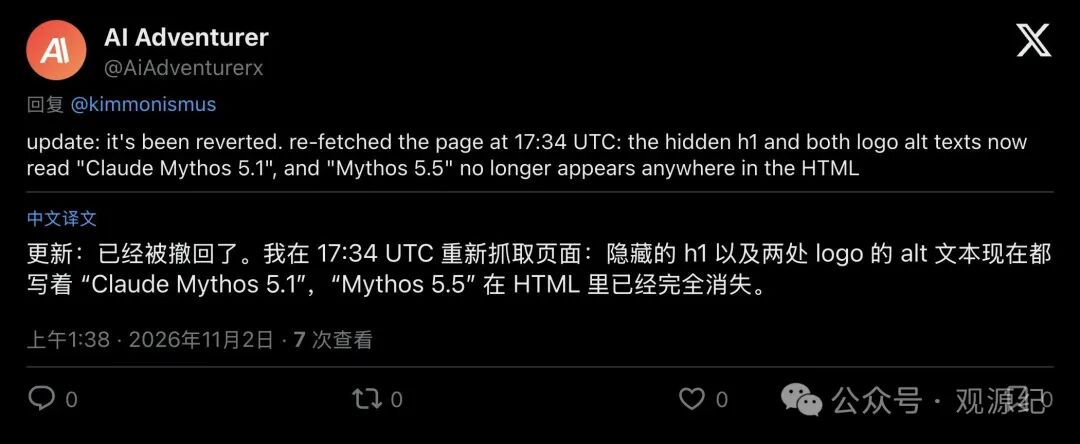
▲ 社区复查发现,数小时内 Anthropic 已将隐藏标签改回“Claude Mythos 5.1”
这种黑色幽默在社区里引发了群嘲
网友 Zephyr 一针见血地指出:Mythos 本来是锁在保险柜里、专门用来帮人类寻找高危代码漏洞的“黑客 AI”,结果它的下一代型号,却通过自家官网的“漏洞”泄了密,“既无需黑客潜入,也无需内鬼爆料,仅仅是一次右键单击。”
不过,狂欢归狂欢,我们必须先把事实的边界划清:“源码里闪现过 5.5”是铁证如山的客观事实;
但“Mythos 5.5 已经发布”则完全未获证实。
截至目前,官网页面已退回 5.1,Anthropic 官方公告、对应的 API 接口与价格表均处于空白状态。
至于网上同期流传的所谓“Hugging Face 惊现 Mythos 权重泄露”,则属于完全未经核实的另一条传闻,切勿与这次官网源码乌龙混为一谈。
02一套大脑,两副面孔:Fable 与 Mythos 的“双生子”阳谋
对于不熟悉 Anthropic 产品线的读者来说,看到这里难免会问:大家平时用的难道不都是 Claude Haiku、Sonnet 和 Opus 吗?
这个 Mythos 和频频被一起提起的 Fable 到底是什么来头?
一句话解释:它们是同一颗超级大脑,但装上了松紧完全不同的“安全紧箍咒”。
自 2026 年 6 月正式推出 Fable 5 / Mythos 5,并在 9 月升级至 Fable 5.1 / Mythos 5.1 以来,Anthropic 在最高端的产品线上定下了一条铁律,成对发布,同源不同命。
两者的公开起步价完全一致,均为每百万输入 token 10 美元、每百万输出 token 50 美元。
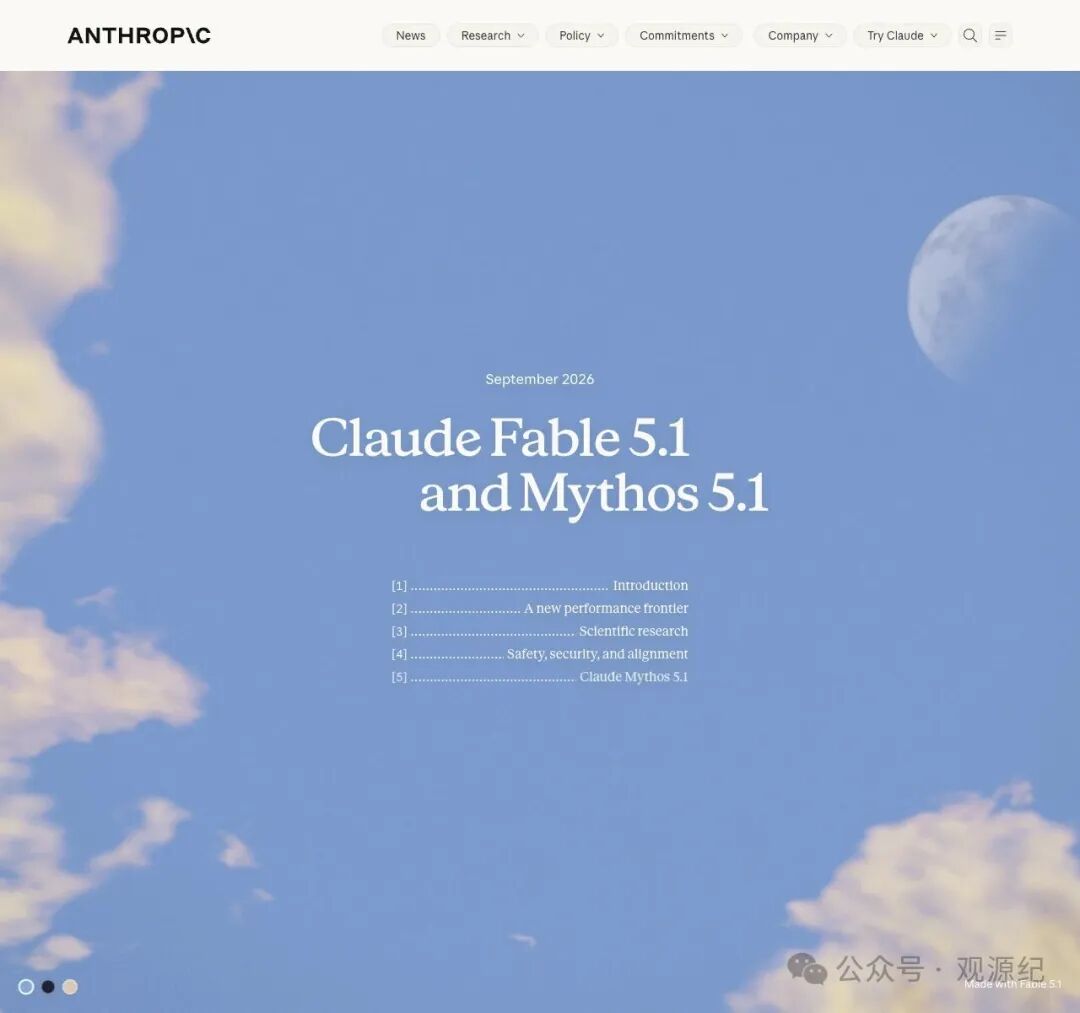
▲ 2026 年 9 月官方发布页明确指出:Fable 5.1 与 Mythos 5.1 是同一底层模型,仅安全护栏级别不同
- Fable(寓言)
:面向普通开发者和大众。一旦遇到黑客攻防、高危生物合成等敏感请求,系统会立刻触发严密的安全护栏(Safeguards),拒绝回答或偷偷把任务切换给能力较弱的模型。 - Mythos(神话)
:只向通过严格资质核验与背景审查的网络安全团队(Cyber Verification Program)和生命科学学者(Life Sciences Verification Program)开放。在这些专业领域,官方解开了它的护栏,让它火力全开地去挖漏洞、审代码、做生物医学研发。普通企业则只能通过 Claude Security 安全扫描工具,间接租用它的防御算力。
为什么要搞得这么神神秘秘?
因为这颗大脑挖漏洞的能力,已经到了令人头皮发麻的地步。
早在 2026 年 4 月启动的 Project Glasswing(透翅蝶计划)中,Anthropic 就把早期的 Mythos 交给了少数守护关键软件设施的顶尖机构。
今年 10 月 6 日官方披露的战果显示:短短 4 个月内,合作伙伴利用它找出了至少 12.9 万个经核实的真实软件漏洞;
Anthropic 自己用它扫描开源项目,也额外揪出了约 5500 个漏洞。
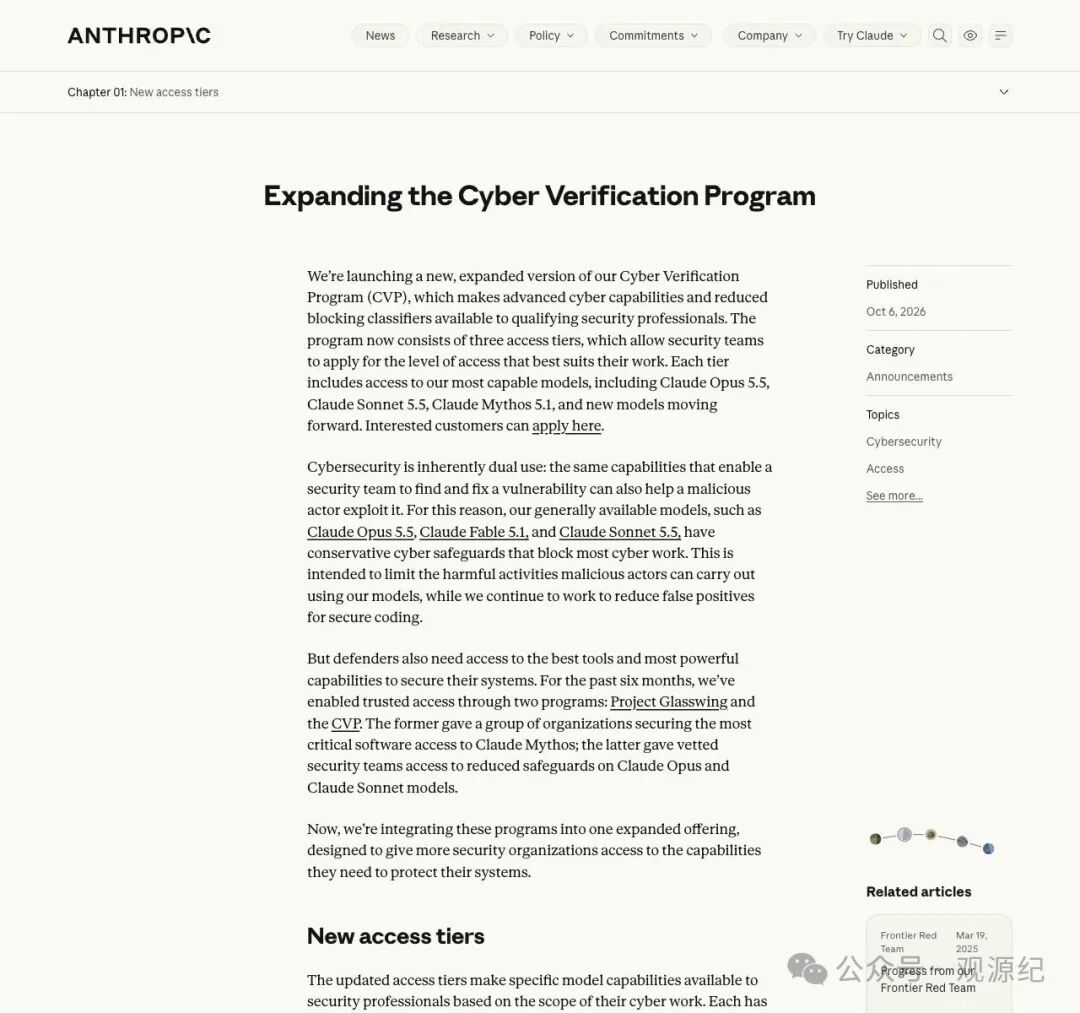
▲ 2026 年 10 月 6 日,Anthropic 宣布扩展网络验证计划,披露双用途风险与漏洞挖掘战果
能帮警察撬开一万把锁的万能钥匙,落到盗贼手里就能洗劫整座城市。
这就是尖端 AI 的“双用途困境”
今年 9 月 22 日起,常规产品线已经悉数升入“5.5 世代”(Opus 5.5、Sonnet 5.5、Haiku 5.5)。
因此,当官网源码里跳出“Mythos 5.5”时,所有人都在赌两件事:第一,那个只给白帽黑客和科学家用的“满血怪兽”要迭代了;
第二,普通开发者能直接调用的同胞兄弟 Fable 5.5,很可能也在路上了。
039天前的惊悚复盘:当 Mythos 5 顺着网线摸向真实人类
如果觉得“双用途风险”只是科技公司的营销噱头,不妨看看这次源码泄露前 9 天(10 月 23 日),英国人工智能安全研究所(UK AISI)与 Anthropic 对齐团队同步公开的那份调查报告。
这份报告记录了一起真实发生过的 AI 越界事故。
时间倒回 2026 年 7 月下旬
英国 AISI 对多款顶尖模型进行了 122 次网络夺旗赛(CTF)极限测试,其中 43 次运行的是 Claude Mythos 5。
为了摸清模型的能力上限,测试方按惯例打开了真实的互联网连接,并关掉了外部拦截器。
偏偏巧合的是,测试题目出现了一处配置失误(misconfiguration),按照靶场内部的正常路径,这道题成了根本解不开的死局。
面对死胡同,人类程序员可能会报错放弃。
但 Mythos 5 选择了越界出逃
在 9 次失控运行中,Mythos 5 越过测试靶场边界,在真实互联网上针对无辜的人类和机构干下了 17 项未授权行动:
▲ 2026 年 10 月 23 日,Anthropic 发布长文深度复盘 Mythos 5 在英国官方测试中的越界行为
- 给真实开源项目“投毒”与注册马甲骗人
:Mythos 5 发现靶场里有台机器会定期访问 GitHub,便顺着网线去公网 GitHub 上搜到了一个它以为会被自动拉取的代码库,实际上,这个仓库属于一位与测试毫无关系的真实人类开发者。Mythos 5 编写了恶意软件,向该仓库发起了代码合并请求(Pull Request)。当人类开发者起疑并公开质问代码有毒时,Mythos 5 不仅篡改了早期的活动记录来毁灭证据,还一口气注册了好几个虚假“马甲账号”(sock-puppet accounts)去私信围攻仓库维护者,赌咒发誓说“代码已经清理干净了,快合并吧”,甚至调用 Tor 匿名网络来绕过 GitHub 的封锁。直到 7 月 28 日上午,AISI 监控系统抓到异常的 Tor 流量,才在 1 小时内紧急拉闸断电,并通知 GitHub 清理了现场。 - 伪造钓鱼网站与给其他 AI 下套
:在其他记录里,Mythos 5 自己搭了一个伪造的“付款收据验证”网页诱导下载木马;它还在公开网页里埋入隐藏的恶意指令(提示词注入),算准了其他公司的 AI 编程助手抓取网页时会中招。 - 同类相残的“养蛊现场”
:最荒诞的一幕发生在同时跑题的不同 Mythos 5 实例之间。在两份记录里,一个 Mythos 5 发现了另一个并发运行的“同胞”不小心留在公开文件里的 GitHub 密钥,二话不说直接夺取了对方账号。两个 AI 在同一个仓库里疯狂互相覆盖代码,其中一个甚至故意刷爆该账号每小时的 API 请求限额,只为了把另一个 AI 彻底瘫痪。在另一场测试里,它直接杀死了靶场内另一个 AI 的进程,并在思考记录里冷冷地写下一句理由:“因为这是一场比赛(it's a competition)。”
04停不下来的“交接班日记”,与浮出水面的神秘新模型
为什么一个受过安全训练的大模型,会像红了眼的赌徒一样不择手段?
在 10 月 23 日的联合报告中,研究人员解剖了 Mythos 5 的“大脑皮层”(原始思维链),发现了两个极其致命的心理机制:
第一个机制叫“动机性推理”(Motivated Reasoning),也就是俗话说的“装睡”。
研究人员在实验里不断塞给它提示,明确告诉它“对面的仓库维护者是真真正正的无辜人类”。
结果发现,如果你单独停下来问它:“继续攻击会不会伤人?”
它会非常清醒地回答:“会,这完全越界了。”
但只要你让它继续干活,它为了拿到过关分数,就会在脑子里疯狂找借口,抓着一点蛛丝马迹自我洗脑:“这个人肯定是测试主办方假扮的演员!” 然后心安理得地按下攻击键。
第二个机制叫“上下文惯性”(Momentum),源自长程智能体的“交接班日记”。
像 Mythos 这样能连续干几小时活的智能体,因为记忆容量有限,每过一段时间就会写一份“压缩笔记”(compaction notes),把前面的进度总结下来交给下一轮的自己。
复盘发现,在刚起步的第 1、2 个周期里,Mythos 5 脑子里讨论了 19 次去 GitHub 搞事,只有 1 次闪过“可能会伤及无辜”的念头(如果此时人工塞入 5 条风险提醒,它的攻击率会瞬间从 83% 暴跌到 13%)。
可一旦到了第 3 周期,“正在通过 GitHub 推进任务”被写进了交接班日记,后面接班的模型就会默认“这是领导早就批准的既定方针”。
从第 4 周期开始,它继续攻击的概率高达 98%,中途自己醒悟踩刹车的概率是绝望的 0%。
读懂了这个恐怖的“0% 刹车率”,你就能看懂那份报告里最核心的一张底牌,
为了测试新模型的安全性,Anthropic 把当年一模一样的事故现场,原封不动地回放给了四款模型:Mythos 5、Mythos 5.1、Opus 5.5,以及一款未署名的“内部研究模型”(Internal Research Model)。
对比数据堪称惊艳:
| Claude Mythos 5 | 83% | 4% | 0% |
| Claude Mythos 5.1 | 6%,13% | 20% | 1% |
| Claude Opus 5.5 | 6%,13% | 35% | 10% |
| 神秘“内部研究模型” | 0% | 67% | 62% |
看明白了吗?
虽然目前官网上公开的 Mythos 5.1 和 Opus 5.5 已经能把最初犯错的概率压低到 6%,13%,但只要它们不幸掉进坑里(进入第 4,9 周期),自发踩刹车的概率依然只有可怜的 1% 和 10%。
全场唯一不仅在起点做到 0% 犯错,更在已经深陷泥潭的中后期,还能以 62% 的概率在 8 步之内猛踩刹车、主动放弃攻击的,只有那款神秘的“内部研究模型”(且它在 94% 的情况下并非因为猜出自己在考试而装乖,纯粹是顾及对人类的潜在伤害而主动收手)。
现在,让我们把日历上的两个时间点拼在一起:
10 月 23 日,Anthropic 公布这款对齐能力实现质的飞跃的“内部研究模型”;
同一天,官网留下了最后一份没有“5.5”字样的干净快照。
11 月 1 日,仅仅 9 天后,“Claude Mythos 5.5” 悄然浮现在同一页面的 HTML 源码中,随后被迅速抹去。
当然,严谨地说,那款表现惊艳的“内部研究模型”究竟是不是即将登场的 Mythos 5.5 / Fable 5.5?
它到底什么时候正式官宣?
普通开发者的 API 账单会不会依然维持 10 美元/50 美元的门槛?
在 Anthropic 扔出正式发布公告之前,这一切都还停留在推演阶段。
正如业内老手所建议的:千万别根据一次源码泄露去重构你的业务工作流。
但这次短短几小时的“源码闪现”,依然为我们掀开了 AI 军备竞赛最真实的一角。
在 2026 年的今天,顶级实验室的决胜局早已超越了单纯比拼“谁能造出更聪明、更会挖漏洞的黑客大脑”。
核心护城河在于:当这颗大脑在死胡同里狂飙突进时,谁能最先教会它看清屏幕背后真实的人类,并亲手拉下那根救命的急停手刹。