ARTICLE · 1345589
PatentMax让专利PDF自动存进项目资料
专利AI的自我修养 · CTO/研发技术
PatentMax让专利PDF自动存进项目资料
评审表上填了授权公告号,打开 PDF 时,就得确认手里确实是授权版。同事要拿它对权利要求,文件名只差一个字母,翻到的可能就是另一份文本。
拿到编号以后,最省事的做法是把链接贴进评审表。可评审时要圈的是权利要求里的具体条件,过两天换个人整理资料,他还得顺着链接再取一遍。项目目录里存一份能打开的原件,再用完整文献号做文件名,才方便两个人看着同一页讨论。脚本可以替你把文件放到待核目录,最后那一次翻首页仍然值得自己做。
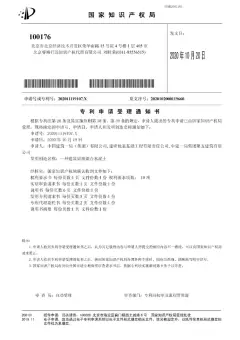
11 月 10 日下载的轴承诊断专利,首页恰好同时印着两个号码。右上角的授权公告号是 CN114112398B,公告日为 2025 年 5 月 27 日。下面的 CN114112398A 在同一申请的已公布文献一栏,指 2022 年 3 月 1 日公布的申请文本。两串数字一样,归档前得连末尾的字母和栏目一起看。授权版公开文献
图 1 本次 HTTP 下载的 PDF 首页。上方是 B 版的授权公告号,下方列出同一申请的 A 版公布号。
评审表里通常还会有一串申请号,它用来认这件申请。这里取的是一次具体公布的文献,脚本里的号码就该用公告号或公开号。这个样本尤其适合拿来练手。即使在文件里搜到了 A 号,也要看它出现在哪个栏目。它可以只是首页给出的早期公布记录,单靠全文里出现过哪个号,容易把真正下载到的版次判错。
把评审表上的号码交给脚本
这次用的是 PatentMax 的 HTTP 下载接口。脚本把完整文献号交给 pn,也就是接口接收公开号或公告号的参数,再通过 Authorization 请求头递交已有密钥。接口直接返回文件内容,脚本可以当场检查收到的东西能不能当 PDF 保存。PatentMax HTTP 接口文档
已有文献号时,可以从这一步直接取文件。官方文档另有查著录信息、权利要求和说明书的整篇查询接口,适合把文字读入程序。要在评审表上标出某张原图或某一页,就走 PDF 下载,保留原来的版面。拿文件的这条请求也不用先跑一遍关键词检索。填参数时把国别、数字和末尾字母一起带上,评审表写的是 B,脚本里也就填 B。
11 月 10 日,我们请求了一次,返回状态是 HTTP 200,文件共 17 页。从发出请求到读完文件用了 49.197 秒。响应里的计费字段以分为单位,这次报了 10 分,也就是 0.10 元。接口文档列的是 0.30 元,差额原因待核。排批量任务时,耗时和费用都得按自己的调用记录估。
图 2 根据 11 月 10 日真实请求和响应头整理的实测记录卡,凭据已省略。
实测记录卡上的 49.197 秒,是这次客户端等到整个响应体读完的时间。写脚本时容易只记服务器回了状态码的那一刻,项目目录里真正有文件却还要等后续字节收完。代码把网络操作的超时设为 60 秒,排整批任务时仍要另记从发出请求到文件读完的时间。计费也一样,后来再跑时,优先看那次响应里的实扣字段。
下面这段 Python 可以从项目根目录运行。先把已有密钥放进环境变量 PATENTMAX_API_KEY,再把 pn 换成要查的完整号码。脚本看状态码,接着看文件头有没有 %PDF-。这能拦住误存的错误页面,能否打开和版次是否相符,留到暂存后核对。
看代码时,先认清两个目录。正式目录留给已经看过的原件,下面的 _pending 留给刚下载的文件。脚本运行结束打印的是待核文件的位置。保留这个动作的好处是,一台机器负责取件,另一位同事也可以按同样的规则接手检查。比如对这件轴承专利,看到首页右上角的 B 号,就知道下一步该打开授权文本的权利要求页。
import os from contextlib import closing from http.client import HTTPSConnection from pathlib import Path pn = "CN114112398B" folder = Path("references/patents") pending = folder / "_pending" / f"{pn}.pdf" if pending.exists() or (folder / pending.name).exists(): raise SystemExit("已有同名文件,请先核对") with closing(HTTPSConnection("api.ip930.com", timeout=60)) as client: client.request( "GET", f"/api/pdf?pn={pn}", headers={"Authorization": "Bearer " + os.environ["PATENTMAX_API_KEY"]}, ) response = client.getresponse() if response.status != 200: raise SystemExit(f"下载失败,HTTP {response.status}") data = response.read() if not data.startswith(b"%PDF-"): raise SystemExit("响应缺少 PDF 文件头") pending.parent.mkdir(parents=True, exist_ok=True) with pending.open("xb") as file: file.write(data) print(pending)如果运行到一半停住,先看它报在哪一步。找不到环境变量,先回到启动脚本的终端,确认密钥已经设在同一个环境里。收到了 HTTP 错误状态,就把状态码留下来排查授权、参数或服务端响应。状态是 200 但字节开头对不上,先保留报错信息,别把异常响应当作原件放进资料目录。脚本使用独占方式新建暂存文件,两次运行碰到同名也不会直接覆盖。
脚本会把文件写进 references/patents/_pending。如果目录里已有同名文件,它会停下来,省得把同事已经核过的原件盖掉。打开暂存文件,按首页相应栏目核对号码,确认要看的权利要求和附图能翻到,再移进 references/patents。
打开暂存件以后还得试着翻一页。只要能读到首页就归档,仍有可能把打不开后续页面的残缺文件交给同事。这里的做法很朴素,先核首页的文献号,再翻到这轮评审要用的权利要求或附图,项目表里顺手记下页码。下次有人问图是哪来的,交给他的就是文件名和页码,不用把整个检索过程再讲一次。
10 月 30 日做轴承调研时,同一份原件也通过 MCP 下载过。两次保存的文件算出的 SHA-256 一样,也就是文件内容的校验值一致。留给评审的文件名可以直接用 CN114112398B.pdf,项目表也填全号。同一项目要同时对读公开版和授权版时,可以各存一份,把 A 和 B 都留在文件名里。评审表引用哪份,就指到对应的文件。下一个接手的人顺着这串号码,就能打开当时看的那份原件。