ARTICLE · 1350987
一个Hermes把 X 书签变成可读清单的插件
每个人的 X 书签里都有几百条"以后再看",而"以后"从来没有来过。
问题不在于你不自律,在于收藏这个动作的成本太低了——点一下只要 0.2 秒,而读完一条长文要 8 分钟。于是书架越来越满,可读的东西反而越来越找不到。
winchxyz/hermes-x-bookmarks 想把这条断掉的链路接上:把书签全部读回来,用你自己的模型分类,再导到一个你真的会打开的地方。MIT 协议,Python 写的,2026 年 11 月 8 日建仓——到今天刚满四天。
它做四件事
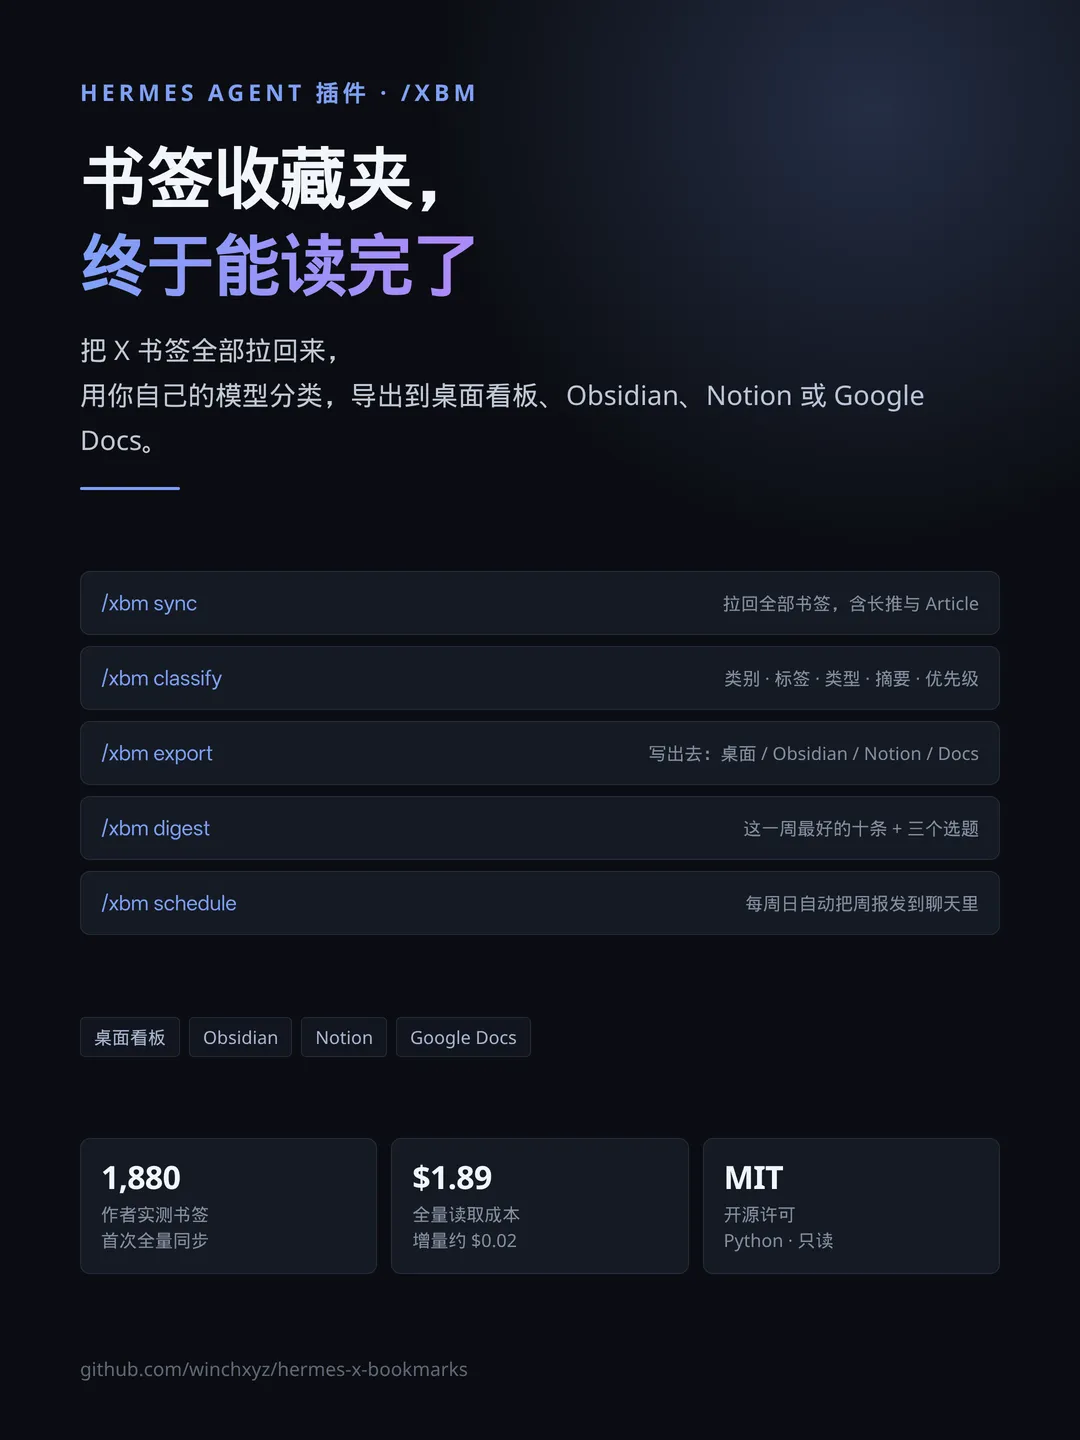
用官方 README 的话说:读你所有的 X 书签(包括长推、thread 和 X Article),用你自己的 Hermes 模型排序,然后导出到 Notion、Google Docs 或者桌面文档。
落到操作上就是五条命令:
/xbm sync—— 把书签拉回来,第一次是全部 /xbm classify—— 打类别、标签、类型、摘要、优先级 /xbm export—— 写出去:桌面 / Obsidian / Notion / Docs /xbm digest—— 这一周的书签里,最好的十条 + 三个选题 /xbm schedule—— 每周日自动把这份周报发到聊天里
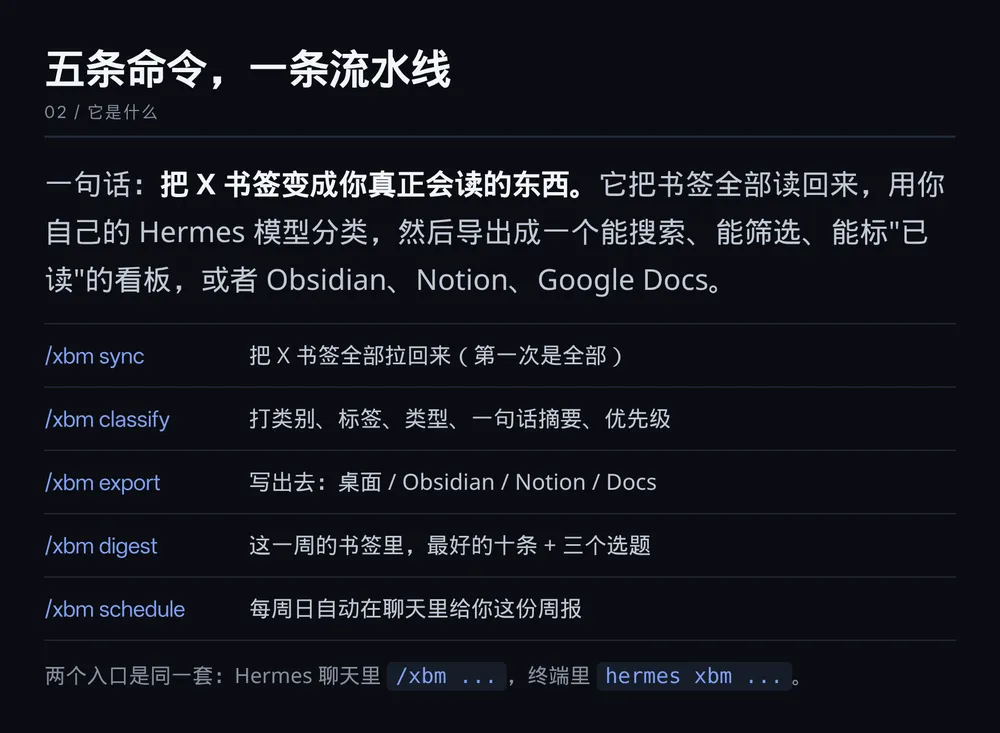
两个入口是同一套:Hermes 聊天里敲 /xbm ...,终端里敲 hermes xbm ...。它不是独立 App,是挂在 Hermes Agent 上的插件——这一点后面会说要紧的地方。
问题不在收藏,在读
作者自己的账号里有 1,880 条书签、213 篇 X Article。这个量级下,书签列表退化成一条按时间排列的流水:一条排序算法、一条融资消息、一条 meme 币教程挨在一起,想找"上次那个讲 MCP 的帖子",只能靠记忆往回翻。
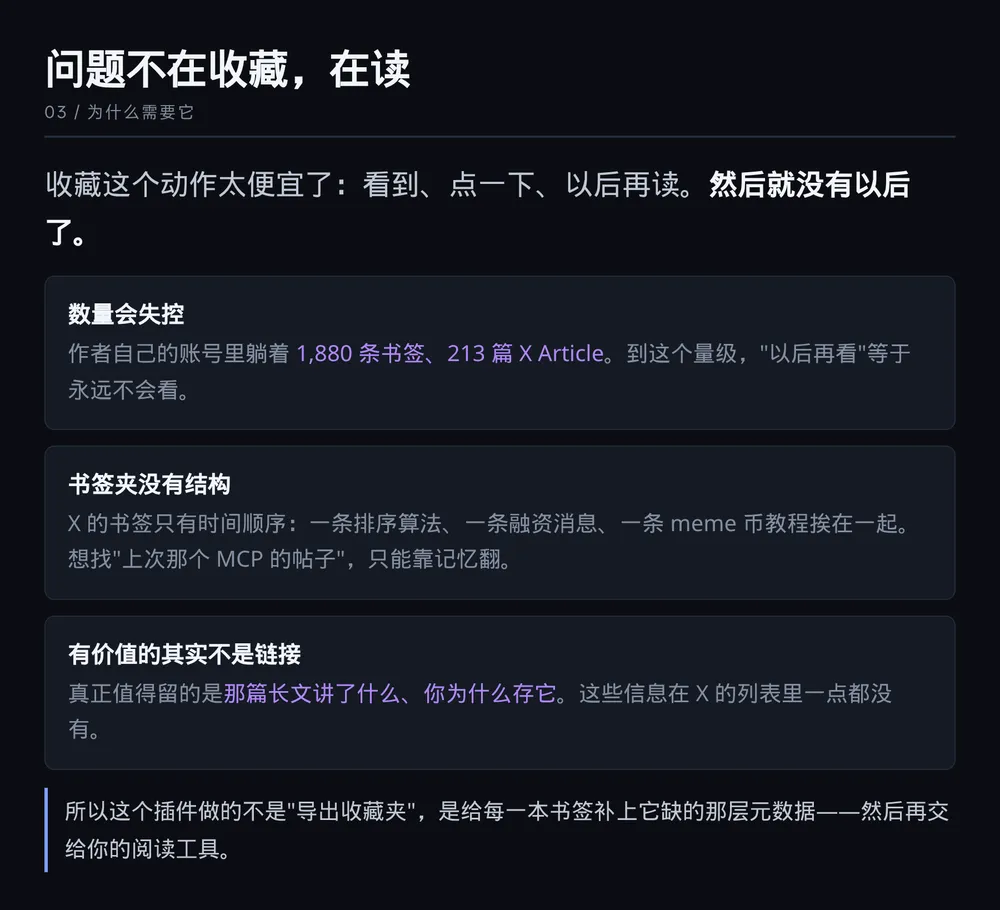
所以它做的不是"导出收藏夹",而是给每条书签补上它缺的那层元数据,再交给你的阅读工具。这个定位很关键——它没打算做一个更好的收藏夹,它想让你把收藏夹清掉。
长什么样
官方那张 banner 已经不客气地把结论写在脸上了:
落地的第一个形态是桌面看板:一个 board.html 单文件,双击就能开,不需要账号、不需要服务器。搜索框、按类别/类型/优先级筛选、按维度分列,每张卡片上有作者、日期、标题、摘要、标签、优先级,还有一个"done"勾。
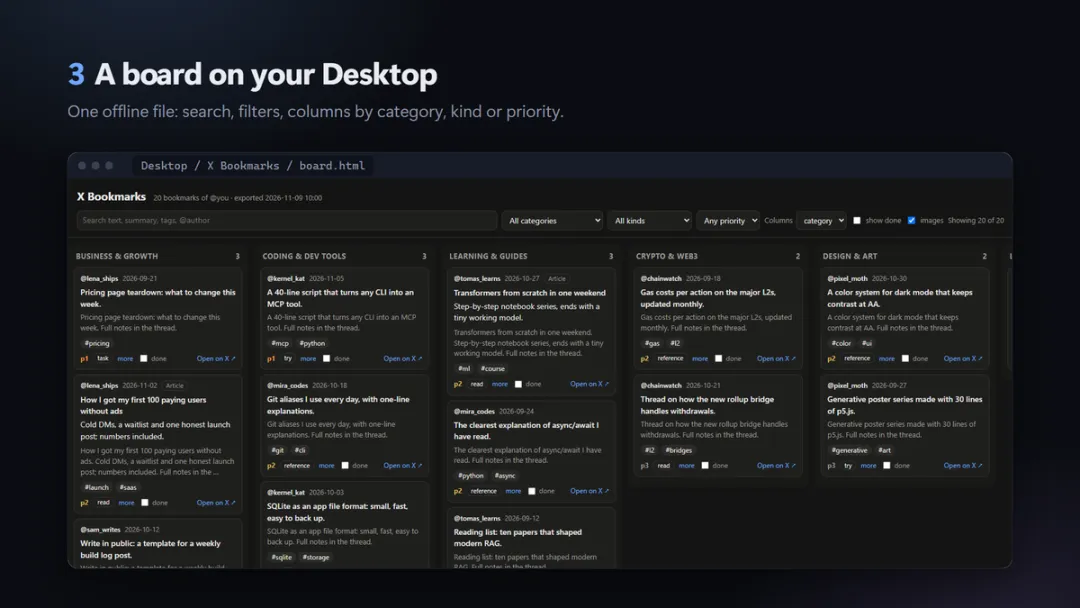
那个 done 勾只存在浏览器里,不上传、不同步。这个选择很实在——它知道你不会为"标记已读"去配一个后端。
分类这一步
抓回来只是搬运,真正让它有价值的是分类:每条书签过一次你自己的模型,输出六个字段。
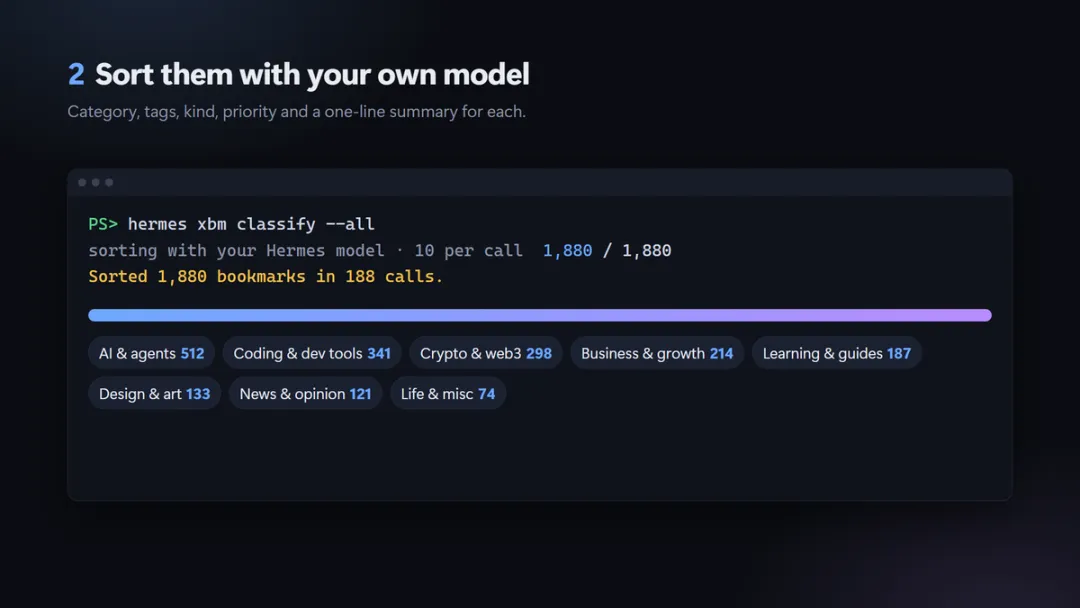
上面这张是 1,880 条分完之后的分布:AI 与 agents 512、编程与开发工具 341、加密与 web3 298、商业与增长 214、学习与指南 187、设计 133、新闻与观点 121、生活杂项 74。188 次模型调用跑完,作者用的是免费模型,花了 $0。
六个字段分别是:类别(从你自己的列表里选,不认识就归 Other 并给出建议)、最多 5 个标签、类型、一句话摘要(≤160 字符)、优先级 1–3,还有一条"猜你当初为什么存它"。
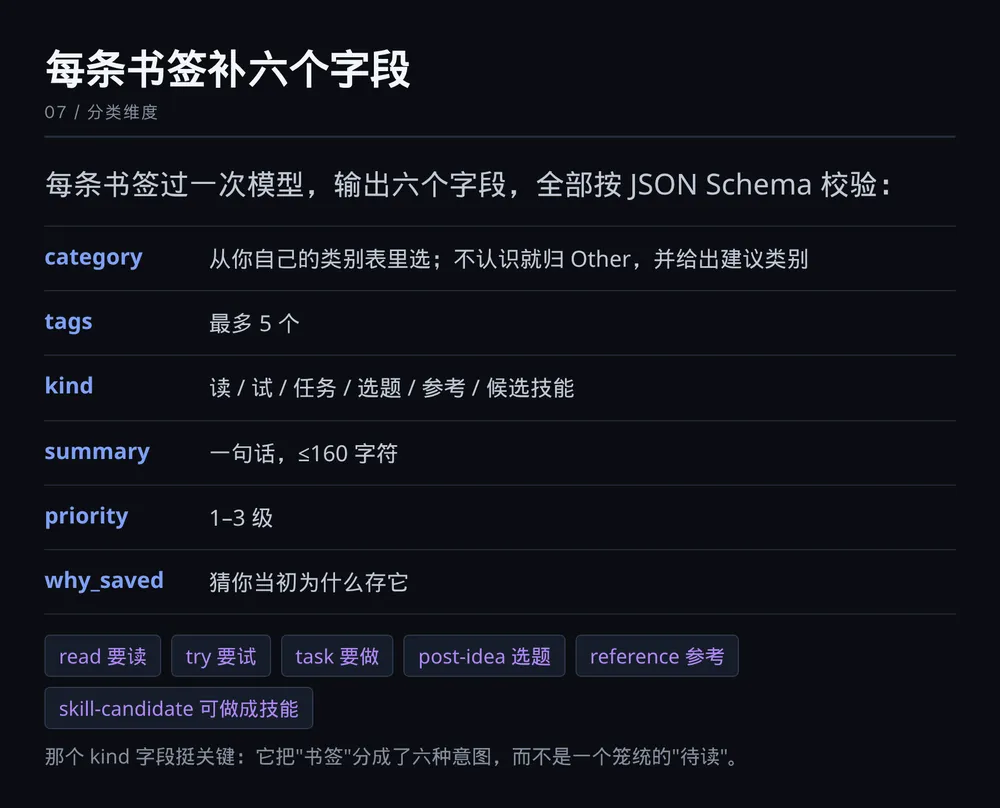
其中 kind 这个字段我觉得最有用:它把"待读"这一个笼统状态拆成了六种意图——要读、要试、要做、可以写、当参考、能做成技能。分类不是为了好看,是为了让你知道下一步该干什么。
一件容易被低估的事:读出全文
这是整个项目里技术含量最高、也最容易被忽略的部分。
"读一条推文"在 X 上其实有五种形态,只取 text 字段的话,你拿到的经常是一句半:
- X Article
—— 取 article.plain_text。作者实测 161 篇里 161 篇都能内联拿到全文 - 长推
—— 取 note_tweet.text,不是被截断的正文字段 - 引用的推文
—— 从 includes.tweets里取,引用的正好是 Article 也能拿全 - thread
—— 用 search/recent补同一对话里作者自己的回复,但只覆盖最近 7 天,更早的会标记为不完整 - 卡片链接
—— 形如 x.com/i/article/<n>的,那个数字不是推文 id(作者实测 100 次查询全部 not found),所以干脆不查,保留链接预览并标记正文不可得
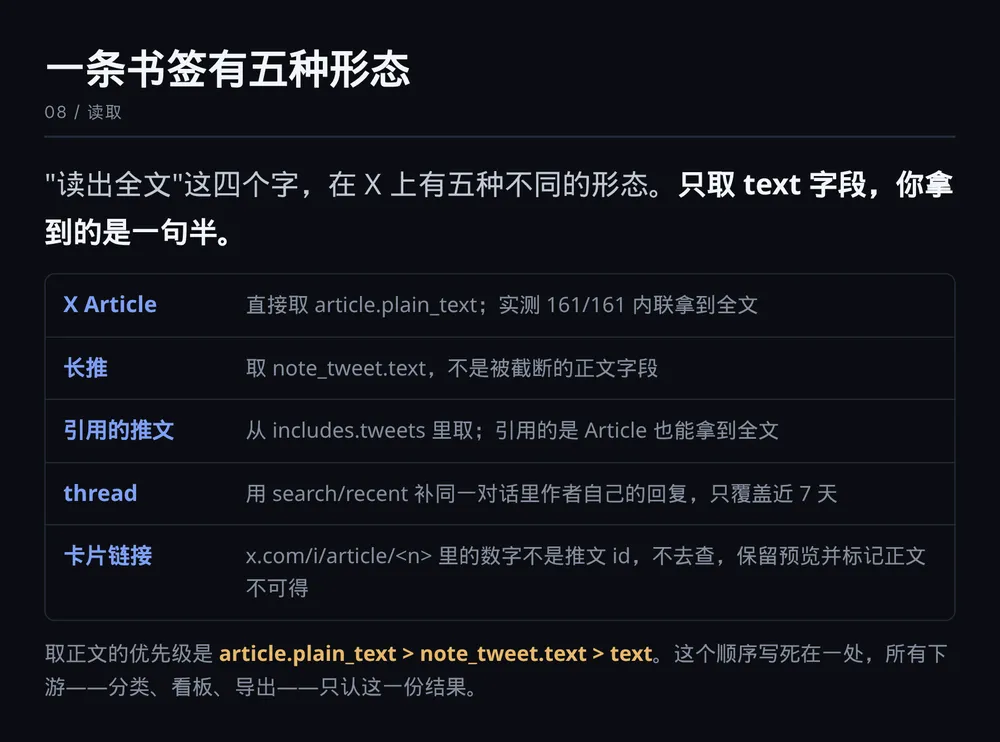
取正文的优先级写死成一条:article.plain_text > note_tweet.text > text。所有下游——分类、看板、导出——只认这一份结果。这种"只在一个地方做判断"的写法,比在每个导出器里各写一遍要可靠得多。
它还做了一件正确的小事:进模型之前清掉零宽字符(U+200B 到 U+200D 那一批)。理由写在架构文档里——这类字符会触发 Hermes 自己的提示注入扫描。听起来是个边角料,但正是这种细节决定了它能不能稳定跑在别人的框架里。
为什么是十个一批
分类这件事的成本和质量,卡在三个数字上:
一次调用处理 10 条,正文截断到 1,500 字符,1,880 条需要 188 次调用。
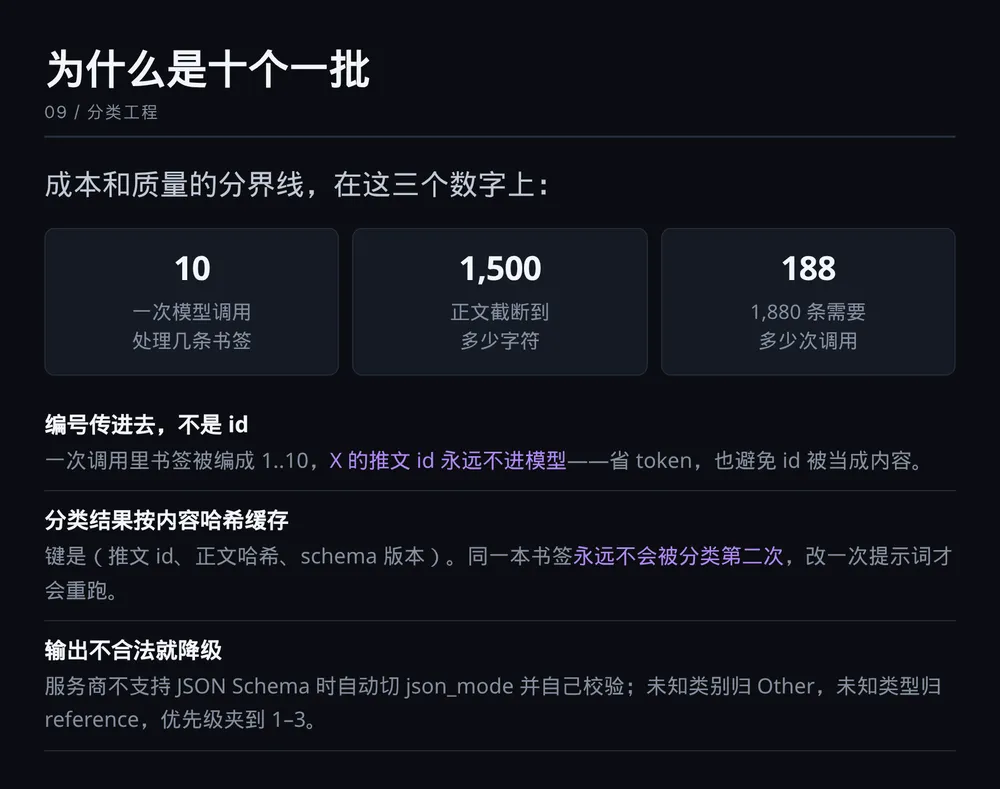
十个一批不只是为了省钱。还有个设计细节:一次调用里书签被编成 1..10,X 的推文 id 根本不进模型——省 token,也避免一串数字被模型当成内容的一部分。
结果按(推文 id、正文哈希、schema 版本)缓存。同一本书签永远不会被分类第二次,只有你改了提示词或者换了模型才会重跑。输出不合格时还有降级路径:服务商不支持 JSON Schema 就切 json_mode 自己校验,未知类别归 Other,未知类型归 reference,优先级夹在 1–3 之间。
四个落点,一条原则
导出目标有四个,官方这张对比图一眼能看完:
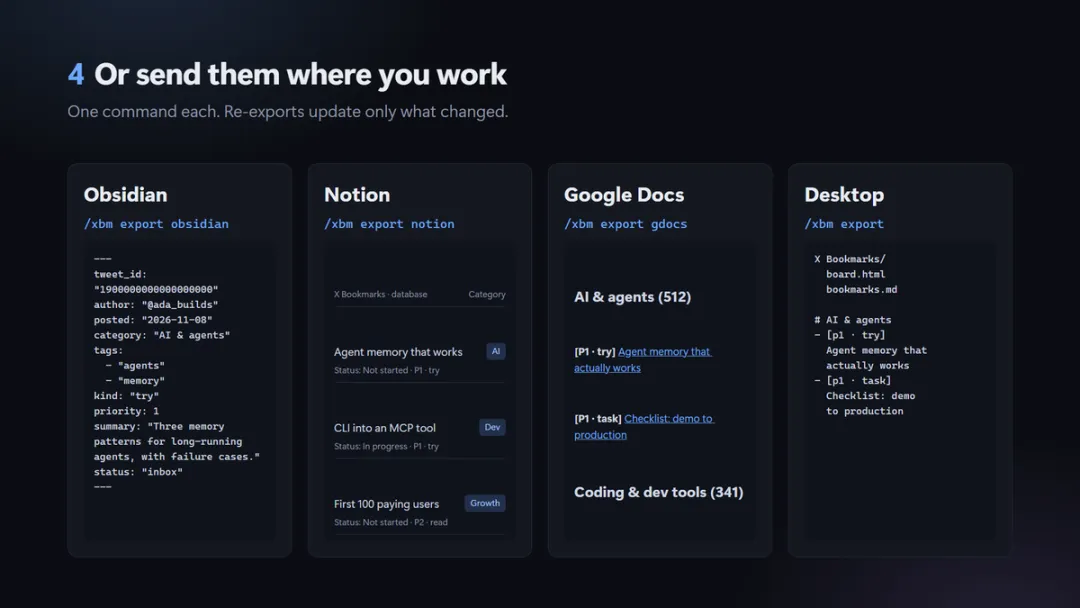
- 桌面
—— board.html看板 +bookmarks.md,零配置,默认就是它 - Obsidian
—— 每条书签一篇笔记,带 front matter;重新导出只更新插件自己的键,你写的正文不动 - Notion
—— 一个数据库 + 两个看板;只发变化的页, Status列永远归你,你删掉的页不会被复活 - Google Docs
—— 一份按类别分组、高优先级在前的文档;每次重写同一份,链接和分享设置都不变
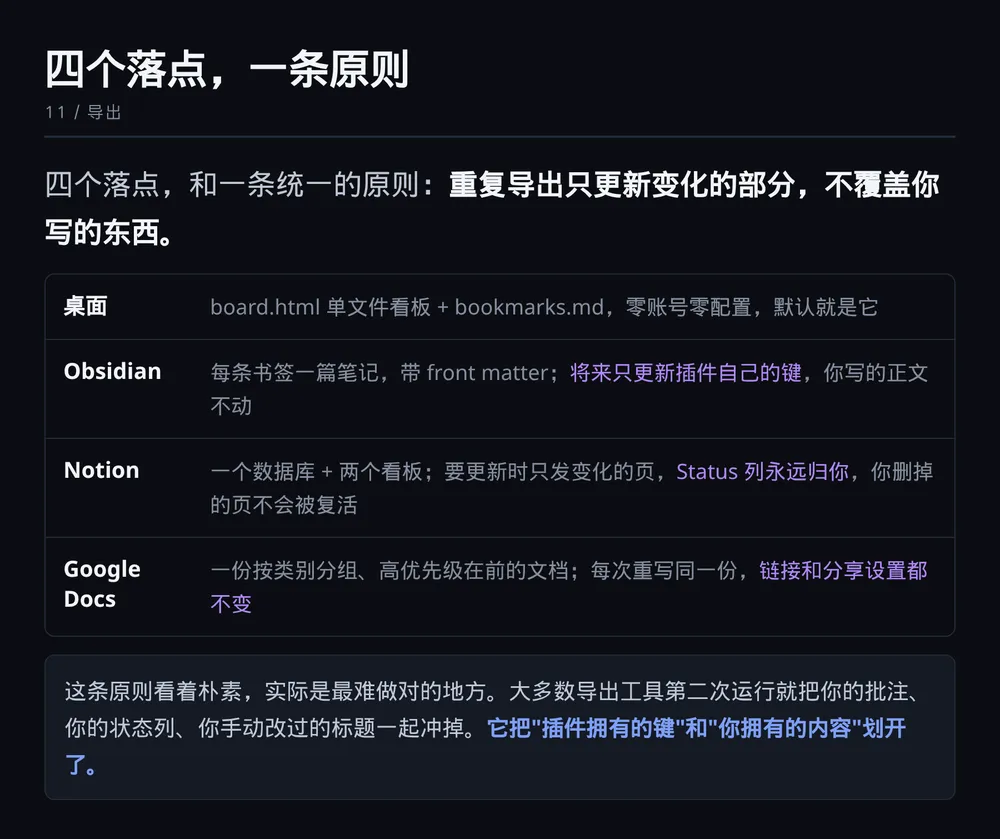
这里有条原则值得单独说:重复导出只更新变化的部分,不覆盖你写的东西。
听着朴素,实际是最难做对的。大多数导出工具第二次运行就把你的批注、你的状态、你改过的标题一起冲掉。它是靠一张导出表(条目 → 远端 id + 内容哈希)做到的:哈希没变就不发请求,字段所有权分开记录——插件只写自己那几列。
Notion 那条路还有个讲究:默认走 Hermes 自己的 Notion 连接器,插件不持有任何 token。作者在决策文档里写了原因:Hermes 的 credentialed_provider_request 只发 JSON body,做不了 multipart 上传,所以 Google Docs 那边只能改成用 Docs API 建文档再写入,避免自己拿 token。
周报:让它在合适的时候找你
能读还不够,得有个时间点把它推到你面前。/xbm schedule 会创建一个普通的 Hermes 定时任务,默认每周日 18:00,把周报发到你设置它的那个聊天里;没有新内容就保持沉默。
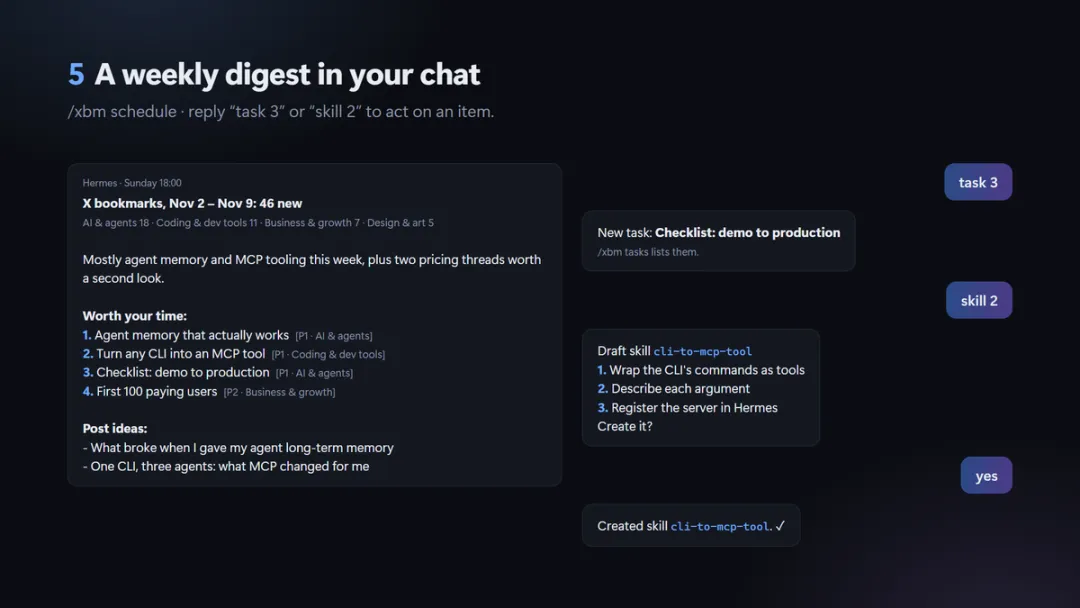
一份周报由四部分组成:过去 7 天入库多少条、各类别分别多少;两三句话总结你这周在关注什么(模型写);按优先级排出最值得看的十条,带编号,你自己发的不算;最后给你三个可以写的题目。
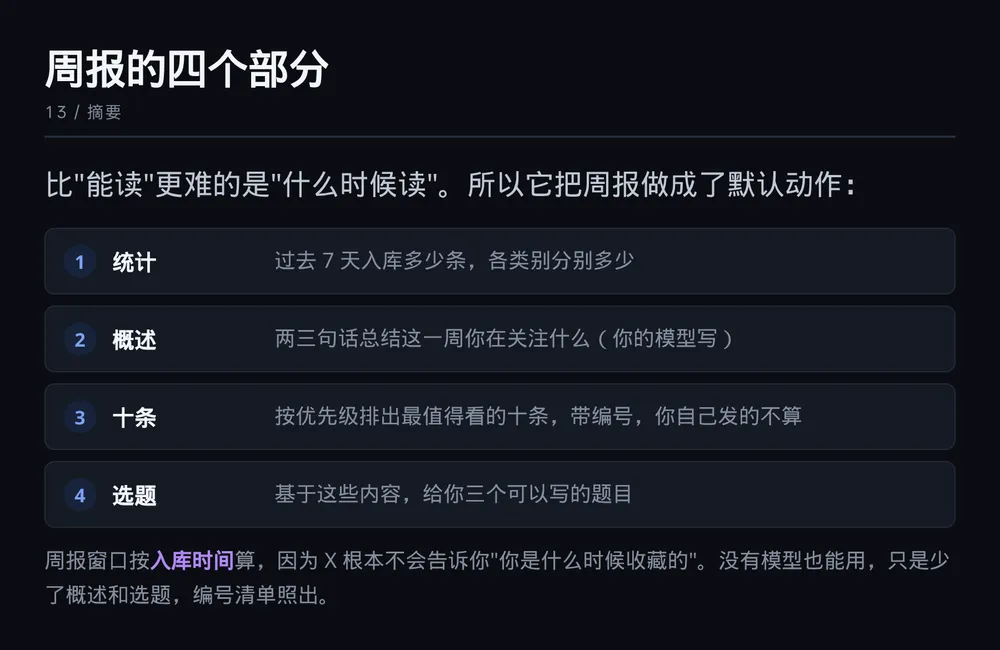
有个细节必须说明:周报窗口是按"入库时间"算的,不是发布或收藏时间——因为 X 的 API 根本不告诉你什么时候收藏的。这个限制官方写在决策记录里,没有藏。
从"读到"走到"做了"
周报里的每条都带编号,你可以直接对它下指令:
task 3—— 第 3 条变成一条待办,进 Hermes 的任务体系,做完用 done 1收掉skill 2—— 从那篇帖子里起草一个 Hermes 技能(步骤、坑、怎么验证),满意再 /xbm skill 2 save正式创建
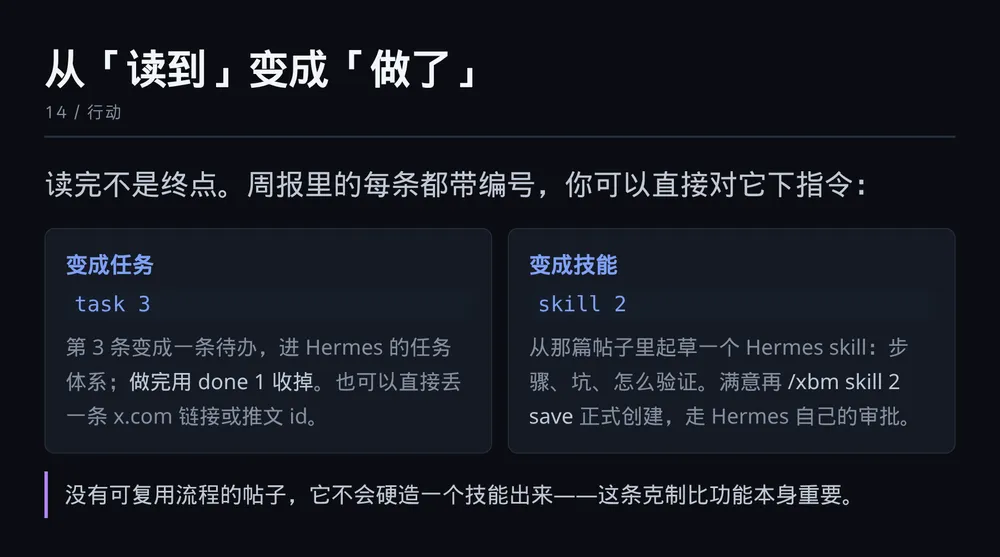
技能这条我给个好评:没有可复用流程的帖子,它不会硬造一个技能出来。这条克制比功能本身重要——很多"AI 帮你提炼"的工具,最后提炼的全是废话。
实现上也有个细节:Hermes 不会把斜杠命令的输出交给 agent,所以直接回一句"task 3",agent 是没上下文的。作者加了个 pre_llm_call 钩子,只在你整条消息就是 task N、skill N、done N 时补一行说明,其它消息完全不碰。
装起来有三道门槛
第一道门槛不在代码里,在 X 的开发者后台。
你得用要读书签的那个账号登录 console.x.com,建一个 Pay-per-use 的应用,权限设成 Read,然后拿四把钥匙(API Key / Secret、Access Token / Secret),写进 Hermes 的 .env,再装插件:
```
hermes plugins install winchxyz/hermes-x-bookmarks --enable
hermes xbm whoami
```
whoami 打印出你的 handle 就对了,接着 sync → classify --all → export。
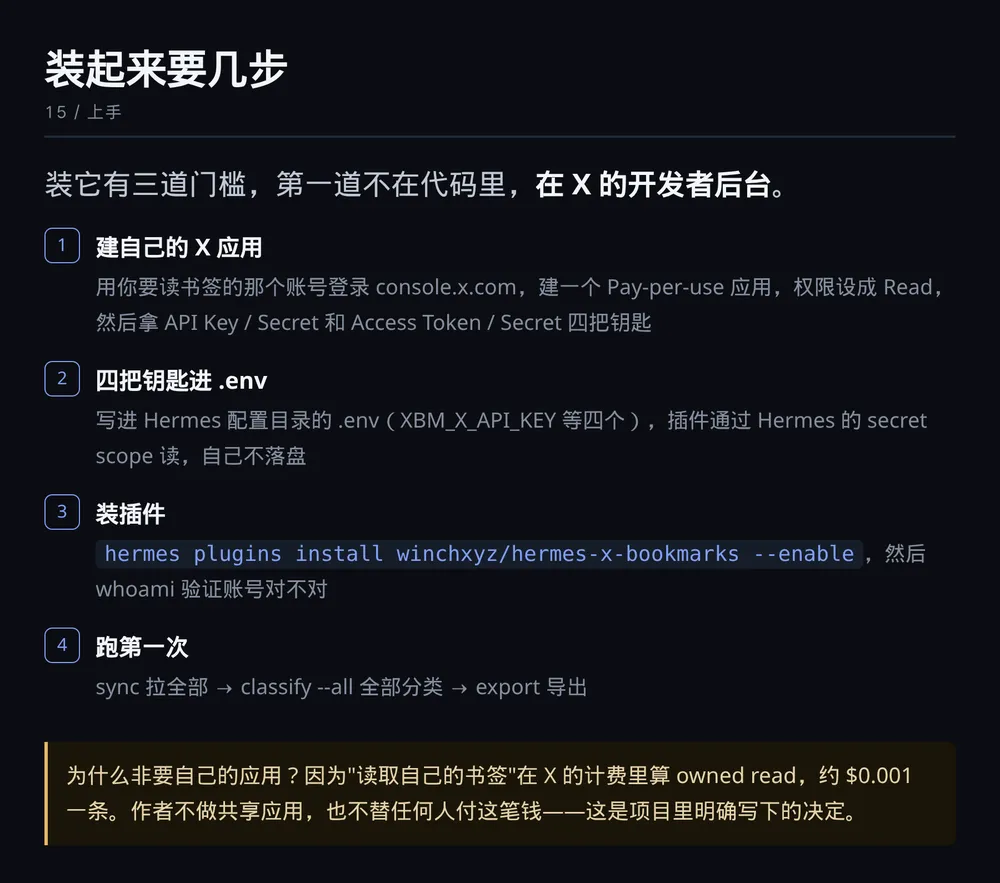
为什么非要自己的应用?因为"读取自己的书签"在 X 的计费里算 owned read,约 $0.001 一条。作者明确决定不做共享应用、不替任何人付这笔钱——这个决定写在决策文档里,日期是 2026-11-09。
这笔钱花在哪
账其实很清楚:
读一条书签:约 $0.001 首次全量 1,880 条:21 页、12 秒、约 $1.89 没有新内容时同步:1 个请求、20 条、约 $0.01 分类 1,880 条:188 次调用、50 万输入 + 20 万输出 token,用免费模型是 $0
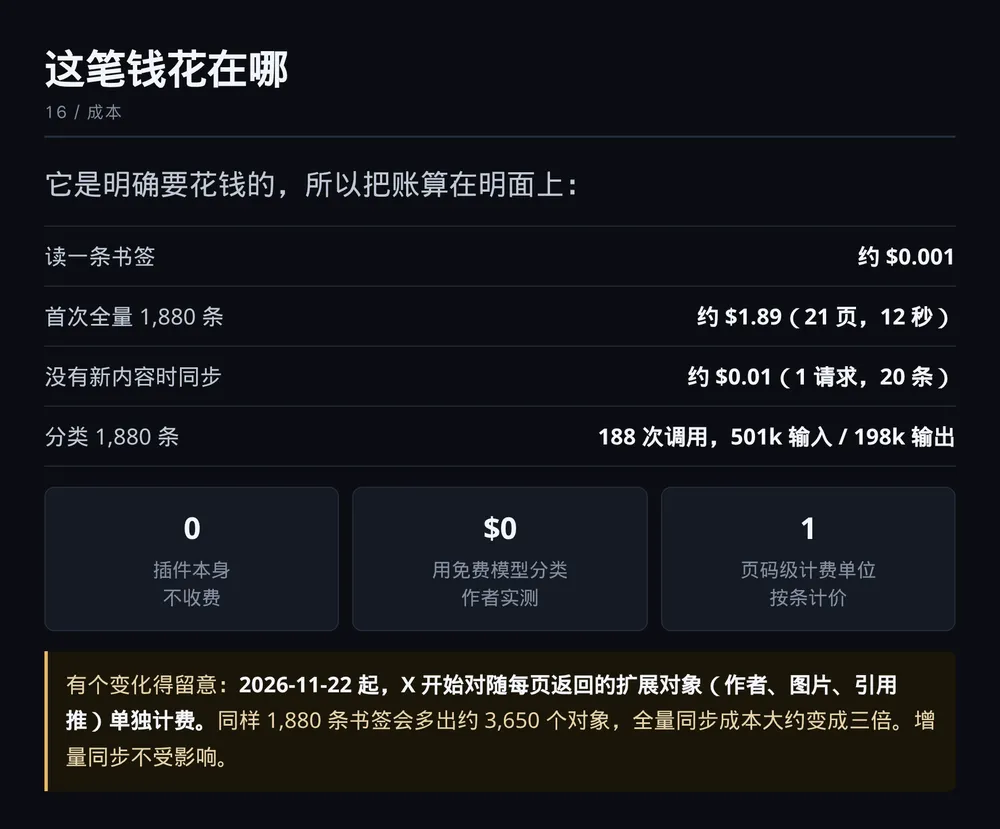
但有个变化得提前知道:2026 年 11 月 22 日起,X 开始对随每页返回的扩展对象(作者、图片、引用推)单独计费。同样 1,880 条书签会多出大约 3,650 个对象,全量同步成本大概变成三倍。作者的建议也很实在:把全量同步当一次性动作,日常只跑增量。
它碰什么,不碰什么
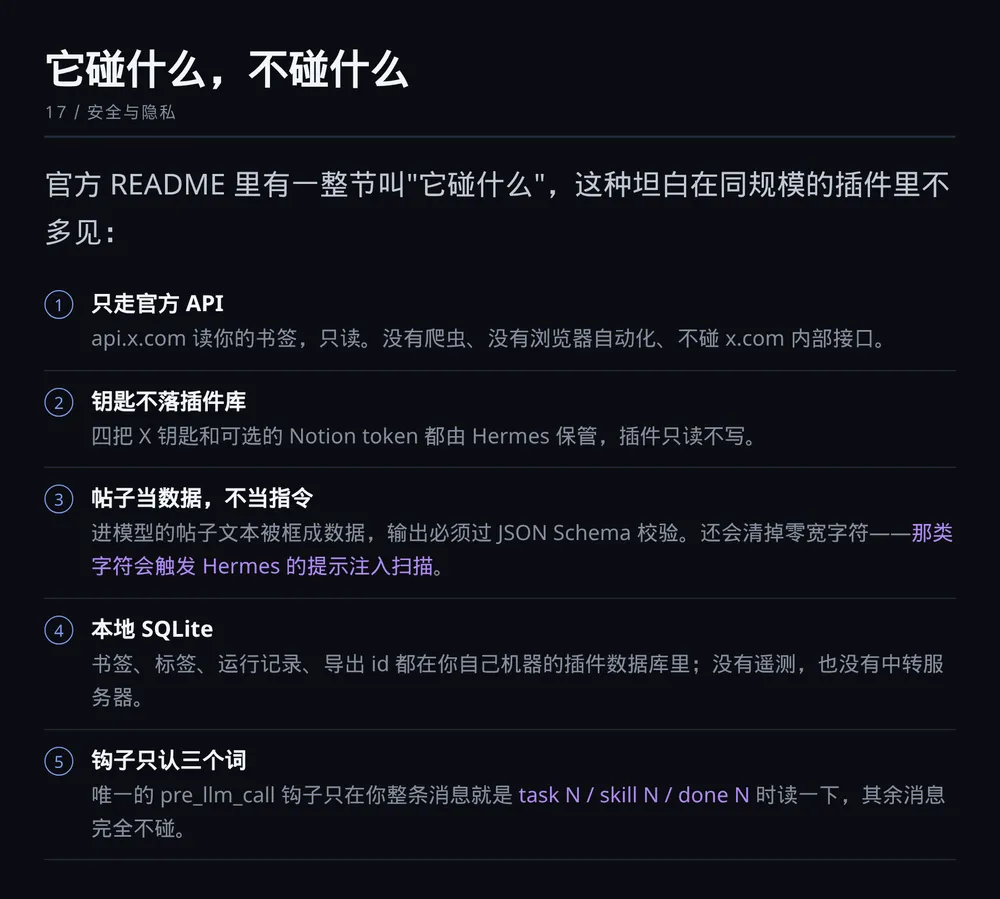
一个能读你全部书签的工具,值得单独看一节。官方 README 里有一整节叫"它碰什么",几乎是把权限清单摊开写的:
- 只走官方 API
—— 只有 api.x.com,只读。没有爬虫、没有浏览器自动化、不碰 x.com 的内部接口 - 钥匙不落插件库
—— 四把 X 钥匙和可选的 Notion token 都由 Hermes 保管,插件只读不写 - 帖子当数据,不当指令
—— 进模型的文本被框成数据,输出必须过 schema 校验;零宽字符会被清掉 - 本地 SQLite
—— 书签、标签、运行记录、导出 id 都在你自己机器上;没有遥测,没有中转服务器 - 钩子只认三个词
—— 唯一的 pre_llm_call钩子只在你整条消息是task N/skill N/done N时读一下
还有一条属于合规而不是技术:X 的开发者政策要求删除同步——帖子在 X 上被删了,本地的副本要在下次同步时跟着删或更新。它做了。
项目本身什么水平
它很新(建仓两天就推了 0.3),但工程完整度不像一个新项目:25 个 Python 模块、16 个测试文件,CI 跑 ruff、pytest 和 hermes plugins validate / doctor,对 Hermes v0.23.0 和 main 两个版本都验。
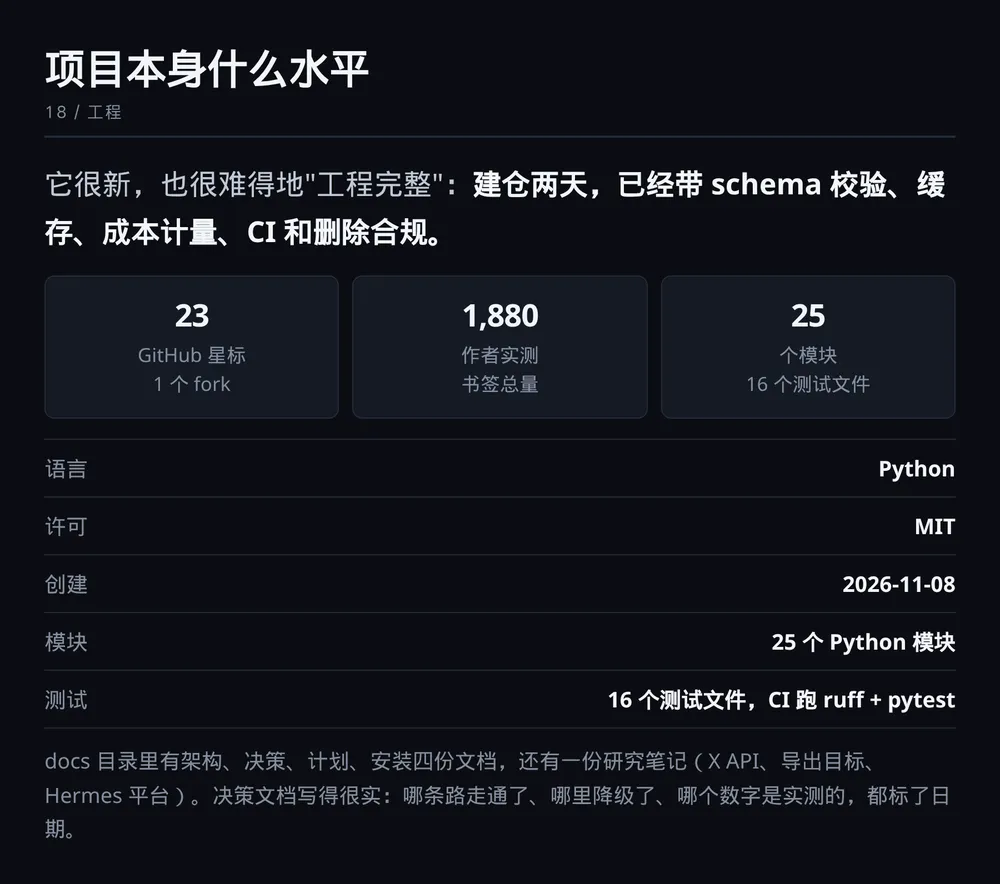
docs 目录里有架构、决策、计划、安装四份文档,外加一份研究笔记(X API、导出目标、Hermes 平台)。决策文档写得尤其实:哪条路走通了、哪里降级了、哪个数字是实测的,全标了日期。比如"OAuth 1.0a 四把钥匙走通了,Hermes 插件 OAuth 2.0 在 v0.23.0 会绑随机回环端口,没验证过 X 是否接受"——这种把不确定写出来的文档,比一堆"完美支持"更可信。
该泼的冷水
Article 只有纯文本。API 给的就是纯文本,标题、链接、代码块的顺序都丢,导出里会明说。想看原排版还得点回 X。
thread 只存被收藏的那条。同一对话里作者的回复要靠 search/recent 补,而它只覆盖最近 7 天;更早的 thread 只能拿到引用链,标记为不完整。
取消收藏不会同步。X 上取消了,本地还在——这条官方写在限制里,还没做。
得自己开 X 应用并付钱。这是硬门槛:后台建应用、绑卡、设限额,一样都不能少。不想为这个花 $1.89 的人,可以直接关掉这篇文章。
弱模型会露馅。作者用免费模型实测:优先级 75% 集中在 p2(等于没分级),少数类别会跑偏(比如 Telegram NFT 教程进了 AI 类)。换个强模型放在分类槽位才治本。
离开 Hermes 用不了。它是插件,不是独立 App。你不用 Hermes Agent 的话,这套东西对你就只是一堆读不了的代码。
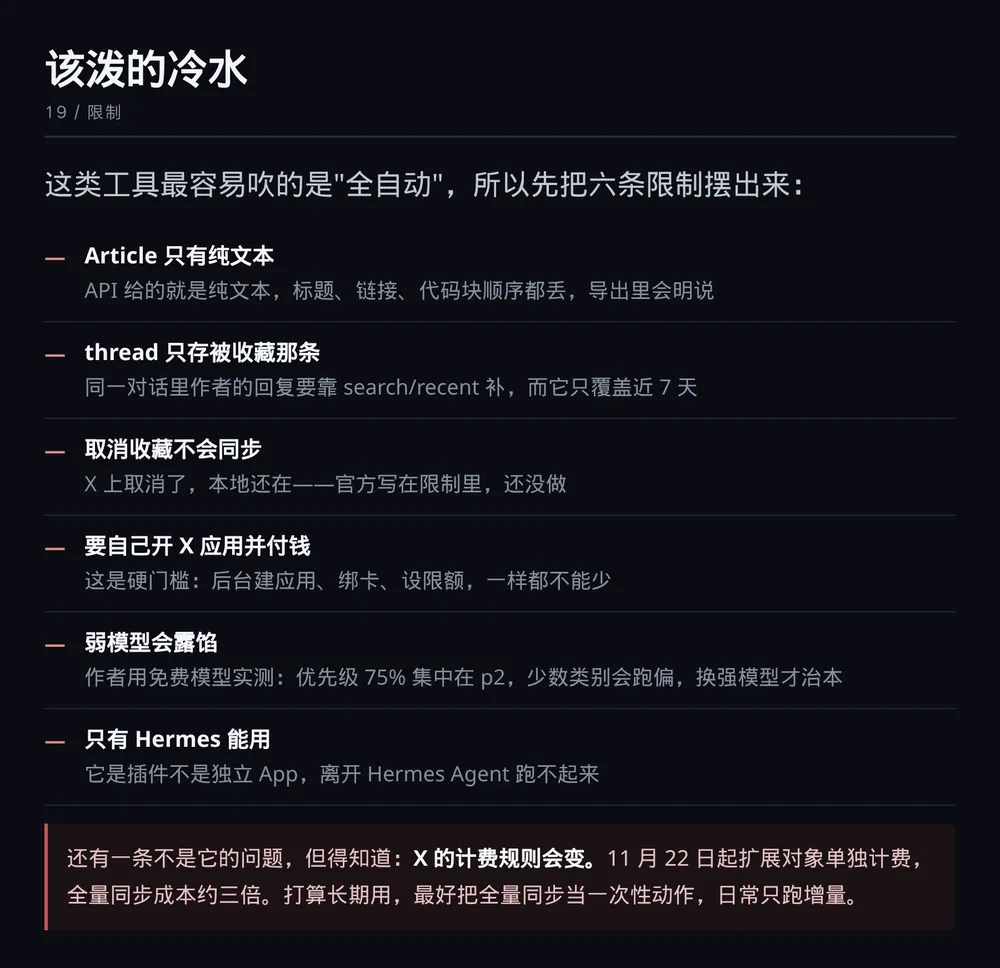
还有一条不是它的问题,但得知道:X 的计费规则在变。11 月 22 日起扩展对象单独计费,全量同步约三倍成本。打算长期用,最好趁现在把全量跑完。
一句话
它解决的其实是个很具体的问题:你的收藏夹里有一批真的值得读的东西,你缺的不是时间,是一条把它们翻出来的路径。
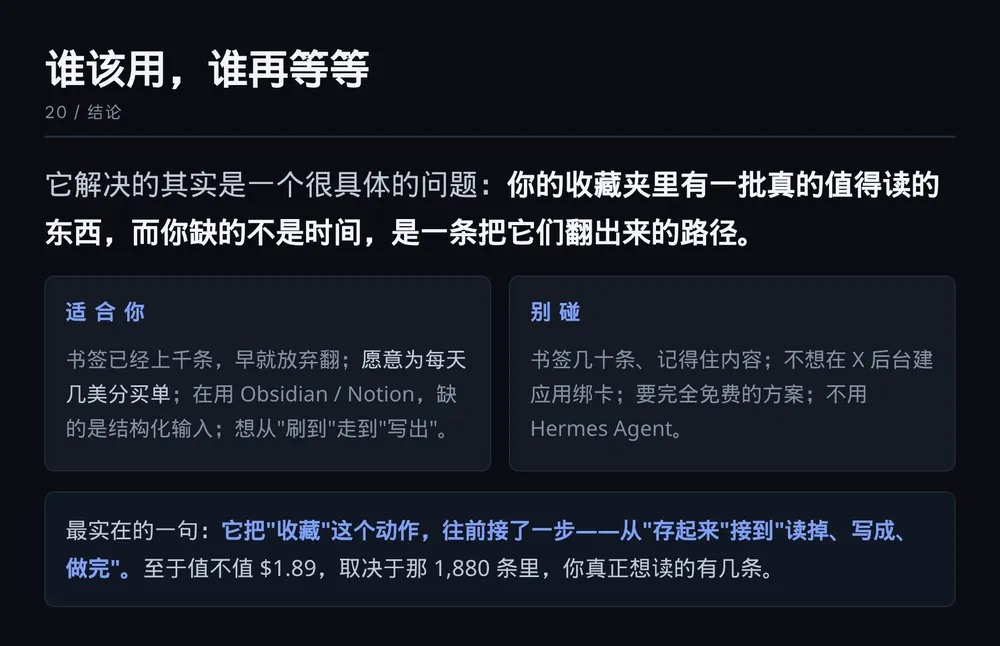
适合你的情况:书签已经上千条、早就放弃翻;愿意为每天几美分买单;在用 Obsidian 或 Notion,缺的是结构化输入;想从"刷到"走到"写出"。
不适合的情况:书签几十条、内容还都记得住;不想在 X 后台建应用绑卡;要完全免费的方案;不用 Hermes Agent。
最后一句话是我自己的判断:这类工具的价值不在"自动化",在它把收藏这个动作往前接了一步——从"存起来"接到"读掉、写成、做完"。至于值不值 $1.89,取决于那 1,880 条里,你真正想读的有几条。
尽快转存,以免被删!
https://pan.quark.cn/s/050f381b395b
https://pan.xunlei.com/s/VOrwPKercKjS8cldc_ol5cI0A1?pwd=724j#