ARTICLE · 1354044
DeepSeek App级API上线!搜索、文件、读链接和语音能力直接给开发者
✅点击上方🔺公众号🔺关注我✅
一句话版本,DeepSeek 把自家 App 里的搜索、文件、链接、安全和语音,整套开给了 API。
中文新闻稿把这件事叫做「全家桶应用 API」。在请求里打开对应参数,工具调用和上下文拼接由服务端完成。OCR、ASR、TTS 等也可以单独调用。官方还开源了一个前端 Demo,用来演示如何接近一比一复刻 DeepSeek App。
这次能力目前写在 deepseek-flash(V4.1-Flash-1017)上,三个协议都能用,分别是 Messages、Responses 和 Chat Completions。
先看信息卡
deepseek-flash | |
一、官方宣布了什么
北京时间 11 月 13 日 22 点 24 分,DeepSeek(@deepseek_ai)发了四条连推。英文标题是 The full DeepSeek App experience, now via API。同一天的中文新闻稿写得更直白。以前开发者要在自己的应用里做出类似 DeepSeek App 的体验,往往还要另接外部工具、自己处理调用衔接。现在在原有 API 里打开对应参数即可。
四条连推的结构和新闻稿一致,具体分成四点。
App 背后的搜索、文件、链接、安全和语音,现在可以通过 API 使用;也可以单独调用 OCR、ASR、TTS。官方同时给出了 Demo、源码和文档。 这些能力由 deepseek-flash在三条协议下提供,工具调用和上下文拼接在服务端完成。对外提供服务的应用必须开启安全校验。开发者仍需自行承担内容审核、大模型登记和 AI 标识等义务。扩展能力除了 Token 费用,还要收工具调用费,并配了一张定价图。 官方说,DeepSeek App 只是与模型交互的一种形态;这些能力现在可以按需调用、自由组合。
DeepSeek还提出了一个产品目标。开发者可以在自己的应用中实现复杂的对话功能,甚至一比一复刻出完整的 DeepSeek App。
二、关键机制
工具在服务端跑,前端只负责渲染
这是这次发布里最值得先看清的一点。官方文档写明,模型自己决定要不要上网,搜索和抓取都在服务端执行,你的客户端不执行任何工具。客户端要做的,是把返回的内容块展示出来,并在下一轮原样传回去。
你不再自己写「模型说要搜索 → 你去搜 → 把结果塞回上下文」这条循环,循环在 DeepSeek 的服务端完成。这里有一个边界。搜索、读页和安全审核的执行权交给了对方的服务,计费、限速和审核结果都以服务端为准。
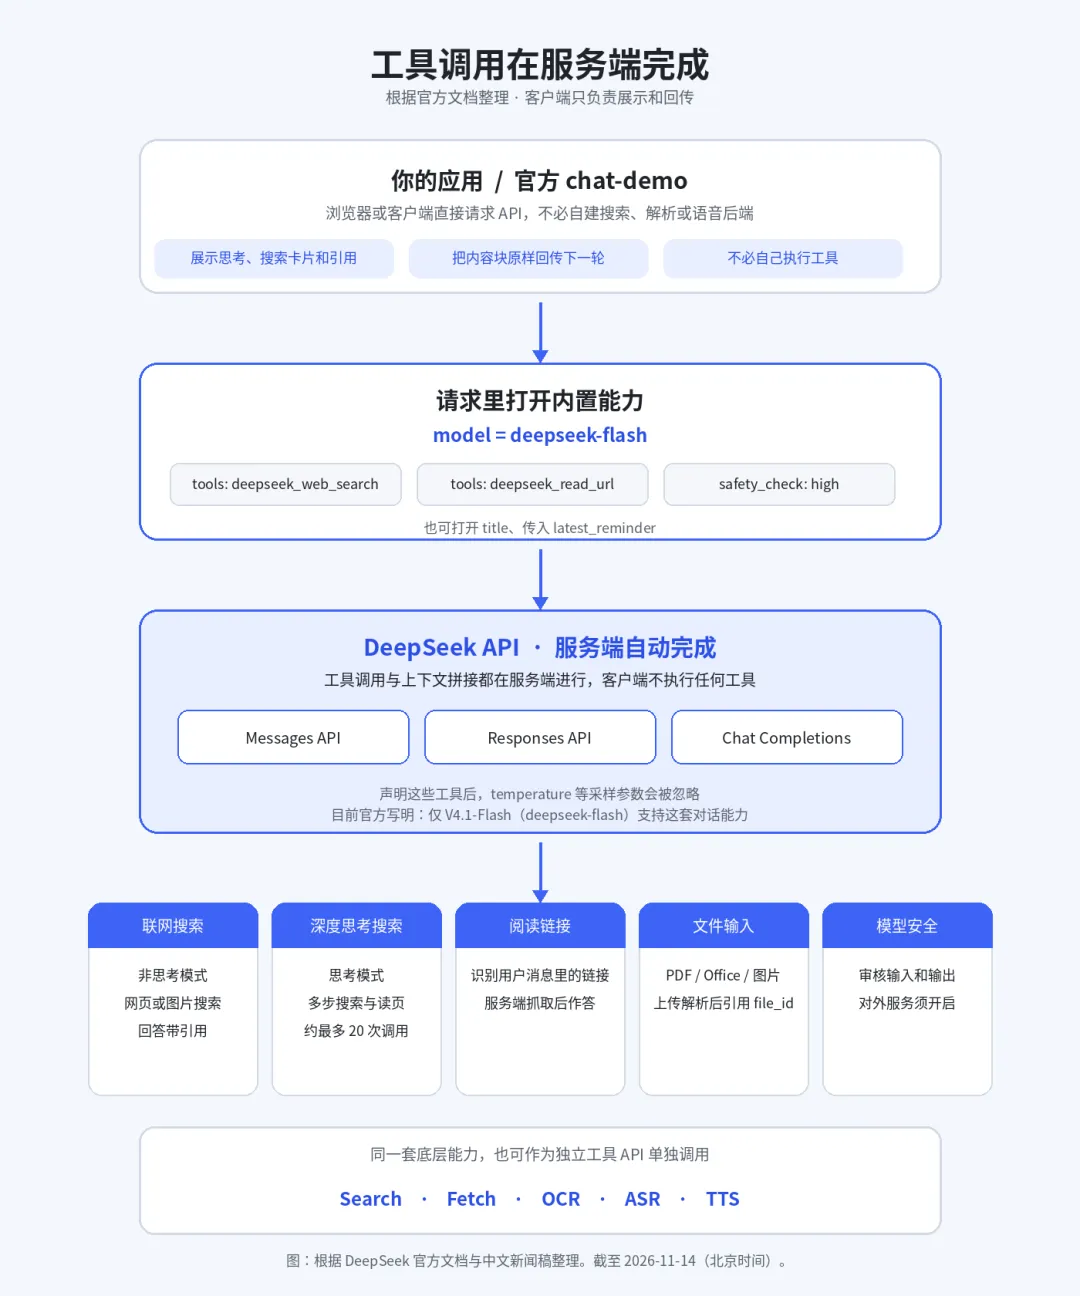
▲ 内置工具的调用关系。请求里打开参数,服务端完成搜索、读链接、文件解析和安全审核。
一段最小可用的 Messages 请求如下。官方示例用的是英语提问,这里改成中文,字段保持不变。
curl https://api.deepseek.com/anthropic/v1/messages \ -H "Content-Type: application/json" \ -H "x-api-key: ${DEEPSEEK_API_KEY}" \ -d '{ "model": "deepseek-flash", "thinking": {"type": "enabled"}, "tools": [ { "type": "deepseek_web_search", "name": "deepseek_web_search" }, { "type": "deepseek_read_url", "name": "deepseek_read_url" } ], "safety_check": {"level": "high"}, "title": {"enabled": true}, "messages": [ { "role": "user", "content": "DeepSeek V4.1 有哪些新能力?" } ], "stream": true }'这段请求完成四件事。它打开思考,让 deepseek_web_search 走「深度思考搜索」。它还打开阅读链接、安全审核,并让服务端在结束时生成会话标题。完整脚本在配套压缩包的 scripts/chat-with-tools.sh。
Responses 和 Chat Completions 的字段几乎相同,只是鉴权和少量参数名不一样。tool_choice 不能点名强制这两个内置工具,否则返回 400。搜不搜、读不读,由模型决定。
三、五项内置能力,怎么开、计什么费
官方把 App 里的对话功能,映射成了一组可开关的能力。下面按文档来写,不补充官方没有给出的效果数据。
联网搜索。 思考关闭,并声明 deepseek_web_search。模型按需要搜索网页或图片,回答带引用。一次搜索可以包含多个 query,计费按 query 条数计算。三个 query 算三次,失败或没有结果不计费。
深度思考搜索。 同一个工具,只要打开思考,就变成多步推理里的搜索、打开网页和页内查找,类似 App 里的深度思考搜索。官方写,模型回答前大约最多会调用 20 次工具。打开网页和搜索结果里已经带上的页面,计费规则不同。成功从网上抓取才计费,同一页再打开、在页内查找是免费的。
阅读链接。 声明 deepseek_read_url 后,模型会识别最后一条用户消息里的链接并抓取。重复链接只算一次,最多考虑前 10 个不同 URL,具体读哪些仍由模型决定。有一个容易踩的组合。思考已打开、同时又声明了 deepseek_web_search 时,这一轮走深度思考搜索,不会再单独读用户给出的链接。要把用户消息里的链接读出来,需要关掉思考,或只声明 deepseek_read_url。
读链接的结果不会把网页正文明文返回给客户端,正文放在加密的 signature 里。下一轮必须把这个块原样传回,服务端才能把页面重新放进上下文。改掉 signature,请求仍可能成功,但模型就再也看不到那一页。
文件输入。 先把 PDF、Word、PowerPoint 或图片传到 Files API,解析成功后拿到 file_id,再在对话里引用。解析有两种目的。text_recognition 只提取文字,图表会被丢掉。rich_layout_recognition 会裁出图,按原位置交给模型。一份带图表的财报,前者往往答不出「这张图说了什么」。纯文本、表格和电子书用 user_data 上传,这一类不收解析费。单次请求最多引用 20 个文档,文本合计不超过 8 MiB;多轮对话会保留完整解析结果,超长时直接返回 400,不会悄悄截断。
模型安全。 请求里加上 "safety_check": {"level": "high"},服务端会审核输入和输出,命中风险时返回拒答标识。low 等同于不传这个参数。官方写得很明确。这只是基础风控,不能替代你作为服务提供者的审核义务。对外提供服务时必须开启,并自行完成内容安全审核、大模型登记和 AI 标识。已经流式发出去的文字无法撤回,前端要以拒答结束时,删掉已展示的回答,改成你自己的拒答文案。拒答前已消耗的 Token 照常计费;安全审核产生的 Token 也按输出 Token 计费。
此外还有两个偏产品体验的开关。title 会在回答结束时生成短标题。latest_reminder 则用来告诉模型当前日期、地点、平台和语言,格式是 2026-11-14,星期六,新加坡,Web,中文,Messages 和 Chat Completions 支持,Responses 不支持。
四、也可以不经过对话,单独调用底层接口
如果要自己做 Agent 或 RAG,不一定要把这些能力绑在一轮聊天里。官方同时开放了五个独立工具 API。
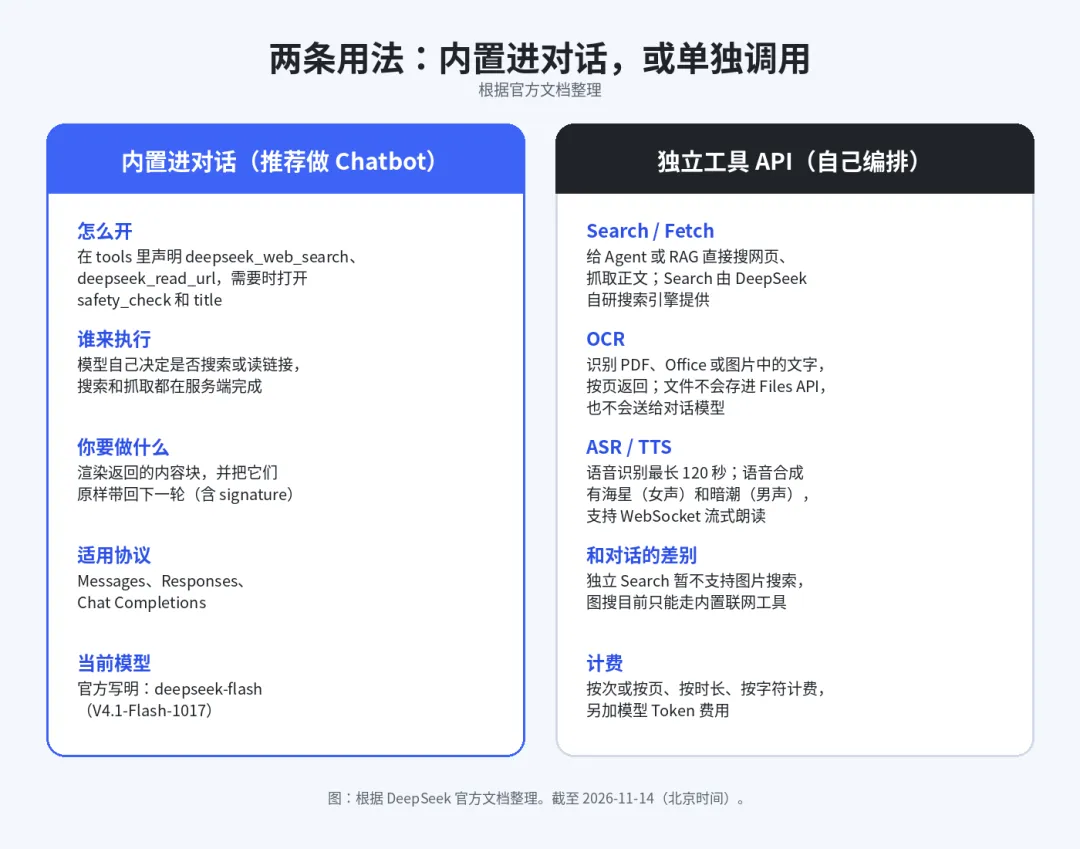
▲ 内置工具适合做 Chatbot。独立 API 适合自己编排工作流。
Search / Fetch。POST /v1/tools/search 按 query 搜网页,返回标题、摘要、站点信息和可选正文。官方写明,该接口由 DeepSeek 自研搜索引擎提供。POST /v1/tools/fetch 抓取单个页面,以 Markdown 返回。两者都按成功次数计费,不按返回条数计费。独立 Search 暂不支持图片搜索,图搜目前只能走内置的 deepseek_web_search。
OCR。POST /v1/tools/ocr 识别 PDF、Office 或图片中的文字,按页返回。和文件输入不同,这份文件不会存进 Files API,也不会送给对话模型。想让模型基于文档问答,应该走文件解析,而不是 OCR。
ASR / TTS。 语音识别一次发送完整音频,返回完整文本,不支持流式识别。格式为 16 位 PCM WAV 或 Ogg Opus,最长 120 秒,最大 8 MiB,语种自动识别。语音合成有两个音色,默认的海星(stella,女声)和暗潮(tide,男声)。可以一次提交整段文本,也可以走 WebSocket 边生成边朗读。不支持调语速。计费时汉字算 2 个字符,英文字母、数字和空格等算 1 个。
五、怎么计价
Token 之外,还要算工具费
连推第三条和中文新闻稿都说,使用扩展能力时,除 Token 费用外,还要收工具调用费。下面这张图来自中文新闻稿,单位是人民币。
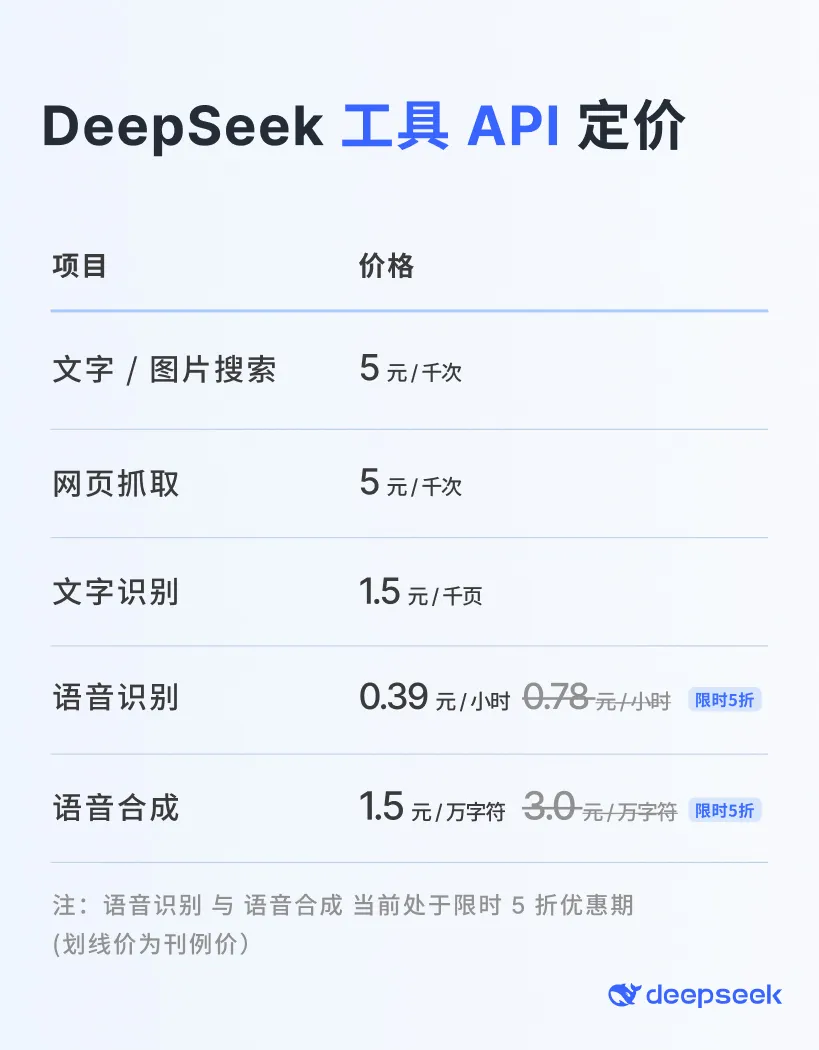
▲ 中文新闻稿中的工具定价。语音识别和语音合成目前是限时 5 折,官方未公布截止日期,划线价为刊例价。
按官方中文定价页,把数字摊开如下。工具价截至 2026-11-14(北京时间)。
这些费用是叠加在模型 Token 之上的。deepseek-flash 的人民币价格如下。缓存命中每百万 Token 空闲 0.02 元、高峰 0.04 元。缓存未命中空闲 1 元、高峰 2 元。输出空闲 4 元、高峰 8 元。北京时间周一至周五 9 点到 12 点、14 点到 18 点为高峰时段,不含中国法定节假日。周末和法定节假日全天按空闲时段计。
做产品时还要提前算进几条计费细则。
内置联网工具和独立 Search / Fetch 用同一档价格,但统计口径不同。内置搜索按成功返回的 query 条数计费;独立 Search / Fetch 按成功请求次数计费,空结果不计费。 官方定价页写明,通过 DeepSeek Harness、Claude Code 或 Codex 使用时,工具触发的 Search 和 Fetch 同样按成功次数计费。这项费用虽然不属于本次发布的主体,但会进入账单。 语音的限时 5 折,官方只写了「当前处于限时优惠期」,没有给出截止日期。 开启安全审核后,审核 Token 计入输出;输入未通过审核、请求返回 400时,输入 Token 仍会按缓存命中价格计费。
六、官方 Demo
官方用这套新接口做了一个开源前端。新闻稿和推文都指向同一个体验地址 https://cdn.deepseek.com/chat-demo 。源码在 https://github.com/deepseek-ai/chat-demo ,许可证是 MIT。仓库说明也可以直接打开 GitHub Pages,或从 Releases 下载 zip,解压后双击 index.html 使用。
我对照了仓库源码。最新发行版是 v0.1.1,说明写的是「修复导入失败提示文案」。下面三张图是官方页面的截图。
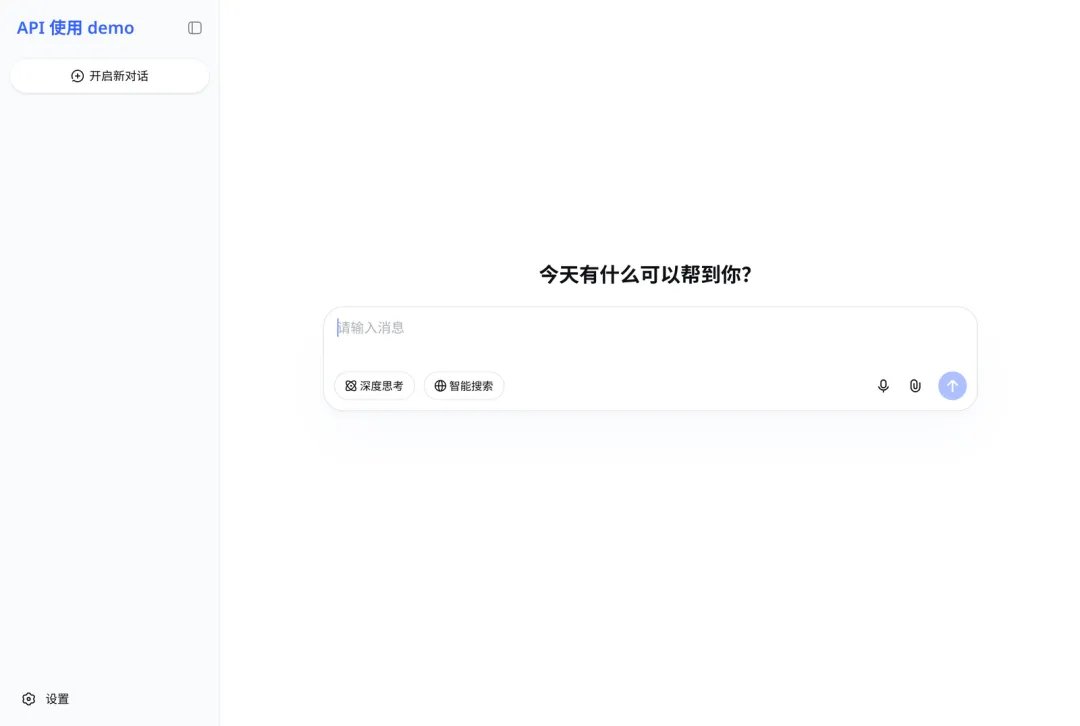
▲ 官方 Demo 的中文主界面,左上角名称是「API 使用 demo」。输入框里可以切换「深度思考」和「智能搜索」,右侧是语音输入、上传附件和发送。
界面几乎就是精简版的 DeepSeek App,支持多会话、流式回答、深度思考、智能搜索、附件和语音。第一次打开时,设置会先跳到「数据管理」,要求输入 API Key。
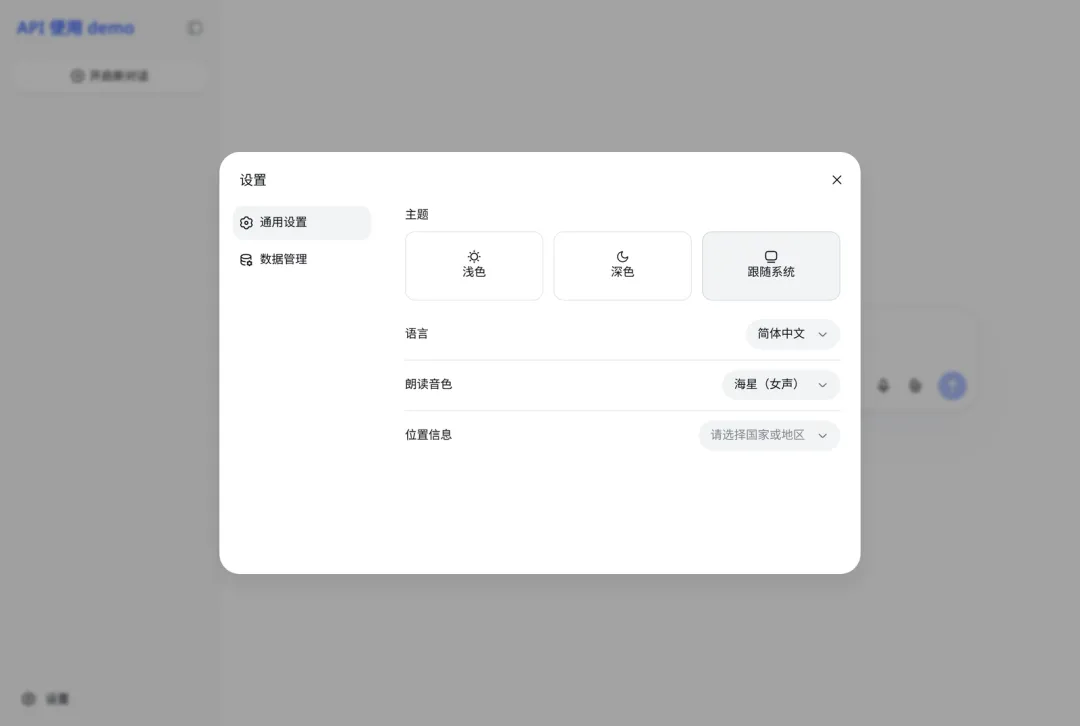
▲ 通用设置里可以改主题、语言、朗读音调和位置信息。朗读音色默认是「海星(女声)」,对应 TTS 的 stella。位置和语言会作为 latest_reminder 传给模型。
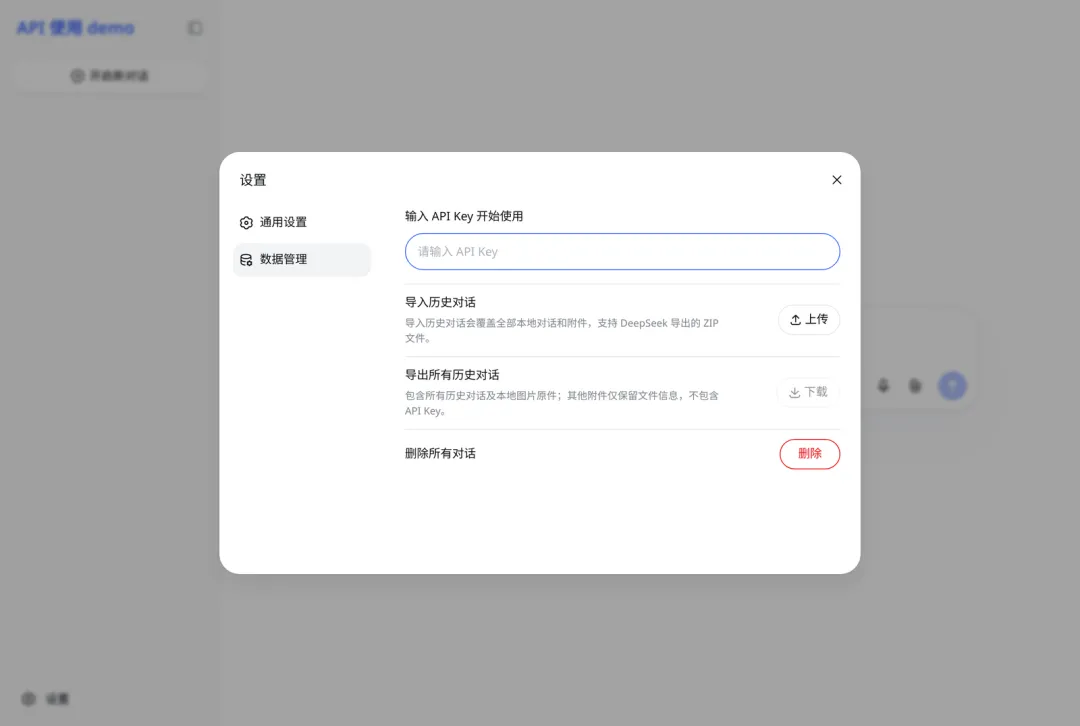
▲ 数据管理支持导入 DeepSeek 导出的 ZIP 历史,也可以导出本地对话。导入会覆盖全部本地对话和附件,导出不含 API Key。
对照源码,也有几处做产品时要留意。
聊天默认走 Anthropic 兼容的 Messages / Files API,模型写死为 deepseek-flash。- 安全审核是固定开启的
,所有请求都带 safety_check.level = high。阅读链接始终声明;「智能搜索」开关只决定要不要再加上deepseek_web_search。 这是一个静态站点,没有应用后端。API Key 存在浏览器的 localStorage,会话和附件原件存在 IndexedDB。官方 README 也写了,发送对话、上传附件和使用语音时,相应内容会提交给所配置的 API 服务。 因此它适合用来对照协议、看交互,不适合把填了真实密钥的页面直接暴露给公众。
七、接入时要注意的坑
这些都来自官方文档,不是测评结论。
目前只写了 Flash。 新闻稿和工具文档反复写,使用 deepseek-flash。定价页上的 deepseek-v4-pro 并没有被宣布支持这套内置对话能力。不要默认 Pro 也能开同样的服务器工具。
很多采样参数会被忽略。 只要声明了 deepseek_web_search 或 deepseek_read_url,或把 safety_check 设为 high,或打开了 title,服务端会自行决定 temperature、top_p 等参数,请求里的值无效。max_tokens 仍然有效,但它限制的是每一轮里单次推理步骤的输出,不是整轮输出总和。
不能和其他服务器工具混用。 文档写明,目前不能把这些内置工具,与 safety_check、title 以及其他服务器工具一起随便组合,否则可能返回 400。想同时用自己的 function calling 和这套内置搜索,先看当前文档是否已经放开。
用过联网工具的回复,不能续写。 官方明确,上一轮如果用了 deepseek_web_search 或 deepseek_read_url,再去 continue 会返回 400,应当重发上一次请求。Responses API 本身也不支持续写。
多轮必须原样回传。 搜索结果、打开的页面、读链接的 signature 以及思考块,都要随历史一起带回。文档还写明,更早轮次的搜索结果、打开的页面和思考,不会进入后面轮次的上下文,后面轮次主要保留回答文本。读过的链接则靠 signature 恢复。如果网关或框架丢掉了 Chat Completions 里的 server_tool_calls,请求可能仍成功,但之前读过的页面就不在上下文里了。
公开应用必须开安全,且责任仍在开发者。 这是官方连推和新闻稿都重复的合规要求,不是可选项。
八、我的看法
这次发布的重点,是 DeepSeek 把自己面向消费者的产品能力,做成了开发者可以直接调用的接口。对做聊天应用的人来说,搜索、读链接、文件解析、语音和基础审核,以前要自己拼一套;现在可以先用官方的服务端工具把主路径跑通,再决定哪些环节要换成自己的实现。
有三点需要保持冷静。第一,官方说的是「可以一比一复刻」,指功能清单和交互能力对得上,效果、延迟和审核尺度仍可能不同。第二,工具费按次、按页、按时长另算,深度思考搜索一轮里可能连续搜索和抓取多次,费用会明显高于「只聊几句」的 Token 账单,定价页又没有给出语音折扣的结束时间。第三,密钥如果像官方 Demo 那样放在浏览器里,只适合个人试用。对外提供服务,还是应当把密钥放在自己的后端,并单独完成登记、标识和内容审核。
它也很适合已经在用 DeepSeek API 的人做一次盘点。如果产品里本来就有搜索或语音,现在可以评估哪些链路能收回到官方工具,哪些仍应留在自己这边。
三点小结
DeepSeek 把 App 里的搜索、文件、链接、安全和语音开给了 API,目前写在 deepseek-flash上,三条协议都能用,工具在服务端执行。这些能力可以当对话内置工具用,也可以单独调用 Search、Fetch、OCR、ASR 和 TTS;工具费与 Token 费分开计算,语音目前是限时 5 折。 对外提供服务必须开启安全审核,开发者仍是内容审核和合规的第一责任人。官方 Demo 适合对照协议,不适合直接把 API Key 暴露在公开页面里。
你更想先用这套接口复刻一个聊天产品,还是把 Search / OCR / 语音接到现有的 Agent 流程里?欢迎把使用场景写在评论区。
#DeepSeek #DeepSeekAPI #AI开发 #Agent #WebSearch #OCR #ASR #TTS
如果觉得这篇文章有帮助,欢迎点赞、推荐、转发!您还有什么问题?欢迎评论区聊聊。