ARTICLE · 1355248
断网也能翻译:一个意大利人做的 App,中文却靠腾讯混元撑着
去年有朋友去日本,回来讲了一件事:在秋田一个小站问路,掏出手机打开翻译软件,屏幕上转了三圈,跳出一行「网络连接失败」。对面日本大爷已经比划了三分钟,最后靠画地图解决。
这事不稀奇。翻译软件的问题从来不是翻得准不准,是它得先能联网。机场、地铁、山里、国外漫游没开流量——最需要翻译的时候,恰恰是最容易没网的时候。
所以当我看到有人把整个翻译模型塞进手机本地跑,第一反应是「这东西要么很慢,要么很耗电」。装完用了一周,两样都没想象中那么糟,但有一个比这两样都更要紧的问题,得先说。
它做的事:断网,也能翻
RTranslator ,意大利独立开发者 niedev 从 2020 年开始做,现在一万多星。它的核心只有一句话:翻译模型和语音识别模型都跑在你手机上,不联网也能用。
技术上不神秘,就是两样东西:
这两个都是开源的、质量能打的模型。问题在于它们本来是给服务器用的,直接搬到手机上会卡死。作者做了一件很实的事——把两个模型都转成 ONNX 格式,做量化,再拆开重排,硬是把内存占用和速度压到了手机能接受的范围。
具体压到什么程度,下一节有表。
作者自己写得很清楚:不收集任何个人数据,他连服务器都没有。这一点比功能更值钱——市面上大部分免费翻译工具,代价就是你的语音被传上去训练了。
先泼一盆冷水:主推的那个模式,九成人用不上
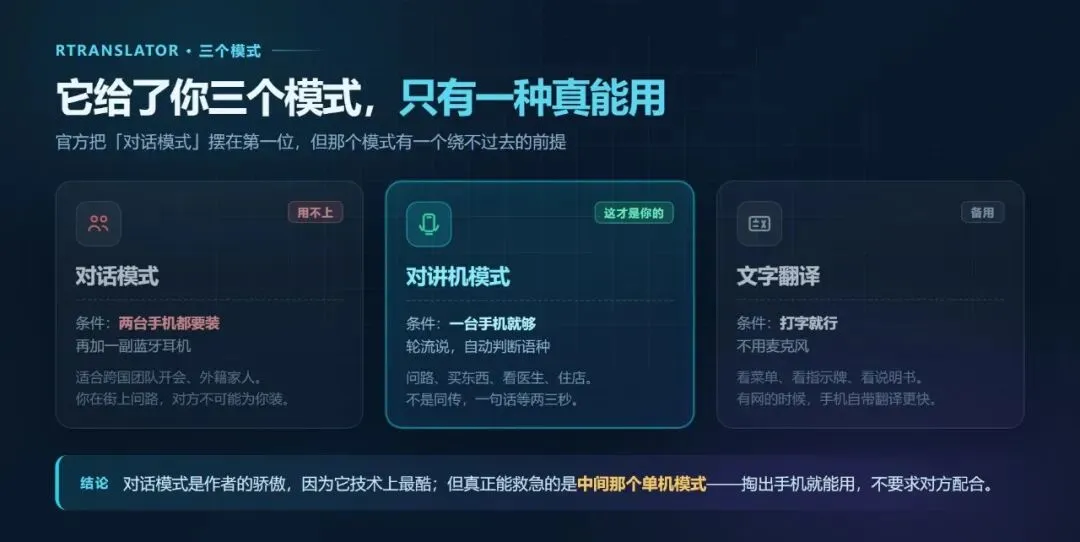
打开 App 你会看到三个模式,排第一的叫「对话模式」,也是作者花最多力气做的:
两台手机都装 App ,配对连上,各戴一副蓝牙耳机,手机揣兜里,就能像对方说着你的语言一样聊天。三个人以上也能连。
听起来很厉害。但你把场景代入一下就明白了:你在泰国街头问路,那个摊主凭什么为你装一个 93MB 的 App ?
这就是它的死结。对话模式要求双方都装。它真正适用的不是「临时问路」,而是「长期、固定、双方都愿意配合」的关系——跨国团队开会、外籍配偶、结伴长途旅行。这些人会装,但人数少得多。
作者把这个模式放第一位是可以理解的,因为它技术上最酷。但对普通用户,这是一个用不上的功能。
真正能用的是第二个:一台手机就够
第二个模式叫「对讲机模式」,界面朴素,但这才是一般人真会用的。
规则很简单:只有你一台手机,轮流说。你说中文,它听、翻、用手机喇叭念出外语;对方说外语,它自动判断是外语,翻成中文念给你。麦克风同时听两种语言,自己判断该往哪个方向翻。
适合的就是那些最实际的场合:买东西问价、问路、酒店前台说事、看医生描述症状。不用连网,不用对方装任何东西,掏出手机就能用。
代价是它不是同声传译。要等它把话说完、翻完、念完,才能轮到对方。一句话大概要等两三秒。真正面对面长谈,这个节奏会很累;但对付三五句的短对话,完全够。
第三个模式就是普通的文字翻译,打字翻,没什么可讲的。
它凭什么敢在手机上跑
这是这个项目最硬的地方,也是我最想让你看的部分。作者在 README 里放了一组自己实测的对比数据:
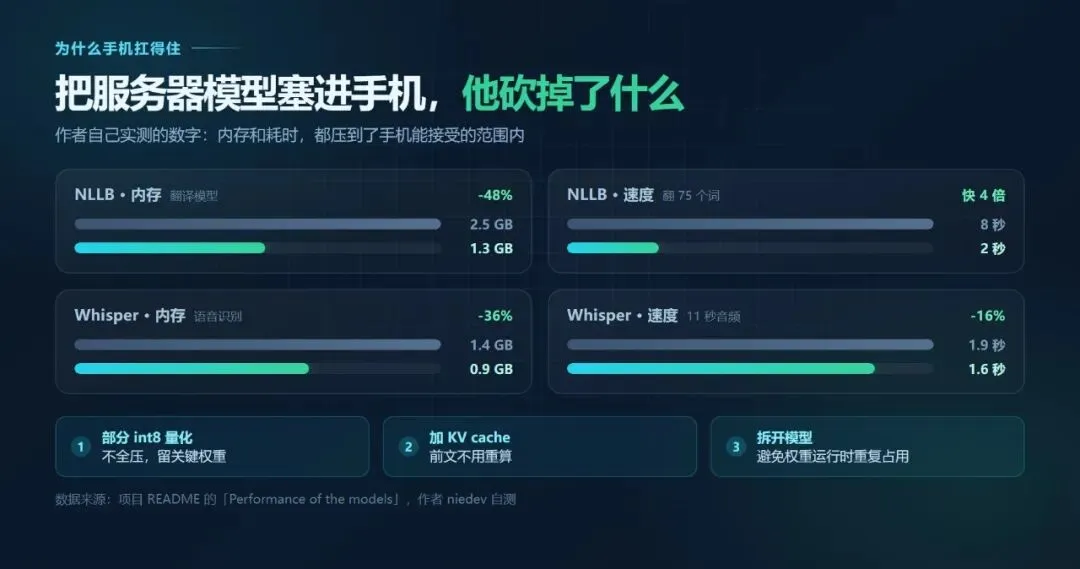
翻译模型的内存从 2.5GB 压到 1.3GB ,翻 75 个词从 8 秒压到 2 秒;语音识别模型的内存从 1.4GB 压到 0.9GB 。他干的事主要三样:
还有个细节很贴心: Whisper 另有一个 0.5GB 内存的低配模式,专门给 8GB 以下内存的手机用,代价是慢到 2.1 秒。作者没把这条路堵死。
翻 75 个词 2 秒,这个数字放在手机上算是能用了。
3.0 版本里,中文翻译换成了腾讯的模型
这是我觉得最有意思的地方。
2.x 用的是 Meta 的 NLLB 。 3.0 版本把它换掉了,现在可以从三个模型里选:
作者的原话是:这三个的翻译质量都比 NLLB 54B 好,和 2024 年的谷歌翻译差不多;而腾讯那个 HY-MT 1.5 1.8B 的分数明显高于谷歌翻译,接近 DeepSeek v3 和 Gemini 3.0。
一个意大利人做的开源项目,中文翻译质量靠中国团队开源的模型撑起来。这事本身就说明开源生态是什么样子——没有谁在闭门造车。
3.0 还顺手把最后一处闭源依赖清理掉了:原来判断语种用的是谷歌的 MLKit ,现在换成开源的 FastText 加 Lingua 。作者在 README 里特意标了一句「100% 开源」,看得出他挺在意这个。
不过要说清楚:3.0 现在还是 beta。目前最新的正式版是 2.1.5 ,用的还是 NLLB 。想尝腾讯模型那个版本,得装 beta 包。
中文这块,有三个短板,得提前知道
这部分我查了 issue 区,不是猜的。
第一,只有简体中文,没有繁体和粤语。 支持语言列表里写的是 Chinese ,实际是简体。有人提了 issue 请求加繁体中文和粤语,到现在还挂着没做。
第二,语音识别是弱项。 它用的是 Whisper-Small ,这是个小模型,英文识别很好,中文只能算能用。坑在 issue 区里能看到痕迹——有人专门提议把语音识别换成阿里的 FunASR (更快、中文更好、能跑 CPU )。提议被采纳与否是一回事,但这个提议本身说明什么,你懂的。
第三,以前翻中文出过乱码 bug 。 有人报过「输入错误的英文,翻出来的中文全是重复符号」,已经修了,但这提醒你:中文不是这个项目的主场,别指望它对中文的处理像对英语一样细。
再加上一个已知问题:蓝牙连接偶尔会断。作者自己写在 README 的「已知 bug 」里,主要影响对话模式,对讲机模式不太受影响。
装之前先确认两件事
第一,手机内存至少 6GB 。 作者的原话是「为了避免崩溃的风险,至少需要 6GB 内存」。低于这个数别硬装,会闪退。另外 CPU 也别太老,跑模型吃算力。
第二,第一次打开要下 1.2GB 模型。 这 1.2GB 是从 GitHub 拉的,而 GitHub 在国内的速度你自己有数。作者也知道这事——README 里直接贴了一个 Reddit 上讨论「为什么 GitHub 在中国这么慢」的帖子,然后给了另一条路:用电脑把模型下下来,手动塞进 App 里,具体步骤他写在 Sideloading.md。
这一步是整件事最容易失败的地方,比装 App 本身难。
至于装哪个版本:
| 大多数人装这个 |
还有一个前提:它只有安卓版,没有 iOS 。 iPhone 用户不用往下看了。
最后
这东西不适合当成日常翻译主力——日常有网的时候,手机自带的翻译又快又省事。它的价值在那些没网的场合:国外漫游没开流量、信号差的景区、飞机上、以及你压根不想让语音上服务器的任何时候。
一个跑了六年、一万多星、连服务器都没有的项目,作者靠自己贴钱和今年 NLnet 的基金支持在做。它不完美,中文也不是强项,但它解决的是一个真问题:翻译不该依赖网络。
下载
关注后回复「翻译」,自动发你安装包( 93.4MB , v2.1.5 正式版)。
3.0 beta 版在项目主页的 Release 里,标着 Pre-release ,自己找:github.com/niedev/RTranslator
项目是 Apache-2.0 协议,代码随便看随便改。但注意一点: 2.x 用的 NLLB 模型本身是「仅限非商业用途」的,这也是作者 3.0 要换模型的原因之一。
如果你下模型那一步卡住了(国内很常见),回复「翻译」时也会给你一份手动装模型的说明。
说句实在的:这 App 最值得装的场景,是你下次出国前,而不是等你已经在国外发现没网的时候。提前装好、提前把 1.2GB 模型下完,落地就能用。临时抱佛脚,你会卡在那 1.2GB 上。
本文由 AI 辅助创作,作者进行了实测验证和编辑修改。